Инференс по нескольким потокам
Обрабатывай видео с нескольких камер одной моделью с помощью пакетного инференса, ограниченных очередей и измерения потерь кадров.
Система, которая справляется с одной камерой, при подключении четырёх может отставать на несколько минут — и при этом ничего не падает: результаты просто приходят всё позже, пока не закончится память. На ноутбуке с CPU, использованном здесь, система справлялась с одним потоком 30 FPS, при четырёх потоках теряла половину кадров, а при восьми — больше двух третей. В этом уроке мы построим конвейер для измерения этого показателя: он поможет подобрать оборудование.
Практические занятия
Куда уходит время#
Каждый кадр проходит четыре этапа:
| Этап | Типичные затраты времени | Где выполняется |
|---|---|---|
| Декодирование (RTSP или файл → массив) | 5–20 мс на кадр 1080p | CPU |
| Предобработка (letterbox, нормализация) | около 1 мс | CPU |
| Инференс | от нескольких мс (GPU) до десятков мс (CPU) | Ускоритель |
| Постобработка, отслеживание, приёмники результатов | несколько мс, больше при медленной работе баз данных | CPU |
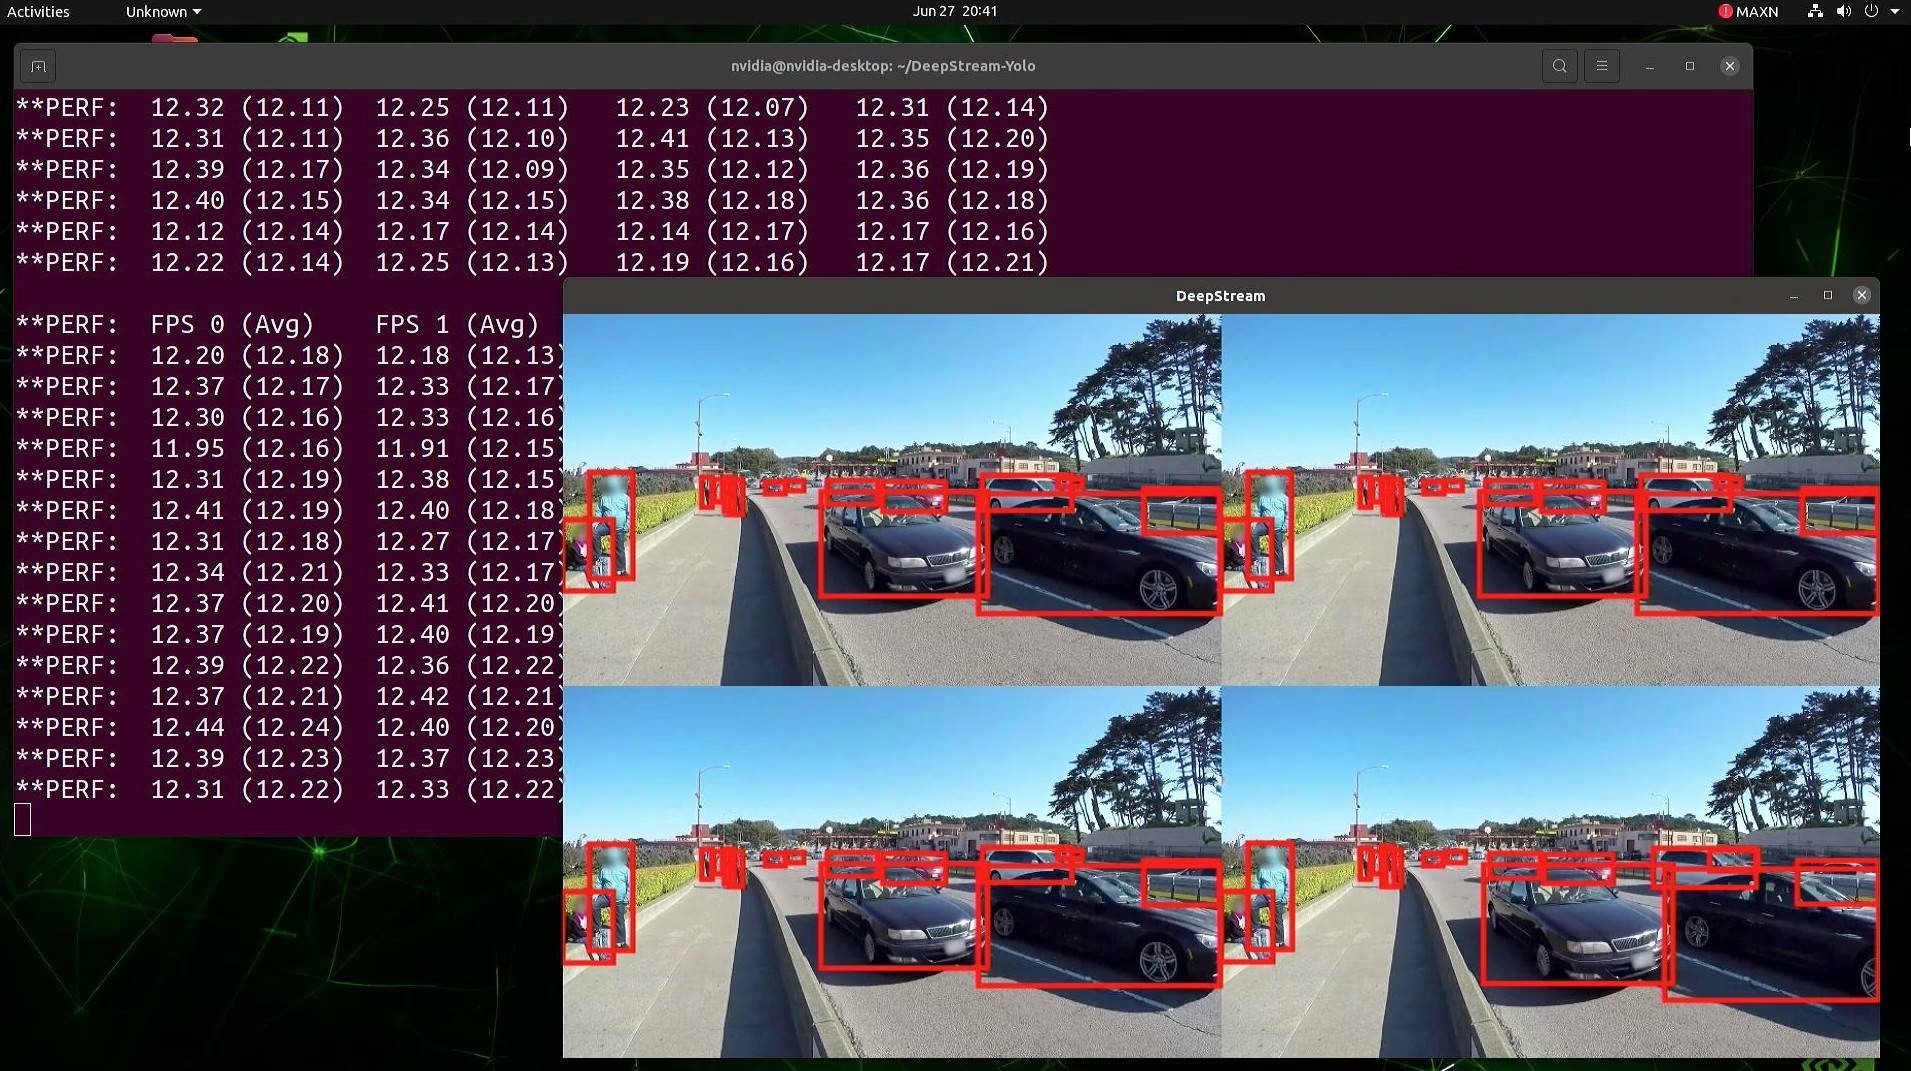
Запусти эти этапы последовательно, обрабатывая по одной камере в одном потоке, — и ускоритель будет простаивать, пока декодируются кадры. Решение — разделить этапы, как сделано в конвейере DeepStream выше: четыре потока используют одно устройство, а для каждого показывается собственный FPS (здесь около 12). Аналогичная структура на Python:
Встроенный вариант: файл .streams#
Ultralytics пакетно обрабатывает несколько источников за тебя. Добавь по одному источнику в строку файла .streams и передай его в режим Predict или Track. Для каждого потока создаются собственные поток чтения и трекер, а на каждой итерации выполняется один прямой проход с пакетной обработкой всех потоков:
from collections import Counter
from pathlib import Path

from ultralytics import YOLO
from ultralytics.utils.downloads import safe_download

base = "https://github.com/ultralytics/assets/releases/download/v0.0.0/"
clips = [safe_download(base + name) for name in ("solutions_ci_demo.mp4", "ground-vehicles-airport.mp4")]
Path("cams.streams").write_text("\n".join(str(c) for c in clips))  # продакшен: один URL rtsp:// в каждой строке

model = YOLO("yolo26n.pt")  # используй в продакшене оптимизированный экспорт модели
frames = Counter()
for r in model.track("cams.streams", stream=True, stream_buffer=True, tracker="bytetrack.yaml", verbose=False):
    frames[Path(r.path).name] += 1  # r.path указывает, из какого потока пришёл этот результат
print(frames)
Counter({'solutions_ci_demo.mp4': 62, 'ground-vehicles-airport.mp4': 62})Оба потока выдали по 62 результата, потому что итерация останавливается, когда завершается самый короткий поток (в ролике из аэропорта 150 кадров). stream_buffer=True обработал каждый кадр — это подходит для записанных видео; для камер в реальном времени оставь значение False по умолчанию, чтобы медленная модель пропускала устаревшие кадры, а не отставала. Для максимальной пропускной способности каждого потока используй экспорт в TensorRT или OpenVINO.
Собственный вариант: производитель-потребитель со счётчиками потерь#
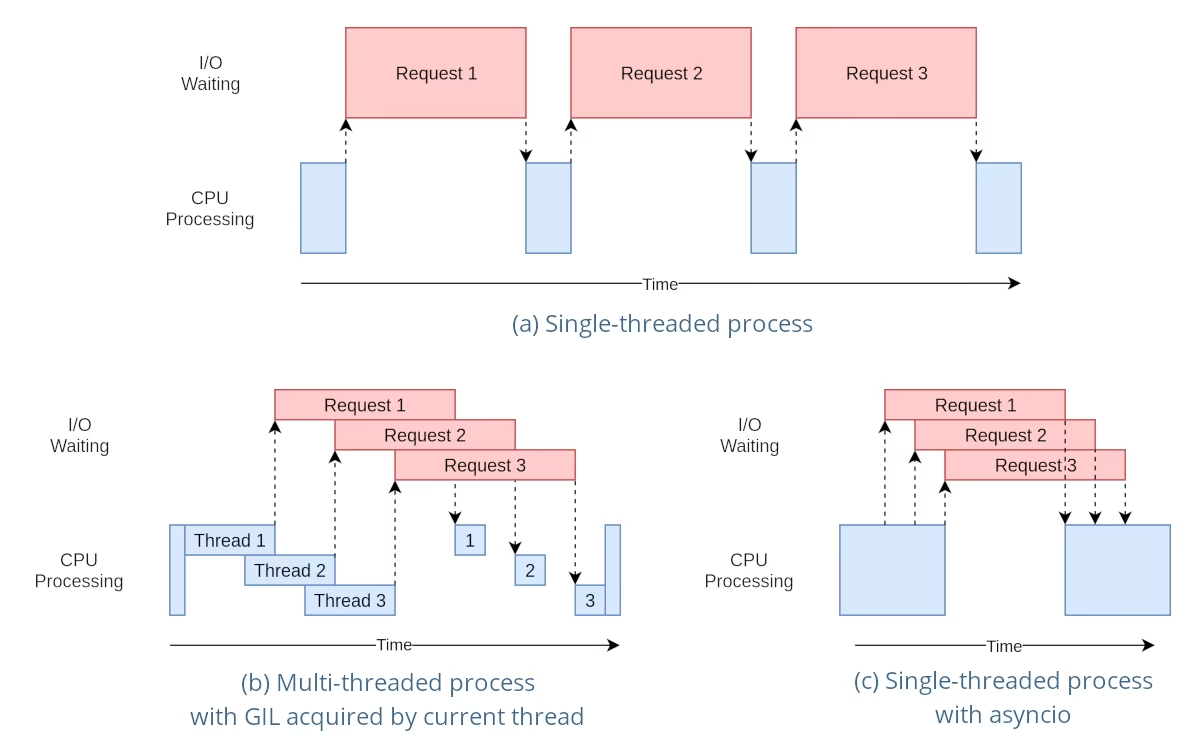
Диаграмма показывает, почему в этом конвейере работают потоки. Декодирование в основном состоит из ожидания (розовые полосы ввода-вывода), а OpenCV и PyTorch освобождают GIL Python во время работы, поэтому потоки декодирования хорошо перекрываются (панель b). Интенсивная постобработка на Python не перекрывается; перенеси её в отдельные процессы.
Если тебе нужны собственные приёмники результатов, логика для каждой камеры или явные метрики потерь, собери конвейер самостоятельно. Потоки декодирования не обращаются к модели; модель принадлежит одному циклу-потребителю, что также позволяет соблюдать правила потокобезопасного инференса:
import queue
import threading
import time

import cv2

from ultralytics import YOLO
from ultralytics.utils.downloads import safe_download

base = "https://github.com/ultralytics/assets/releases/download/v0.0.0/"
SOURCES = [str(safe_download(base + n)) for n in ("solutions_ci_demo.mp4", "ground-vehicles-airport.mp4")]
frames = queue.Queue(maxsize=16)  # bounded: memory and latency stay flat under overload
dropped = [0] * len(SOURCES)

def decode(stream_id, source):
    """Producer: read frames at the camera's pace and never block on a full queue."""
    cap = cv2.VideoCapture(source)
    interval = 1 / (cap.get(cv2.CAP_PROP_FPS) or 30)
    while True:
        ok, frame = cap.read()
        if not ok:
            break
        try:
            frames.put_nowait((stream_id, frame))
        except queue.Full:
            dropped[stream_id] += 1  # consumer is behind: drop rather than serve stale frames
        time.sleep(interval)  # pace files like a live camera; remove for RTSP sources
    cap.release()

model = YOLO("yolo26n.pt")  # one model, used only by the consumer loop below
model.predict("https://ultralytics.com/images/bus.jpg", verbose=False)  # warm up before cameras start

decoders = [threading.Thread(target=decode, args=(i, s), daemon=True) for i, s in enumerate(SOURCES)]
for t in decoders:
    t.start()

processed = [0] * len(SOURCES)
while any(t.is_alive() for t in decoders) or not frames.empty():
    batch = []
    while len(batch) < 8:  # gather up to 8 frames from any camera
        try:
            batch.append(frames.get(timeout=0.05))
        except queue.Empty:
            break
    if not batch:
        continue
    results = model([frame for _, frame in batch], verbose=False)  # one batched forward pass
    for (stream_id, _), r in zip(batch, results):
        processed[stream_id] += 1  # per-stream postprocessing and sinks go here

print(f"processed={processed} dropped={dropped}")
processed=[56, 131] dropped=[6, 19]В двух роликах 62 и 150 кадров, и каждый кадр либо обработан, либо потерян (56 + 6 = 62, 131 + 19 = 150), так что счётчики учитывают все кадры. Потеряно 25 из 212 кадров: CPU этого ноутбука не справляется с yolo26n в PyTorch при обработке двух потоков 30 FPS. Вот один прогон с повторением роликов для имитации работы большего числа камер:
| Потоки (по 30 FPS каждый) | Потерянные кадры |
|---|---|
| 1 | 0% |
| 2 | 12% |
| 4 | 51% |
| 8 | 69% |
Подбирай пропускную способность по результатам измерений#
Потоки на устройство ≈ устойчивая пропускная способность (число кадров в секунду, обрабатываемых моделью при заданном размере пакета) ÷ требуемый FPS для одного потока. Измерь пропускную способность на реальном оборудовании с оптимизированным экспортом из предыдущих уроков, оставь запас 20–30% на пиковую нагрузку и настрой оповещение, если появляются потери. Затраты на более высокое разрешение примерно пропорциональны числу пикселей: обработка 1280×1280 требует примерно в 4 раза больше вычислений, чем 640×640. Для больших парков устройств естественными решениями для продакшена будут Triton Inference Server и DeepStream на Jetson.
Подводные камни#
Симптом: model.track(["cam1.mp4", "cam2.mp4"]) воспринимает список как пакет изображений, а не как потоки. Решение: запиши источники в файл .streams, по одному на строку.
Симптом: из каждого файла получается всего один-два кадра. Решение: stream_buffer=False отбрасывает устаревшие кадры, а чтение файлов опережает модель; для файлов задай stream_buffer=True, а для потоковых камер оставь значение по умолчанию.
Симптом: под нагрузкой иногда появляются неверные или перепутанные результаты. Решение: никогда не вызывай один экземпляр YOLO одновременно из нескольких потоков. Назначь его одному обработчику, как описано выше, или создай модель внутри каждого потока инференса.
Симптом: задержка увеличивается с каждой минутой, а потребление памяти растёт, пока процесс не завершится с ошибкой. Решение: используй ограниченную очередь, которая отбрасывает элементы при заполнении, и счётчик отброшенных кадров. Системы реального времени при перегрузке должны отбрасывать кадры, а не накапливать задержку.
Показать решение
Сделай число потоков аргументом командной строки: добавь эти строки в producer_consumer.py сразу после строки SOURCES:
import sys

N = int(sys.argv[1]) if len(sys.argv) > 1 else 2  # число имитируемых камер
SOURCES = [SOURCES[i % len(SOURCES)] for i in range(N)]
Теперь проверь разные значения:
for n in 1 2 4 8; do python producer_consumer.py $n; doneprocessed=[62] dropped=[0]
processed=[56, 131] dropped=[6, 19]
processed=[23, 82, 23, 81] dropped=[39, 68, 39, 69]
processed=[14, 53, 13, 53, 13, 52, 13, 53] dropped=[48, 97, 49, 97, 49, 98, 49, 97]Для этой машины ответ — один поток: потери начинаются при двух. Чтобы обслуживать четыре камеры, экспортируй модель в более быстрый runtime (уроки 3 и 4), уменьши imgsz или используй ускоритель, а затем повтори проверку.