Оптимизация с TensorRT
Собери движок TensorRT в FP16, реши, оправдывает ли INT8 потерю точности, и проверь движок перед выпуском.
На GPU NVIDIA движок TensorRT в FP16 — обычно самый простой способ ускорить работу: в бенчмарке Ultralytics на A100 он работает примерно в 1,5 раза быстрее без изменения mAP. INT8 ускоряет ещё сильнее, но при посттренировочном квантовании YOLO26s–YOLO26m теряют 4–6 пунктов mAP на COCO. В этом уроке ты узнаешь, как определить нужный этап и измерить результат до того, как это сделают пользователи.
Практические занятия
Для кода в этом уроке требуется GPU NVIDIA с установленным TensorRT. Все показанные аргументы перечислены для format=engine в документации по режиму экспорта.
FP16 — безопасный первый шаг#
В GPU NVIDIA начиная с поколения Volta есть тензорные ядра FP16, а детекционным моделям при инференсе редко требуется FP32. Начни с этого:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")  # or runs/detect/pills_v1/weights/best.pt
model.export(format="engine", quantize=16, workspace=4)  # Движок FP16, до 4 GiB памяти рабочей области сборщика
workspace ограничивает объём памяти GPU, который TensorRT может использовать при сборке; если не задавать этот параметр, TensorRT выберет значение самостоятельно. На странице интеграции TensorRT опубликован результат для A100 (YOLOv8n, 640 пикселей):
| Точность | Предсказание, batch 8 (мс) | mAP50-95 на COCO val |
|---|---|---|
| FP32 | 0.52 | 0.37 |
| FP16 | 0.34 | 0.37 |
| INT8 | 0.28 | 0.33 |
Модель старше YOLO26, но соотношение скорости и точности остаётся показательным: FP16 примерно в 1,5 раза быстрее без потери точности, а INT8 ускоряет ещё в 1,2 раза ценой 4 пунктов. Если FP16 укладывается в твои ограничения, выпускай его.
Нет локального GPU NVIDIA? На вкладке Export платформы Ultralytics движок собирается на выбранном тобой облачном GPU с теми же настройками размера изображений, точности, batch, динамического режима, NMS и рабочей области:

Выбери семейство GPU, на котором будешь развёртывать модель: движок на скриншоте собран на RTX 5090 и будет работать только на этом семействе.
Для INT8 нужны калибровочные данные#
При квантовании INT8 активации каждого слоя преобразуются в 256 уровней. Чтобы выбрать диапазоны, экспортёр пропускает через модель изображения для калибровки и записывает наблюдаемые активации. Поэтому изображения должны быть похожи на производственные данные:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
model.export(
    format="engine",
    quantize=8,
    data="coco128.yaml",  # изображения для калибровки берутся из val-части этого датасета; используй my_dataset/data.yaml
    fraction=1.0,  # доля или количество изображений, которые нужно использовать
    batch=8,  # увеличение batch для калибровки делает диапазоны стабильнее
    dynamic=True,  # при batch=8 движок принимает batch от 1 до 8
    workspace=4,
)
Потери от INT8 зависят от модели. В документации по режиму Export приведены измерения движков TensorRT для YOLO26 на COCO val (mAP50-95):
| Модель | Движок FP32 | INT8 после калибровки (PTQ) | INT8 после квантования с учётом обучения (QAT) |
|---|---|---|---|
| YOLO26n | 0.4032 | 0.3934 | 0.3935 |
| YOLO26s | 0.4794 | 0.4412 | 0.4711 |
| YOLO26m | 0.5269 | 0.4696 | 0.5137 |
Одна калибровка снижает mAP YOLO26n на 1 пункт, а более крупных моделей — на 4–6 пунктов. При QAT модель дообучается с помощью quantize=8 в train, чтобы её веса лучше переносили INT8; контрольная точка содержит собственные диапазоны, для экспорта в INT8 не нужны калибровочные данные, а точность отличается от FP32 всего на 1–2 пункта. Решение:
Проверь движок перед выпуском#
Проверь каждый движок на целевом GPU по одним и тем же критериям:
| Проверка | Критерий |
|---|---|
| mAP50-95 на твоём val-наборе | Для FP16 — не более 0,5 пункта ниже FP32; для INT8 — в пределах зафиксированного тобой допуска |
| AP по классам | Ни один класс не должен терять больше примерно 1 пункта (сильнее всего варьируются малочисленные классы) |
| Задержка p95 | Не превышает лимит при производственном размере batch |
| Рабочий порог | conf подобран заново по собственной F1-кривой движка |
| Детерминированность | Для одного и того же изображения дважды получаются в точности одинаковые боксы |
yolo val model=yolo26n.engine data=coco8.yaml  # or my_dataset/data.yaml
yolo benchmark model=yolo26n.pt data=coco8.yaml imgsz=640 format=engine quantize=16
За счёт чего достигается ускорение#
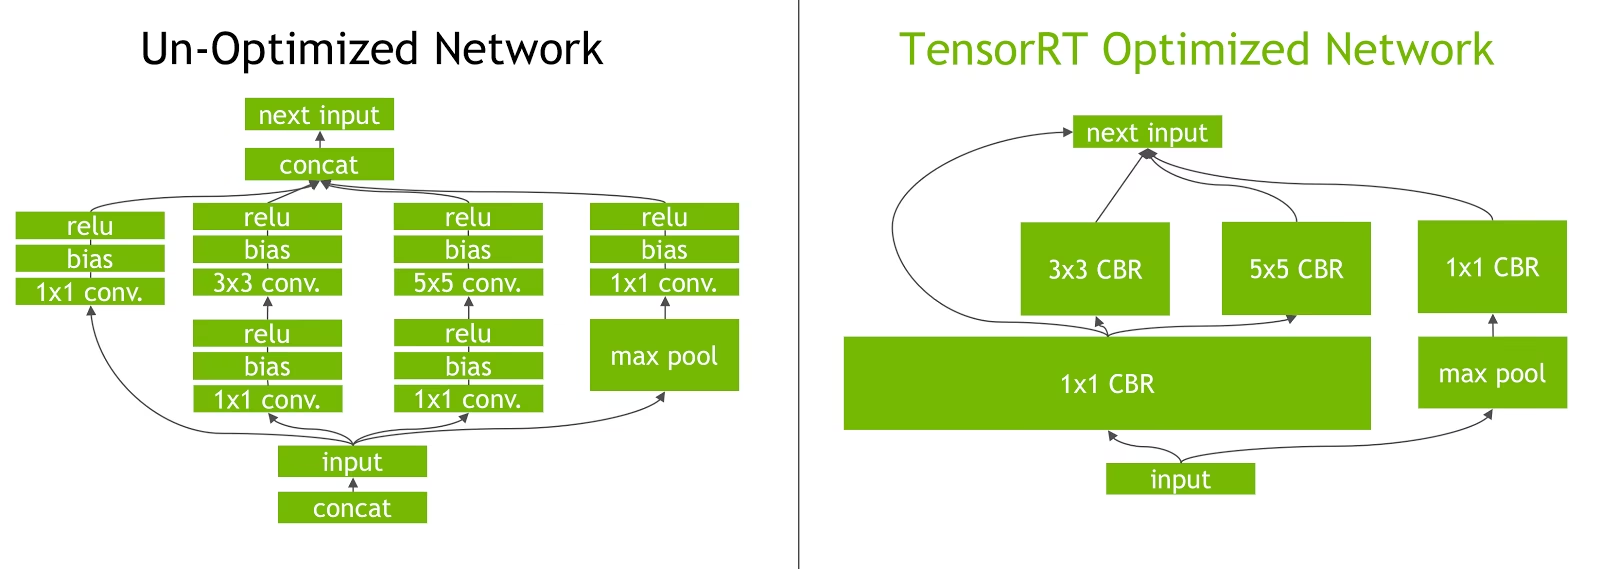
TensorRT объединяет свёртку, смещение и ReLU в одно ядро (блоки «CBR» справа) и удаляет этапы concat, поэтому GPU запускает гораздо меньше ядер и перемещает меньше данных. В YOLO26 это ускоряет цепочки conv-BN-активация по всей сети, блок внимания (PSA) в backbone и множество небольших операций в detection head. Если движок всё ещё работает медленно, профилируй его с помощью trtexec или NVIDIA Nsight: часто на один слой уходит 30% времени или больше.
Подводные камни#
Симптом: на COCO INT8 теряет 1 балл, а на твоих камерах — 6. Решение: калибруй на отложенной части своего валидационного набора; NVIDIA рекомендует использовать не менее 500 репрезентативных изображений. Результаты калибровки также зависят от устройства, поэтому выполняй её на GPU, на котором будешь запускать модель.
Симптом: после перехода на INT8 полнота падает при том же значении conf. Решение: INT8 может сдвигать значения уверенности; заново выбери conf по собственной кривой F1 движка INT8.
Симптом: движок не удаётся десериализовать или он работает медленнее ожидаемого на целевом устройстве. Решение: выполняй сборку на GPU того же семейства, что и целевой, с совместимыми версиями среды выполнения TensorRT и CUDA, и поставляй .onnx, чтобы устройства могли пересобрать движок. Если во время сборки происходит сбой калибровки, увеличь workspace или уменьши imgsz либо batch.
На Jetson DeepStream запускает полученные движки в аппаратно-ускоренном видеоконвейере; в дата-центре их обслуживает Triton Inference Server.
Показать решение
from ultralytics import YOLO

if __name__ == "__main__":  # validation starts worker processes on Windows
    data = "coco8.yaml"  # or my_dataset/data.yaml
    model = YOLO("yolo26n.pt")
    engine = model.export(format="engine", quantize=16, workspace=4)

    base = model.val(data=data, plots=False).box.map
    fp16 = YOLO(engine).val(data=data, plots=False).box.map
    print(f"PyTorch {base:.4f}  FP16 engine {fp16:.4f}  gap {abs(base - fp16) * 100:.2f} points")

    # Only if FP16 misses the latency budget:
    # model.export(format="engine", quantize=8, data=data, batch=8, dynamic=True, workspace=4)
В отчёте, прошедшем проверку, указано: расхождение меньше 0,5 пункта, задержка p95 ниже лимита, решение — выпустить FP16. Если p95 превышает лимит, экспортируй INT8 со своим YAML для калибровки, повтори те же две команды и выпускай INT8, только если расхождение остаётся в пределах допуска, который ты зафиксировал до начала работы; в противном случае попробуй QAT или модель меньшего размера.