OpenVINO на CPU
Экспортируй модели OpenVINO в FP32, FP16 и INT8, проверь каждую и оставь INT8 только там, где он даёт преимущество на твоём CPU.
CPU Intel, который у тебя уже есть, часто может заменить экземпляр с GPU: в бенчмарках Ultralytics YOLO26m ускоряется с 192 мс в PyTorch до 36 мс с OpenVINO INT8 на ноутбучном CPU Core Ultra. Однако прирост зависит от чипа, а на тестовом ARM-ноутбуке для этого курса экспорт INT8, откалиброванный на четырёх изображениях, потерял 3 пункта mAP. Ты научишься определять, какой случай у тебя, до выпуска модели.
Практические занятия
Что даёт OpenVINO#
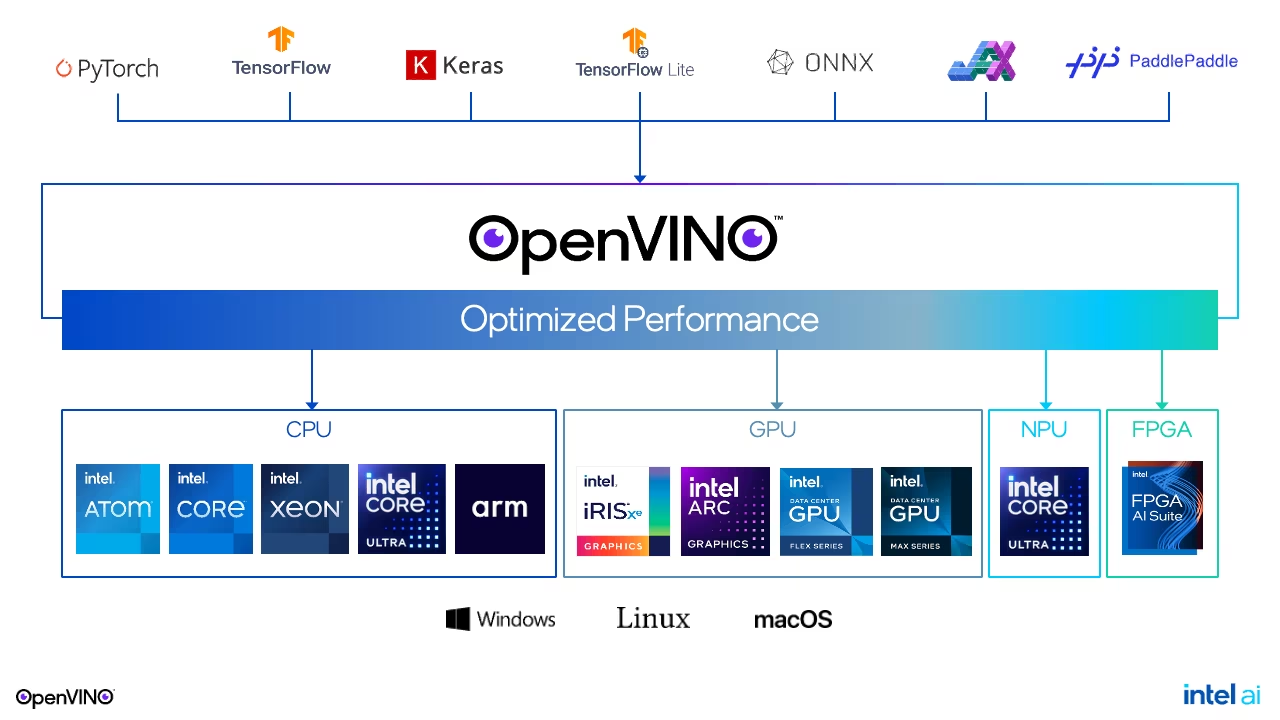
OpenVINO запускает модели из PyTorch и ONNX на CPU Intel, встроенных и дискретных GPU, а также NPU через единый API. Ядра CPU рассчитаны на наборы инструкций Intel (AVX2, AVX-512, AMX), а поддержка INT8 хорошо отлажена. Обрати внимание на блок ARM в столбце CPU: OpenVINO работает и на ARM, но его ядра оптимизированы для Intel, поэтому сначала измерь производительность.
Опубликованный бенчмарк на CPU Intel Core Ultra 7 155H (COCO128):
| Модель | PyTorch FP32 | OpenVINO FP32 | OpenVINO INT8 | mAP50-95 FP32 → INT8 |
|---|---|---|---|---|
| YOLO26n | 33.19 ms | 13.43 ms | 11.40 ms | 0.4734 → 0.4611 |
| YOLO26s | 70.92 ms | 36.16 ms | 15.54 ms | 0.5632 → 0.5471 |
| YOLO26m | 192.45 ms | 102.52 ms | 35.72 ms | 0.6191 → 0.6025 |
Из этой таблицы следуют три правила:
- Один только OpenVINO FP32 примерно вдвое снижает задержку PyTorch на CPU Intel. Начни с него.
- Чем крупнее модель, тем выгоднее INT8: ускорение в 1,2 раза для
nи в 2,9 раза дляmценой 1,2–1,7 пункта mAP. ДляnINT8 редко оправдывает потерю точности. - Сначала попробуй встроенный GPU, прежде чем покупать оборудование: Arc iGPU (
device="intel:gpu") на том же чипе запускал YOLO26n FP32 за 9.13 мс, а YOLO26m — за 34.47 мс.
Сравни точность на своём CPU#
Экспортируй каждый вариант точности, сразу проверяй его и только потом экспортируй следующий:
from ultralytics import YOLO

if __name__ == "__main__":  # validation starts worker processes on macOS and Windows
    model = YOLO("yolo26n.pt")  # or runs/detect/pills_v1/weights/best.pt
    for name, quantize in (("FP32", None), ("FP16", 16), ("INT8", 8)):
        path = model.export(format="openvino", quantize=quantize, data="coco8.yaml")  # or my_dataset/data.yaml
        m = YOLO(path).val(data="coco8.yaml", batch=1, plots=False, verbose=False)  # before the next export overwrites it
        print(f"{name}: mAP50-95 {m.box.map:.4f}  -> {path}")
OpenVINO: export success ✅ 2.3s, saved as 'yolo26n_openvino_model/' (9.6 MB)
FP32: mAP50-95 0.6783 -> yolo26n_openvino_model/
OpenVINO: export success ✅ 1.6s, saved as 'yolo26n_openvino_model/' (5.1 MB)
FP16: mAP50-95 0.6783 -> yolo26n_openvino_model/
WARNING ⚠️ OpenVINO: >300 images recommended for INT8 calibration, found 4 images.
OpenVINO: export success ✅ 11.3s, saved as 'yolo26n_int8_openvino_model/' (3.2 MB)
INT8: mAP50-95 0.6460 -> yolo26n_int8_openvino_model/Что показывает каждая строка:
- FP32 и FP16 показывают одинаковую точность, а FP16 занимает вдвое меньше места (5.1 против 9.6 МБ), но оба варианта записывались в одну папку. Если бы ты сначала экспортировал оба, а проверил позже, то дважды измерил бы FP16.
- INT8 занимает 3.2 МБ и потерял 3.2 пункта точности, потому что калибровка проводилась на четырёх изображениях из COCO8. Об этом предупреждает сообщение: для реальной калибровки нужны сотни похожих на производственные изображений из твоего YAML-файла (
fractionограничивает их количество). - Ничто из этого не измеряет скорость. Для этого используй бенчмарк ниже.
Чтобы запускать экспортированную модель на конкретном устройстве Intel:
from ultralytics import YOLO

ov_model = YOLO("yolo26n_openvino_model/")
results = ov_model("https://ultralytics.com/images/bus.jpg", device="intel:cpu")  # or intel:gpu, intel:npu
Отправляй всю папку: yolo26n.xml (граф), yolo26n.bin (веса) и metadata.yaml. Для intel:gpu и intel:npu требуется оборудование Intel.
Сравни производительность с ONNX Runtime#
Точность уже проверена; скорость нужно измерять на целевом устройстве под реальной нагрузкой. Запусти pick_runtime.py из первого урока с CANDIDATES = ("onnx", "openvino"). На тестовом ноутбуке с Apple silicon, пока другие задачи использовали тот же CPU:
onnx      p50  30.0 ms  p95  46.4 ms  misses the 30 ms budget
openvino  p50  22.8 ms  p95 113.5 ms  misses the 30 ms budget
У OpenVINO была лучше медианная задержка, но значительно хуже задержка в хвосте распределения. Обёртка Ultralytics компилирует OpenVINO с подсказкой LATENCY (в журнале указано Using OpenVINO LATENCY mode for batch=1 inference on CPU), распределяя каждый запрос по ядрам CPU; когда за эти ядра конкурируют другие задачи, сильнее всего страдают самые медленные запросы. На выделенном компьютере Intel результаты обычно ближе к опубликованным выше, но узнать это можно только по собственным измерениям p95.
Правила выбора:
Подводные камни#
Симптом: экспорт FP16 вдвое меньше по размеру, но работает точно так же медленно. Решение: на большинстве CPU плагин самостоятельно выбирает точность вычислений; используй FP16 для уменьшения размера загрузки, а INT8 или встроенный GPU — для ускорения.
Симптом: FP32 и FP16 показывают одинаковые результаты, потому что это один и тот же файл. Решение: экспорты FP32 и FP16 используют общую папку *_openvino_model/; проводи валидацию (или переименовывай папку) сразу после каждого экспорта.
Симптом: среднее значение выглядит нормальным, но в моменты высокой нагрузки кадры всё равно пропускаются. Решение: измеряй время инференса при рабочей нагрузке и ориентируйся на p95, а не на среднее значение. Для обработки множества потоков на одном сервере собери модель с подсказкой THROUGHPUT, напрямую загрузив .xml с помощью среды выполнения OpenVINO, как показано в руководстве по режимам задержки и пропускной способности.
В macOS и Windows валидация запускает рабочие процессы, которые повторно импортируют твой скрипт. Без if __name__ == "__main__": тестовый запуск для этого урока повторно выполнял экспорт внутри этих процессов, тратил минуты и конкурировал за CPU, производительность которого пытался измерить.
Показать решение
python ov_compare.py    # accuracy and size of FP32, FP16, INT8
python pick_runtime.py  # p50 and p95 for ONNX Runtime and OpenVINO
Пример решения на основе приведённых выше данных для Core Ultra 7 155H:
| Параметр | mAP50-95 | Объём | мс на изображение |
|---|---|---|---|
| OpenVINO FP32 | 0.4734 | 9.6 MB | 13.43 |
| OpenVINO INT8 | 0.4611 | 3.2 MB | 11.40 |
iGPU FP32 (intel:gpu) | 0.4758 | 9.6 MB | 9.13 |
Выпускай OpenVINO FP32 на интегрированном GPU: это самый быстрый вариант без потери качества, тогда как INT8 на CPU обойдётся в 1,2 пункта ради экономии 2 мс. При развёртывании YOLO26m выбор меняется на INT8 на CPU (в 2,9 раза быстрее при потере 1,7 пункта), если такая потеря укладывается в твой бюджет.