Chất lượng gán nhãn
Nắm rõ nội dung của nhãn YOLO, kiểm tra lỗi các tệp nhãn để tìm những dòng sai định dạng, và giúp annotator làm việc nhất quán bằng hướng dẫn cùng một vòng hiệu chuẩn có đo lường.
Model được huấn luyện bằng các nhãn không nhất quán sẽ học theo sự không nhất quán đó. Năm mươi nghìn bounding box được vẽ theo một quy tắc rõ ràng có giá trị hơn nửa triệu bounding box dựa trên hai mươi cách diễn giải riêng, và việc gán nhãn lại gần như luôn rẻ hơn việc dùng model lớn hơn. Bài học này cung cấp cho bạn công cụ kiểm tra nhãn, hướng dẫn một trang và chỉ số đo mức độ nhất quán giữa các annotator.
Thực hành
Nhãn thực sự là gì#
Trong định dạng YOLO, mỗi ảnh có một tệp .txt tương ứng, với một dòng cho mỗi đối tượng. Tọa độ được chuẩn hóa về khoảng 0–1 theo chiều rộng và chiều cao của ảnh, nhờ đó nhãn vẫn chính xác khi thay đổi kích thước ảnh. Cấu trúc dòng tùy thuộc vào tác vụ:
| Tác vụ | Một nhãn | Ghi chú |
|---|---|---|
| Phát hiện | class x_center y_center width height | Tâm và kích thước bounding box |
| Phân đoạn đối tượng | class x1 y1 x2 y2 ... xn yn | Đường viền polygon |
| Pose | class x y w h px1 py1 v1 ... pxn pyn vn | Bounding box, tiếp theo là keypoint với thông tin hiển thị tùy chọn |
| OBB | class x1 y1 x2 y2 x3 y3 x4 y4 | Bốn góc của bounding box xoay |
| Phân loại | Không có tệp nhãn | Ảnh được sắp xếp vào một thư mục cho mỗi lớp |
| Phân đoạn ngữ nghĩa | Một mask PNG cho mỗi ảnh | Giá trị mỗi pixel là một chỉ số lớp |
| Ước tính độ sâu | Một ảnh độ sâu PNG hoặc NPY cho mỗi ảnh | Giá trị mỗi pixel là một khoảng cách |
Chỉ số lớp bắt đầu từ 0 và ánh xạ tới tên lớp trong YAML của bộ dữ liệu. Ảnh không có đối tượng thì không cần tệp nhãn — đó là cách ảnh nền hoạt động. Các trang về bộ dữ liệu định dạng detection, phân đoạn ngữ nghĩa và độ sâu có các ví dụ thực tế.
Kiểm tra lỗi các tệp nhãn#
Các dòng sai định dạng thường không báo lỗi: tọa độ lớn hơn 1, class ID không được định nghĩa trong YAML hoặc cùng một đối tượng bị đánh bounding box hai lần đều trở thành nhiễu mà model cố học. Một công cụ kiểm tra ngắn có thể phát hiện chúng trước khi huấn luyện:
from itertools import combinations
from pathlib import Path

from ultralytics.data.utils import check_det_dataset

def iou(a, b):
    """IoU of two normalized (x_center, y_center, width, height) boxes."""
    ax1, ay1, ax2, ay2 = a[0] - a[2] / 2, a[1] - a[3] / 2, a[0] + a[2] / 2, a[1] + a[3] / 2
    bx1, by1, bx2, by2 = b[0] - b[2] / 2, b[1] - b[3] / 2, b[0] + b[2] / 2, b[1] + b[3] / 2
    inter = max(0, min(ax2, bx2) - max(ax1, bx1)) * max(0, min(ay2, by2) - max(ay1, by1))
    return inter / (a[2] * a[3] + b[2] * b[3] - inter)

def check_labels(text, names):
    """Return a list of problems in one YOLO detection label file."""
    problems, boxes = [], []
    for i, row in enumerate(text.split("\n"), 1):
        values = row.split()
        if not values:
            continue
        if len(values) != 5:
            problems.append(f"row {i}: {len(values)} values, expected 5")
        elif int(values[0]) not in names:
            problems.append(f"row {i}: unknown class {values[0]}")
        elif not all(0 <= float(v) <= 1 for v in values[1:]):
            problems.append(f"row {i}: coordinates outside 0-1")
        else:
            boxes.append((i, int(values[0]), [float(v) for v in values[1:]]))
    for (i, ca, a), (j, cb, b) in combinations(boxes, 2):
        if ca == cb and iou(a, b) > 0.8:
            problems.append(f"row {j}: duplicate of row {i} (IoU {iou(a, b):.2f})")
    return problems

broken = "0 0.50 0.50 0.20 0.30\n0 0.51 0.50 0.20 0.30\n3 0.40 0.40 0.10 0.10\n0 1.20 0.50 0.10 0.10\n0 0.50 0.50 0.10"
print("\n".join(check_labels(broken, {0: "pill"})))

data = check_det_dataset("medical-pills.yaml")
files = sorted(Path(data["path"], "labels").rglob("*.txt"))
found = sum(len(check_labels(f.read_text(), data["names"])) for f in files)
print(f"medical-pills: {found} problems in {len(files)} label files")
row 3: unknown class 3
row 4: coordinates outside 0-1
row 5: 4 values, expected 5
row 2: duplicate of row 1 (IoU 0.90)
medical-pills: 0 problems in 115 label filesMẫu được tạo thủ công minh họa từng lỗi mà công cụ kiểm tra phát hiện; bộ dữ liệu thực tế vượt qua bước kiểm tra mà không có lỗi. Hãy chạy công cụ sau mỗi đợt gán nhãn và trước mỗi lần huấn luyện — chỉ mất vài giây.
Vì sao nhãn không nhất quán#
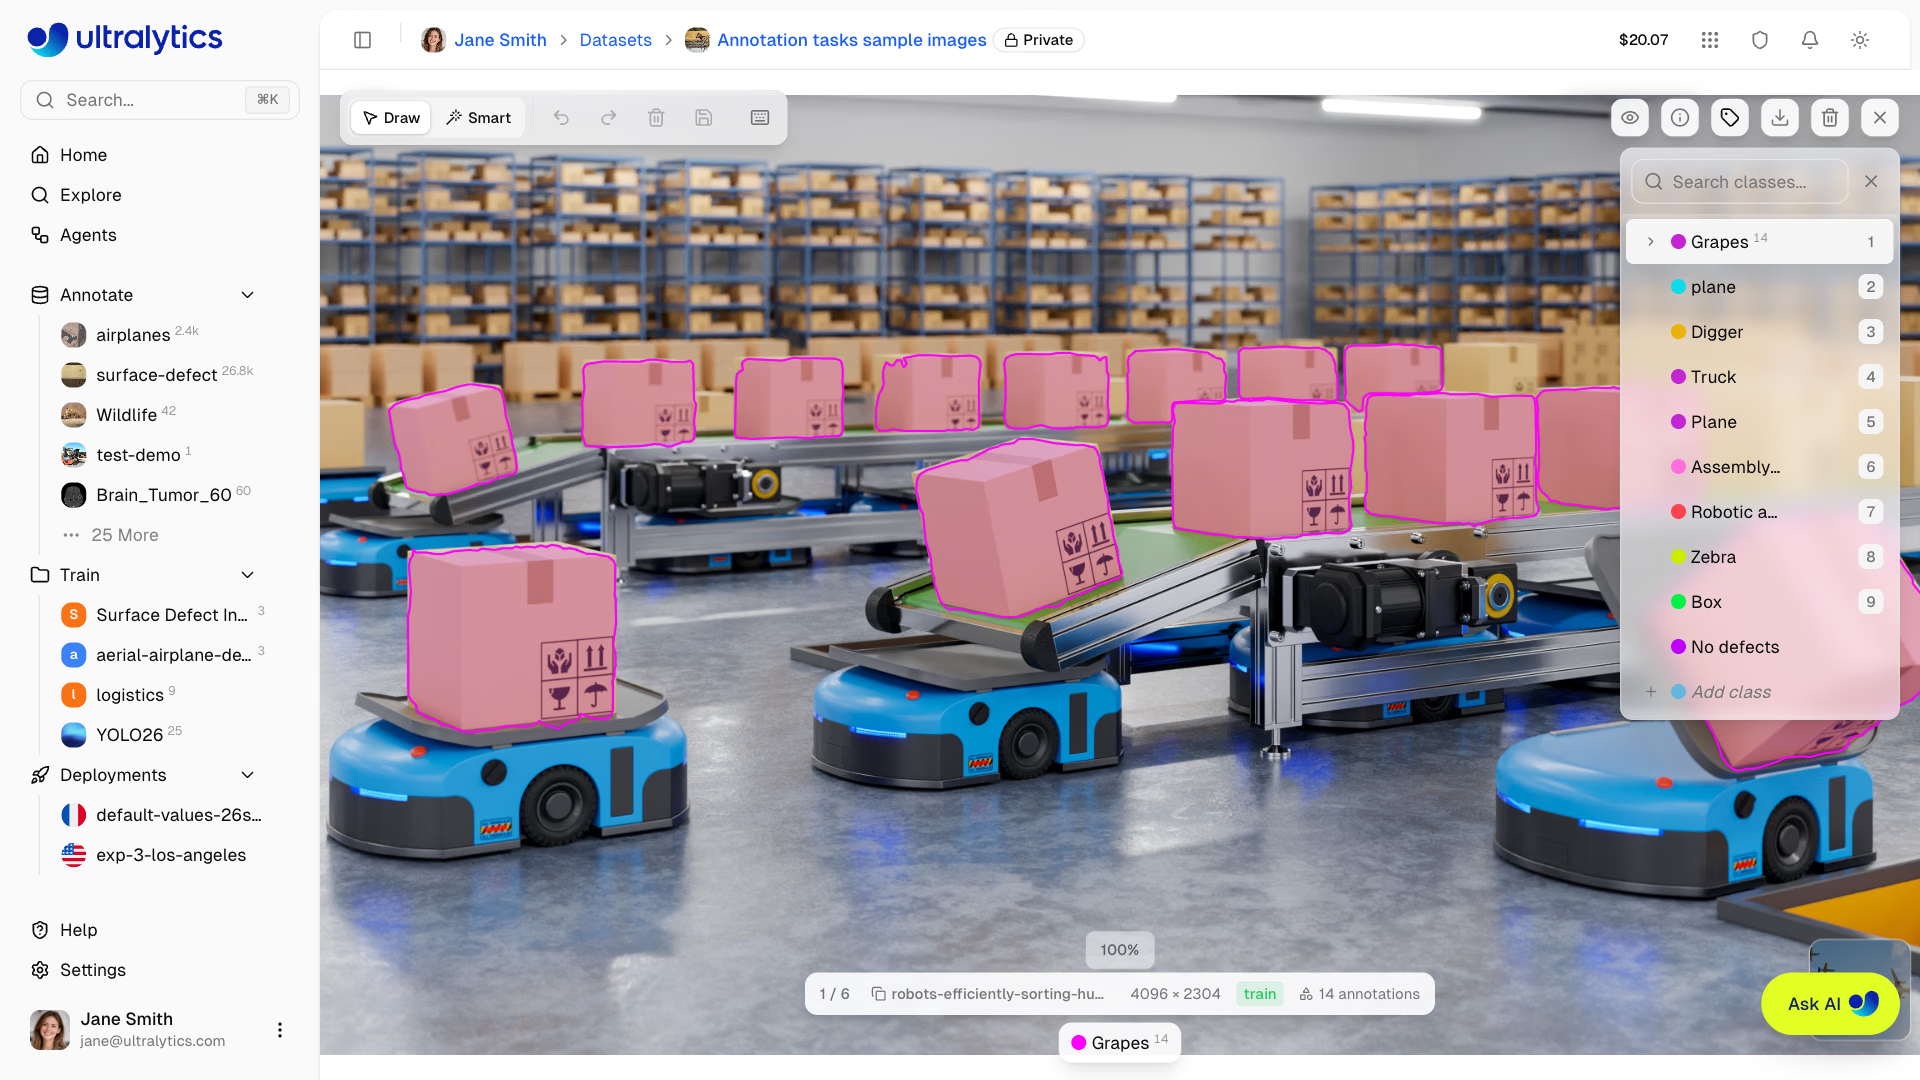
Hãy nhìn vào bảng lớp trong trình chỉnh sửa này: 14 polygon thùng carton được lưu dưới lớp Grapes, trong khi lớp Box nằm bên dưới trong danh sách — và plane cùng Plane tồn tại thành hai lớp riêng biệt. Công cụ kiểm tra không thể phát hiện vấn đề nào trong hai vấn đề này vì mọi dòng đều hợp lệ, nhưng người đánh giá đối chiếu nhãn với hướng dẫn sẽ phát hiện cả hai chỉ trong vài giây. Phần lớn lỗi gán nhãn đều như vậy: tệp hợp lệ nhưng quyết định sai.
Annotator hiếm khi gán nhãn kém vì bất cẩn. Họ gán nhãn không nhất quán vì quy tắc còn mơ hồ, khiến mỗi người đưa ra một phán đoán hợp lý nhưng khác nhau:
- Bounding box dừng ở đâu? Ở bóng đổ, túi xách đang được mang theo hay hàng hóa trên càng xe nâng?
- Vật thể bị cắt khỏi khung hình. Một người chỉ hiện một nửa bên ngoài khung hình có còn là
personkhông? Cần nhìn thấy bao nhiêu phần của người đó? - Vật thể bị che khuất. Nếu chỉ thấy một bánh xe của ô tô thì có gán nhãn hay bỏ qua?
- Ranh giới giữa các lớp. Xe bán tải là
carhaytruck? Xe scooter làbicyclehayother? - Trường hợp không gán nhãn. Hình phản chiếu, áp phích và màn hình hiển thị hình ảnh của đối tượng.
Mọi lựa chọn đều phù hợp, miễn là tất cả mọi người cùng áp dụng một lựa chọn.
Hướng dẫn một trang#
Tài liệu này chỉ dài một trang, có ảnh ví dụ cho từng quy tắc và trình bày các trường hợp ngoại lệ trước:
## Class: forklift

Include:
- Forklifts with at least 30% of the body visible, moving or parked, any size or color.

Do not label:
- Pallet jacks (no overhead mast) → class `pallet_jack`.
- Reflections in glass or polished floors, and forklifts on posters or screens.

Box rules:
- Include the mast and the full visible body.
- Exclude the load (pallets, boxes) — those have their own classes.
- For partly occluded forklifts, box the visible part only.
Đo mức độ nhất quán trong một vòng hiệu chuẩn#
Trước khi mở rộng từ một lên hai mươi annotator, mọi người gán nhãn cùng 50 ảnh và bạn so sánh kết quả:
Mức độ nhất quán là tỷ lệ đối tượng mà cả hai annotator cùng vẽ với một lớp và IoU ít nhất 0.5 — cách diễn giải thực tế của độ tin cậy giữa những người đánh giá:
def iou(a, b):
    """IoU of two (x1, y1, x2, y2) pixel boxes."""
    w = max(0, min(a[2], b[2]) - max(a[0], b[0]))
    h = max(0, min(a[3], b[3]) - max(a[1], b[1]))
    inter = w * h
    return inter / ((a[2] - a[0]) * (a[3] - a[1]) + (b[2] - b[0]) * (b[3] - b[1]) - inter)

def agreement(boxes_a, boxes_b, threshold=0.5):
    """Share of objects both annotators drew with the same class and IoU >= threshold."""
    unmatched, matched = list(boxes_b), 0
    for cls_a, box_a in boxes_a:
        best = max(unmatched, key=lambda b: iou(box_a, b[1]) if b[0] == cls_a else -1, default=None)
        if best and best[0] == cls_a and iou(box_a, best[1]) >= threshold:
            unmatched.remove(best)
            matched += 1
    return matched / max(len(boxes_a), len(boxes_b))

# Two annotators label the same calibration image
alice = [("forklift", (100, 200, 400, 600)), ("person", (450, 220, 520, 480)), ("person", (600, 230, 660, 470))]
bob = [("forklift", (100, 120, 400, 600)), ("person", (452, 218, 522, 478)), ("pallet_jack", (600, 230, 660, 470))]
print(f"agreement: {agreement(alice, bob):.0%}")
agreement: 67%Có hai loại bất đồng ẩn sau con số 67%. Bounding box xe nâng của Bob bắt đầu cao hơn 80 pixel — anh ấy đưa cả đầu cột nâng vào — nhưng vẫn đạt IoU 0.83 nên được tính là nhất quán; hãy siết chặt quy tắc vẽ bounding box nếu sản phẩm của bạn đo chiều cao. Đối tượng thứ ba là một xung đột thực sự: Alice gán person, còn Bob gán pallet_jack. Trường hợp này cần quy tắc rõ ràng hơn và ảnh ví dụ, sau đó thực hiện thêm một vòng. Giữ lại 50 ảnh hiệu chuẩn: chúng sẽ trở thành bài kiểm tra đầu vào cho mỗi annotator mới.
Người đánh giá âm thầm sửa nhãn sẽ loại bỏ vòng phản hồi, khiến người gán nhãn không bao giờ biết mình đã làm sai ở đâu. Hãy từ chối kèm lý do và để người gán nhãn sửa. Cách này chậm hơn với một trăm ảnh đầu tiên nhưng nhanh hơn nhiều sau đó.
Các chỉ số cần theo dõi#
| Chỉ số | Ý nghĩa |
|---|---|
| Thông lượng (số đối tượng mỗi giờ) | Năng lực xử lý và chi phí |
| Tỷ lệ từ chối | Chất lượng có đang giảm dần hay không |
| Mức độ nhất quán trên tập dữ liệu chồng lấp được chia sẻ | Annotator có còn áp dụng cùng một quy tắc hay không |
Khi mức độ nhất quán giảm, có điều gì đó đã thay đổi: annotator mới, camera mới, đợt dữ liệu mơ hồ hoặc sự mệt mỏi. Khi model sau này gặp lỗi trong một điều kiện cụ thể, hãy đưa chính những ảnh đó trở lại quy trình gán nhãn — vòng lặp mà active learning tự động hóa, đồng thời là nguồn tạo ra phần lớn cải thiện độ chính xác trong thực tế. Duyệt và lọc các trường hợp lỗi trong bộ dữ liệu của bạn trên Ultralytics Platform, đồng thời tham khảo Kiểm soát chất lượng bộ dữ liệu và Các phương pháp gán nhãn tốt nhất để triển khai quy trình này ở quy mô lớn.
Hiển thị lời giải
Hướng dẫn cho lớp pill của bộ dữ liệu medical-pills, được viết sau vòng hiệu chuẩn trên 10 ảnh:
## Class: pill

Include:
- Every tablet inside a blister cavity, including half-visible ones at the image edge.
- Tablets seen through clear plastic, even when glare covers part of them.

Do not label:
- Empty cavities, torn foil, or tablets outside the pack.
- Reflections of tablets in the foil.

Box rules:
- Box the tablet itself, not the plastic bubble around it.
- If two tablets touch, draw two boxes.
Cách đọc điểm số nhất quán: giả sử vòng đầu tiên đạt 82%. Hãy phân loại các đối tượng không khớp theo nguyên nhân. Với các vỉ thuốc, hai nguyên nhân thường gặp là bounding box được vẽ quanh vòm nhựa thay vì viên thuốc (khắc phục bằng quy tắc vẽ bounding box đầu tiên và ảnh ví dụ) và viên thuốc bị lóa mà một annotator bỏ qua (khắc phục bằng quy tắc bao gồm thứ hai). Chạy lại trên 10 ảnh mới; chỉ mở rộng quy mô khi điểm số vượt ngưỡng 90%.