Hộp và mask: khi nào bạn thực sự cần segmentation
Đo lường phần mask bổ sung được gì so với hộp trên ảnh thực tế, rồi dựa vào thành phần downstream để quyết định dự án có thực sự cần hình dạng hay không.
Mask là thứ mà hầu hết mọi người hình dung khi nghĩ đến thị giác AI, đồng thời cũng là phần khiến các nhóm tiêu tốn nhiều ngân sách gán nhãn nhất. Mask cho biết hình dạng chính xác của vật thể; hộp chỉ cho biết vị trí của vật thể. Sự khác biệt đó quyết định hoàn toàn một số sản phẩm — nhưng không làm thay đổi gì đối với phần lớn sản phẩm.
Thực hành
Mask bổ sung được gì#
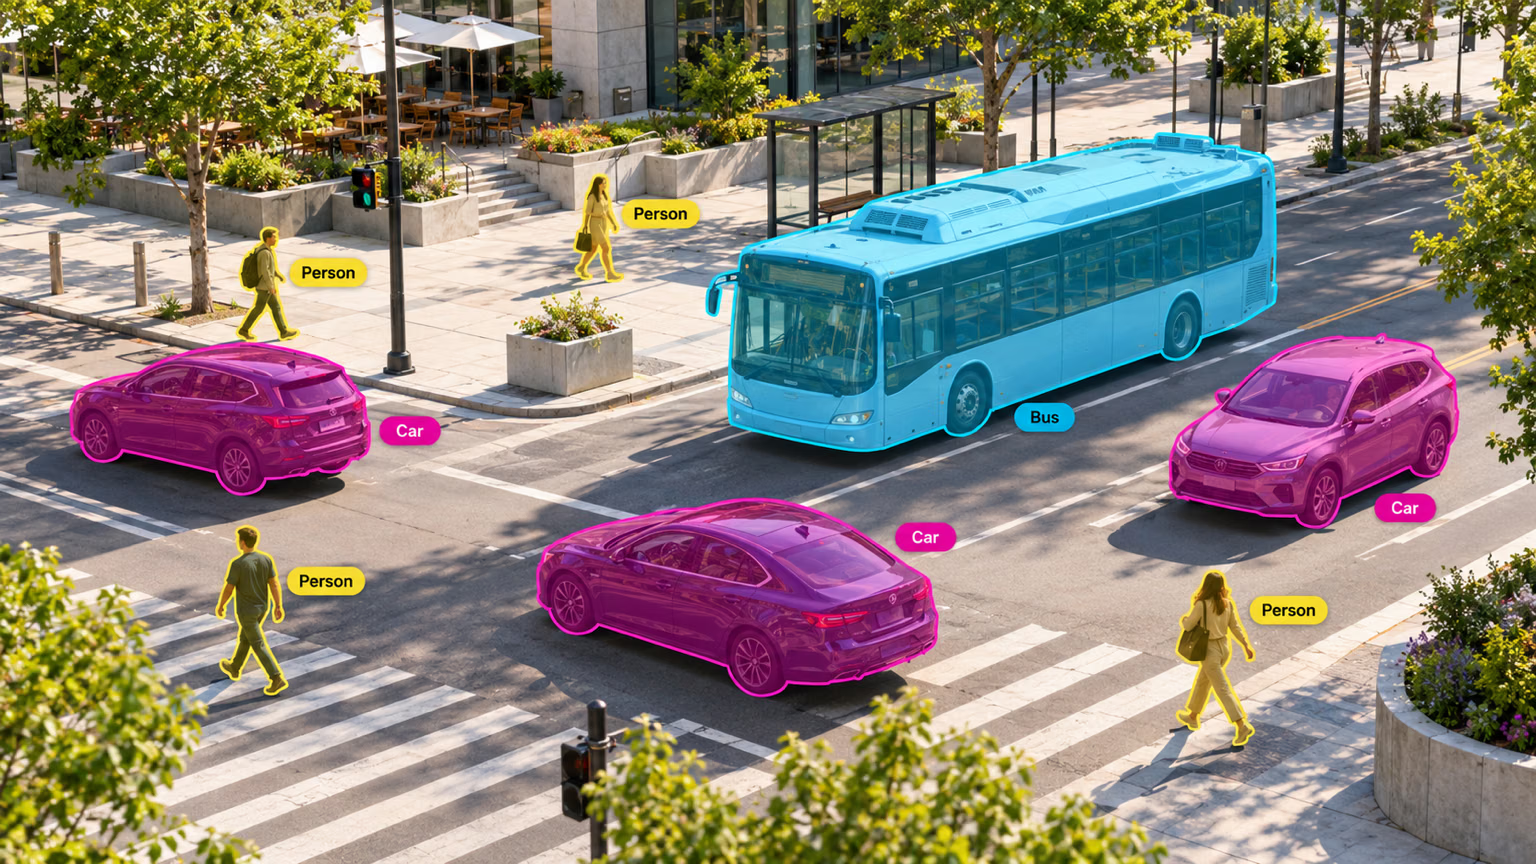
Với mỗi vật thể, tác vụ Segment trả về mọi thông tin mà detector trả về — lớp, hộp, confidence — cùng các pixel thuộc về vật thể; nhờ vậy, mỗi chiếc ô tô ở trên có đường viền riêng, tách biệt với xe buýt và người đi bộ. Đọc mask dưới dạng polygon (masks.xy) hoặc ảnh nhị phân (masks.data).
Hình dạng làm thay đổi các con số đến mức nào? So sánh diện tích hộp với diện tích mask của từng vật thể:
from ultralytics import YOLO

model = YOLO("yolo26n-seg.pt")
result = model("https://ultralytics.com/images/bus.jpg", retina_masks=True, verbose=False)[0]

for box, mask in zip(result.boxes, result.masks.data):
    x1, y1, x2, y2 = box.xyxy[0].tolist()
    box_area = (x2 - x1) * (y2 - y1)
    mask_area = float(mask.sum())  # pixels inside the object's mask
    name, ratio = result.names[int(box.cls)], mask_area / box_area
    print(f"{name:7} box={box_area:7.0f} px  mask={mask_area:7.0f} px  ({ratio:.0%})")
person box= 97116 px mask= 49331 px (51%)
person box= 68102 px mask= 21316 px (31%)
bus box= 410093 px mask= 255265 px (62%)
person box= 55998 px mask= 33524 px (60%)
person box= 23690 px mask= 11109 px (47%)Xe buýt chỉ chiếm 62% diện tích hộp, còn một người chỉ chiếm 31%. Mọi con số tính riêng từ hộp — diện tích được sơn, kích thước vết tràn, phần kệ còn trống — đều sẽ sai lệch ở mức đó. Nếu sản phẩm của bạn báo cáo những con số như vậy, bạn cần mask. Nếu sản phẩm chỉ đếm hoặc xác định vị trí, số pixel bổ sung không tạo ra khác biệt.
Triệu chứng: diện tích mask có vẻ nhỏ hơn diện tích hộp 3–4 lần. Nguyên nhân: theo mặc định, masks.data được trả về ở kích thước inference (ở đây là 640×480), trong khi các hộp dùng pixel của ảnh gốc (1080×810). Cách khắc phục: truyền retina_masks=True như trên, hoặc tự mình điều chỉnh tỷ lệ các số đếm.
Quyết định dựa trên thành phần sử dụng đầu ra, không phải bản demo#
| Nhu cầu downstream | Chỉ dùng hộp có đủ không? | Lý do |
|---|---|---|
| Đếm vật thể hoặc kiểm tra sự hiện diện | Có | Vị trí là toàn bộ câu trả lời |
| Cảnh báo khi vật thể đi vào một vùng | Có | Chỉ cần hộp cắt qua một đường |
| Tracking vật thể qua các frame | Có | Tracker liên kết các hộp |
| Crop để đưa vào classifier thứ hai | Có | Crop chỉ cần hộp |
| Đo diện tích hoặc độ phủ (cỏ dại, gỉ sét, vết tràn) | Không | Hình dạng không đều khiến diện tích hộp trở nên vô nghĩa |
| Tách vật thể khỏi nền (xóa nền, AR) | Không | Bạn cần đường biên chính xác |
| Kiểm tra khoảng hở hoặc tiếp xúc (robot gắp vật, va chạm) | Không | Hộp phóng đại kích thước vật thể |
| Tách các vật thể không đều đang chạm nhau | Thường là không | Các hộp chồng lấn khiến khó xác định pixel nào thuộc về vật thể nào |
Nếu tất cả các hàng tương ứng với nhu cầu sản phẩm đều ghi "có", hãy triển khai detector. Chỉ dùng YOLO26 segmentation khi hình dạng thực sự cần thiết.
Instance segmentation và semantic segmentation#
Instance segmentation tạo mask riêng cho từng vật thể, vì vậy ba chiếc ô tô chồng lấn vẫn được giữ thành ba chiếc riêng biệt. Semantic segmentation gán một lớp cho từng pixel và không cung cấp thông tin nào khác: mọi pixel ô tô trở thành một vùng "ô tô", và không thể đếm riêng nữa. Dùng instance segmentation để đếm hoặc đo từng vật thể — tế bào, trái cây, lỗi sản phẩm. Dùng semantic segmentation để đo độ phủ vùng — đường so với vỉa hè, cây trồng so với đất.
Chi phí gán nhãn hình dạng#
Tạo một hộp cần hai lần nhấp. Một polygon chất lượng tốt có thể cần hàng chục lần, và mỗi đường biên đều có thể khiến người gán nhãn bất đồng: chiếc túi có thuộc về người đó không, bóng đổ có phải là một phần của ô tô không? Hãy tự đo chi phí thay vì tin vào quy tắc kinh nghiệm: tính thời gian người gán nhãn cần để tạo hộp cho 20 vật thể và polygon cho chính 20 vật thể đó, rồi nhân phần chênh lệch với quy mô dataset của bạn.
Các công cụ có AI hỗ trợ giúp thu hẹp đáng kể khoảng cách. Gán nhãn thông minh và gán nhãn hàng loạt đề xuất mask dựa trên một lần nhấp hoặc một hộp, để người gán nhãn chỉnh sửa đường biên thay vì vẽ lại — nhưng vẫn cần có người kiểm tra từng đường biên.
Trước khi bắt đầu gán nhãn, hãy quyết định cách xử lý tình trạng che khuất, đối tượng trong suốt, bóng đổ, đối tượng bị cắt ở mép khung hình và vật gắn kèm (túi, tay cầm, hàng hóa), rồi cung cấp cùng một tài liệu cho người gán nhãn và người đánh giá. Các phương pháp gán nhãn tốt nhất trình bày cách thực thi các quy tắc; dataset COCO-Seg cho thấy các mask nhất quán ở quy mô lớn.
Khi kiểm tra mẫu mask, hãy tìm tràn (mask vượt quá đường biên), lỗ hổng (bỏ sót vùng bên trong vật thể), đường biên giả (mask chạy theo lỗi JPEG) và bộ phận không rõ ràng (tay cầm vali có nằm trong mask của vali không?).
Hiển thị lời giải
Giả sử hai sản phẩm cùng sử dụng camera trên xe buýt: một bộ đếm người và một báo cáo mức độ chiếm dụng đường phố cho biết phương tiện chiếm bao nhiêu phần của khung cảnh. Đo cả hai kết quả từ cùng một lần chạy:
from ultralytics import YOLO

model = YOLO("yolo26n-seg.pt")
result = model("https://ultralytics.com/images/bus.jpg", retina_masks=True, verbose=False)[0]
height, width = result.orig_shape

for name in sorted({result.names[int(c)] for c in result.boxes.cls}):
    rows = [i for i, c in enumerate(result.boxes.cls) if result.names[int(c)] == name]
    union = result.masks.data[rows].amax(dim=0)  # merge masks so overlaps count once
    box_union = sum(float((b[2] - b[0]) * (b[3] - b[1])) for b in result.boxes.xyxy[rows])
    print(f"{name:6} {len(rows)} objects | masks cover {float(union.sum()) / (height * width):.0%} of the image, boxes {box_union / (height * width):.0%}")
bus 1 objects | masks cover 29% of the image, boxes 47%
person 4 objects | masks cover 13% of the image, boxes 28%- Bộ đếm người → hộp. Dù dùng cách nào, kết quả đếm vẫn là 4; mask làm tăng chi phí gán nhãn mà không đem lại thay đổi gì.
- Báo cáo mức độ chiếm dụng → mask. Hộp cho rằng xe buýt chiếm 47% khung cảnh; thực tế chỉ là 29%. Báo cáo dựa trên hộp sẽ sai lệch hơn một nửa.