Tập dữ liệu phản ánh thực tế
Kiểm tra tập dữ liệu thực tế để tìm các khoảng trống về độ bao phủ trước khi gán nhãn thêm, rồi chuyển các khoảng trống đó thành kế hoạch thu thập dữ liệu kèm hard negative.
Phần lớn model thị giác máy tính gây thất vọng không phải vì model kém — mà vì model tốt được huấn luyện trên tập dữ liệu không giống với môi trường triển khai. Bộ phát hiện COCO trong bài học trước không phát hiện được chiếc thuyền nào từ drone vì thuyền trong COCO được chụp từ bên cạnh. Một cuộc kiểm tra kéo dài năm phút sẽ cho thấy các khoảng trống đó trước khi bạn chi tiền gán nhãn.
Thực hành
Model học từ tập dữ liệu, không phải thế giới thực#
Model nội suy giữa các ví dụ mà model đã thấy. Nếu huấn luyện trên đường phố ban ngày nắng ráo rồi triển khai trong gara mù sương vào ban đêm, model sẽ thất bại — không phải vì ô tô trông khác đi, mà vì model chưa từng thấy ô tô trong những điều kiện đó. Sự không tương thích này được gọi là domain shift, và tập validation không thể cảnh báo về vấn đề đó nếu ảnh validation cũng đến từ cùng một tập dữ liệu bị lệch:
Giải pháp mang tính cấu trúc, không phải thuật toán: chủ động lấy mẫu từ môi trường triển khai trước khi gán nhãn. Hướng dẫn về thu thập và gán nhãn dữ liệu trình bày các bước thực hiện.
Kiểm tra tập dữ liệu thực tế#
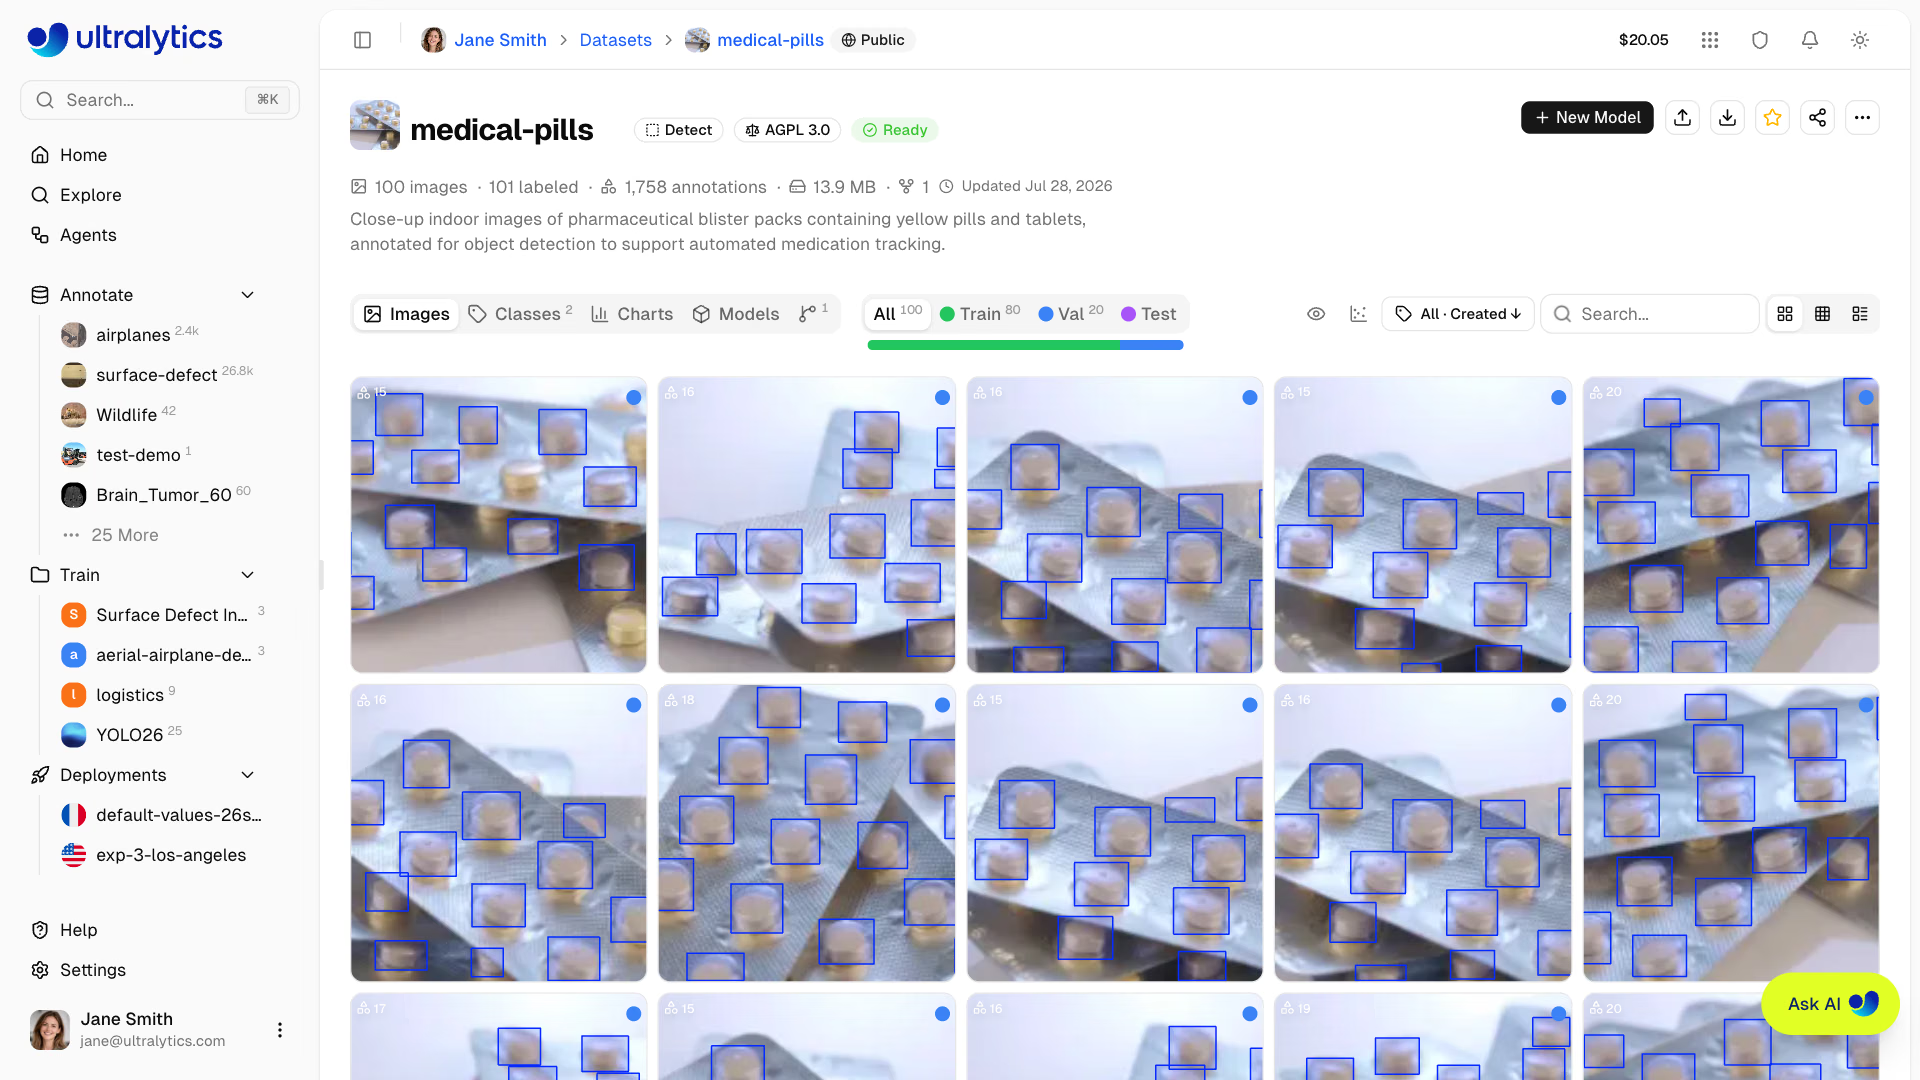
Tập dữ liệu medical-pills phía trên — ảnh cận cảnh các vỉ thuốc, mỗi viên thuốc đều được đóng khung — là đối tượng phù hợp để kiểm tra. Ultralytics Platform hiển thị các số liệu tổng quan trên trang tập dữ liệu; đoạn script bên dưới tính toán các số liệu cho thấy độ bao phủ, trên bản sao đi kèm với ultralytics:
from collections import Counter
from pathlib import Path

from PIL import Image, ImageStat
from ultralytics.data.utils import check_det_dataset

data = check_det_dataset("medical-pills.yaml")  # downloads the dataset on first use

for split in ("train", "val"):
    images = sorted(Path(data[split]).glob("*.jpg"))
    labels = [Path(str(p).replace("/images/", "/labels/")).with_suffix(".txt") for p in images]
    rows = [line.split() for f in labels if f.exists() for line in f.read_text().splitlines()]
    classes = Counter(data["names"][int(r[0])] for r in rows)
    backgrounds = sum(not f.exists() or not f.read_text().strip() for f in labels)
    areas = sorted(float(r[3]) * float(r[4]) for r in rows)  # box area as a share of the image
    sizes = Counter(Image.open(p).size for p in images)
    brightness = [ImageStat.Stat(Image.open(p).convert("L")).mean[0] for p in images]
    print(f"{split}: {len(images)} images, {backgrounds} backgrounds, {dict(classes)}, sizes {dict(sizes)}")
    print(f"  boxes: median {areas[len(areas) // 2]:.1%} of the image, {sum(a < 0.01 for a in areas)} of {len(areas)} under 1%")
    print(f"  brightness: {min(brightness):.0f} to {max(brightness):.0f} (0 = black, 255 = white)")
train: 92 images, 0 backgrounds, {'pill': 1623}, sizes {(1920, 1080): 92}
boxes: median 1.4% of the image, 320 of 1623 under 1%
brightness: 171 to 198 (0 = black, 255 = white)
val: 23 images, 0 backgrounds, {'pill': 399}, sizes {(1920, 1080): 23}
boxes: median 1.4% of the image, 79 of 399 under 1%
brightness: 171 to 198 (0 = black, 255 = white)Đọc nội dung này như báo cáo độ bao phủ, mỗi dòng nêu một phát hiện:
| Phát hiện | Ý nghĩa | Quyết định |
|---|---|---|
| Một độ phân giải, 1920×1080 | Một camera, một thiết lập | Thu thập dữ liệu từ mọi model camera sẽ được triển khai |
| Độ sáng chỉ từ 171–198 | Ánh sáng studio sáng và đồng đều, không có điều kiện thiếu sáng | Thu thập ảnh trong điều kiện thiếu sáng, ngược sáng và ánh sáng hỗn hợp trước khi triển khai tại quầy thuốc |
| 0 ảnh nền | Model không bao giờ thấy cảnh không có thuốc | Thêm vỉ thuốc rỗng, các loại viên thuốc khác và quầy trống làm hard negative |
| Hộp trung vị chiếm 1.4% ảnh; 1 trong 5 hộp nhỏ hơn 1% | Vật thể nhỏ | Giữ imgsz đủ cao và chủ động đưa vào ảnh chụp từ xa |
Một lớp, pill | Không phân loại loại thuốc | Phù hợp để đếm; chỉ thêm lớp nếu cần dùng chúng để đưa ra quyết định |
Không yếu tố nào trong số này thể hiện trong điểm validation, vì tập validation cũng có đầy đủ những đặc điểm đó.
Bốn khía cạnh của độ bao phủ#
| Khía cạnh | Cần thu thập gì | Lỗi thường gặp nếu thiếu |
|---|---|---|
| Ánh sáng | Bình minh, giữa trưa, chạng vạng, ban đêm, chói sáng, ngược sáng, đèn huỳnh quang nhấp nháy | Recall giảm mạnh vào lúc đổi ca hoặc dưới ánh nắng trực tiếp |
| Thời tiết và khí quyển | Mưa, sương mù, tuyết, bụi, hơi nước ngưng tụ trên ống kính | Dương tính giả do giọt nước, bỏ sót đối tượng trong sương mù |
| Che khuất và vật thể gây nhiễu | Đối tượng bị che khuất một phần, cảnh đông đúc, vật thể bị cắt ở mép khung hình | Bỏ sót bất cứ khi nào đối tượng không hiển thị đầy đủ |
| Camera và góc nhìn | Ống kính, độ cao và góc lắp đặt, độ phân giải, mức nén, nhòe chuyển động | Hoạt động tốt trên camera thử nghiệm nhưng thất bại tại địa điểm tiếp theo |
Góc nhìn là khía cạnh mà ví dụ bến du thuyền đã bỏ sót: cùng một lớp nhưng ở góc nhìn mới, recall giảm xuống bằng không.
Hard negative và ảnh nền#
Bộ phát hiện cũng phải học những gì không phải là đối tượng cần phát hiện. Hard negative có vẻ ngoài tương tự: với bộ phát hiện xe nâng, đó có thể là xe nâng tay, xe nâng người dạng cắt kéo, hình phản chiếu của xe nâng trên sàn bóng hoặc áp phích an toàn có in hình xe nâng.
Trong định dạng YOLO, ảnh nền đơn giản là ảnh không có tệp nhãn — không có gì để vẽ. Mẹo huấn luyện của Ultralytics đề xuất ảnh nền chiếm khoảng 0–10% để giảm dương tính giả; bản thân COCO có khoảng 1%. Dùng hard negative từ môi trường của bạn để lấp tỷ lệ đó thay vì dùng các khung hình trống ngẫu nhiên. Tăng cường dữ liệu có thể thay đổi độ sáng và góc chụp, nhưng không thể tạo ra một chiếc xe nâng tay mà model chưa từng thấy.
Các lỗi thường gặp#
Triệu chứng: 10.000 ảnh đã gán nhãn, tất cả đều chụp ban ngày và từ camera thử nghiệm. Cách khắc phục: ghi hình từ các camera triển khai trong toàn bộ điều kiện hoạt động trong vài tuần, kiểm tra độ bao phủ, rồi mới trả tiền gán nhãn. Dữ liệu tổng hợp có thể lấp một khoảng trống đã biết nhưng không thể thay thế dữ liệu ghi nhận thực tế.
Triệu chứng: mAP validation cao nhưng kết quả kém ở địa điểm mới đầu tiên. Cách khắc phục: nhớ rằng validation cũng có các điểm mù của dataset. Lấy ngẫu nhiên mười ảnh huấn luyện và mười khung hình từ production, rồi nhờ đồng nghiệp phân biệt chúng; nếu họ làm được, bạn đang gặp khoảng cách miền dữ liệu.
Để lập kế hoạch lấy mẫu với số lượng mục tiêu cho từng điều kiện, hãy tiếp tục với Thu thập dữ liệu chất lượng cao, có tính đại diện trong Xây dựng bộ dữ liệu YOLO hiệu năng cao.
Hiển thị lời giải
Với bộ dữ liệu medical-pills được triển khai trên quầy nhà thuốc dưới ánh sáng cửa hàng pha trộn, hãy điền bảng lưới từ kết quả kiểm tra (độ sáng 171–198, một nguồn 1920×1080, không có ảnh nền) và lướt nhanh qua các ảnh. Bạn sẽ thấy các gói thuốc giống nhau trên cùng một bề mặt sáng, không có bàn tay:
| Lớp | Ánh sáng studio mạnh | Ánh sáng cửa hàng yếu hoặc ấm | Ngược sáng / lóa | Bị bàn tay che một phần | Camera điện thoại |
|---|---|---|---|---|---|
pill | 2,022 | 0 | 0 | 0 | 0 |
| nền | 0 | 0 | 0 | — | 0 |
Kế hoạch thu thập theo thứ tự ưu tiên:
- Ánh sáng cửa hàng yếu hoặc ấm — điều kiện thông thường trên quầy, hiện chưa có ảnh nào.
- Bị bàn tay che một phần — xảy ra trong gần như mọi tương tác thực tế.
- Camera điện thoại — một cảm biến và độ phân giải thứ hai.
- Ngược sáng / lóa — các gói thuốc bằng lá nhôm phản chiếu cửa sổ và đèn trần.
Mẫu âm khó: vỉ thuốc rỗng (cùng chất liệu lá nhôm, không có thuốc) và các vật thể tròn khác trên quầy — tiền xu, cúc áo, kẹo. Thêm chúng dưới dạng ảnh nền, chiếm khoảng 5–10% bộ dữ liệu.