Xác định bài toán
Chuyển ý tưởng sản phẩm còn mơ hồ thành đặc tả tác vụ gồm ba dòng, đồng thời giữ quy tắc nghiệp vụ trong code để có thể thay đổi mà không cần huấn luyện lại.
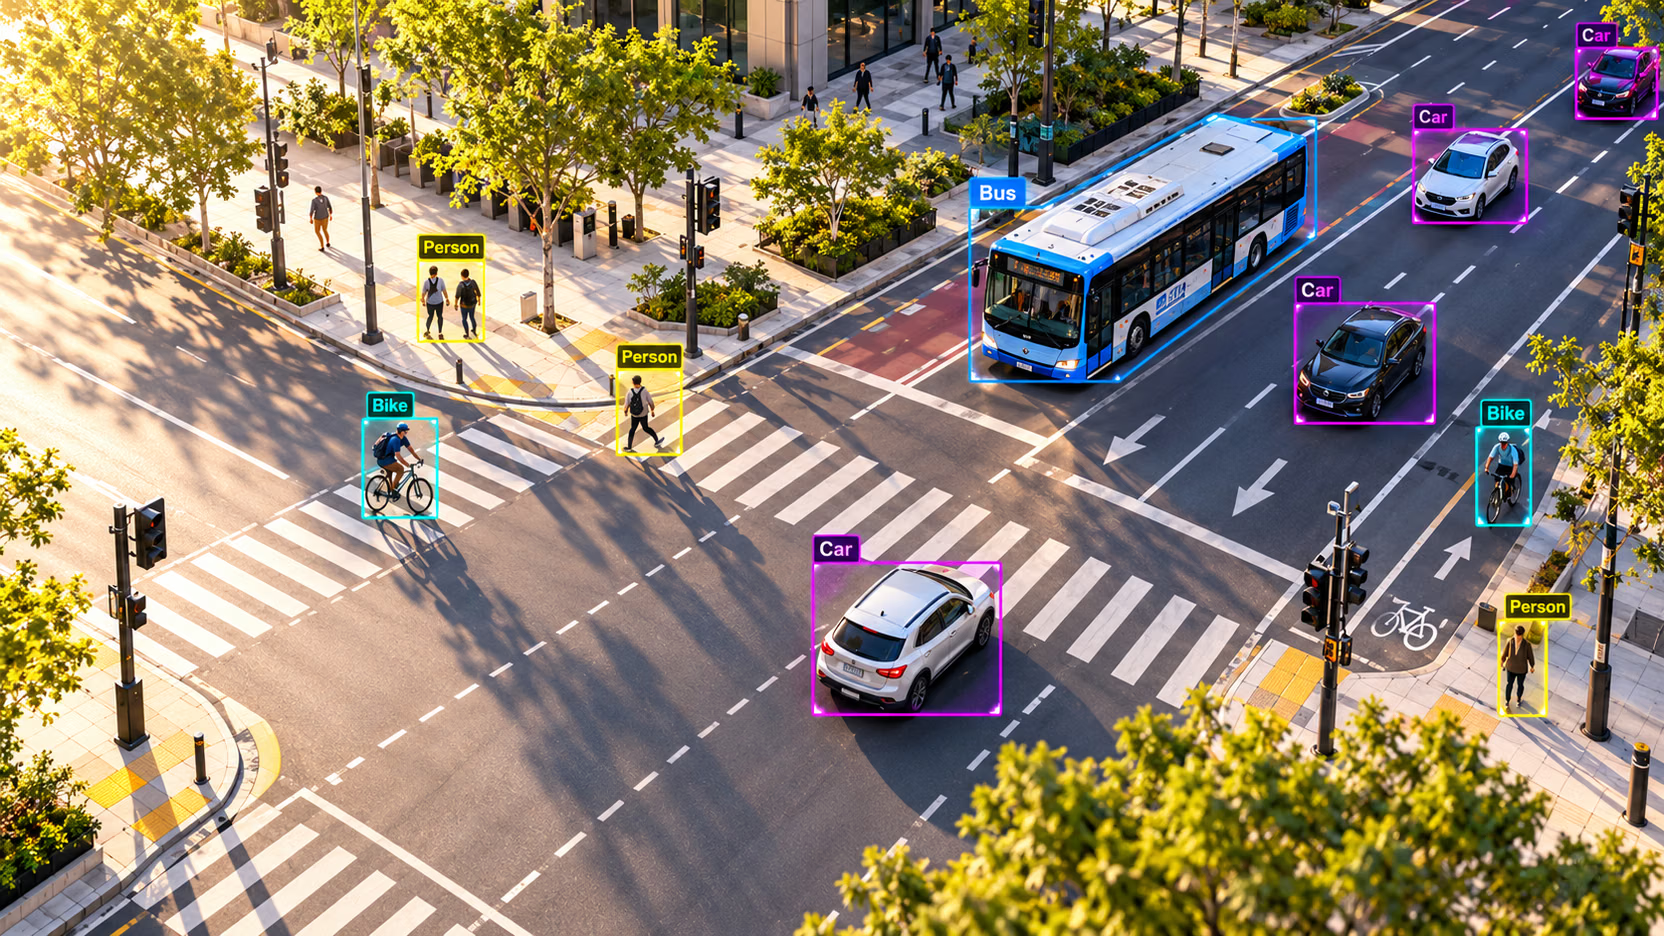
Hầu hết dự án thị giác máy tính bị đình trệ đều chưa từng có câu hỏi rõ ràng. “Phát hiện hành vi không an toàn” nghe có vẻ như một yêu cầu, nhưng người gán nhãn không thể gán nhãn cho yêu cầu đó, model không thể học điều đó và không ai biết khi nào nó hoạt động tốt. Đặc tả ba dòng có thể giải quyết vấn đề này chỉ trong một buổi chiều — đồng thời quyết định tác vụ bạn sẽ huấn luyện, nội dung bạn sẽ gán nhãn và chỉ số bạn sẽ báo cáo.
Thực hành
Vì sao cần đặc tả trước tiên#
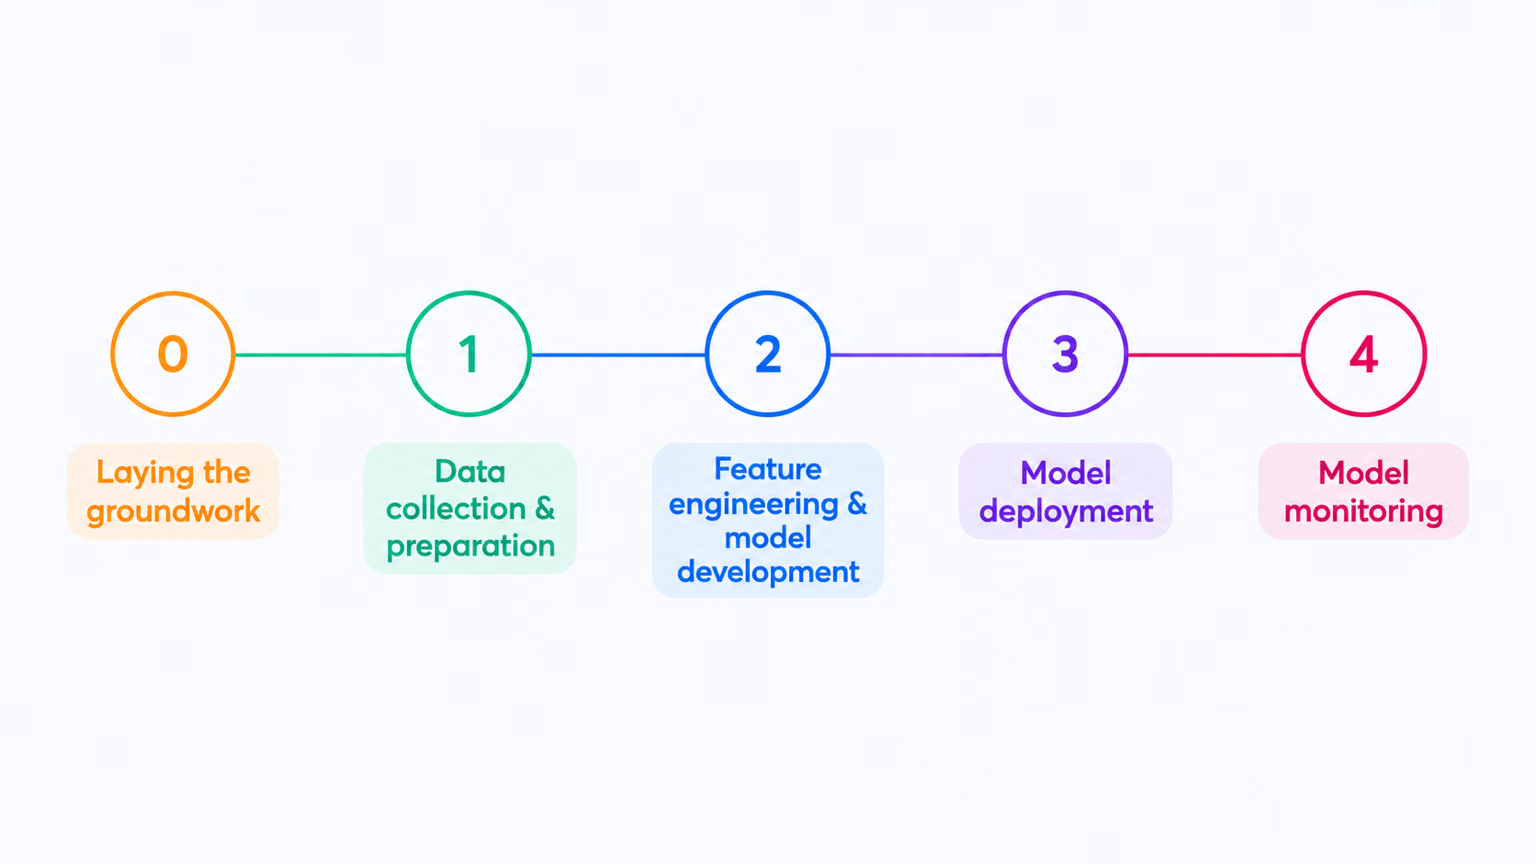
Mọi bước trong dự án thị giác máy tính đều kế thừa mục tiêu từ bước 0. Câu hỏi mơ hồ dẫn đến dataset mơ hồ, người gán nhãn bất đồng và chỉ số đo sai vấn đề — không một lượng huấn luyện nào ở bước 2 có thể khắc phục điều đó.
Ba dòng đặc tả#
Đặc tả tác vụ gồm ba câu, mỗi câu trên một dòng. Mỗi câu trả lời một câu hỏi mà một người khác nhau trong dự án sẽ đặt ra:
| Dòng | Câu hỏi được trả lời | Yếu | Tốt |
|---|---|---|---|
| Đầu vào | Model nhìn thấy gì? | “Video từ camera” | “Các khung hình 1920×1080 ở 5 fps từ 12 camera gắn trên trần” |
| Đầu ra | Dữ liệu nào được trả về? | “Phát hiện vấn đề an toàn” | “Bounding box cho forklift và person, mỗi box kèm một điểm confidence” |
| Quyết định | Ai hành động và khi nào? | “Cải thiện an toàn” | “Thông báo cho giám sát viên ca làm khi xe nâng và một người ở cách nhau dưới 2 m trong 2 giây” |
Dòng đầu ra cần được cân nhắc kỹ nhất vì kiểu dữ liệu của nó quyết định tác vụ:

Một nhãn cho toàn bộ ảnh tương ứng với phân loại; bounding box tương ứng với phát hiện; đường viền tương ứng với phân đoạn; khớp xương tương ứng với pose; bounding box xoay tương ứng với OBB; lớp hoặc khoảng cách cho từng pixel tương ứng với phân đoạn ngữ nghĩa hoặc độ sâu. Bài học tiếp theo sẽ trình bày cả bảy tác vụ.
Ví dụ thực hành: tách biệt model và quy tắc#
“Chúng tôi muốn biết khi nào xe nâng đang làm điều gì nguy hiểm trên sàn kho.”
Đó là một dự án, không phải một tác vụ. Câu này gộp hai việc: tìm xe nâng và người, một bài toán liên quan đến pixel; và quyết định thế nào là nguy hiểm, một vấn đề về chính sách. Hãy tách chúng ra:
Chỉ detector mới là model. Hình thoi là code thuần túy. Bạn có thể thử cách tách này ngay: bus.jpg không có xe nâng, nhưng một chiếc xe buýt và bốn người sẽ cho phép thực hiện cùng bài kiểm thử. Quy tắc đầu tiên là “cảnh báo khi hơn 30% bounding box của một người chồng lấn với bounding box của một phương tiện”:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
result = model("https://ultralytics.com/images/bus.jpg", verbose=False)[0]

# The model's job ends here: a class, a box, and a confidence per object.
people = [b.xyxy[0].tolist() for b in result.boxes if result.names[int(b.cls)] == "person"]
vehicles = [b.xyxy[0].tolist() for b in result.boxes if result.names[int(b.cls)] == "bus"]

def share_inside(a, b):
    """Fraction of box a's area that lies inside box b."""
    w = max(0, min(a[2], b[2]) - max(a[0], b[0]))
    h = max(0, min(a[3], b[3]) - max(a[1], b[1]))
    return w * h / ((a[2] - a[0]) * (a[3] - a[1]))

# The decision rule is plain code: change the policy without retraining.
ALERT_SHARE = 0.30
for person in people:
    share = max(share_inside(person, v) for v in vehicles)
    print(f"person at x={person[0]:3.0f}: {share:4.0%} inside the bus box -> {'ALERT' if share > ALERT_SHARE else 'ok'}")
person at x= 49: 70% inside the bus box -> ALERT
person at x=223: 76% inside the bus box -> ALERT
person at x=670: 70% inside the bus box -> ALERT
person at x= 0: 62% inside the bus box -> ALERTCả bốn cảnh báo đều sai: những người này đang ở trên vỉa hè phía trước một chiếc xe buýt đang đỗ. Detector xác định đúng mọi bounding box; quy tắc sai vì các đối tượng chồng lấn trong ảnh 2D không có nghĩa là chúng ở gần nhau ngoài đời. Vì quy tắc là code, cách khắc phục cũng là code. So sánh vị trí chân mỗi người chạm đất với đường bánh xe buýt:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
result = model("https://ultralytics.com/images/bus.jpg", verbose=False)[0]
people = [b.xyxy[0].tolist() for b in result.boxes if result.names[int(b.cls)] == "person"]
vehicles = [b.xyxy[0].tolist() for b in result.boxes if result.names[int(b.cls)] == "bus"]

def same_ground_line(person, vehicle, tolerance=40):
    """True when the person's feet are level with the vehicle's wheels and inside its width."""
    feet_x, feet_y = (person[0] + person[2]) / 2, person[3]
    return vehicle[0] < feet_x < vehicle[2] and abs(feet_y - vehicle[3]) < tolerance

for person in people:
    alert = any(same_ground_line(person, v) for v in vehicles)
    print(f"person at x={person[0]:3.0f}: feet y={person[3]:.0f}, bus wheels y={vehicles[0][3]:.0f} -> {'ALERT' if alert else 'ok'}")
person at x= 49: feet y=902, bus wheels y=751 -> ok
person at x=223: feet y=861, bus wheels y=751 -> ok
person at x=670: feet y=880, bus wheels y=751 -> ok
person at x= 0: feet y=871, bus wheels y=751 -> okChân của mỗi người nằm thấp hơn đường bánh xe 110–150 pixel, nên họ đứng gần camera hơn chiếc xe buýt. Không cần huấn luyện lại, không cần gán nhãn lại: nhóm an toàn có thể tiếp tục tinh chỉnh quy tắc trong khi detector không đổi. Phiên bản production sẽ ánh xạ vị trí chân sang tọa độ mặt sàn bằng camera đã hiệu chuẩn và thêm điều kiện duy trì 2 giây thông qua theo dõi đối tượng — vẫn là code chạy trên cùng các bounding box.
Các từ mang tính chủ quan — "không an toàn", "lỗi", "đáng ngờ", "VIP" — thuộc về code đọc đầu ra của model. Model trả lời các câu hỏi về pixel. Nếu hai chuyên gia có thể tranh luận về một nhãn, cuộc tranh luận đó nên được xử lý bằng một quy tắc mà bạn có thể quản lý phiên bản, kiểm thử và thay đổi.
Các lỗi thường gặp#
Triệu chứng: đặc tả ghi "phát hiện vấn đề an toàn" hoặc "hiểu khung cảnh", khiến người gán nhãn hỏi cần vẽ gì. Cách khắc phục: viết lại đầu ra dưới dạng một kiểu dữ liệu có các lớp được đặt tên: "các hộp cho forklift và person."
Triệu chứng: một lớp như suspicious_behavior hoặc dangerous được hai người gán nhãn khác nhau trên cùng một khung hình. Cách khắc phục: thay thế bằng bằng chứng có thể quan sát được — một người ở trong khu vực hạn chế, một cánh cửa bị giữ mở — và chuyển phần đánh giá vào dòng quyết định.
Triệu chứng: "mô tả những gì đang diễn ra" (tạo chú thích) hoặc "dự đoán xe nâng có đâm vào ai không" (dự báo). Cách khắc phục: trước tiên xác định vị trí các đối tượng, sau đó bổ sung quy tắc theo dõi và chuyển động. Xây dựng detector trước khi dự đoán.
Từ đặc tả đến tiêu chí thành công#
Đặc tả cho biết model làm gì, chứ không phải mức độ tốt nào là đủ hay một lần bỏ sót sẽ gây thiệt hại ra sao so với một cảnh báo sai. Bắt đầu từ mục tiêu kinh doanh trong Xây dựng dataset YOLO hiệu năng cao chuyển đặc tả thành các mục tiêu có thể đo lường. Mọi bài học tiếp theo trong khóa học này đều tham chiếu lại ba dòng của bạn.
Hiển thị lời giải
Đặc tả cho camera kệ hàng:
- Đầu vào: một ảnh tĩnh 1920×1080 mỗi 60 giây từ camera cố định hướng vào một lối đi.
- Đầu ra: bounding box cho
productvàempty_facing(một vị trí trên kệ không có sản phẩm), mỗi box kèm một điểm confidence. - Quyết định: tạo tác vụ bổ sung hàng khi có từ ba bounding box
empty_facingtrở lên trên cùng một kệ, tồn tại qua năm ảnh tĩnh liên tiếp trong giờ mở cửa.
Những từ mà model không thể nhìn thấy là tác vụ bổ sung hàng, cùng một kệ, tồn tại qua năm ảnh tĩnh và giờ mở cửa. Viết thành quy tắc:
if count(empty_facing on shelf S) >= 3 in each of the last 5 stills and store_is_open(now):
    create_restock_task(shelf=S)
Cửa hàng có thể thay đổi “3”, “5” hoặc giờ mở cửa mà không cần gán nhãn lại dù chỉ một ảnh.