Gán nhãn thông minh và gán nhãn hàng loạt
Chọn model gán nhãn và ngưỡng confidence bằng cách đo khối lượng công việc cần rà soát, sau đó chạy Batch Annotation và xác minh bằng tỷ lệ chỉnh sửa.
Vẽ box thủ công có thể chỉ đạt khoảng 100 ảnh mỗi giờ; rà soát các nhãn sơ bộ tốt có thể nhanh hơn gấp nhiều lần. Nhưng model gán nhãn với ngưỡng confidence không phù hợp có thể tạo thêm việc thay vì tiết kiệm công sức, còn nếu không rà soát, model sẽ khiến model tiếp theo học theo chính những lỗi đó. Bài học này đo khối lượng rà soát ở từng ngưỡng trên dữ liệu đã gán nhãn thực tế, giúp bạn chọn ngưỡng dựa trên số liệu thay vì phỏng đoán.
Thực hành
Ba cách gán nhãn sơ bộ#
Trong trình chỉnh sửa annotation, chế độ Draw (V) là thủ công, còn chế độ Smart (S) cho phép model đề xuất nhãn:
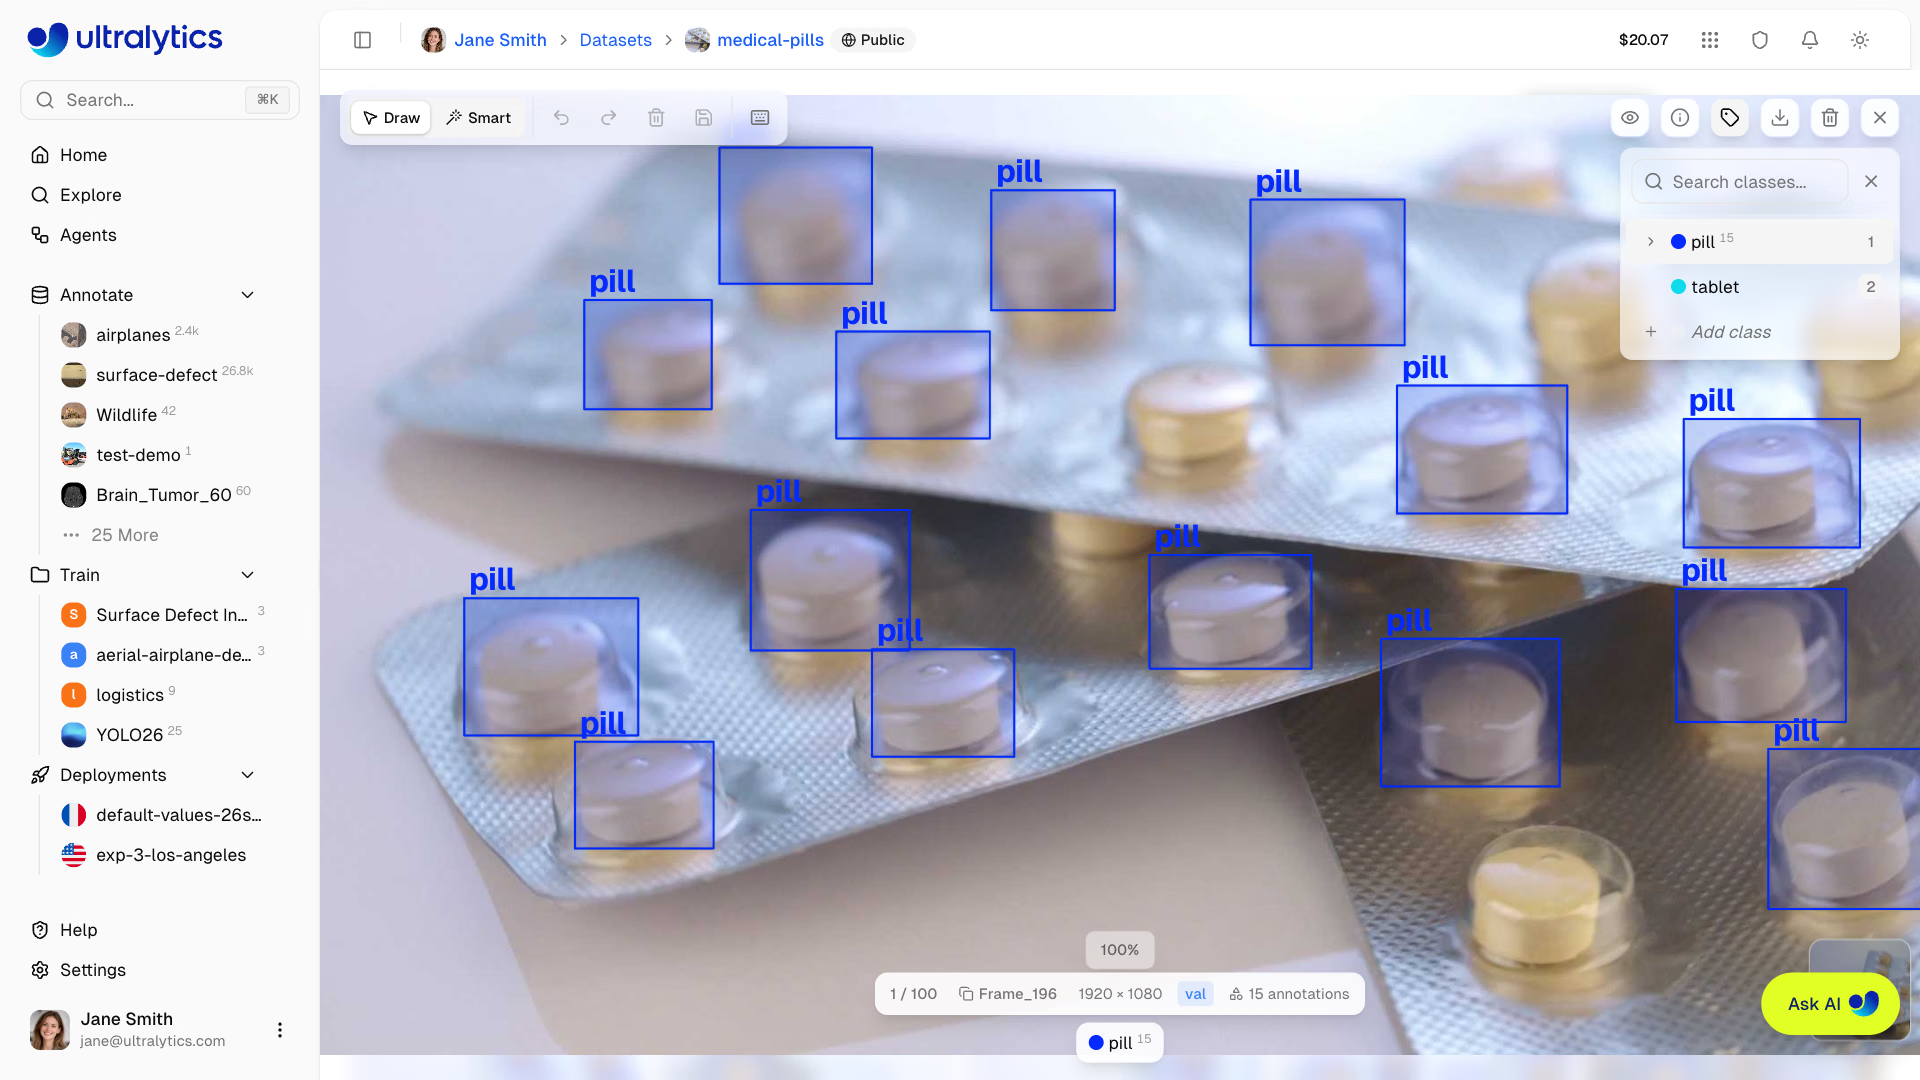
| Dòng model | Cách hoạt động | Tác vụ | Chi phí |
|---|---|---|---|
| SAM (SAM 2.1 Tiny đến Large, SAM 3, SAM 3.1 mặc định) | Nhấp vào một đối tượng để tạo mask; nhấp bên ngoài để thêm, nhấp bên trong để xóa; A bật/tắt tự động áp dụng | Phát hiện, phân đoạn, ngữ nghĩa, OBB | Free |
| YOLO (model chính thức hoặc model của bạn) | Predict thêm các kết quả phát hiện của model; Map classes căn chỉnh class của model với class của dataset; các box trùng lặp có IoU từ 0.7 trở lên sẽ bị bỏ qua | Phát hiện, phân đoạn, ngữ nghĩa, OBB, pose | Miễn phí trong trình chỉnh sửa |
| Nhận prompt class (Moondream 3.1 mặc định, YOLOE-26x, SAM 3 Text và các model khác) | Tìm tên class của dataset trong ảnh; model của nhà cung cấp tính phí sẽ chạy bằng API key của bạn | Dataset phát hiện có 1–200 class | Model được lưu trữ miễn phí |
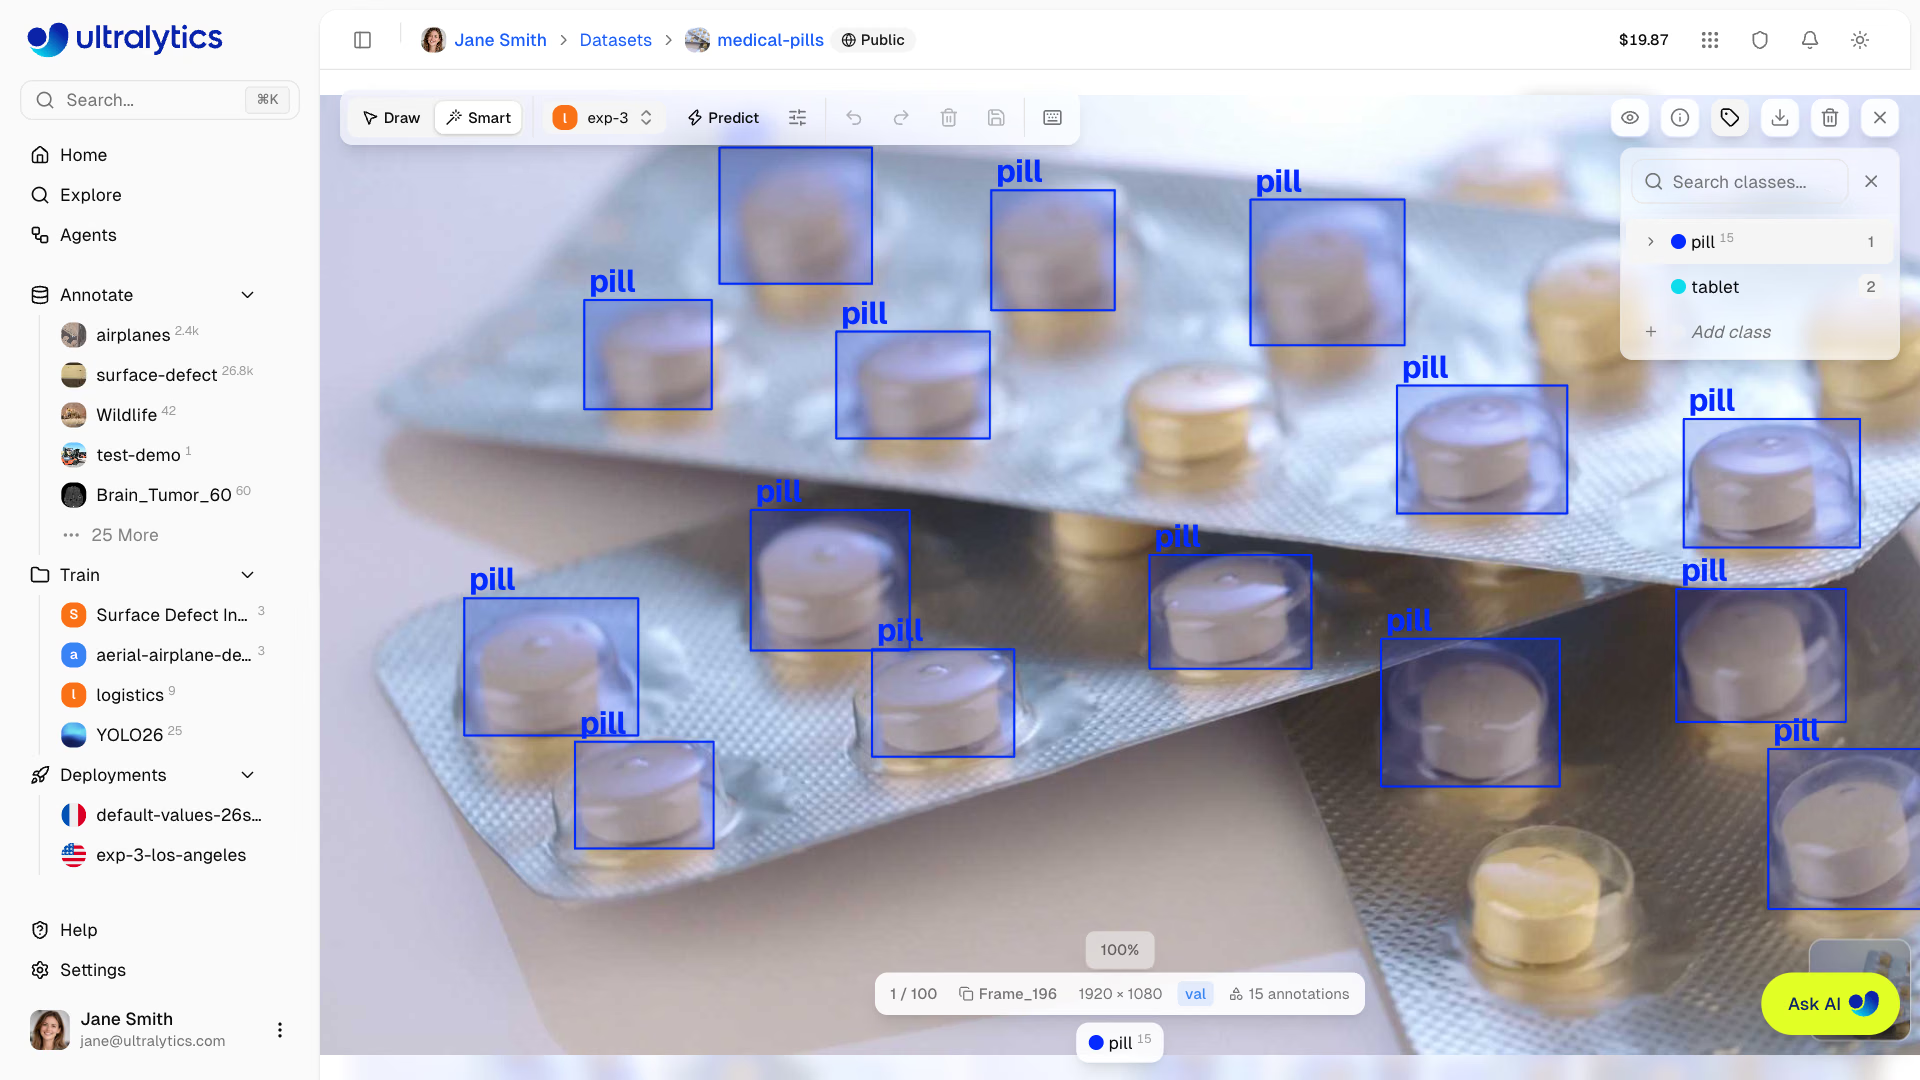
SAM cần một lần nhấp cho mỗi đối tượng và tạo hình dạng sát nhất. Dự đoán của model chỉ cần một lần nhấp cho mỗi ảnh và chất lượng phụ thuộc vào model, vì vậy phần còn lại của bài học tập trung vào việc chọn và tinh chỉnh model đó.
Chọn model gán nhãn#
Model v0 còn yếu, được train trên 100–200 nhãn thủ công, vẫn tốt hơn bắt đầu vẽ từ đầu; đến v1, model thường đã trở thành đối tác học chủ động hữu ích. Hiệu quả của model nhận prompt class thay đổi đáng kể theo domain: một số model phát hiện gần như mọi thứ trong ảnh đời thường nhưng lại bỏ sót hầu hết đối tượng trong ảnh PCB, X-quang hoặc bán lẻ, vì vậy hãy kiểm tra mười dự đoán trước khi tin dùng.
Ví dụ thực hành: Đo khối lượng rà soát ở từng ngưỡng#
Ngưỡng confidence quyết định nội dung người rà soát sẽ dành thời gian xử lý: quá thấp thì họ xóa các box false positive, quá cao thì họ vẽ những box model bỏ sót. Hãy đo trên các ảnh đã có nhãn chính xác; ở đây là 128 ảnh có nhãn của COCO128, dùng YOLO26n pretrained làm model gán nhãn:
from pathlib import Path

import torch

from ultralytics import YOLO
from ultralytics.data.utils import check_det_dataset
from ultralytics.utils.metrics import box_iou
from ultralytics.utils.ops import xywhn2xyxy

data = check_det_dataset("coco128.yaml")  # 128 labeled images, downloaded on first use
images = sorted(Path(data["train"]).glob("*.jpg"))
results = YOLO("yolo26n.pt").predict(images, conf=0.05, verbose=False)  # your labeling model

def review_work(result, image, conf):
    """Return (kept, delete, draw): correct pre-labels, false positives to delete, missed objects to draw."""
    label = Path(str(image).replace("images", "labels")).with_suffix(".txt")
    lines = label.read_text().splitlines() if label.exists() else []  # no label file = background image
    gt = torch.tensor([[float(x) for x in line.split()] for line in lines]).reshape(-1, 5)
    h, w = result.orig_shape
    gt_boxes, gt_cls = xywhn2xyxy(gt[:, 1:], w=w, h=h), gt[:, 0]
    boxes = result.boxes[result.boxes.conf >= conf]
    iou = box_iou(boxes.xyxy, gt_boxes) * (boxes.cls[:, None] == gt_cls[None])  # IoU with same-class boxes only
    matched = set()
    for row in iou:  # greedily match each prediction to its best unmatched ground-truth box
        for j in row.argsort(descending=True).tolist():
            if row[j] >= 0.5 and j not in matched:
                matched.add(j)
                break
    return len(matched), len(boxes) - len(matched), len(gt) - len(matched)

print("conf  kept  delete  draw  edits/image")
for conf in (0.1, 0.25, 0.4, 0.5, 0.7):
    kept, delete, draw = (sum(t) for t in zip(*(review_work(r, i, conf) for r, i in zip(results, images))))
    print(f"{conf:<5} {kept:>4} {delete:>7} {draw:>5} {(delete + draw) / len(images):>12.1f}")
conf kept delete draw edits/image
0.1 590 490 339 6.5
0.25 468 138 461 4.7
0.4 386 58 543 4.7
0.5 328 35 601 5.0
0.7 230 6 699 5.5Cách hoạt động và ý nghĩa kết quả:
- Model dự đoán một lần ở mức
conf=0.05thấp; mỗi ngưỡng sau đó lọc cùng một tập dự đoán, nên việc thử nhiều ngưỡng diễn ra nhanh. review_workghép mỗi dự đoán với một box ground truth cùng class có IoU từ 0.5 trở lên. Dự đoán không được ghép là các box người rà soát sẽ xóa; ground truth không được ghép là các đối tượng người rà soát sẽ vẽ.- Số lần chỉnh sửa trên mỗi ảnh thấp nhất ở mức 0.25–0.4 (4.7). Thấp hơn mức đó, số lần xóa tăng vọt; cao hơn, số đối tượng bị bỏ sót tăng vọt.
- Ngay cả ở ngưỡng tốt nhất, người rà soát vẫn phải vẽ khoảng 3.6 box mỗi ảnh vì có nhiều đối tượng nhỏ, ít phổ biến trong COCO mà model nano khó xử lý.
Quy tắc ra quyết định: chọn ngưỡng có số lần chỉnh sửa trên mỗi ảnh thấp nhất. Nếu vẽ chiếm ưu thế ở mọi ngưỡng, model gán nhãn quá yếu đối với dữ liệu; hãy dùng model lớn hơn hoặc model fine-tune của bạn. Nếu xóa vẫn chiếm ưu thế ngay cả ở mức 0.5, model nhầm lẫn các class có hình thức tương tự; hãy kiểm tra confusion matrix trước khi gán nhãn thêm. Với dự án của bạn, hãy chạy thử nhiều ngưỡng bằng model fine-tune trên 50–100 ảnh bạn đã gán nhãn.
Chạy Batch Annotation#
Batch Annotation chạy một model YOLO hoặc nhận prompt class trên toàn bộ dataset. Mở tính năng này từ More actions > Batch Annotation, hoặc chọn Annotate all trong thông báo hiện ra sau khi dự đoán bằng trình chỉnh sửa:
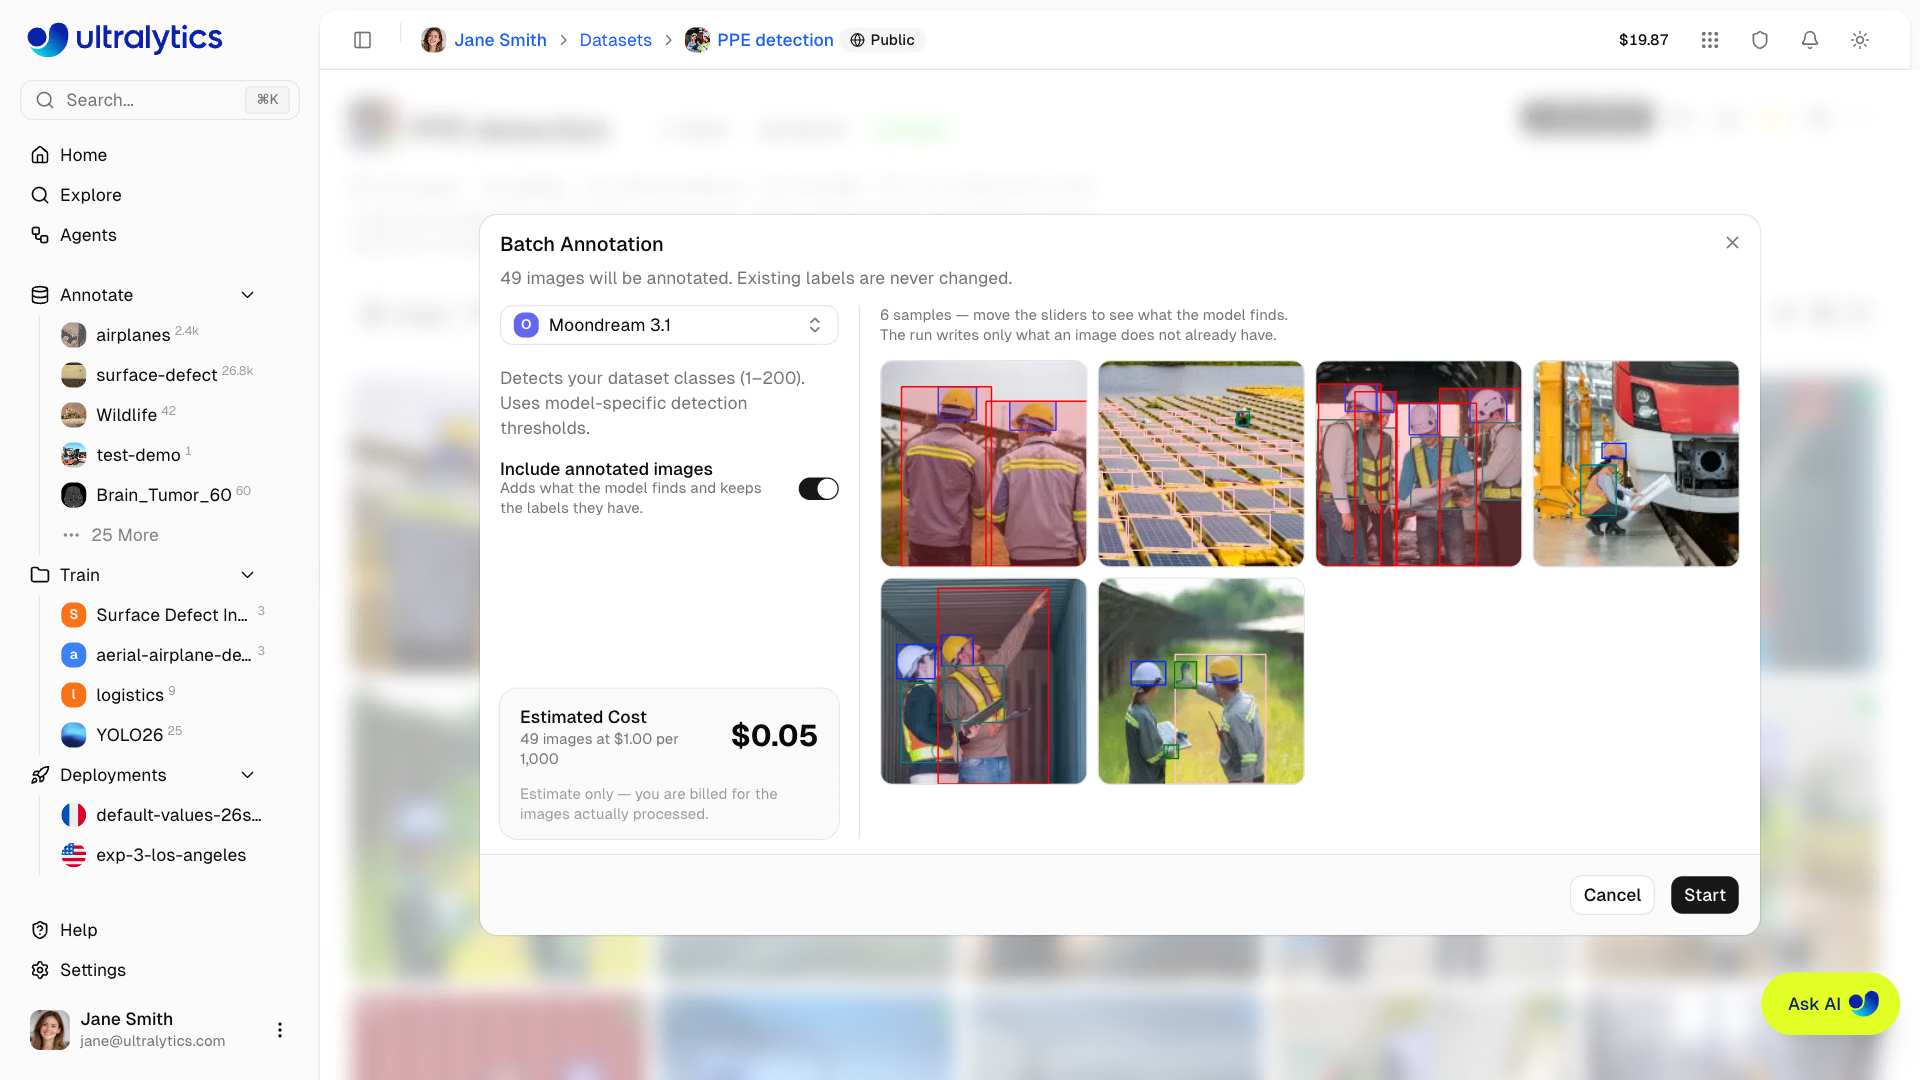
- Chọn model. Dataset phát hiện sẽ mở với Moondream 3.1 được chọn; hãy chuyển sang model fine-tune hoặc model YOLO của bạn.
- Với model YOLO, đặt confidence bằng ngưỡng bạn đã chọn sau khi thử (mặc định là
0.25) và đặt IoU (0.7), rồi kiểm tra các bản xem trước. - Để tắt Include annotated images để chỉ gán nhãn cho các ảnh chưa có nhãn.
- Kiểm tra Estimated Cost ($1.00 cho mỗi 1.000 ảnh, tối thiểu $0.01), rồi nhấp vào Start.
Khi bắt đầu một lượt chạy, hệ thống sẽ lưu phiên bản dataset trước, để bạn có thể khôi phục trạng thái trước khi chạy. Stop giữ lại các ảnh đã xử lý đến thời điểm đó và tính phí cho chúng.
Rà soát rồi đo tỷ lệ chỉnh sửa#
Dự đoán được thêm dưới dạng annotation thông thường nên không có dấu hiệu nào cho biết chúng chưa được rà soát. Lọc theo class để kiểm tra các class hiếm trước, rồi sắp xếp theo Annotations tăng dần (có thể bị bỏ sót) và giảm dần (cảnh đông đúc, nơi các box có thể nhập vào nhau). Sau đó tạo một phiên bản, mở Compare versions trong tab Versions và chọn v_auto làm phiên bản From:
| Loại chỉnh sửa | Ý nghĩa |
|---|---|
| Đã thêm | Các đối tượng model bỏ sót, cộng với bản sao đã chỉnh sửa của mỗi box được sửa |
| Đã xóa | Các false positive, cộng với bản gốc của mỗi box được sửa |
| Tỷ lệ chỉnh sửa | (số mục đã thêm + số mục đã xóa) ÷ số annotation trong v_auto, là giới hạn trên vì một box được sửa sẽ được tính hai lần |
Theo dõi tỷ lệ chỉnh sửa của từng batch. Tỷ lệ tăng là dấu hiệu cảnh báo sớm rằng ảnh mới đã khác với dữ liệu mà model gán nhãn đã học. Bài học về các phương pháp gán nhãn tốt nhất đề cập đến hướng dẫn gán nhãn và mức độ thống nhất giữa người rà soát.
Các lỗi thường gặp#
Triệu chứng: mỗi lần huấn luyện lại đều đạt điểm gần như cũ và luôn bỏ sót cùng những đối tượng đó. Cách khắc phục: nhãn sơ bộ chưa được rà soát sẽ biến lỗi có hệ thống của model gán nhãn thành dữ liệu đúng trong dataset: lớp dễ nhầm, cạnh box thường bị nới lỏng, các đối tượng model không bao giờ phát hiện. Hãy rà soát mọi ảnh trước khi đưa ảnh vào phiên bản dùng để huấn luyện.
Triệu chứng: Batch Annotation hoàn tất nhưng phần lớn đối tượng vẫn chưa được gán nhãn. Cách khắc phục: trước tiên, chạy model trong trình chỉnh sửa trên mười ảnh đại diện. Nếu model bỏ sót hơn vài đối tượng, hãy tự gán nhãn một tập dữ liệu khởi đầu rồi huấn luyện phiên bản v0.
Triệu chứng: các bounding box dự đoán mang tên class sai. Cách khắc phục: khi các class của model khác với class của dataset, bước Map classes ánh xạ từng class của model sang một class của dataset hoặc bỏ qua class đó. Hãy ánh xạ cẩn thận; ánh xạ sai sẽ đổi nhãn mọi bounding box thuộc class đó.
Hiển thị lời giải
Ví dụ thực tế: quá trình sweep chọn ngưỡng 0.35 cho lần fine-tune kiểm tra thuốc dạng viên. Batch Annotation lưu v4 với 1,240 annotation. Sau khi xem lại, Compare versions v4 → v5 cho thấy có 96 annotation được thêm và 152 annotation bị xóa, vậy tỷ lệ chỉnh sửa là (96 + 152) ÷ 1,240 = 20%. Số annotation bị xóa nhiều hơn số được thêm cho thấy model dự đoán thừa: kiểm tra các BBox bị xóa cho thấy model đánh dấu hình phản chiếu trên vỉ thuốc thành thuốc viên. Có hai hành động cần thực hiện: tăng confidence lên một mức (0.35 → 0.45) cho batch tiếp theo và xác nhận tỷ lệ giảm; đồng thời thêm 30 ảnh vỉ thuốc bóng đã xem xét vào phiên bản training tiếp theo để fine-tune học cách phân biệt.