Theo dõi tình trạng và độ chính xác
Đọc các chỉ số endpoint và thống kê dự đoán của Platform, gửi cảnh báo từ health check được lên lịch và phát hiện suy giảm độ chính xác bằng tác vụ holdout.
Endpoint có thể trả về 200 OK cho mọi request trong khi độ chính xác giảm 5 điểm vì ca đêm đã giảm độ sáng đèn. Platform cho biết tình trạng hoạt động của từng endpoint, nhưng không gửi thông báo cảnh báo và không thể đánh giá độ chính xác nếu thiếu nhãn. Bài học này xây dựng hai bước kiểm tra theo lịch để khắc phục khoảng trống đó, đồng thời diễn tập cảnh báo độ chính xác bằng cách mô phỏng ca đêm.
Thực hành
Thông tin Platform hiển thị#

| Tín hiệu | Vị trí | Thời gian lưu trữ |
|---|---|---|
| HTTP requests, tỷ lệ lỗi (4xx và 5xx), độ trễ P95 | Các thẻ trên trang deployment và tab Deployments, được làm mới mỗi phút | Các thẻ bao phủ 24 giờ; API cung cấp dữ liệu từ 1 giờ đến 30 ngày |
| Tình trạng sức khỏe | Thẻ Endpoint trong tab Overview | Trực tiếp; tự động thử lại khi endpoint không khỏe mạnh |
| Logs | Tab Logs: 20 mục mới nhất, bộ lọc Errors | API trả về tối đa 200 mục mỗi request, có phân trang |
| Thống kê dự đoán và ví dụ tạm thời (tối đa 100 ảnh) | Tab Monitoring | Chỉ lưu trong bộ nhớ của instance đang phục vụ |
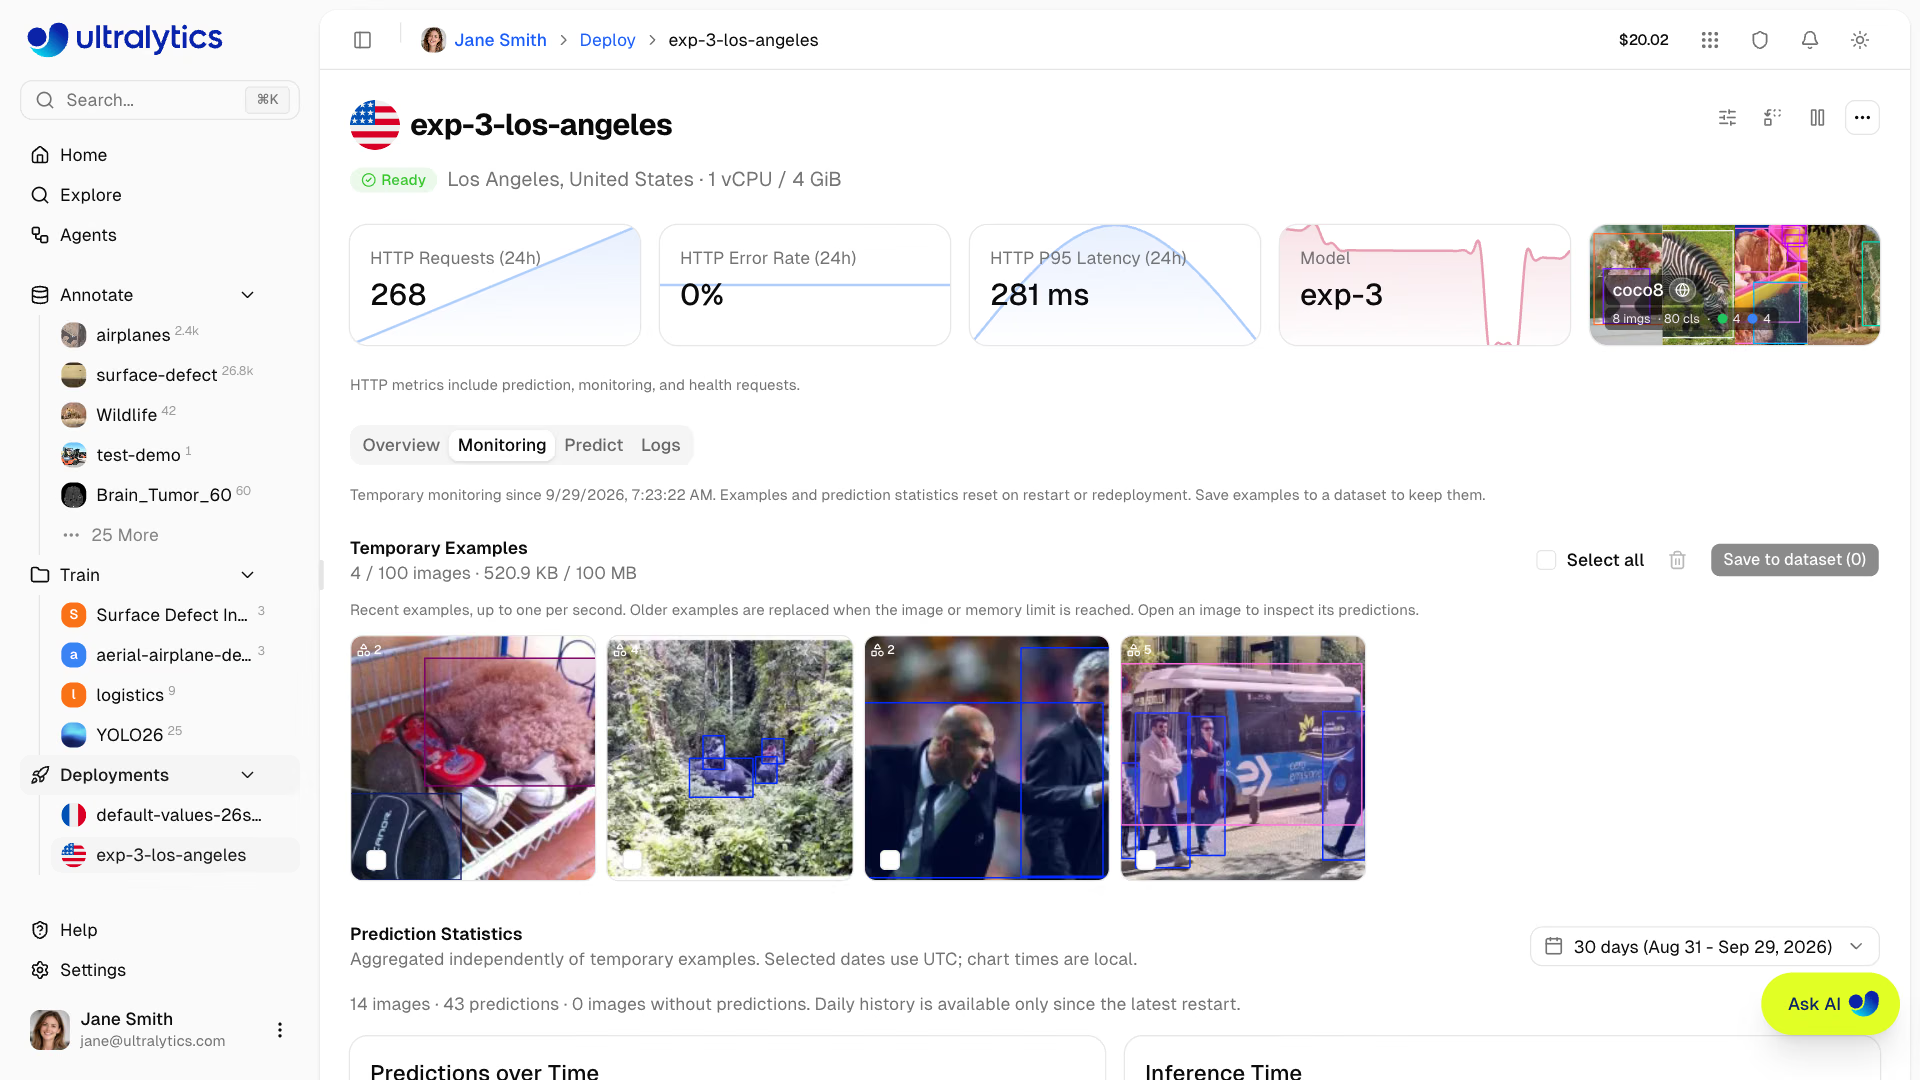
Hai điểm cần lưu ý ảnh hưởng đến mọi nội dung khác. Chỉ thu thập chỉ số khi endpoint ở trạng thái Ready, và xóa deployment sẽ chấm dứt quyền truy cập vào lịch sử. Thống kê và ví dụ trong tab Monitoring sẽ mất mỗi khi endpoint dừng, khởi động lại, đổi kích thước hoặc thay model: đây là chế độ xem trực tiếp, không phải kho lưu trữ.
Ví dụ thực tế: Kiểm tra endpoint theo lịch#
Platform chuyển thẻ tỷ lệ lỗi sang màu đỏ khi vượt 5%, còn Slack có thể thông báo khi deployment sẵn sàng hoặc không khởi động được, nhưng không có cảnh báo theo ngưỡng. Chạy bước kiểm tra này mỗi 5 phút bằng cron, CI hoặc agent giám sát, và gửi cảnh báo khi mã thoát khác 0:
from ultralytics_platform import Platform

OWNER, DEPLOYMENT = "your-username", "yolo26n-iowa"  # from the deployment page URL
P95_BUDGET_MS, MAX_ERROR_RATE = 300, 1.0  # errorRate is a percentage

with Platform() as client:  # reads ULTRALYTICS_API_KEY
    health = client.deployments.health(OWNER, DEPLOYMENT)
    summary = client.deployments.metrics(OWNER, DEPLOYMENT, range="1h", view="overview")["summary"]
    print(
        f"healthy={health['healthy']} requests={summary['totalRequests']} "
        f"p95={summary['p95LatencyMs']:.0f} ms errors={summary['errorRate']:.2f}%"
    )
    if not health["healthy"] or summary["p95LatencyMs"] > P95_BUDGET_MS or summary["errorRate"] > MAX_ERROR_RATE:
        for entry in client.deployments.logs(OWNER, DEPLOYMENT, severity="ERROR,WARNING", limit=5)["entries"]:
            print(entry["timestamp"], entry["severity"], entry["message"][:120])
        raise SystemExit(1)  # non-zero exit lets cron, CI, or your pager treat it as an alert
Khi chạy với API giả lập trả về endpoint khỏe mạnh, chương trình in một dòng rồi thoát với mã 0; với P95_BUDGET_MS = 100, cùng dữ liệu sẽ thoát với mã 1:
healthy=True requests=1200 p95=180 ms errors=0.40%healthping endpoint và trả vềhealthy,statusvàlatencyMs. Lệnh này cũng đánh thức endpoint đã tự giảm về 0, nên lịch 5 phút đồng thời đóng vai trò ping giữ endpoint luôn ấm.metrics(..., view="overview")trả vềtotalRequests,errorRate(một tỷ lệ phần trăm) vàp95LatencyMscho khoảng thời gian.logslấy các lỗi và cảnh báo mới nhất, để thông báo cảnh báo đi kèm manh mối đầu tiên.
Cài đặt SDK bằng pip install -U ultralytics-platform (SDK yêu cầu Python 3.11+). Chỉ gửi cảnh báo khi vi phạm ngưỡng liên tục, chẳng hạn ba lần kiểm tra thất bại liên tiếp, và bổ sung một dòng hướng dẫn xử lý cho mỗi cảnh báo.
Ví dụ thực tế: Theo dõi độ chính xác bằng tập holdout#
Chỉ số request không thể đo độ chính xác; tập holdout thì có thể: 200–500 ảnh gần với dữ liệu production, được gán nhãn cẩn thận, nằm trong phiên bản dataset riêng tư và chưa từng được dùng để huấn luyện. Hàng tuần, đánh giá checkpoint đã triển khai và nối kết quả vào file lịch sử:
import json
import sys
from datetime import date
from pathlib import Path

from ultralytics import YOLO

DEPLOYED = "pills-v1.pt"  # the exact best.pt behind the endpoint
HOLDOUT = sys.argv[1] if len(sys.argv) > 1 else "medical-pills.yaml"  # labeled, never trained on

metrics = YOLO(DEPLOYED).val(data=HOLDOUT, split="val", plots=False, verbose=False)
history = Path("holdout_history.jsonl")
rows = [json.loads(line) for line in history.read_text().splitlines()] if history.exists() else []
row = {"date": date.today().isoformat(), "data": HOLDOUT, "map50_95": round(float(metrics.box.map), 4)}
history.write_text("".join(json.dumps(r) + "\n" for r in [*rows, row]))

baseline = rows[0]["map50_95"] if rows else row["map50_95"]
drop = baseline - row["map50_95"]
print(f"holdout mAP50-95 {row['map50_95']:.3f} (baseline {baseline:.3f}, drop {drop:+.3f})")
if drop > 0.01:  # more than 1 mAP point below the deployment-day baseline
    raise SystemExit("ALERT: holdout accuracy regressed - open the retraining runbook")
Lần chạy đầu tiên ghi lại baseline vào ngày triển khai. Sau đó, hãy diễn tập cảnh báo trước khi cần dùng: script này tạo bản sao "ca đêm" của tập holdout, giữ nguyên nhãn và ảnh nhưng giảm độ sáng xuống 15%:
import shutil
from pathlib import Path

import cv2

from ultralytics.data.utils import check_det_dataset

src = Path(check_det_dataset("medical-pills.yaml")["path"])
dst = Path("pills-night")
(dst / "images/val").mkdir(parents=True, exist_ok=True)
for img in (src / "images/val").glob("*.jpg"):  # darken every holdout image to mimic a dim night shift
    cv2.imwrite(str(dst / "images/val" / img.name), (cv2.imread(str(img)) * 0.15).astype("uint8"))
shutil.copytree(src / "labels/val", dst / "labels/val", dirs_exist_ok=True)  # same labels, darker pixels
Path("pills-night.yaml").write_text(f"path: {dst.resolve()}\ntrain: images/val\nval: images/val\nnames:\n  0: pill\n")
print("wrote pills-night.yaml")
$ python holdout_check.py
holdout mAP50-95 0.659 (baseline 0.659, drop +0.000)
$ python simulate_night_shift.py
wrote pills-night.yaml
$ python holdout_check.py pills-night.yaml
holdout mAP50-95 0.609 (baseline 0.659, drop +0.050)
ALERT: holdout accuracy regressed - open the retraining runbookMọi request trong ca đêm vẫn sẽ trả về 200 chỉ trong vài mili giây, nhưng model đã mất 5 điểm mAP. Chỉ tập holdout mới phát hiện được điều này. Mỗi quý, làm mới tập holdout bằng ảnh production mới được gán nhãn, và đặt lại baseline mỗi khi triển khai model mới. Hướng dẫn giám sát model và bài học Khả năng quan sát và suy giảm phân phối trình bày các kiểm định thống kê về drift.
Đọc tab Monitoring để phát hiện drift#
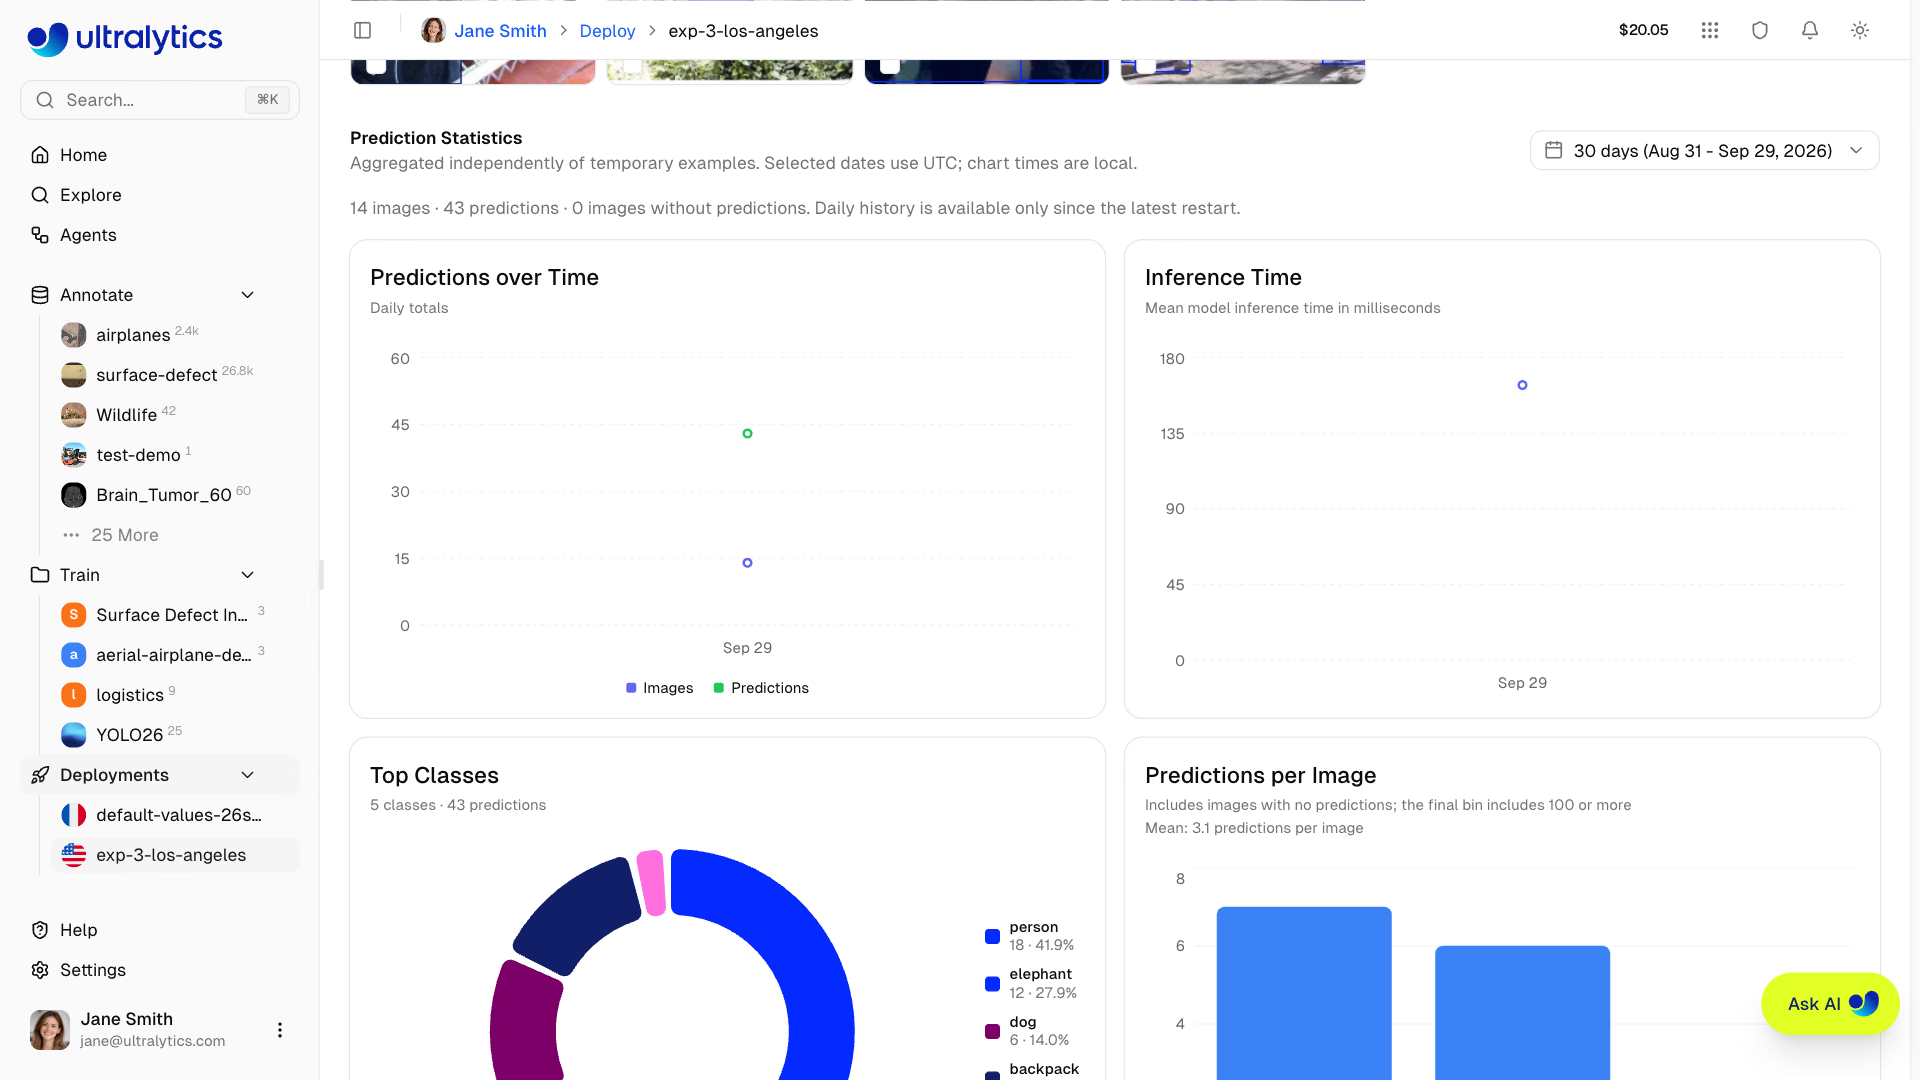
Ghi nhận hình dạng biểu đồ trong tuần triển khai, rồi so sánh về sau. Confidence đo mức độ chắc chắn chứ không đo độ chính xác, vì vậy hãy xem các chỉ số này cùng với tập holdout:
| Tình huống | Nguyên nhân có khả năng | Hành động |
|---|---|---|
| Confidence giảm, kết quả holdout vẫn ổn định | Thay đổi miền dữ liệu vô hại | Theo dõi; lưu ví dụ cho phiên bản dataset tiếp theo |
| Confidence và kết quả holdout cùng giảm | Độ chính xác thực sự suy giảm | Huấn luyện lại (bài học 10) |
| Kích thước hoặc vị trí bounding box thay đổi đột ngột | Camera bị di chuyển, thay ống kính hoặc thay đổi địa điểm | Kiểm tra camera trước khi chỉnh sửa model |
| Số dự đoán trên mỗi ảnh giảm, confidence ổn định | Camera ngoại tuyến, khung cảnh ít hoạt động hơn hoặc lỗi client | Điều tra các thành phần phía thượng nguồn |
| Độ trễ P95 tăng, thời gian suy luận không đổi | Xử lý request, kích thước payload hoặc năng lực hệ thống | Hạ tầng, không phải model |
Đưa ảnh production trở lại quy trình#
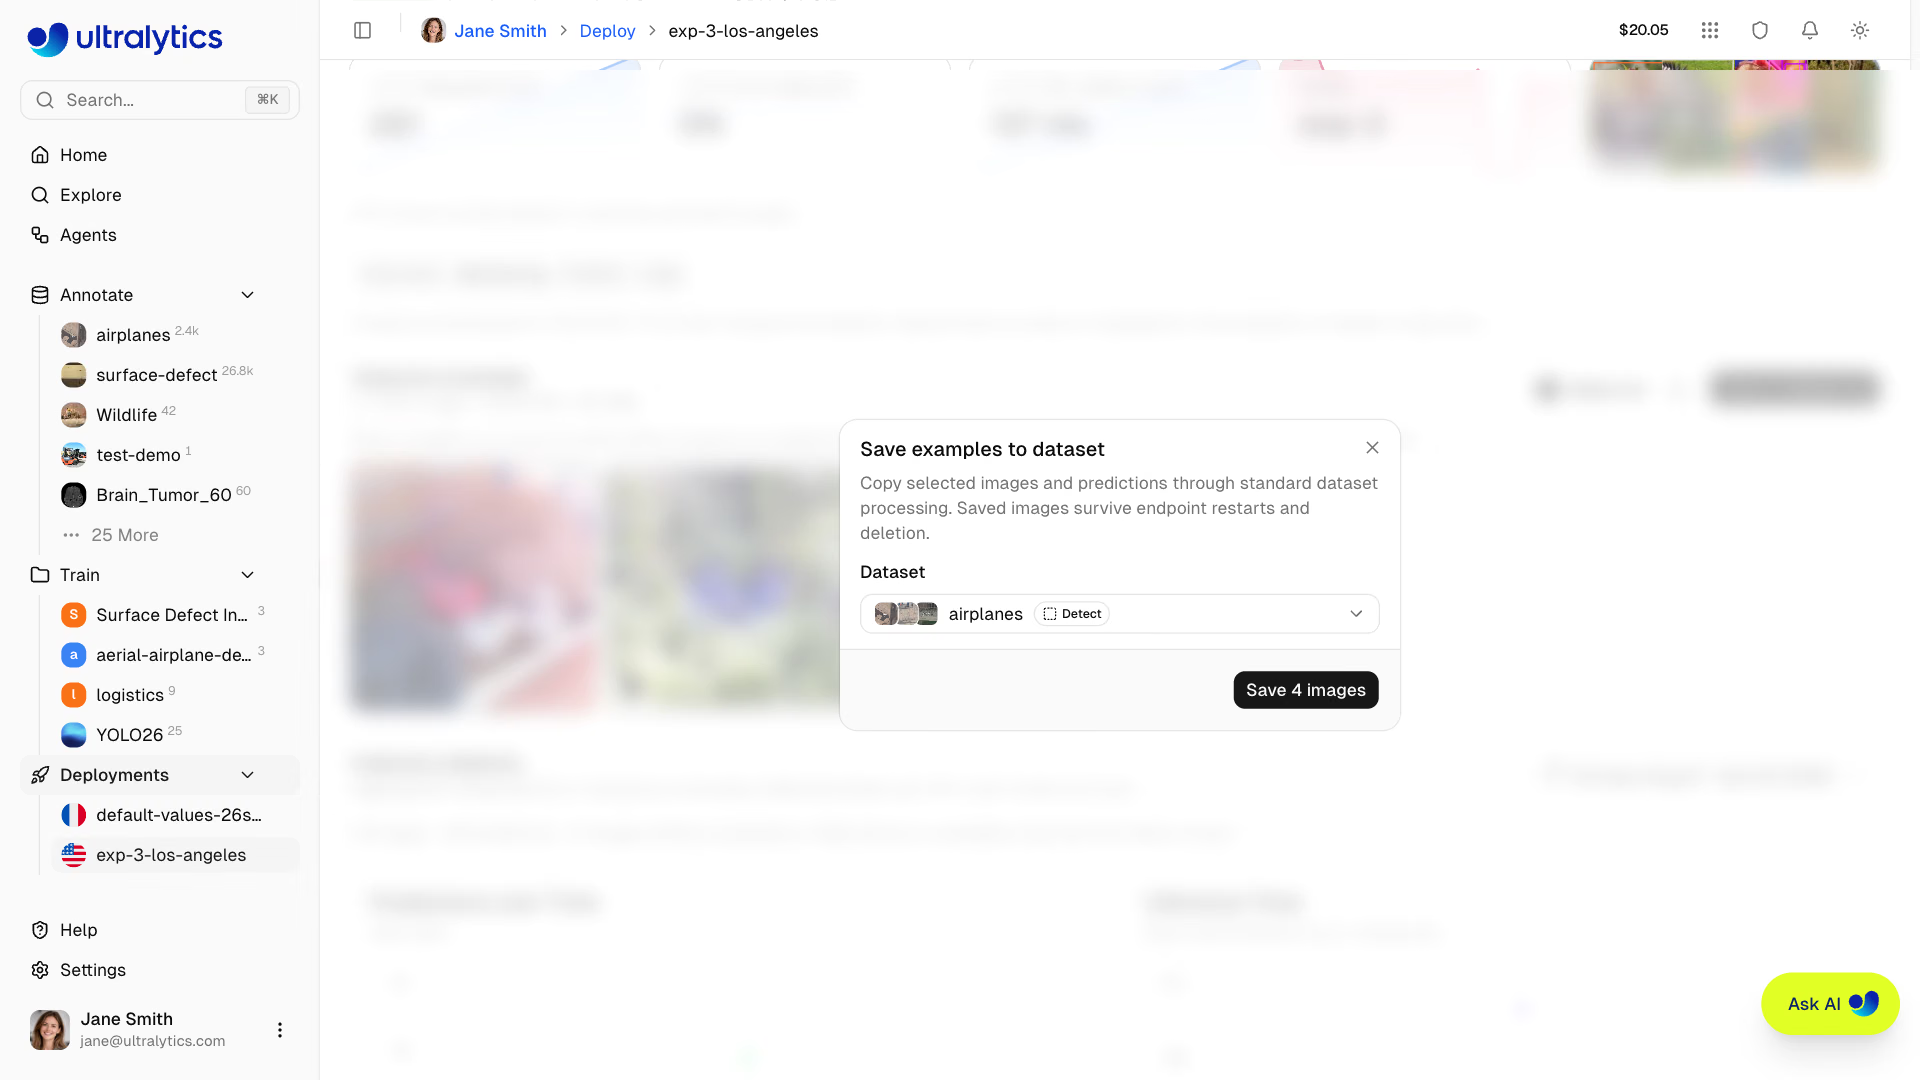
Trong tab Monitoring, chọn ví dụ rồi nhấp Save to dataset; các ví dụ được đưa qua quy trình nhập dữ liệu thông thường cùng với dự đoán và lưu deploymentId cùng khu vực trong metadata. Template Collect Uncertain Detections của Agents thực hiện tương tự cho toàn bộ dataset: dự đoán qua deployment của bạn rồi sao chép ảnh có detection trong một khoảng confidence vào dataset để rà soát.
Các lỗi thường gặp#
Triệu chứng: các ví dụ bạn định gán nhãn biến mất sau khi thay đổi kích thước hoặc đổi model. Cách khắc phục: chúng được lưu trong bộ nhớ của instance phục vụ. Hãy lưu chúng vào dataset và chờ quá trình tiếp nhận dữ liệu hoàn tất trước khi dừng, thay đổi kích thước hoặc thay thế model.
Triệu chứng: cảnh báo holdout bật ngay sau khi triển khai model tốt hơn, hoặc không bao giờ bật lại. Cách khắc phục: baseline là hàng đầu tiên trong lịch sử. Hãy bắt đầu một holdout_history.jsonl mới (hoặc ghi lại một hàng baseline mới) mỗi khi thay model.
Triệu chứng: tỷ lệ lỗi tăng đột biến trong lúc lưu lượng truy cập tăng mạnh, trong khi trạng thái health vẫn xanh. Cách khắc phục: phản hồi 429 được tính là lỗi nhưng có nghĩa là “đã đạt giới hạn năng lực”. Hãy kiểm tra log; nếu là lỗi 429, hãy phân bổ lưu lượng qua nhiều endpoint hơn hoặc dùng kích thước tùy chỉnh lớn hơn.
Hiển thị lời giải
Đáp án mẫu cho endpoint viên thuốc: một mục cron */5 * * * * python endpoint_check.py || ./page-oncall.sh với P95_BUDGET_MS = 300 và MAX_ERROR_RATE = 1.0; đặt ngân sách ở mức 100 ms khi P95 thực tế là 180 ms sẽ khiến tiến trình thoát với mã 1 và gửi cảnh báo, vậy nên cấu hình hoạt động đúng. Tác vụ CI hằng tuần chạy holdout_check.py với DEPLOYED = "pills-v2.pt" trên phiên bản tập holdout riêng tư gồm 300 ảnh: baseline 0.69. Lần diễn tập ca đêm làm chỉ số giảm 0.05 và in dòng ALERT với mã thoát 1; điều này khiến tác vụ CI thất bại và gửi thông báo đến kênh. Mười hai ví dụ Monitoring từ ca tối được đưa vào pill-review bằng Save to dataset, mỗi ví dụ được gắn thẻ deploymentId và europe-west1.