Triển khai và gọi endpoint
Tạo endpoint riêng tại một trong 42 khu vực, chọn quy mô phù hợp với lưu lượng truy cập và gọi endpoint bằng client xử lý cold start, lỗi 429 và key không hợp lệ.
Endpoint miễn phí có thể scale về 0 có thể mất đến một phút để phản hồi yêu cầu đầu tiên, và client đơn giản có thể biến việc đó thành timeout hiển thị cho người dùng. Key bị lộ vẫn tiếp tục hoạt động ngay cả sau khi bạn xóa key. Bài học này hướng dẫn triển khai model đã chọn, chủ động chọn quy mô endpoint và viết client nhỏ cần thiết cho mọi tích hợp production.
Thực hành
Inference dùng chung hay endpoint riêng#
Mọi model đều có thể được gọi thông qua API inference dùng chung của Platform, phù hợp cho việc kiểm thử. Lưu lượng production nên dùng endpoint riêng:
| Inference dùng chung | Endpoint riêng | |
|---|---|---|
| Dịch vụ | Dùng chung giữa những người dùng Platform | Một model, một tenant riêng |
| Khu vực | Khu vực dữ liệu của bạn (US, EU hoặc AP) | Bất kỳ khu vực nào trong 42 khu vực |
| Giới hạn tốc độ | 20 yêu cầu mỗi phút cho mỗi key | Platform không giới hạn các lệnh gọi trực tiếp |
| Kích thước yêu cầu | Khoảng 4,5 MB | 32 MB, tối đa 1 giờ cho mỗi yêu cầu (hỗ trợ video) |
| Xác thực | Bất kỳ API key nào của workspace | Chỉ key được liên kết với deployment |
Tạo và định cấu hình kích thước Endpoint#
Mở tab Deploy của model. Trình duyệt đo độ trễ đến cả 42 khu vực (14 ở châu Mỹ, 13 ở châu Âu, 12 ở châu Á-Thái Bình Dương, 3 ở Trung Đông và châu Phi), rồi sắp xếp bảng theo độ trễ:
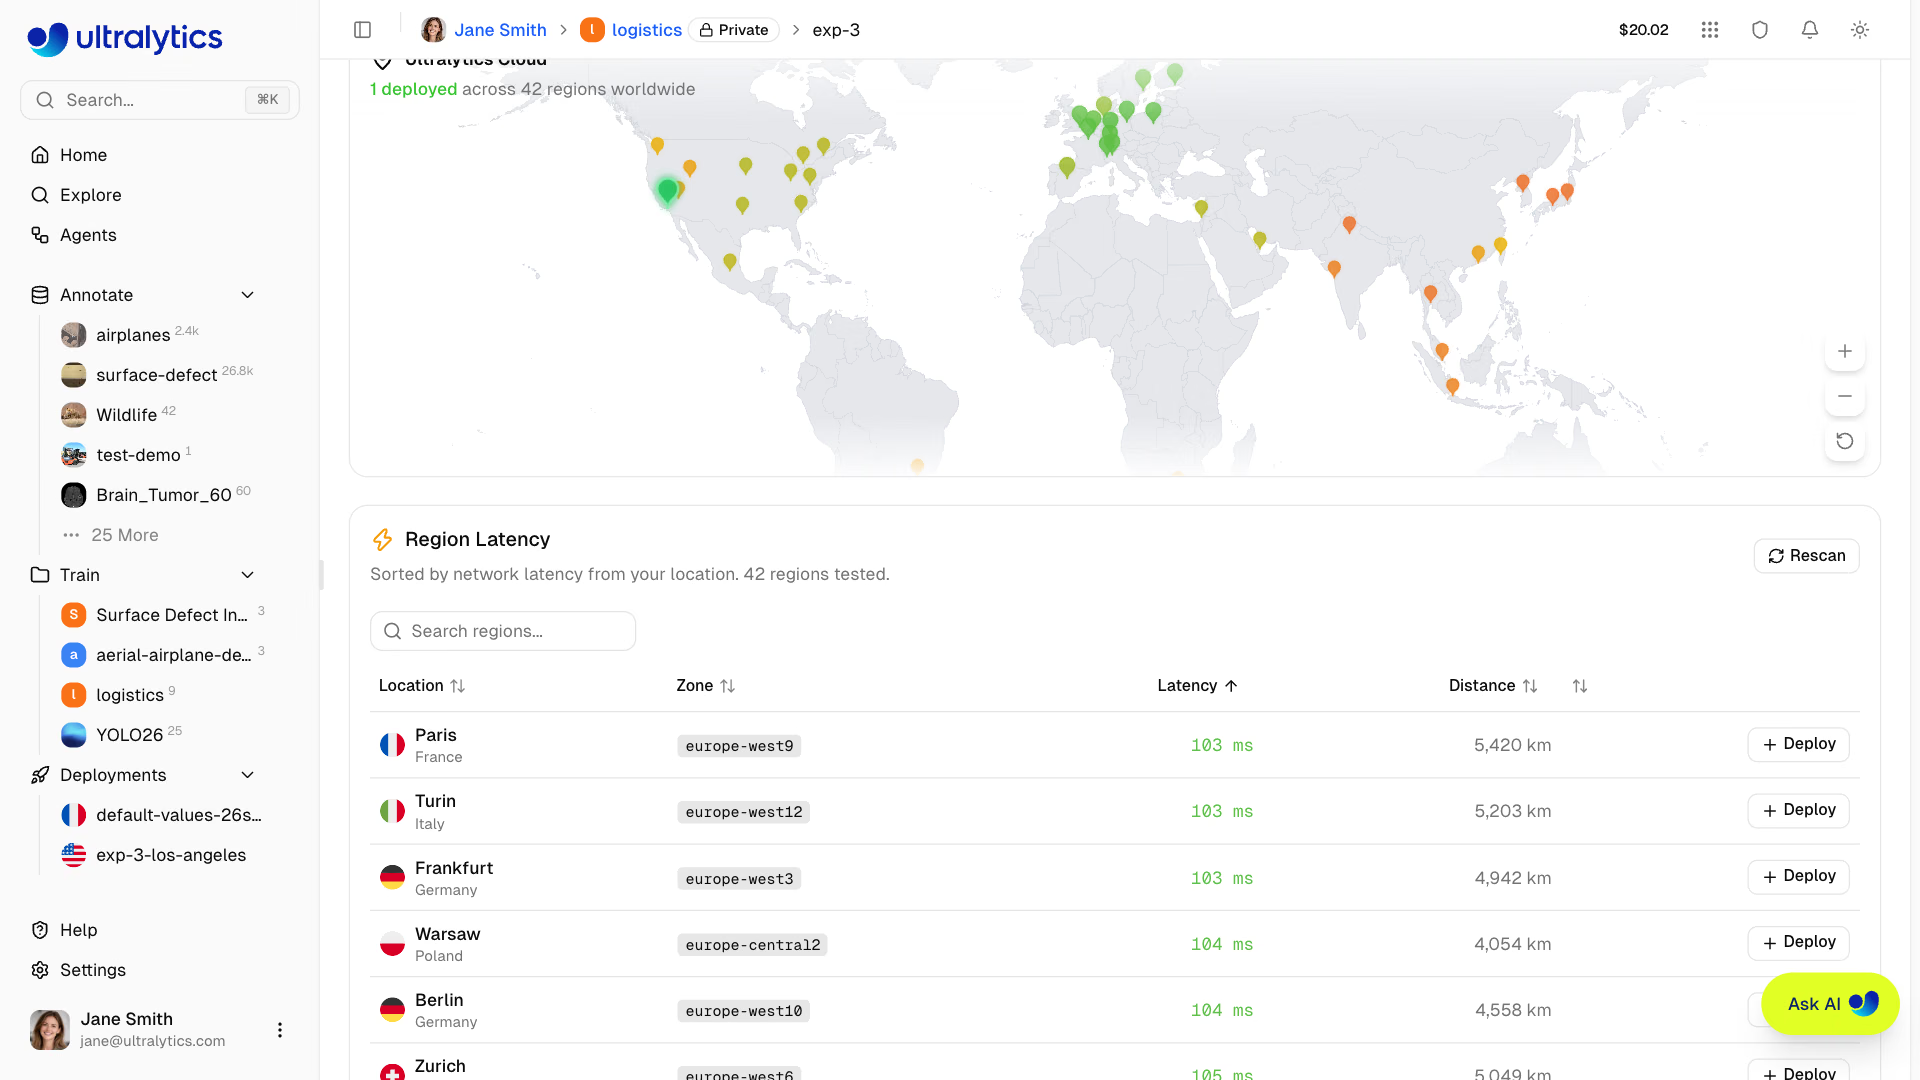
Nhấp Deploy ở hàng gần với người gọi nhất, xem lại CPU, bộ nhớ, giá và tên được tạo (chẳng hạn yolo26n-iowa), rồi nhấp Create Deployment. Bạn cũng có thể bắt đầu từ New Deployment trong tab Deployments trên hồ sơ của mình:
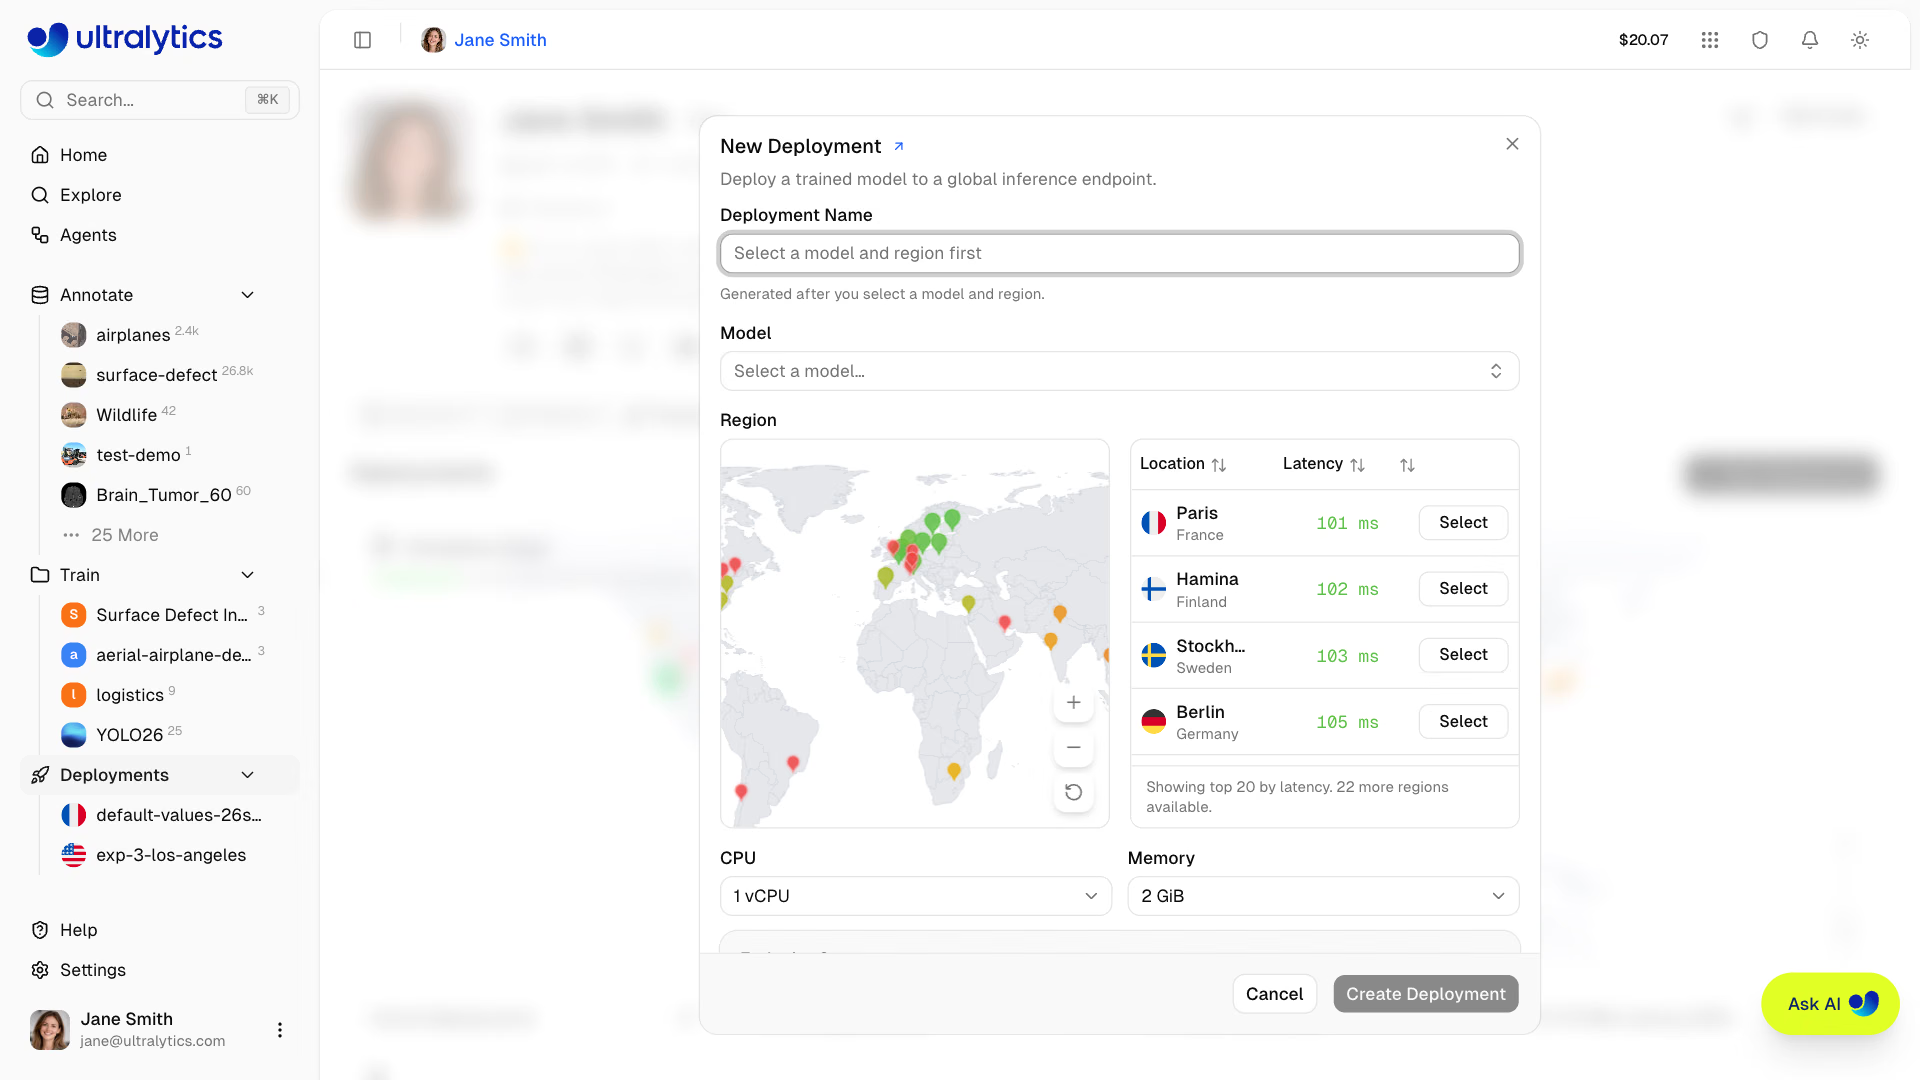
Chọn kích thước theo dạng lưu lượng:
| Lưu lượng | Quy mô | Chi phí |
|---|---|---|
| Tác vụ batch, công cụ nội bộ, bản demo có lưu lượng tăng đột biến | Mặc định 1 vCPU, 2 GiB; tự giảm về 0 | Miễn phí với mọi gói |
| Lưu lượng thời gian thực ổn định không thể chờ khởi động nguội | Kích thước tùy chỉnh (1–8 vCPU, 2–32 GiB) với một instance luôn sẵn sàng | Tính phí theo giờ từ lúc sẵn sàng đến khi dừng, bao gồm cả thời gian nhàn rỗi: khoảng $0.12/h cho 1 vCPU, 4 GiB tại Iowa |
| Người dùng ở nhiều châu lục | Một endpoint cho mỗi khu vực, đặt sau router của riêng bạn | Mỗi endpoint được tính phí theo kích thước |
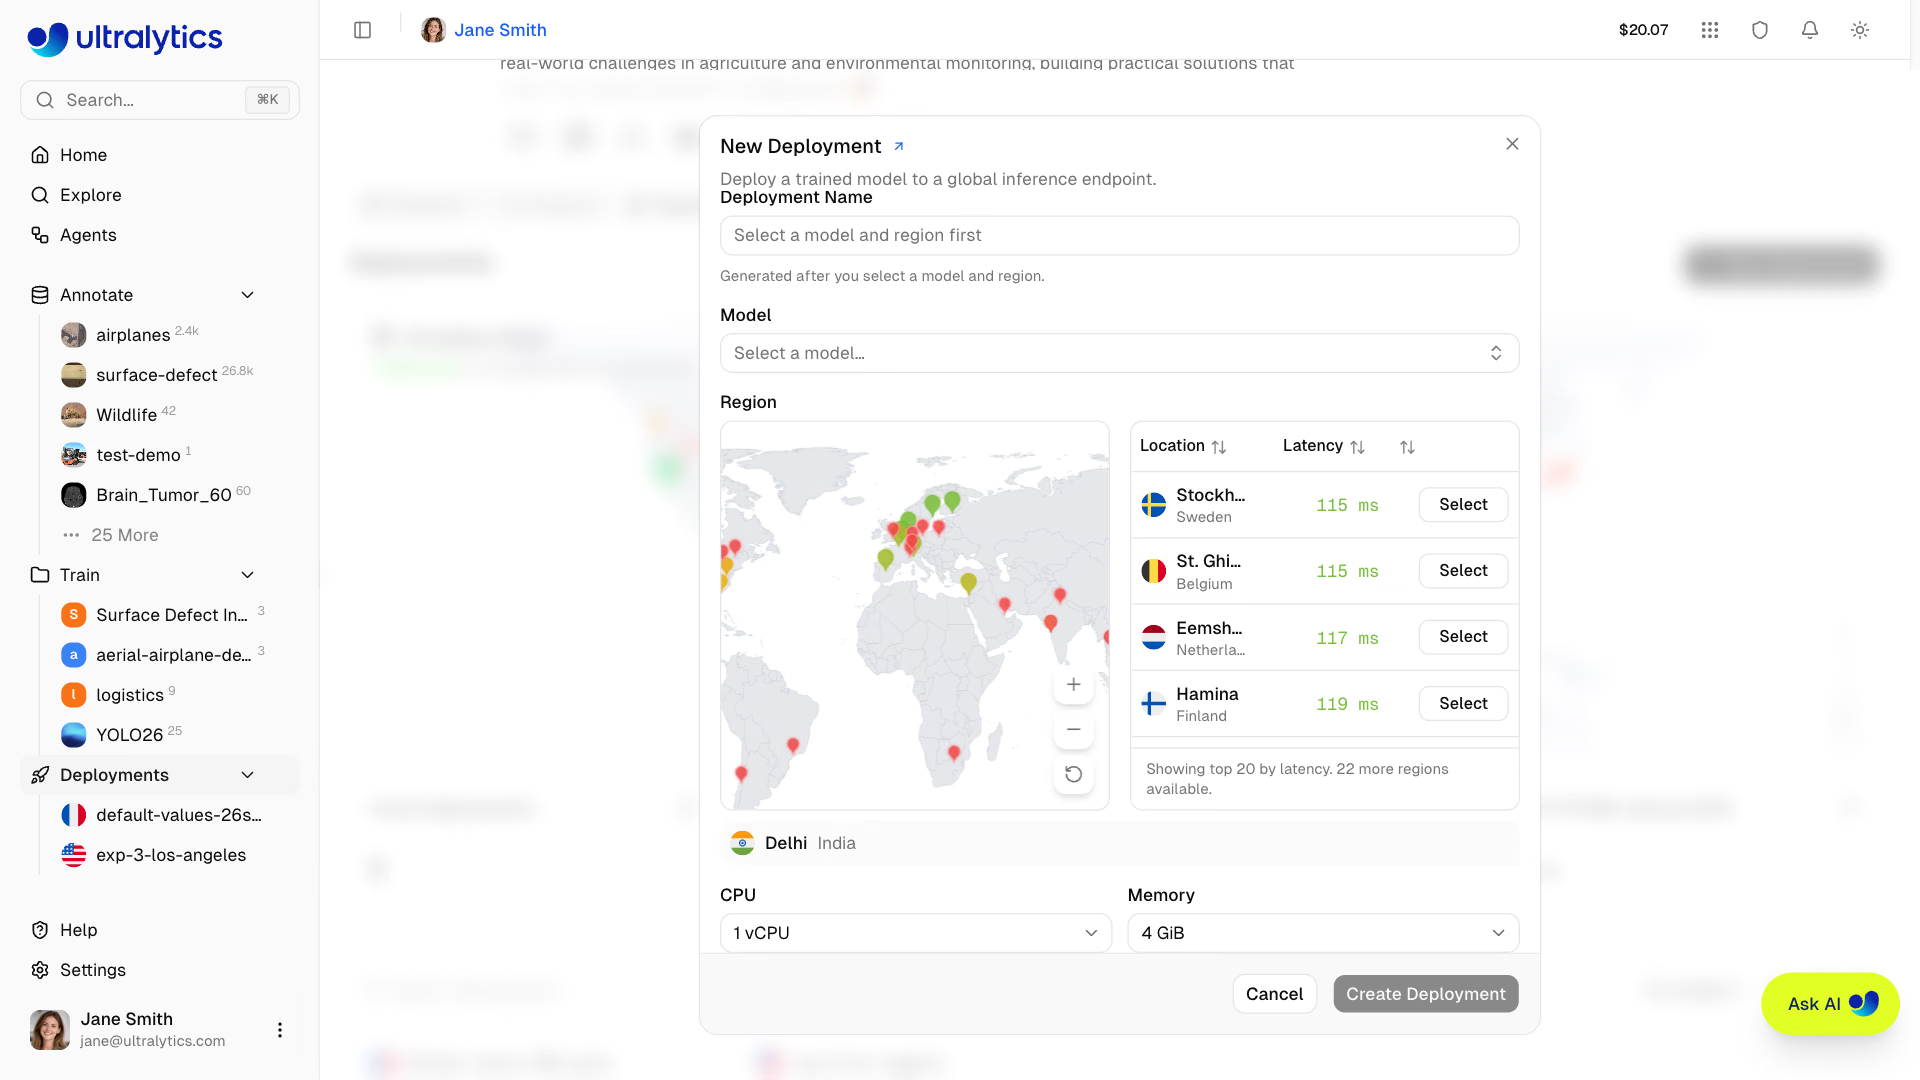
Các gói cho phép 3 (Free), 10 (Pro) hoặc không giới hạn (Enterprise) deployment; endpoint đã dừng vẫn được tính. Endpoint nhận lưu lượng khi huy hiệu hiển thị Ready:
Ví dụ thực tế: Client hoạt động ổn định trong môi trường production#
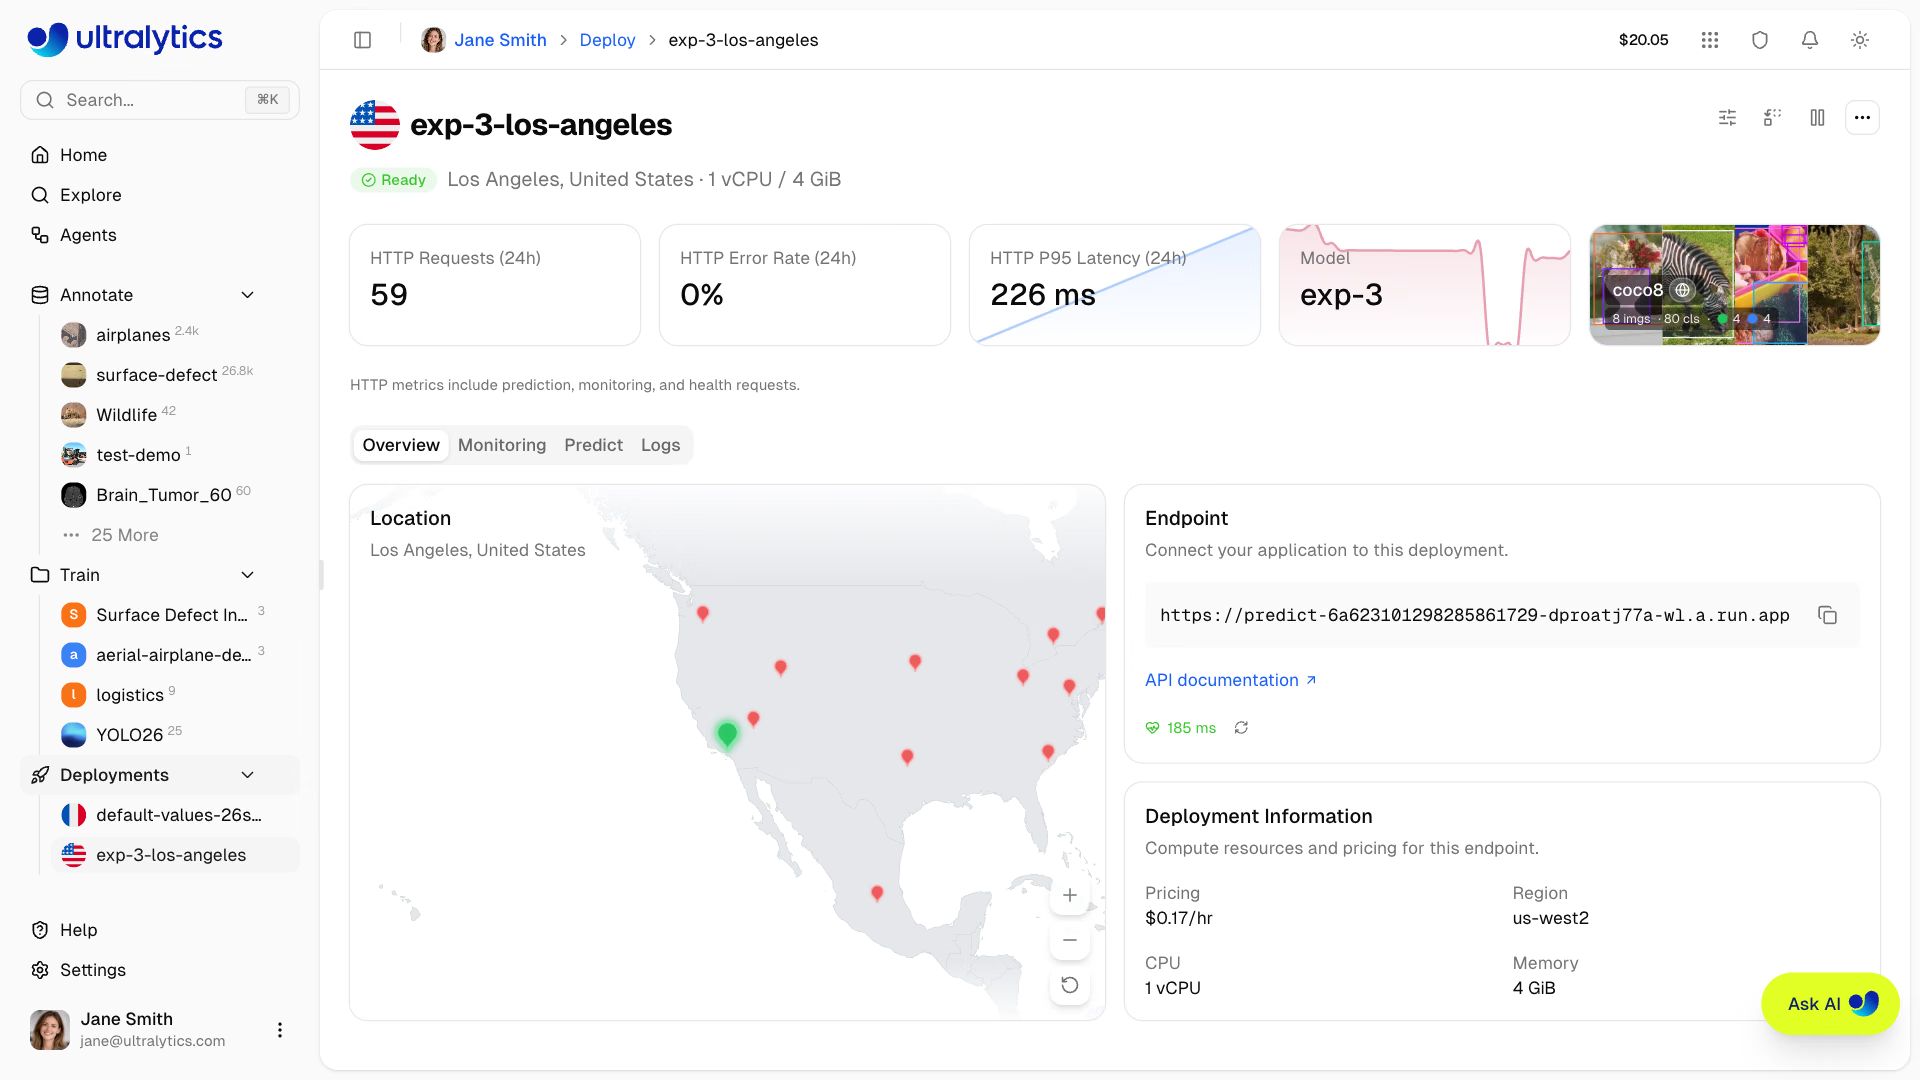
Mỗi endpoint có URL dạng https://predict-<id>-<hash>-<region>.a.run.app, phục vụ /predict (POST), /health và trang tương tác /docs. Endpoint chỉ chấp nhận API key được liên kết khi tạo; chủ sở hữu workspace sẽ thấy key được điền sẵn trong tab Predict của deployment, bên dưới Docs, cạnh các đoạn mã Python, JavaScript và cURL. Các đoạn mã chỉ gửi một request; mã production cũng phải xử lý được khởi động nguội và instance quá tải:
import os
import time
from collections import Counter

import httpx

URL = "https://YOUR_DEPLOYMENT_URL.run.app/predict"
HEADERS = {"Authorization": f"Bearer {os.environ['ULTRALYTICS_API_KEY']}"}  # the deployment's bound key, server-side only

def predict(client, path, conf=0.25, attempts=4):
    """POST one image; retry timeouts, 429, and 5xx with backoff; fail fast on other errors."""
    for attempt in range(attempts):
        try:
            with open(path, "rb") as f:
                r = client.post(URL, headers=HEADERS, data={"conf": conf}, files={"file": f}, timeout=90)
            if r.status_code < 400:
                return r.json()
            if r.status_code != 429 and r.status_code < 500:
                r.raise_for_status()  # 401 wrong key, 413 too large: retrying won't help
            wait, reason = float(r.headers.get("Retry-After", 2**attempt)), r.status_code
        except httpx.TimeoutException:  # a scaled-to-zero endpoint can take up to a minute to wake
            wait, reason = 2**attempt, "timeout"
        print(f"attempt {attempt + 1}: {reason}, retrying in {wait:.0f} s")
        time.sleep(wait)
    raise RuntimeError(f"endpoint still unavailable after {attempts} attempts")

with httpx.Client() as client:
    response = predict(client, "bus.jpg")
for image in response["images"]:
    counts = Counter(d["name"] for d in image["results"])
    print(f"{sum(counts.values())} objects {dict(counts)} in {image['speed']['inference']:.1f} ms")
Chúng tôi đã kiểm thử với một stub cục bộ, phản hồi 429 một lần rồi trả về kết quả YOLO26n thực cho bus.jpg theo định dạng phản hồi của endpoint:
attempt 1: 429, retrying in 2 s
5 objects {'bus': 1, 'person': 4} in 34.9 ms
Xem từng dòng, đây là những quyết định quan trọng:
timeout=90xử lý thời gian khởi động nguội có thể lên đến khoảng một phút; timeout mặc định của hầu hết HTTP client ngắn hơn nhiều.- Các lỗi 429 và 5xx được thử lại, đồng thời tuân theo
Retry-Afterkhi endpoint gửi giá trị này. Mỗi endpoint phục vụ từ một instance duy nhất và giảm tải bằng429khi bận. - Các lỗi 4xx khác khiến request thất bại ngay:
401nghĩa là key không đúng và413nghĩa là body vượt quá 32 MB; cả hai lỗi đều không tự khắc phục. - Phản hồi chứa một mục cho mỗi ảnh (hoặc mỗi khung hình video) trong
images, mỗi mục córesults(class,name,confidence,boxvớix1,y1,x2,y2) vàspeedtính bằng mili giây.
Các trường form tùy chọn gồm conf (mặc định 0.25), iou (0.7), imgsz (kích thước huấn luyện của model), vid_stride cho video và normalize=true cho tọa độ trong khoảng 0–1. Lệnh cURL tương đương có một dòng cho mỗi trường:
curl -X POST "https://YOUR_DEPLOYMENT_URL.run.app/predict" \
  -H "Authorization: Bearer $ULTRALYTICS_API_KEY" \
  -F "file=@bus.jpg" -F "conf=0.25" -F "iou=0.7" -F "imgsz=640"
Phát hành phiên bản mới mà không đổi URL#
Replace model trên trang deployment sẽ thay bằng một model khác đã hoàn tất trong cùng workspace. Model cũ tiếp tục phục vụ cho đến khi model mới sẵn sàng; URL, khu vực và key vẫn giữ nguyên. Nếu quá trình triển khai thất bại, model trước đó vẫn hoạt động. Để khôi phục, thực hiện cùng thao tác và chọn model trước đó, vì vậy hãy giữ model đó trong project. Update configuration thay đổi kích thước ngay tại chỗ, còn Stop tạm dừng tính phí và giữ nguyên URL.
Một số thay đổi cần endpoint mới: khu vực đã cố định (muốn chuyển thì phải xóa rồi tạo lại, kèm URL mới), và custom domain không được hỗ trợ; vì vậy, hãy đặt gateway của riêng bạn ở phía trước nếu người gọi cần hostname mang thương hiệu ổn định. Để chạy bên ngoài Platform, hãy export model (Export for Deployment) hoặc tự host model sau Triton Inference Server.
Các lỗi thường gặp#
Triệu chứng: endpoint của bạn nhận được lưu lượng truy cập không thể xác định nguồn gốc. Cách khắc phục: đừng bao giờ đưa key vào ứng dụng web hoặc mobile; hãy gọi endpoint từ backend. Xóa hoặc vô hiệu hóa key được liên kết không khóa endpoint, vì endpoint vẫn chấp nhận chuỗi key đó. Để thu hồi quyền truy cập, hãy dừng hoặc xóa deployment, rồi tạo deployment mới được liên kết với key mới.
Triệu chứng: request đầu tiên vào buổi sáng thất bại, nhưng lần thử lại thành công. Cách khắc phục: endpoint có kích thước mặc định sẽ scale về 0. Hãy đặt timeout ít nhất 90 giây, làm nóng endpoint bằng một lệnh gọi /health trước khi dự kiến có lưu lượng truy cập, hoặc chuyển sang kích thước tùy chỉnh nếu mọi request đều cần phản hồi nhanh.
Triệu chứng: tải lên thất bại với 413. Cách khắc phục: dedicated endpoint chấp nhận request body có dung lượng tối đa 32 MB. Hãy chia video dài thành các clip ngắn hơn hoặc gửi các frame được lấy mẫu, đồng thời truyền vid_stride để bỏ qua frame phía máy chủ.
Hiển thị lời giải
Câu trả lời mẫu cho camera trên dây chuyền kiểm tra viên thuốc: triển khai v2-finetune tại europe-west1 (St. Ghislain, khu vực có độ trễ thấp nhất tính từ nhà máy ở Đức) với kích thước mặc định. Request nguội sau một giờ nhàn rỗi: 38 s, được timeout 90 giây xử lý; request ấm: 0.3 s. Quyết định: PLC trên dây chuyền gửi một khung hình mỗi 30 giây trong ca làm, nên endpoint luôn ấm suốt ca và chỉ khung hình đầu tiên chịu thời gian khởi động nguội. Một lệnh gọi /health từ bộ điều khiển dây chuyền trước mỗi ca 2 phút cũng loại bỏ thời gian đó, nên vẫn dùng kích thước mặc định miễn phí, tiết kiệm khoảng $90 mỗi tháng so với instance tùy chỉnh 1 vCPU, 4 GiB. Thay model trở lại v1-baseline sẽ trả về kết quả của v1 từ cùng URL; thay tiếp bằng v2 để hoàn tất.