Tuyển chọn, loại trùng lặp và chia tập
Tìm ảnh trùng lặp giữa các tập split và các lớp còn thiếu bằng hai script ngắn, chia tập theo đơn vị phù hợp và đóng băng một phiên bản dataset đã được kiểm tra.
Độ tin cậy của điểm validation chỉ cao bằng độ tin cậy của cách chia tập. COCO128, một dataset demo phổ biến, cố ý dùng cùng 128 ảnh cho train và val; nếu vô tình lặp lại cách chia này với dữ liệu của bạn, bạn sẽ có một model 'tốt' nhưng thất bại khi dùng camera tiếp theo. Bài học này thực hiện hai cuộc kiểm tra trên dữ liệu thực: kiểm tra ảnh trùng lặp và kiểm tra lớp theo từng tập, sau đó chia theo camera và đóng băng phiên bản đã vượt qua cả hai bước kiểm tra.
Thực hành
Ví dụ thực tế: Tìm ảnh dùng chung giữa các tập#
Platform giữ một bản sao của ảnh trong mỗi tập và hỏi cách xử lý xung đột khi upload, nhưng không có gì ngăn cùng một ảnh hoặc cảnh xuất hiện trong cả train và val. Hãy kiểm tra trước khi upload và kiểm tra lại sau khi gộp dataset:
import hashlib
from pathlib import Path

from ultralytics.data.utils import check_det_dataset

data = check_det_dataset("coco128.yaml")  # any local YOLO dataset YAML before you upload it

def hashes(split_dir):
    return {hashlib.md5(p.read_bytes()).hexdigest(): p.name for p in Path(split_dir).rglob("*.jpg")}

train, val = hashes(data["train"]), hashes(data["val"])
shared = train.keys() & val.keys()
print(f"train {len(train)} images, val {len(val)} images, identical in both: {len(shared)}")
print("examples:", sorted(val[h] for h in shared)[:3])
train 128 images, val 128 images, identical in both: 128
examples: ['000000000009.jpg', '000000000025.jpg', '000000000030.jpg']Mọi ảnh validation của COCO128 cũng là ảnh training. Điều này được chủ ý áp dụng cho dataset smoke test, và chính vì vậy mAP validation của dataset không nói lên điều gì về khả năng tổng quát hóa. Với dữ liệu của bạn, mọi số lượng khác 0 đều là rò rỉ: hãy chuyển hoặc xóa một bản sao của mỗi ảnh trước khi training.
Phát hiện ảnh gần trùng lặp bằng Clustering#
Hash chỉ phát hiện các byte giống hệt nhau. Các frame video liên tiếp, ảnh chụp liên tục và bản sao được mã hóa lại có thể khác nhau vài pixel. Mở biểu tượng biểu đồ phân tán trên thanh công cụ thư viện ảnh và nhấp Analyze Dataset (từ 20 đến 200,000 ảnh, chỉ áp dụng cho dataset đã upload):
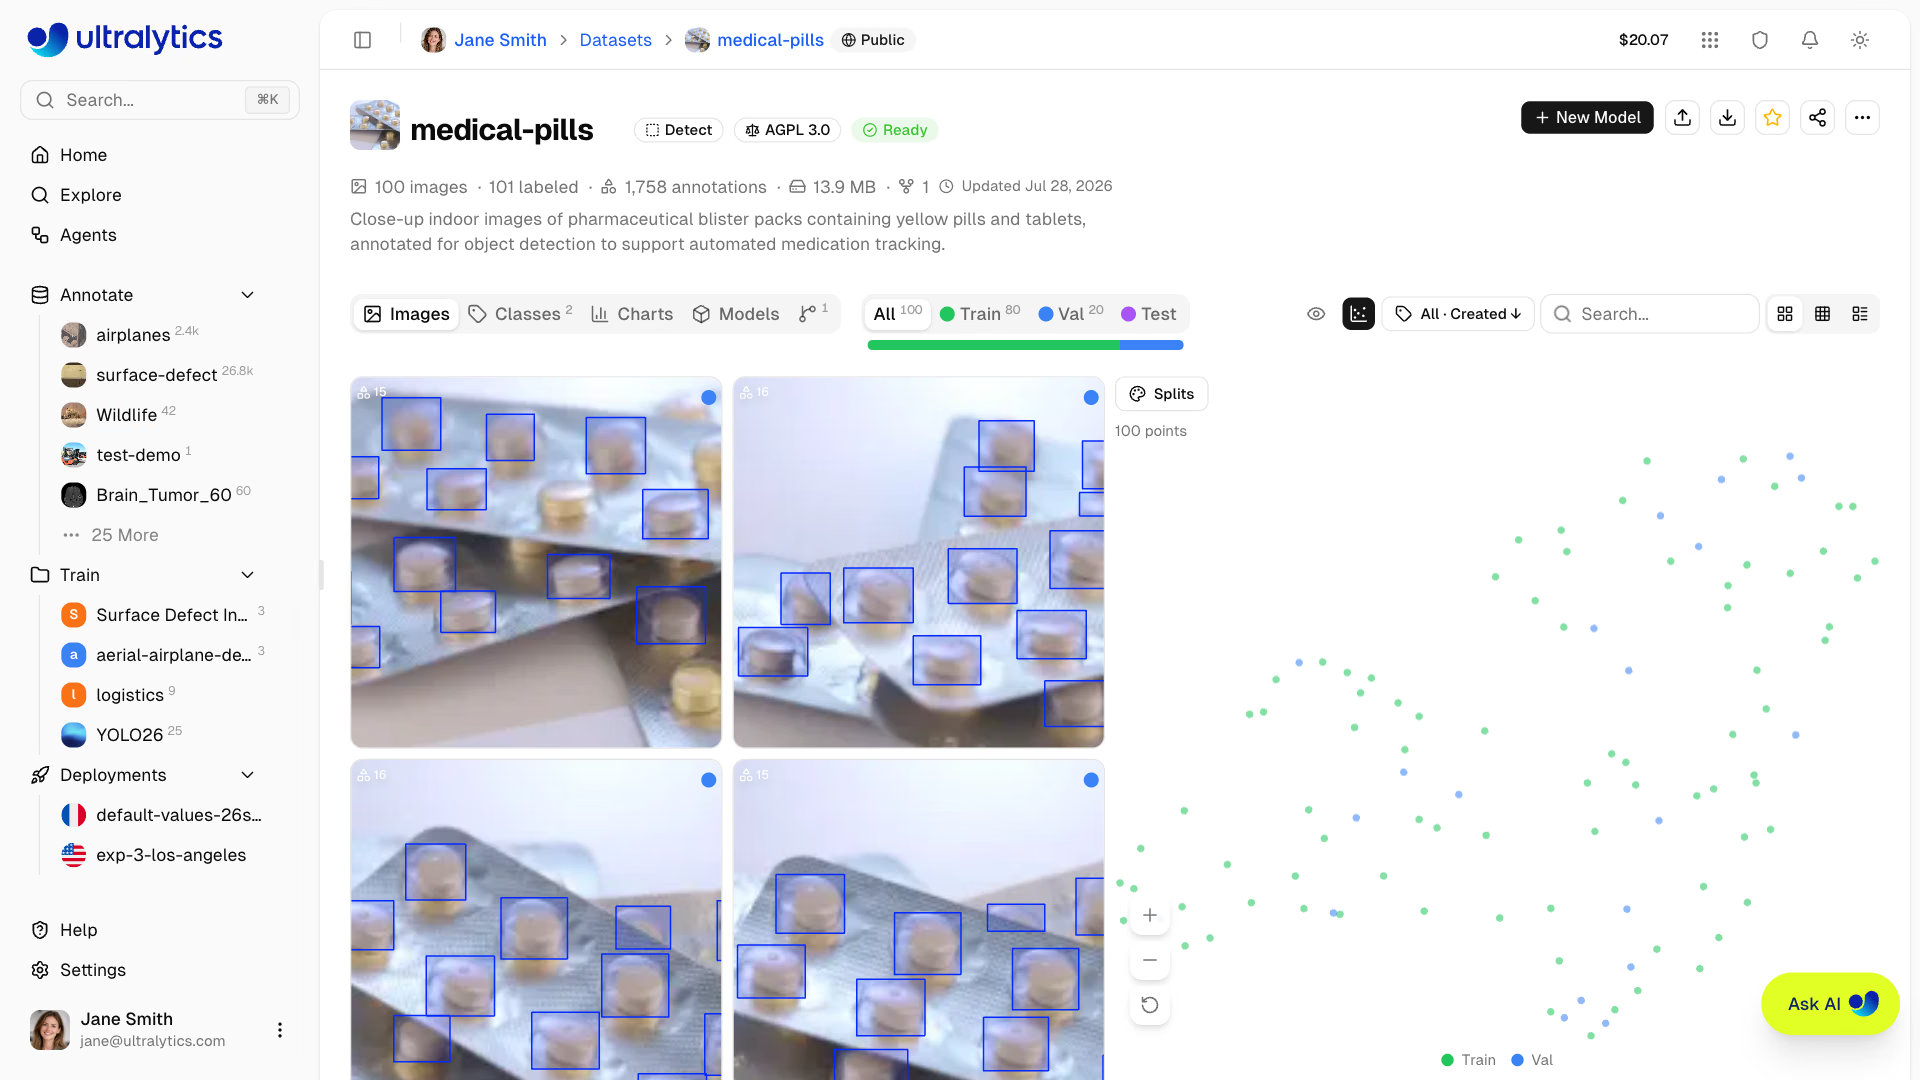
- Tô màu theo Splits: một cụm điểm tập trung có cả điểm train và val là dấu hiệu rò rỉ do ảnh gần trùng lặp.
- Tô màu theo Clusters hoặc Classes: một cụm lớn chỉ có một lớp cho thấy dataset đại diện quá nhiều cho lớp đó; các điểm tách biệt là ngoại lệ (sai camera, frame bị hỏng, ảnh gán nhãn sai).
- Khoanh vùng hoặc nhấp vào một khu vực để lọc thư viện ảnh còn những ảnh đó (tối đa 1,000), sau đó xóa, chuyển hoặc gán nhãn lại.
Các embedding tương tự cũng hỗ trợ Tìm ảnh tương tự trong menu ngữ cảnh ảnh; tính năng này thêm các ảnh tương tự từ dataset công khai và nhóm vào train dưới dạng ảnh chưa gán nhãn: cách nhanh nhất để bổ sung dữ liệu còn thiếu mà bước kiểm tra bên dưới phát hiện.
Ví dụ thực tế: Kiểm tra lớp theo từng tập#
Tải NDJSON export từ tiêu đề dataset hoặc tab Versions. Mỗi dòng sau dòng tiêu đề là một ảnh cùng split và nhãn của ảnh đó, vì vậy chỉ cần vài dòng Python để đếm mọi lớp trong từng tập. Ví dụ dưới đây chạy trên COCO8 export công khai:
import json
from collections import Counter, defaultdict

counts = defaultdict(Counter)  # split -> class name -> instances
images = Counter()
with open("coco8.ndjson") as f:  # the NDJSON export from the dataset header or Versions tab
    header = json.loads(f.readline())
    names = header["class_names"]
    for line in f:
        record = json.loads(line)
        images[record["split"]] += 1
        for box in (record.get("annotations") or {}).get("boxes", []):
            counts[record["split"]][names[str(box[0])]] += 1

print("images per split:", dict(images))
for name in sorted(set(counts["train"]) | set(counts["val"])):
    train, val = counts["train"][name], counts["val"][name]
    flag = "missing in train" if not train else "too few in val" if val < 10 else ""
    print(f"{name:<14} train {train:>3}  val {val:>3}  {flag}")
images per split: {'train': 4, 'val': 4}
bowl train 3 val 0 too few in val
broccoli train 1 val 0 too few in val
dog train 0 val 1 missing in train
elephant train 0 val 2 missing in train
giraffe train 2 val 0 too few in val
horse train 0 val 2 missing in train
orange train 4 val 0 too few in val
person train 0 val 10 missing in train
potted plant train 1 val 1 too few in val
umbrella train 0 val 1 missing in train
vase train 1 val 0 too few in val
zebra train 1 val 0 too few in valCách đọc kết quả: dòng tiêu đề chứa class_names; mỗi BBox detection là [class, x, y, w, h]. Thiếu trong train nghĩa là model hoàn toàn không thể học lớp đó và AP trên val sẽ bằng 0. Quá ít trong val nghĩa là AP sẽ dao động mạnh giữa các lần chạy: nếu val chỉ có 7 pallet, bỏ sót một pallet sẽ làm AP của pallet thay đổi khoảng 14 điểm. COCO8 là smoke test gồm 8 ảnh nên mọi lớp đều không đạt; phiên bản dùng trong production của bạn không nên có cảnh báo nào. Khắc phục các thiếu hụt bằng cách thu thập thêm ví dụ, không phải bằng cách tinh chỉnh.
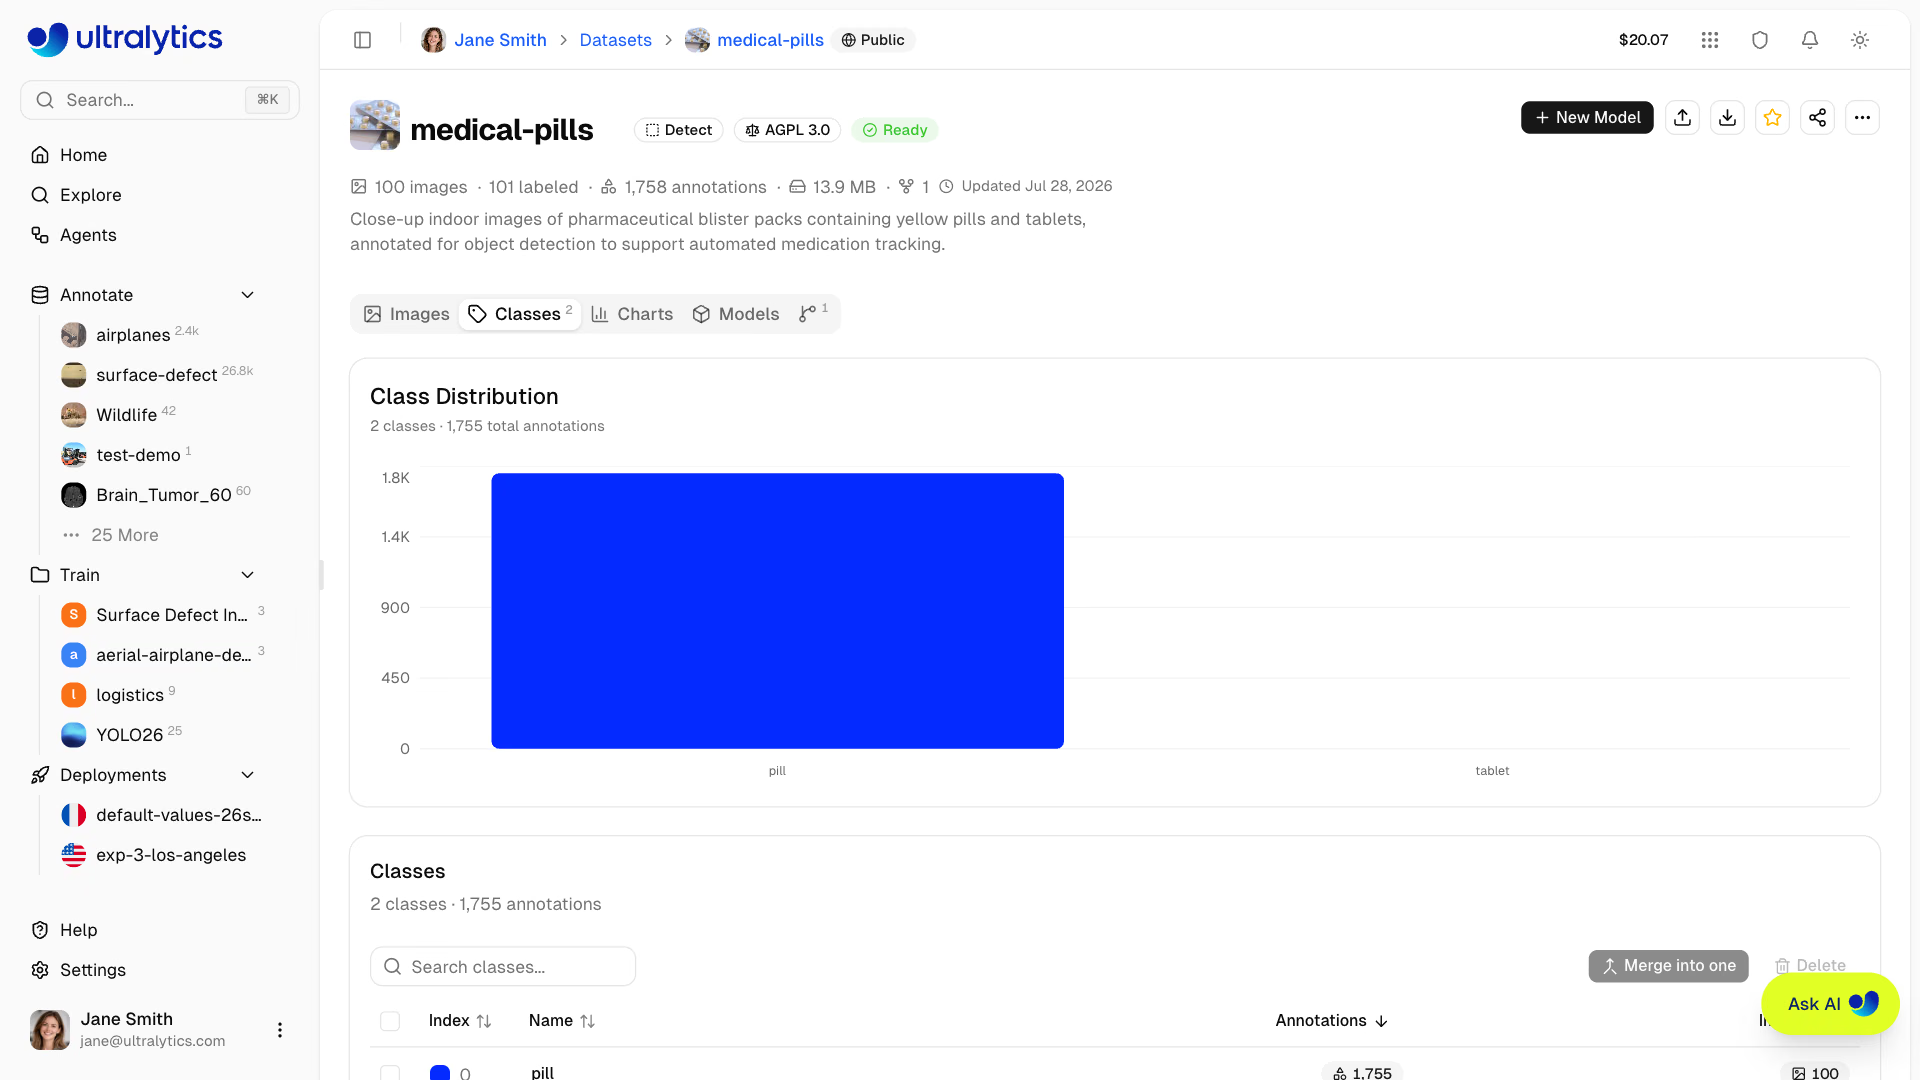
Tab Classes hiển thị các số liệu tương tự cho dataset đang hoạt động, kèm tùy chọn thang log cho dữ liệu mất cân bằng. Gộp thành một hợp nhất các lớp trùng lặp như car, automobile và vehicle thành một lớp mà không làm mất annotation; Delete xóa một lớp và tất cả annotation của lớp đó.
Chia theo đơn vị mà bạn cần tổng quát hóa sang#
Các frame từ cùng một camera, phiên làm việc hoặc ngày có tương quan với nhau. Nếu chúng xuất hiện cả trong train lẫn val, model sẽ được đánh giá trên những cảnh đã thấy. Giữ lại toàn bộ đơn vị tương ứng với yếu tố thay đổi trong production: nếu là camera mới, hãy giữ lại các camera; nếu là cùng camera vào ngày khác, hãy giữ lại các ngày.
Các công cụ chia tập của Platform khác nhau chính ở điểm này:
| Công cụ | Cách gán | Dùng cho |
|---|---|---|
Các thư mục train/, val/, test/ trong một lần upload | Giữ nguyên cách gán của bạn | Chia nhóm đã chuẩn bị ngoại tuyến |
| Đặt bộ lọc split trước khi upload | Mọi file trong lần upload đó được đưa vào split đã chọn | Upload từng camera vào một split |
| Move to split trong chế độ xem Table | Chuyển các ảnh đã chọn | Sửa các ảnh cụ thể |
| Thanh split, Redistribute Splits | Gán lại ngẫu nhiên tất cả ảnh | Chỉ áp dụng cho ảnh độc lập |

Bài học Chia Dataset Đúng Cách hướng dẫn chọn đơn vị; với dataset rất nhỏ, k-fold cross-validation giúp khai thác thêm tín hiệu. Để kiểm tra nhóm sau khi upload, hãy thêm khóa nhóm vào bước kiểm tra lớp (ví dụ record["file"].split("_")[0] cho các file có tên cam07_000123.jpg, hoặc trường camera trong metadata ảnh) và liệt kê mọi nhóm xuất hiện trong hai tập.
Đóng băng một phiên bản đã vượt qua kiểm tra#
Training cần một snapshot cố định. Trong tab Versions, nhập mô tả ("v5: giữ lại cam07, +80 ảnh pallet") rồi nhấp New Version. Mỗi phiên bản là một NDJSON snapshot bất biến, được đánh số và có thể tải xuống, so sánh hoặc khôi phục; hộp thoại training cũng thực hiện tương tự khi bắt đầu nếu chọn Save Dataset Version, đồng thời dùng lại phiên bản trùng khớp khi không có thay đổi. Không hỗ trợ Versions cho dataset cloud được kết nối hoặc On Premise.
Các lỗi thường gặp#
Triệu chứng: sau khi nhấp Auto 80/20, mAP trên tập validation tăng vọt nhưng độ chính xác khi triển khai thì không. Cách khắc phục: Redistribute Splits phân bổ ngẫu nhiên lại mọi ảnh (đồng thời loại bỏ các bản sao trùng khớp chính xác), khiến các frame liền kề nằm ở tập train và val. Hãy dùng các thư mục tải lên hoặc Move to split cho dữ liệu được nhóm.
Triệu chứng: một bản export cũ hoặc các dự đoán của model đột nhiên mang tên class sai. Cách khắc phục: class ID được xác định theo vị trí, vì vậy việc gộp hoặc xóa một class sẽ làm mọi chỉ số cao hơn dịch xuống một bậc. Hãy tạo một version trước khi thay đổi class, và huấn luyện lại thay vì dùng lại các file nhãn cũ.
Triệu chứng: một lần chạy mới có điểm thấp hơn 5 điểm, dù không có gì khác thay đổi. Cách khắc phục: chỉ có thể so sánh metric trên cùng một tập chia dữ liệu. Khi thay đổi tập chia dữ liệu, hãy ghi chú trong phần mô tả version và chạy lại baseline trên version mới trước khi so sánh bất cứ điều gì.
Hiển thị lời giải
Đáp án mẫu cho dataset xe nâng gồm 8 camera. Bước kiểm tra ảnh trùng lặp tìm thấy 41 ảnh giống hệt nhau giữa train và val, tất cả đều đến từ một thư mục được upload lại; hãy xóa các bản sao trong val. Bước kiểm tra, có bổ sung group = record['file'].split('_')[0], cho thấy cam02 xuất hiện trong cả train lẫn val, vì vậy hãy chọn ảnh cam02 trong val ở chế độ xem Table và chọn Move to split > Train. Bước này cũng báo pallet: train 63, val 7, too few in val: dùng Find similar images trên hai ảnh pallet để thêm 40 ảnh tương tự chưa gán nhãn, gán nhãn cho các ảnh đó và chuyển 15 ảnh pallet từ cam07 vào val để giữ nguyên nhóm cam07. Chạy lại: 0 ảnh trùng lặp, 0 nhóm bị rò rỉ, pallet val là 22. Clustering khi tô màu theo split không cho thấy cụm nào trộn lẫn. Lưu v5: cam07 val, cam08 test, +40 pallets.