So sánh các lượt chạy và chọn model tốt nhất
So sánh các lượt chạy trong một project Platform, ghi lại mục đích của từng lượt chạy và quyết định có triển khai ứng viên hay không bằng cổng đánh giá tự động.
Model lớn hơn thường thắng ở metric tổng quát, rồi lại kém hơn ở một lớp mà không ai kiểm tra. Nếu không có quy tắc được quyết định trước, lượt chạy được triển khai sẽ là lượt mà ai đó thích nhất. Bài học này ghi lại từng lượt chạy để sau này có thể tìm thấy lý do đằng sau chúng, đồng thời biến câu hỏi “nó có tốt hơn không?” thành một script kiểm tra trả về PASS hoặc FAIL.
Thực hành
So sánh các lượt chạy trong một project#
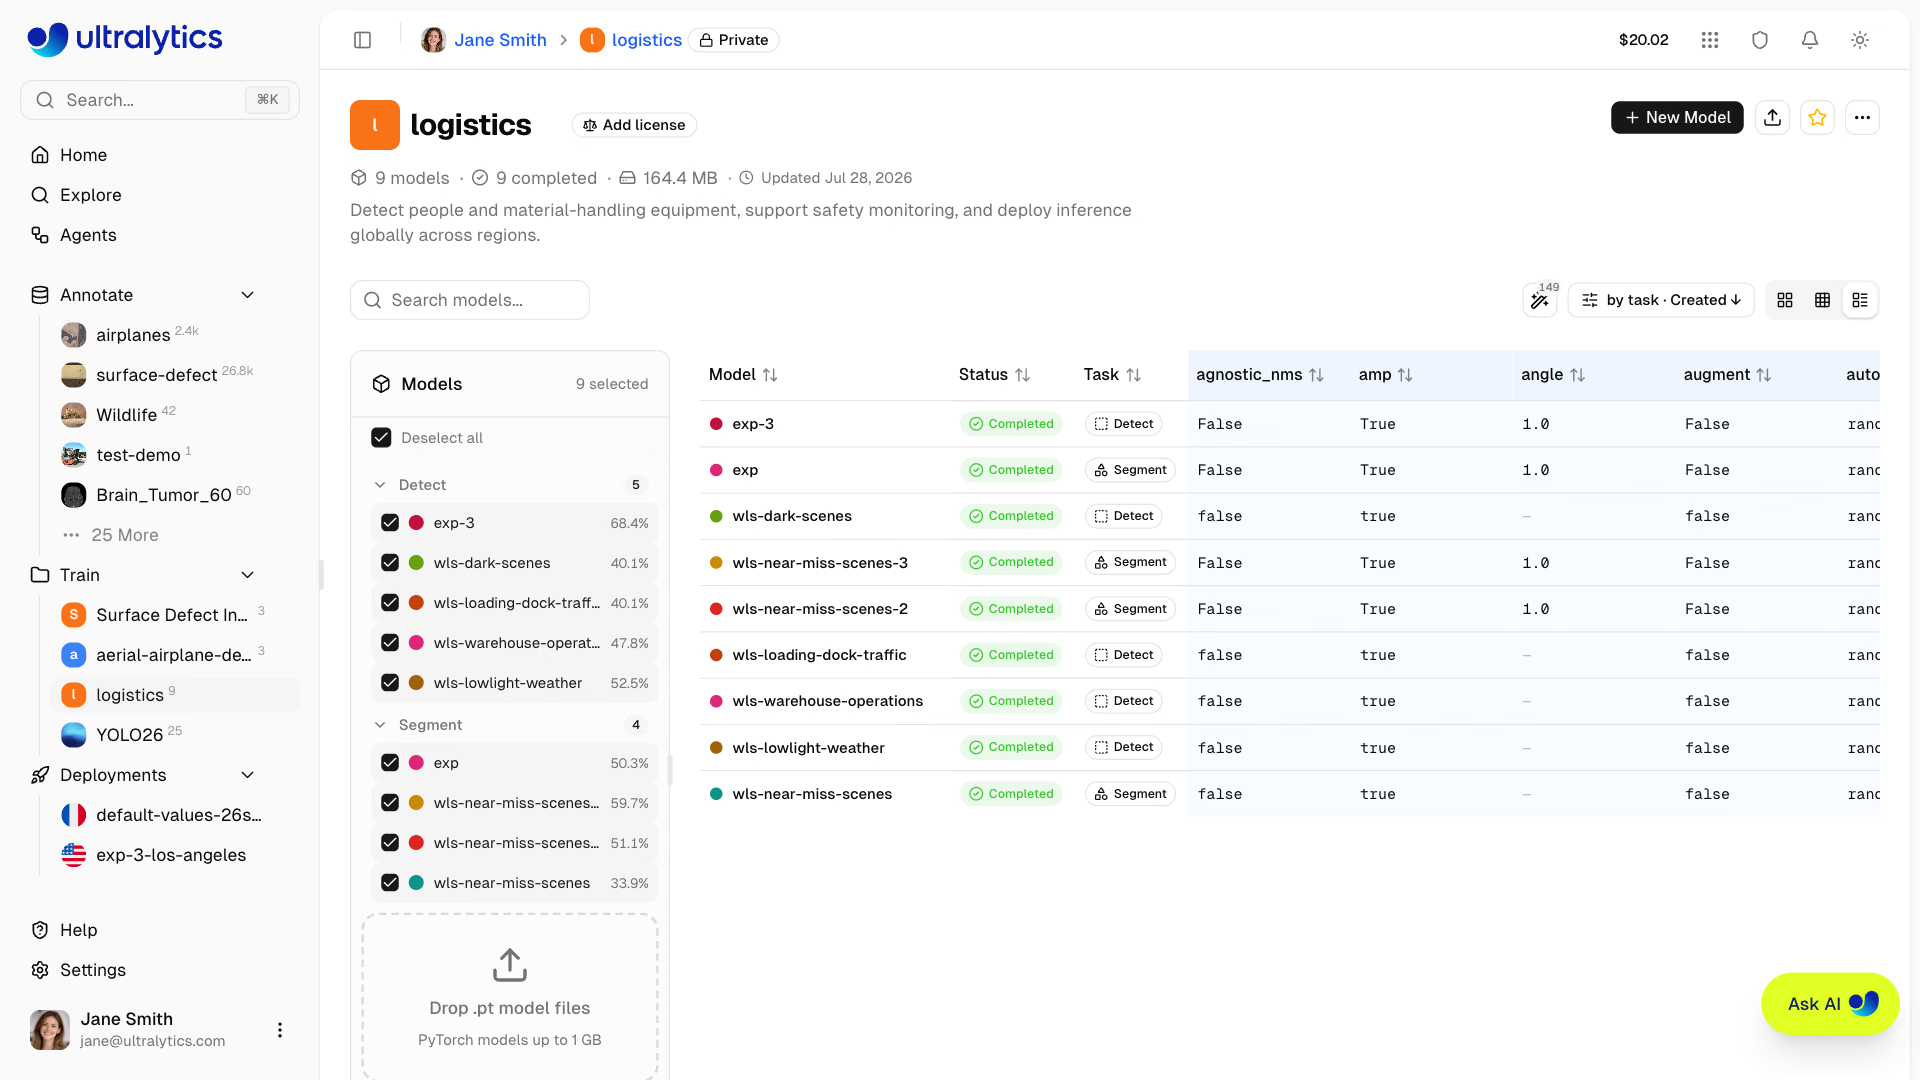
Một project liệt kê các model kèm hộp kiểm. Các model được chọn sẽ được phủ lên bảng điều khiển Charts; chế độ xem Table đặt các tham số huấn luyện và metric cuối cùng cạnh nhau, còn Diff ẩn các cột giống nhau để bạn thấy ngay hai lượt chạy chỉ khác nhau ở imgsz. Chỉ có thể so sánh trong cùng một project, vì vậy hãy gom các thử nghiệm có liên quan vào cùng nơi (có thể cắt và dán model giữa các project). Khi đọc đường cong, hãy so sánh giá trị cuối cùng, tốc độ mỗi lượt chạy đạt được giá trị đó và độ mượt của quá trình.

Khi có từ hai model đã hoàn tất trở lên, Compare with AI yêu cầu Ask AI tóm tắt điểm khác biệt và đề xuất thử nghiệm tiếp theo. Hãy xem đề xuất đó là giả thuyết cho lượt chạy tiếp theo, không phải kết luận.
Giúp mọi lượt chạy dễ giải thích#
Tên gọi truyền tải ý nghĩa: run_5 không nói lên điều gì, còn v3_pallets_added và v4_imgsz1024 cho biết phiên bản tập dữ liệu nào được dùng và có gì thay đổi. Để lưu lại lý do, hãy mở More actions > Information trên trang model rồi lưu ghi chú JSON dưới dạng Custom Metadata:
{
  "hypothesis": "Pallet AP is low because val holds only 7 pallets",
  "change": "Dataset v3: +80 pallet images from cam03 and cam07; fine-tuned from v2",
  "result": "Pallet AP 0.31 -> 0.58, overall mAP50-95 0.51 -> 0.59",
  "next": "Forklift recall drops at night; collect dawn and dusk footage"
}
Platform ghi lại các thông tin còn lại: thẻ Run Information hiển thị GPU, giá theo giờ, tổng chi phí, phiên bản ultralytics, host, model cha, phiên bản tập dữ liệu được cố định, Git commit nếu có và lệnh yolo train có thể sao chép. Chỉ có thể so sánh công bằng các lượt chạy dùng cùng phiên bản tập dữ liệu; vì vậy, mọi lượt chạy đều cần cố định một phiên bản.
Chọn metric và các cổng đánh giá trước khi xem kết quả#
| Chỉ số | Khi nào nên dùng |
|---|---|
| mAP50-95 | Mặc định cho detect, segment, pose và OBB: đánh giá cao bbox chặt, đủ ổn định để so sánh |
| mAP50 | Đối tượng lớn, tách biệt rõ, trong đó độ chặt của bbox ít quan trọng |
| AP theo từng lớp cho một lớp | Một lớp quyết định giá trị kinh doanh |
| Recall tại một mức precision cố định | Hệ thống an toàn và báo động |
| Độ trễ suy luận trên thiết bị đích | Luôn dùng làm giới hạn cứng |
Hướng dẫn về metric hiệu năng YOLO giải thích từng metric. Chỉ triển khai ứng viên nếu ứng viên vượt qua mọi cổng đánh giá:
Ví dụ thực hành: Script kiểm tra cổng triển khai#
Tải các file best.pt của những ứng viên vào vòng cuối xuống và đánh giá chúng trên cùng dữ liệu bằng cùng một đoạn code. Ví dụ này dùng hai checkpoint chính thức nên có thể chạy ở mọi nơi:
from ultralytics import YOLO

DATA = "coco8.yaml"  # identical held-out data for both runs; use your test split for the final call
BASELINE, CANDIDATE = "yolo26n.pt", "yolo26s.pt"  # e.g. best.pt from two Platform runs
NOISE, CLASS_FLOOR, LATENCY_BUDGET_MS = 0.005, 0.90, 100.0

def evaluate(weights):
    m = YOLO(weights).val(data=DATA, plots=False, verbose=False)
    per_class = {m.names[int(c)]: ap for c, ap in zip(m.box.ap_class_index, m.box.ap)}
    return m.box.map, per_class, m.speed["inference"]

(base_map, base_ap, _), (cand_map, cand_ap, cand_ms) = evaluate(BASELINE), evaluate(CANDIDATE)
weak = [n for n, ap in base_ap.items() if cand_ap.get(n, 0) < CLASS_FLOOR * ap]
gates = {
    f"mAP50-95 {base_map:.3f} -> {cand_map:.3f} beats noise": cand_map - base_map > NOISE,
    f"every class keeps {CLASS_FLOOR:.0%} of its AP (weak: {', '.join(weak) or 'none'})": not weak,
    f"inference {cand_ms:.1f} ms within {LATENCY_BUDGET_MS:.0f} ms": cand_ms <= LATENCY_BUDGET_MS,
}
for name, ok in gates.items():
    print("PASS" if ok else "FAIL", name)
print("verdict:", "ship the candidate" if all(gates.values()) else "keep the baseline, run more experiments")
raise SystemExit(0 if all(gates.values()) else 1)  # non-zero exit blocks a CI release step
PASS mAP50-95 0.669 -> 0.693 beats noise
FAIL every class keeps 90% of its AP (weak: elephant, potted plant)
PASS inference 44.1 ms within 100 ms
verdict: keep the baseline, run more experimentsKết quả: model lớn hơn thắng chung cuộc 2,4 điểm, nhưng hai lớp có AP giảm hơn 10%, nên model không vượt qua kiểm tra. Đây là hồi quy mà phép so sánh chỉ nhìn vào metric tổng quát sẽ bỏ sót. Dictionary theo từng lớp lấy từ ap_class_index và ap, chỉ bao gồm các lớp có trong dữ liệu; độ trễ được đo trên máy chạy script, vì vậy hãy chạy kiểm tra trên phần cứng tương tự thiết bị triển khai. COCO8 chỉ có 8 ảnh validation, quá ít để đưa ra quyết định thực tế. Hãy dùng tập holdout có ít nhất vài trăm ảnh và chỉ truyền split="test" đúng một lần, để đưa ra quyết định cuối cùng.
Tìm hiểu sâu các ảnh yếu#
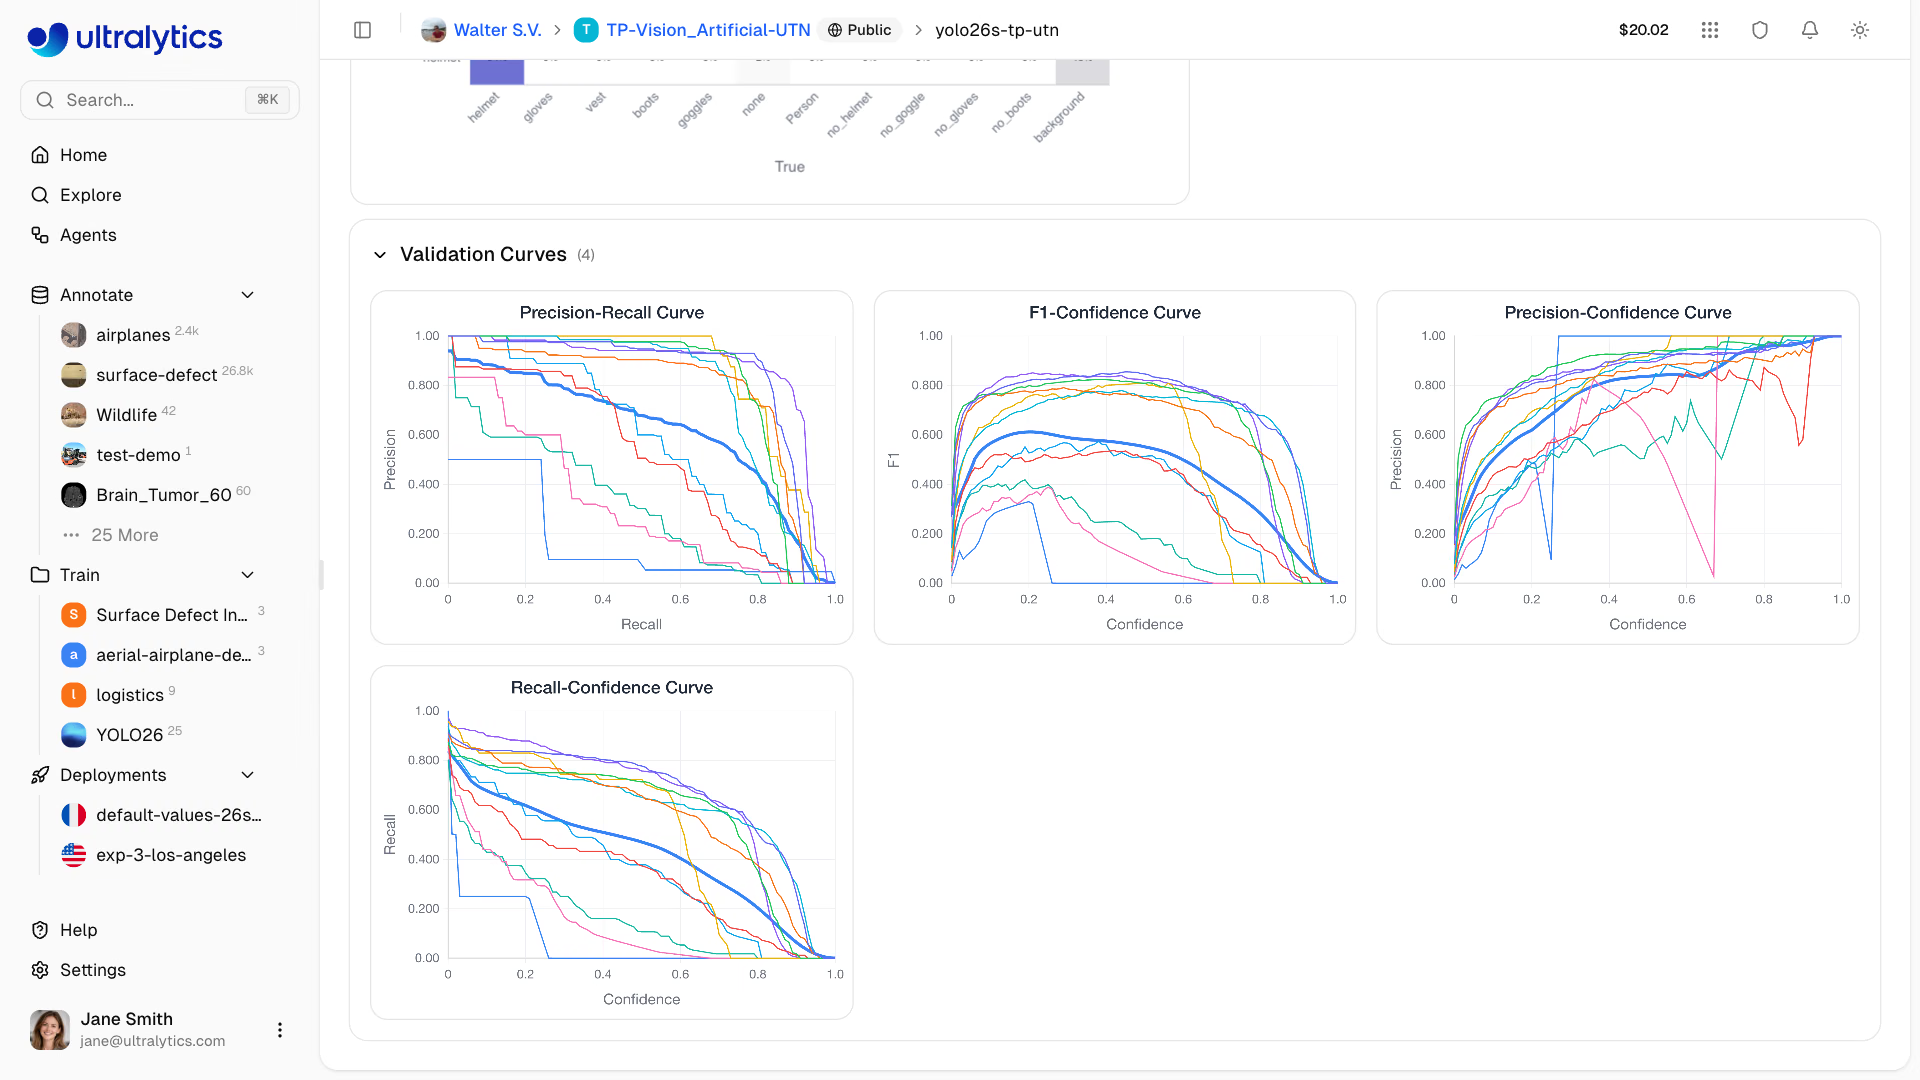
Với các lượt chạy detect được huấn luyện bằng phiên bản tập dữ liệu đã lưu, chế độ xem Validation bổ sung Validation insights: các ảnh có hiệu năng thấp nhất và cao nhất theo F1 trên từng ảnh, hiển thị cùng ground truth; công cụ khám phá đặc trưng tương quan F1 với kích thước ảnh, tỷ lệ khung hình và số lượng instance; cùng các lớp thường liên quan nhất đến lỗi. Find similar trên các ảnh kém nhất sẽ thêm ảnh tương tự vào tập huấn luyện dưới dạng ảnh chưa gán nhãn, biến một lần không vượt cổng kiểm tra thành một tác vụ dữ liệu cụ thể.
Các lỗi thường gặp#
Triệu chứng: mAP test được báo cáo rất cao, nhưng hiệu năng production lại kém hơn. Cách khắc phục: hãy tinh chỉnh trên val. Nếu bạn đã so sánh mười lần chạy trên test, thì tập test đã được dùng để tinh chỉnh và kết quả của nó đang lạc quan hơn thực tế. Chỉ đánh giá các ứng viên cuối cùng trên test một lần, vào thời điểm cuối cùng.
Triệu chứng: một lần chạy “thắng” 4 điểm nhưng không ai tái hiện được lý do. Cách khắc phục: kiểm tra version dataset được ghim trong thẻ Run Information của từng lần chạy. Nếu chúng khác nhau, hãy chạy lại baseline trên version mới trước khi so sánh.
Triệu chứng: kết quả đứng đầu thay đổi mỗi lần bạn huấn luyện lại với seed mới. Cách khắc phục: với hầu hết dataset, chênh lệch dưới khoảng 0,5 điểm mAP là nhiễu giữa các lần chạy. Hãy giữ ngưỡng nhiễu trong tiêu chí kiểm định và dùng tập holdout lớn hơn khi kết quả sát nhau như vậy.
Hiển thị lời giải
Đáp án mẫu cho model viên thuốc: baseline v1-baseline (10 epoch) so với ứng viên v2-finetune (thêm 5 epoch, SGD, lr0 0.001). Đặt DATA = "medical-pills.yaml" và hai trọng số trong gate.py. Kết quả: PASS mAP50-95 0.659 -> 0.687 beats noise, PASS every class keeps 90% of its AP (weak: none), PASS inference 4.0 ms within 100 ms, kết luận “triển khai ứng viên”. Custom Metadata trên v2: giả thuyết “v1 vẫn đang cải thiện ở epoch 10”, thay đổi “fine-tune 5 epoch, SGD lr0 0.001”, kết quả “mAP50-95 0.659 -> 0.687”. Lưu ý trong metadata: tập validation medical-pills cũng được dùng để định hướng huấn luyện, vì vậy hãy xác nhận trên một tập holdout riêng trước khi đưa vào production.