Quyền riêng tư, khu vực và tuân thủ
Chọn khu vực dữ liệu và deployment dựa trên hợp đồng, giữ dữ liệu ở chế độ riêng tư, ẩn danh hóa ảnh trước khi tải lên và hoàn thành danh sách kiểm tra tuân thủ trước khi ra mắt.
Dữ liệu thị giác thường mang tính cá nhân: khuôn mặt, biển số xe, thẻ nhân viên của một công nhân trên sàn nhà máy. Chọn khu vực dữ liệu một cách tùy tiện khi đăng ký hoặc để một tập dữ liệu ở chế độ Public có thể vi phạm hợp đồng khách hàng; cả hai đều khó khắc phục. Bài học này hướng dẫn các quyết định về khu vực, quyền hiển thị và ẩn danh hóa, kèm một bước làm mờ có thể chạy trước khi tải lên, sau đó kết thúc bằng danh sách kiểm tra để bạn gửi cho chuyên viên đánh giá tuân thủ.
Thực hành
Khu vực dữ liệu và khu vực deployment#
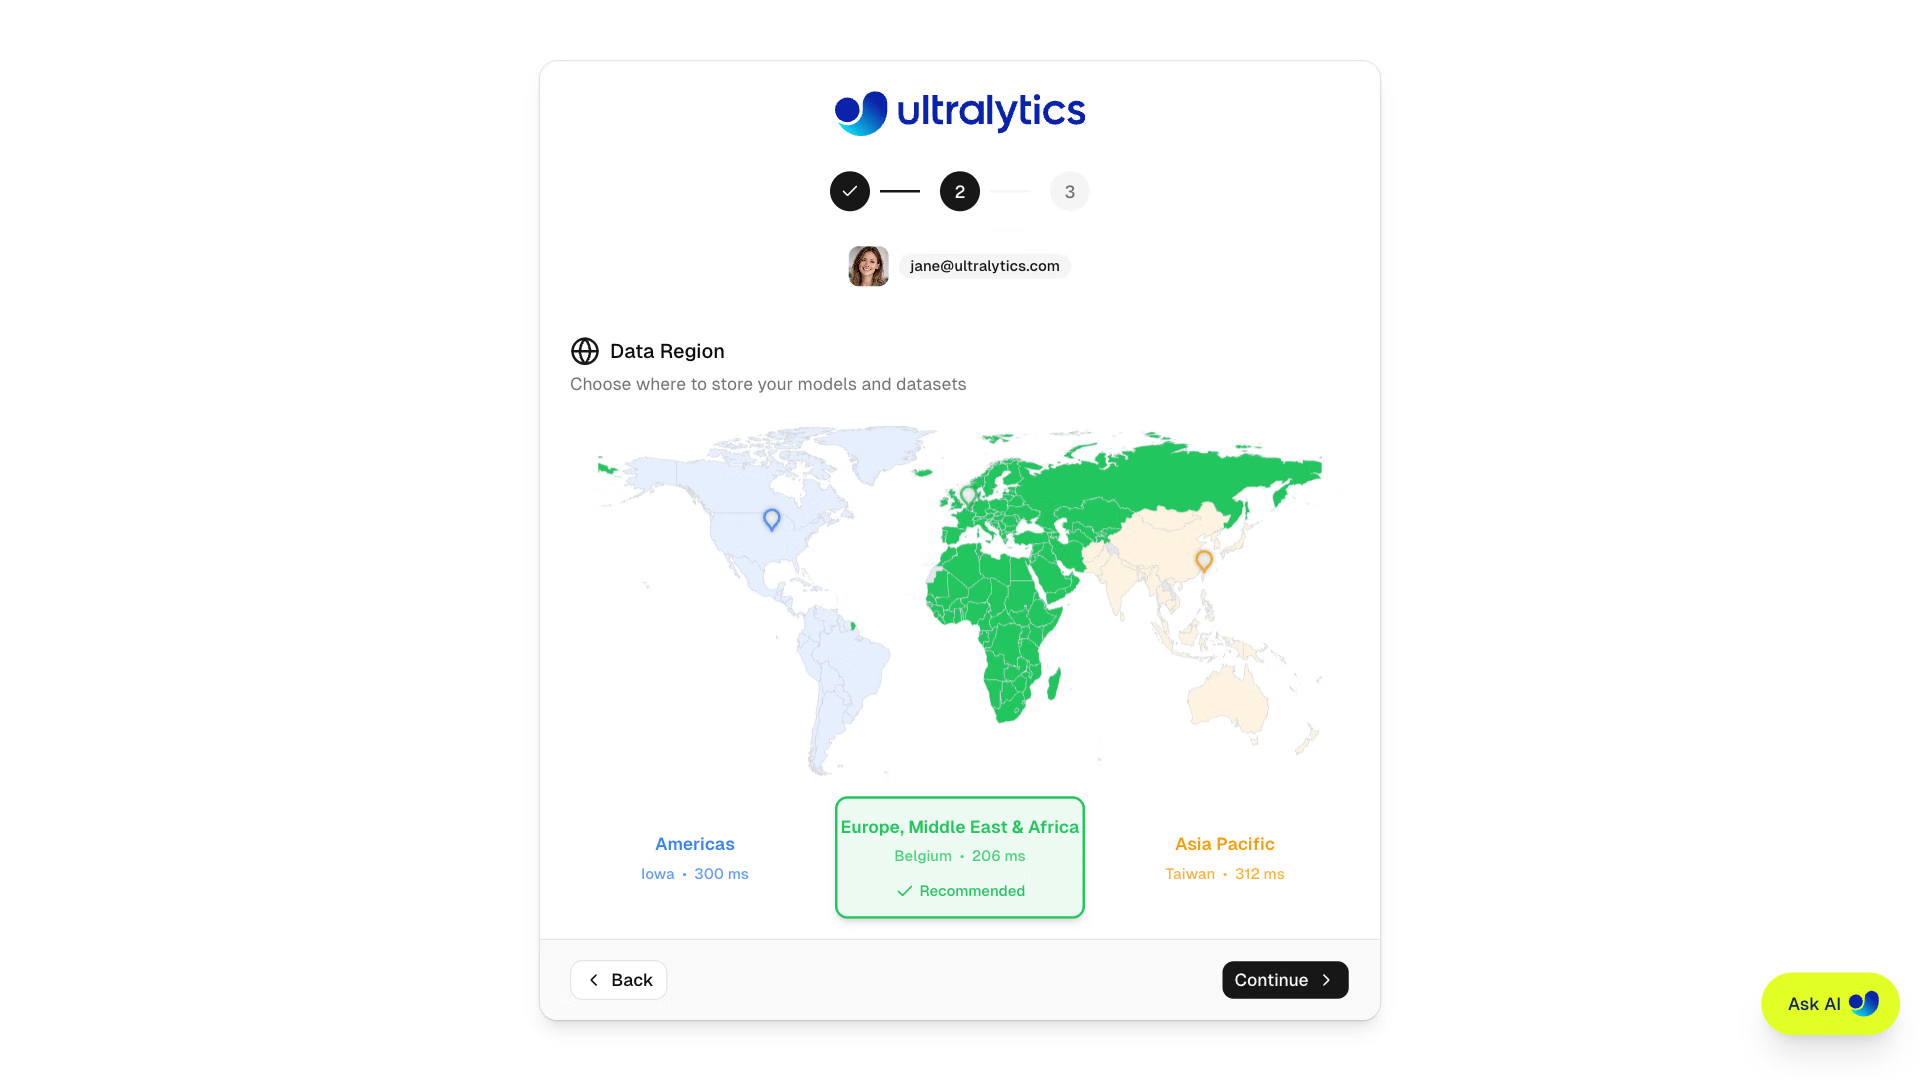
Trong quá trình onboarding, Platform đo độ trễ đến ba khu vực dữ liệu và đề xuất khu vực gần nhất. Lựa chọn của bạn trở thành dataRegion của tài khoản:
| Khu vực dữ liệu | Vị trí | Lựa chọn thường dùng cho |
|---|---|---|
US (us) | Iowa, Hoa Kỳ (us-central1) | Châu Mỹ |
EU (eu) | St. Ghislain, Bỉ (europe-west1) | Châu Âu, Trung Đông và Châu Phi; yêu cầu lưu trú dữ liệu theo GDPR |
AP (ap) | Changhua, Đài Loan (asia-east1) | Châu Á - Thái Bình Dương |
Khu vực dữ liệu quyết định nơi Platform lưu trữ tập dữ liệu, model và dữ liệu huấn luyện được quản lý, cũng như nơi chạy suy luận dùng chung. Có ba thành phần nằm ngoài khu vực này:
- Endpoint chuyên dụng chạy tại một trong 42 khu vực deployment mà bạn chọn, vì vậy workspace ở EU có thể phục vụ từ Tokyo và ảnh trong từng request sẽ được gửi đến đó.
- Dữ liệu cấp tài khoản như hồ sơ, thanh toán và hoạt động được xử lý trên toàn cầu, như mô tả trong chính sách quyền riêng tư.
- Vị trí tính toán. Khu vực dữ liệu là cam kết về nơi lưu trữ. Nếu hợp đồng giới hạn nơi xử lý dữ liệu, hãy xác nhận vị trí GPU và endpoint với Ultralytics trước khi huấn luyện, hoặc sử dụng On Premise.
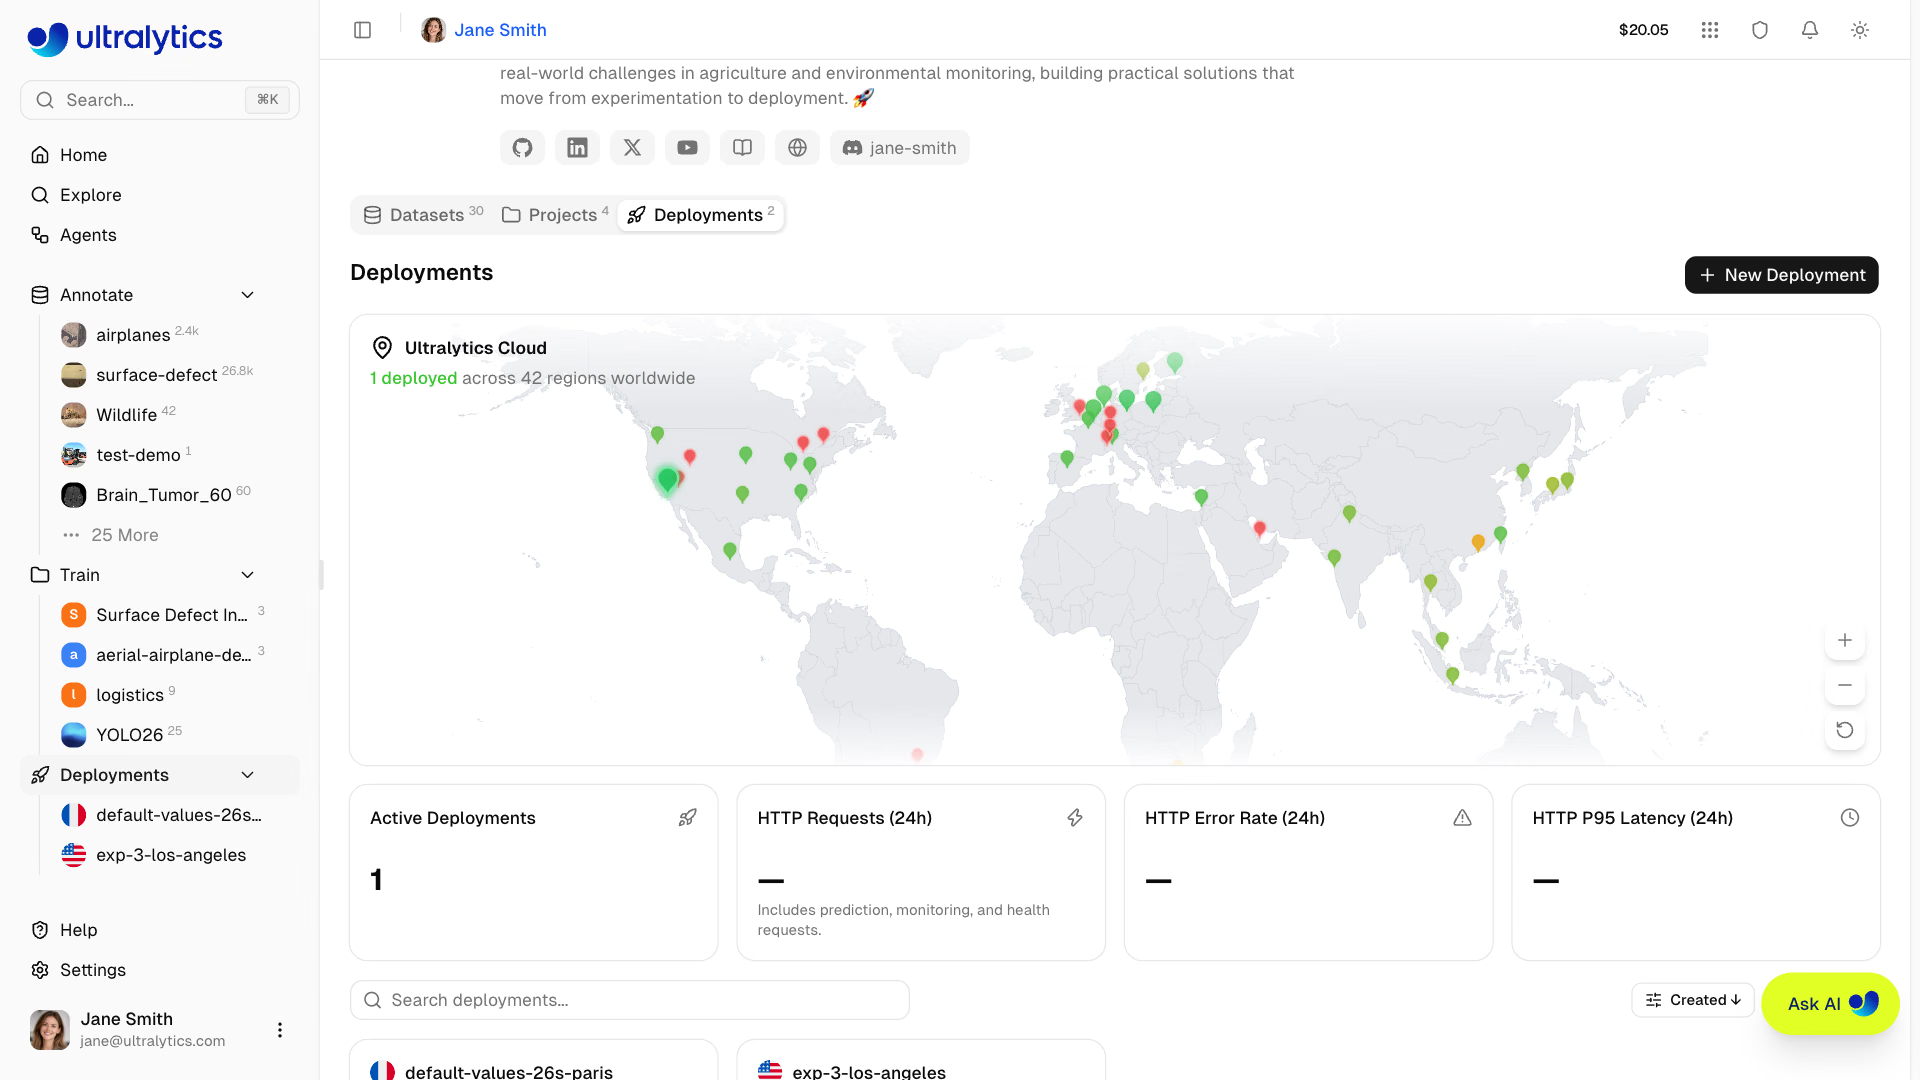
Bạn không thể tự thay đổi khu vực dữ liệu; việc này cần gửi yêu cầu hỗ trợ. Workspace nhóm kế thừa khu vực dữ liệu của người tạo workspace. Hãy đưa ra quyết định dựa trên hợp đồng, không phải độ trễ:
Khi độ trễ và yêu cầu lưu trú dữ liệu mâu thuẫn đối với người dùng đa quốc gia, hãy cân nhắc kỹ: dùng một endpoint trong khu vực dữ liệu (tuân thủ đơn giản nhất nhưng chậm hơn với người dùng ở xa), dùng endpoint ở nhiều khu vực (nhanh hơn nhưng mỗi khu vực sẽ nhận ảnh trong request, vì vậy cần kiểm tra từng khu vực theo hợp đồng), hoặc tạo workspace riêng cho từng khu vực pháp lý (mức độ tách biệt cao nhất nhưng cần vận hành nhiều hơn).
Quyền hiển thị và quyền truy cập#
Tập dữ liệu và dự án mới mặc định ở chế độ Public trên gói Free và Pro, còn ở chế độ Private trên Enterprise. Bất kỳ ai, kể cả khách truy cập chưa đăng nhập, đều có thể xem tài nguyên Public và sao chép tài nguyên từ Explore; chuyển tài nguyên sang chế độ riêng tư sau đó không xóa các bản sao mà người khác đã tạo. Workspace nhóm (Pro và Enterprise) có bốn vai trò:
| Vai trò | Quyền |
|---|---|
| Owner | Mọi quyền, bao gồm quản lý thành viên, thanh toán, xóa nhóm và chuyển quyền sở hữu |
| Admin | Chỉnh sửa mọi thứ; quản lý thanh toán, cài đặt và thành viên có quyền thấp hơn admin |
| Editor | Tạo, chỉnh sửa và xóa tài nguyên; tải lên; huấn luyện, xuất và triển khai |
| Viewer | Xem tài nguyên và thành viên trong nhóm |
Mỗi endpoint chuyên dụng được liên kết với một API key và chỉ chủ sở hữu workspace mới có thể xem giá trị khóa. Xóa khóa đó không khóa endpoint; dừng hoặc xóa deployment mới làm được điều đó.
Ví dụ thực hành: Ẩn danh hóa trước khi tải lên#
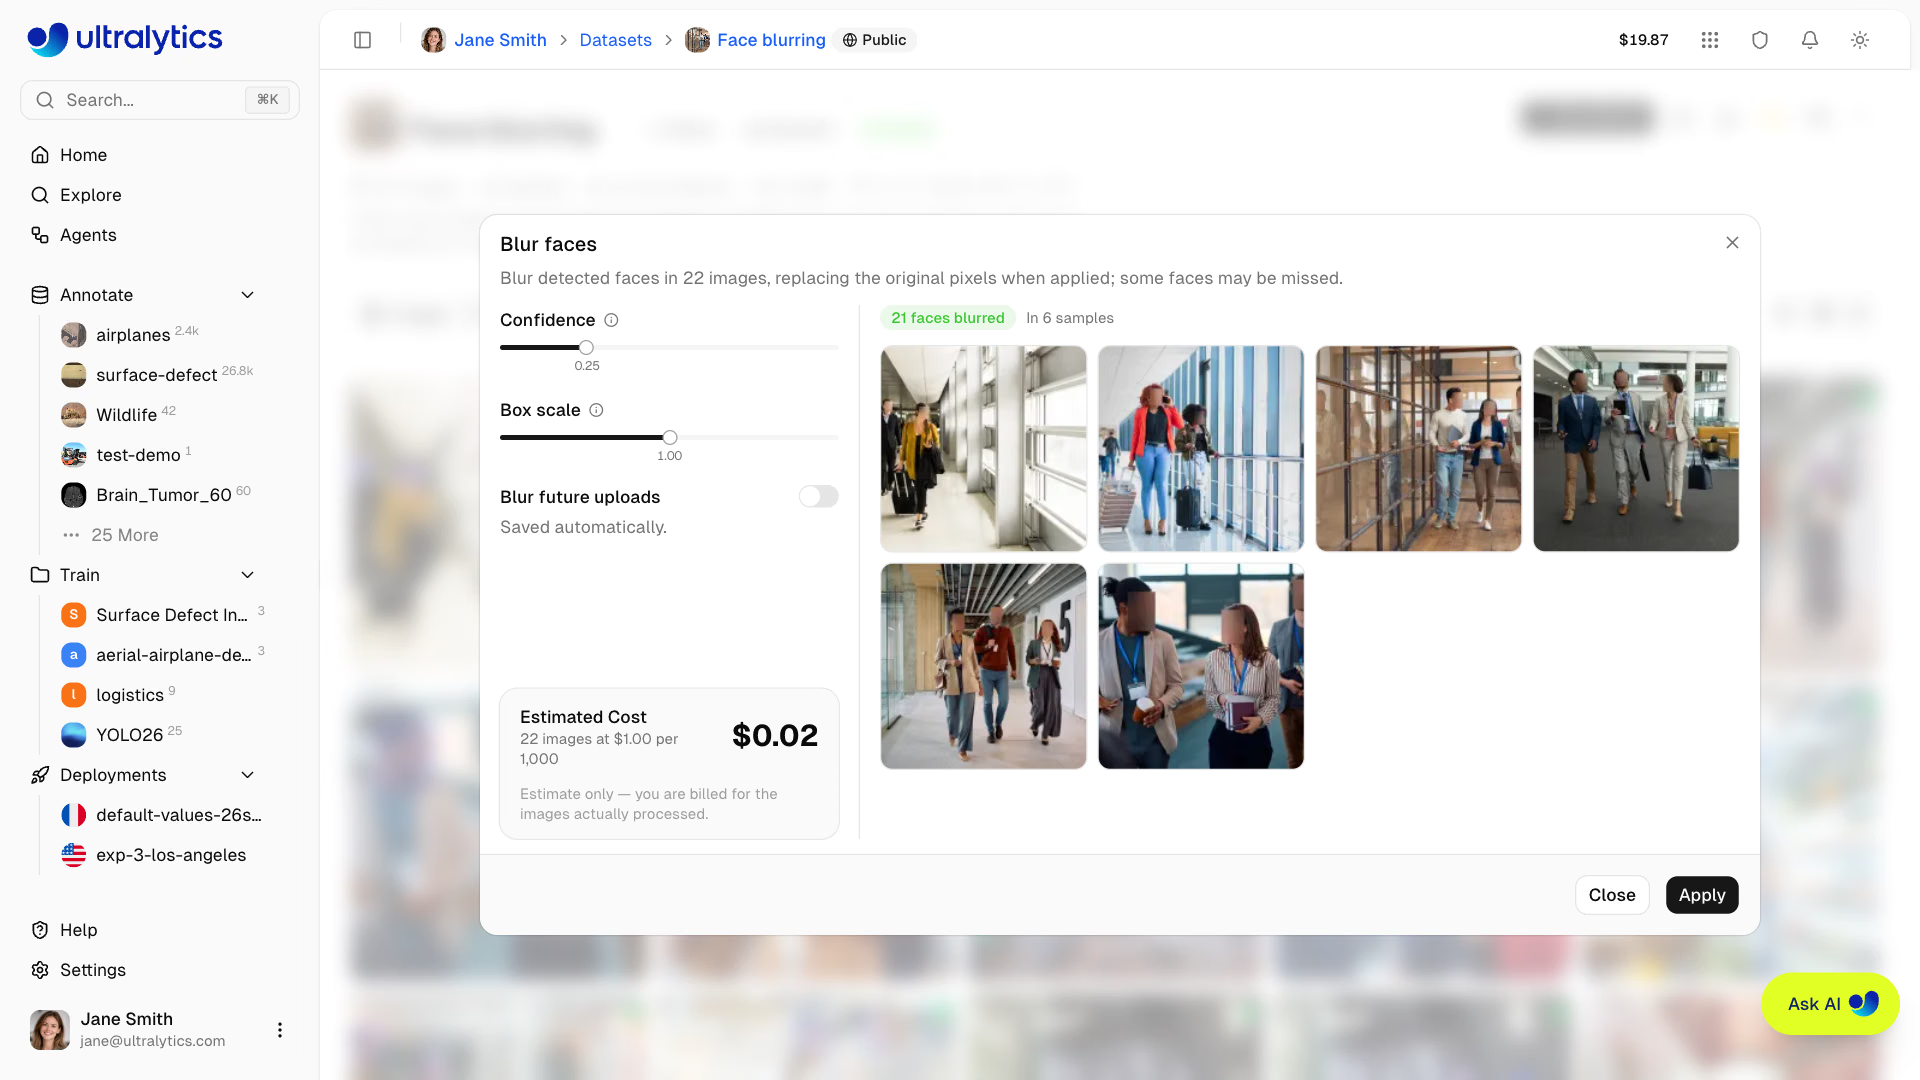
Platform làm mờ khuôn mặt: nhấp chuột phải vào ảnh và chọn Làm mờ khuôn mặt (miễn phí), chạy thao tác này trên toàn bộ tập dữ liệu từ Thao tác khác ($1.00 cho mỗi 1.000 ảnh), hoặc bật tính năng làm mờ trong hộp thoại New Dataset để ảnh được làm mờ trong quá trình xử lý khi tải lên mà không mất phí. Tính năng này không làm mờ biển số, màn hình hoặc toàn bộ người qua đường, và không dùng được với tập dữ liệu đã kết nối.
Với các trường hợp khác, hãy ẩn danh hóa trước khi pixel rời khỏi máy của bạn. Ví dụ, trong dự án xe nâng, người xuất hiện chỉ là người qua đường chứ không phải lớp cần phát hiện, vì vậy hãy làm mờ hoàn toàn từng người:
from pathlib import Path

import cv2

from ultralytics import YOLO

model = YOLO("yolo26n.pt")  # swap in a plate or face detector for those objects
out = Path("anonymized")
out.mkdir(exist_ok=True)

for result in model.predict("https://ultralytics.com/images/bus.jpg", classes=[0], conf=0.25, verbose=False):
    img = result.orig_img
    for x1, y1, x2, y2 in result.boxes.xyxy.int().tolist():
        img[y1:y2, x1:x2] = cv2.GaussianBlur(img[y1:y2, x1:x2], (51, 51), 0)  # irreversible once saved
    cv2.imwrite(str(out / Path(result.path).name), img)
    print(f"{Path(result.path).name}: blurred {len(result.boxes)} people")
bus.jpg: blurred 4 peopleclasses=[0]giới hạn phát hiện ở người; đặtpredicttrỏ đến thư mục chứa các frame để xử lý cả lô.conf=0.25được đặt thấp có chủ đích: vì quyền riêng tư, làm mờ thừa một vùng sẽ tốt hơn bỏ sót một người. Dù vậy, hãy kiểm tra ngẫu nhiên kết quả vì detector có thể bỏ sót người nhỏ hoặc bị che khuất.- Chỉ tải lên thư mục
anonymized/, và giữ bản gốc theo quy định lưu trữ dữ liệu của bạn.
Quy tắc quyết định: chỉ làm mờ khuôn mặt (bằng công cụ của Platform) khi người là lớp bạn cần phát hiện, vì làm mờ toàn thân sẽ phá hủy tín hiệu mà model học được. Làm mờ toàn bộ người qua đường khi người không phải là lớp cần phát hiện. Che biển số khi quy định của bạn xem biển số là dữ liệu cá nhân, như cách EU và California thường áp dụng. Khi chỉ có thể gửi số liệu hoặc cảnh báo ra khỏi cơ sở, hãy chạy suy luận tại edge và gửi metadata thay vì frame.
Thời hạn lưu trữ và xóa dữ liệu#
| Mục | Tác động khi xóa |
|---|---|
| Tập dữ liệu, dự án, model | Được chuyển vào Thùng rác trong 30 ngày (vẫn tính vào dung lượng lưu trữ), sau đó bị xóa vĩnh viễn |
| Deployment | Bị xóa ngay lập tức và vĩnh viễn, bao gồm lịch sử chỉ số và log |
| Ví dụ và thống kê Monitoring | Được lưu trong bộ nhớ endpoint; mất khi dừng hoặc khởi động lại, trừ khi được lưu vào tập dữ liệu |
| Tài khoản của bạn | Cài đặt > Hồ sơ > Xóa tài khoản của tôi; chủ sở hữu nhóm cần xóa hoặc chuyển giao nhóm trước |
Đối với yêu cầu truy cập, Xuất tất cả dữ liệu trong Cài đặt > Hồ sơ tạo một tệp JSON chứa metadata của bạn (hồ sơ, tập dữ liệu, dự án, model, hoạt động), không bao gồm ảnh hoặc trọng số.
Danh sách kiểm tra tuân thủ trước khi ra mắt#
- Dữ liệu nào rời khỏi môi trường của khách hàng? Frame, dự đoán hay chỉ số tổng hợp?
- Khu vực dữ liệu nào và những khu vực deployment nào? Mỗi khu vực có đáp ứng hợp đồng không?
- Mọi tập dữ liệu và dự án nhạy cảm có ở chế độ Private không? Kiểm tra các bản sao công khai đã tạo trước đó.
- Khuôn mặt đã được làm mờ và biển số đã được che khi cần chưa? Ai sẽ kiểm tra ngẫu nhiên những gì thao tác làm mờ bỏ sót?
- Bạn có được phép huấn luyện bằng dữ liệu của khách hàng này không? Nếu không, hãy lưu dữ liệu trong workspace riêng.
- Bạn sẽ xóa ảnh của một khách hàng theo yêu cầu như thế nào? Nêu tên các tập dữ liệu và bước chuyển vào Thùng rác.
- Ai có vai trò nào và ai nắm giữ API key của deployment?
Ultralytics công bố tình hình bảo mật, bao gồm chứng nhận ISO/IEC 27001:2022 và tuân thủ SOC 2 Type I, trên trang bảo mật. Hãy để chuyên viên đánh giá tuân thủ phê duyệt mọi deployment thuộc phạm vi quản lý.
Các lỗi thường gặp#
Triệu chứng: một cuộc kiểm toán về nơi lưu trú dữ liệu phát hiện ảnh trong request được xử lý tại Iowa. Cách khắc phục: vùng dữ liệu không giới hạn vị trí endpoint. Hãy triển khai ở một vùng đáp ứng yêu cầu hợp đồng và liệt kê mọi vùng endpoint trong checklist.
Triệu chứng: sau khi ẩn danh, recall của model phát hiện người giảm mạnh. Cách khắc phục: làm mờ toàn bộ người sẽ loại bỏ những đặc trưng mà model học được. Chỉ làm mờ khuôn mặt khi người là class mục tiêu, và chỉ làm mờ toàn thân khi họ là người ngoài mục tiêu.
Triệu chứng: bạn đã đặt dataset ở chế độ riêng tư nhưng các bản sao vẫn xuất hiện trên Explore. Cách khắc phục: các bản sao được tạo khi dataset còn công khai thuộc về chủ sở hữu của chúng. Hãy coi chế độ Public là không thể đảo ngược đối với dữ liệu nhạy cảm và đặt chế độ hiển thị ngay khi tạo.
Hiển thị lời giải
Đáp án mẫu cho dây chuyền đóng gói thuốc tại Đức: (1) Frame chỉ rời nhà máy để gán nhãn; dự đoán được gửi đến MES. (2) Khu vực dữ liệu EU; endpoint europe-west1. (3) Cả hai tập dữ liệu và dự án đều ở chế độ Private; không có bản sao. (4) Đôi khi thấy tay và mặt của nhân viên vận hành: tính năng Làm mờ khuôn mặt khi tải lên được bật và trưởng nhóm QA kiểm tra ngẫu nhiên 20 ảnh mỗi tuần. (5) Hợp đồng cho phép huấn luyện bằng dữ liệu nhà máy. (6) Ảnh của mỗi khách hàng được lưu trong tập dữ liệu riêng, vì vậy khi có yêu cầu xóa, cần xóa tập dữ liệu đó rồi dùng Dọn sạch Thùng rác thay vì chờ hết 30 ngày để tự động xóa. (7) Ravi là owner và nắm giữ khóa endpoint; Ana là editor; QA là viewer. anonymize.py chạy trên 20 frame đã làm mờ 23 người; một nhân viên bị che khuất một phần đã bị bỏ sót và được che thủ công, vì vậy ngưỡng được giảm xuống 0.15.