Thêm và chuẩn bị dữ liệu
Kiểm tra dataset cục bộ trước khi tải lên, chủ động lấy mẫu video và giúp dataset trên Platform đạt trạng thái Ready ngay lần đầu.
Lỗi dataset ít tốn kém nhất là lỗi bạn phát hiện trước khi tải lên. Nhãn Pascal VOC bị bỏ qua mà không có thông báo, ảnh nhỏ hơn 28 pixel bị từ chối, còn video dài 30 phút chỉ tạo ra 100 frame, phần lớn là cảnh trống. Bài học này hướng dẫn kiểm tra trước khi tải lên trong hai phút, chủ động lấy mẫu video và đọc các tín hiệu xử lý của Platform để dữ liệu huấn luyện của bạn được đưa lên đầy đủ.
Thực hành
Tạo dataset#
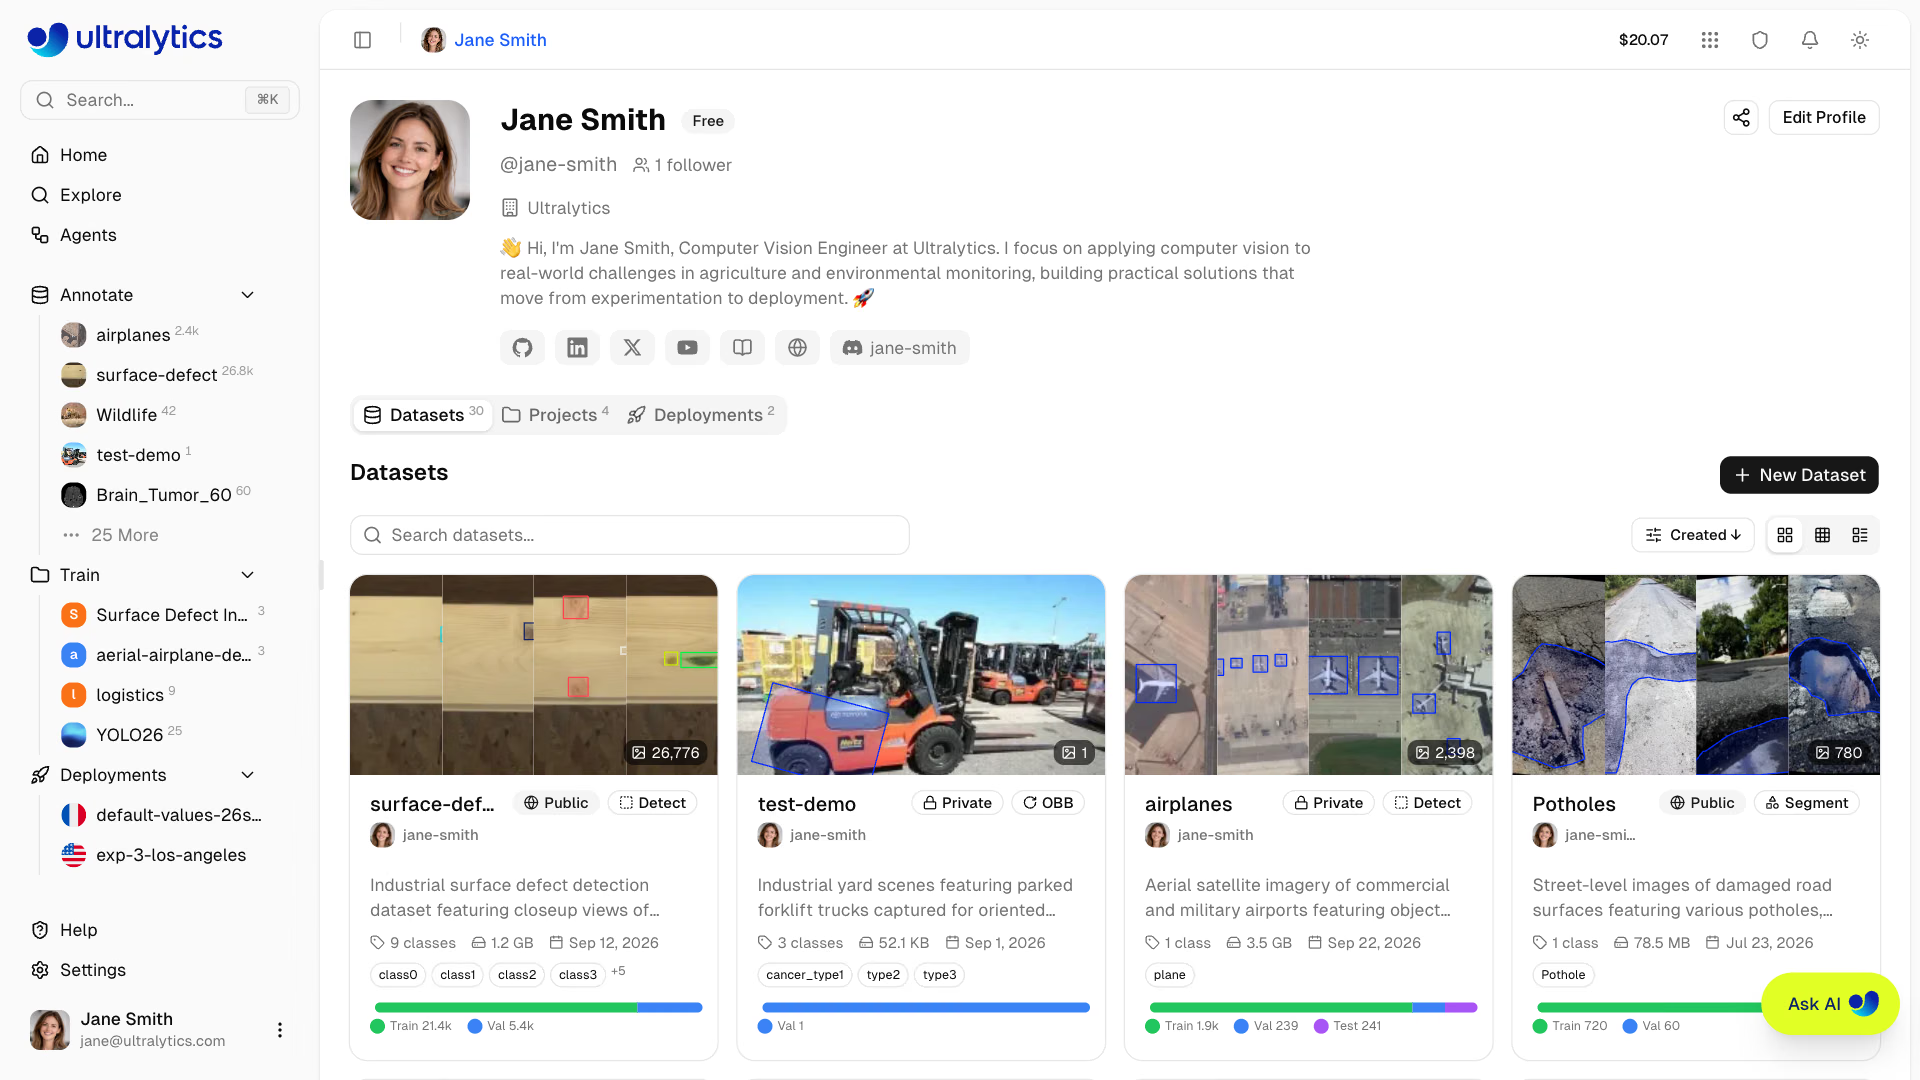
Mở Annotate trên thanh bên và nhấp vào New Dataset. Hộp thoại yêu cầu chọn nguồn, tên, loại tác vụ, giấy phép tùy chọn, làm mờ khuôn mặt và chế độ hiển thị:

| Nguồn | Sử dụng khi | Kế hoạch |
|---|---|---|
| Tải lên | File nằm trên máy của bạn: ảnh, video, archive hoặc bản xuất NDJSON | Tất cả |
| URL | Có liên kết công khai tới .zip, .tar, .tar.gz, .tgz hoặc .ndjson; Platform tải xuống ở phía máy chủ | Tất cả |
| Cloud | Dữ liệu đã nằm trong Google Cloud Storage, Amazon S3 hoặc Azure Blob Storage và nên được giữ nguyên tại đó | Pro, Enterprise |
| Tại chỗ | Dữ liệu pixel tuyệt đối không được rời khỏi máy của bạn | Enterprise |
Quy tắc quyết định: tải lên một bản sao để thực hiện khóa học này. Dataset Cloud và Tại chỗ giữ dữ liệu pixel bên ngoài Platform, do đó không thể dùng gán nhãn thông minh, Phân cụm, sao chép và tạo snapshot phiên bản.
Loại tác vụ quyết định những công cụ và model nào sẽ xuất hiện. Platform hỗ trợ cả bảy tác vụ Ultralytics YOLO:
| Tác vụ | Cách gán nhãn |
|---|---|
| Detect | Hình chữ nhật, hoặc gán nhãn thông minh bằng SAM và YOLO |
| Segment | Đa giác, hoặc gán nhãn thông minh bằng SAM và YOLO |
| Semantic | Đa giác, hoặc gán nhãn thông minh bằng SAM và YOLO; nhập trực tiếp mask PNG |
| Pose | Keypoint trên skeleton tích hợp sẵn hoặc tùy chỉnh; model pose YOLO để gán nhãn thông minh |
| OBB | Hộp định hướng, hoặc gán nhãn thông minh bằng SAM và YOLO |
| Classify | Bộ chọn lớp trên thanh bên |
| Độ sâu | Không có bản vẽ: tải ảnh lên kèm bản đồ độ sâu tương ứng (chỉ hỗ trợ tải lên hoặc URL) |
Ví dụ thực hành: Kiểm tra dataset trước khi tải lên#
Platform chấp nhận ảnh JPEG, PNG, WebP, BMP, TIFF, HEIC, AVIF, JP2, DNG và MPO có dung lượng tối đa 50 MB và cạnh ngắn tối thiểu 28 px; Platform đọc nhãn YOLO, COCO, LabelMe, NDJSON của Ultralytics hoặc Labelbox và mask PNG ngữ nghĩa. Platform nhận diện được XML Pascal VOC nhưng không nhập dữ liệu này. Script này kiểm tra dataset YOLO cục bộ theo các quy tắc đó, ở đây là dataset medical pills công khai:
from collections import Counter
from pathlib import Path

from PIL import Image

from ultralytics.data.utils import check_det_dataset

ACCEPTED = {".jpg", ".jpeg", ".png", ".webp", ".bmp", ".tif", ".tiff", ".heic", ".avif", ".jp2", ".dng", ".mpo"}
data = check_det_dataset("medical-pills.yaml")  # your local dataset YAML
root = Path(data["path"])

problems = Counter()
for split in ("train", "val", "test"):
    if not data.get(split):
        continue
    files = [p for p in Path(data[split]).rglob("*") if p.is_file()]
    images = [p for p in files if p.suffix.lower() in ACCEPTED]
    labeled = 0
    for img in images:
        label = Path(str(img).replace("images", "labels")).with_suffix(".txt")
        labeled += label.exists() and label.stat().st_size > 0
        if min(Image.open(img).size) < 28:
            problems["under 28 px (rejected)"] += 1
        if img.stat().st_size > 50 * 1024**2:
            problems["over 50 MB (rejected)"] += 1
    problems["unsupported files (skipped)"] += len(files) - len(images)
    print(f"{split:<5} {len(images):>4} images, {labeled:>4} labeled, {len(images) - labeled:>3} background")
problems["Pascal VOC .xml labels (not imported)"] += len(list(root.rglob("*.xml")))
print("classes:", data["names"])
print("problems:", {k: v for k, v in problems.items() if v} or "none")
train 92 images, 92 labeled, 0 background
val 23 images, 23 labeled, 0 background
classes: {0: 'pill'}
problems: noneKết quả cho biết điều gì:
- Số lượng theo split. Ảnh trong các thư mục
train/,val/vàtest/vẫn giữ nguyên split đó khi tải lên, vì vậy những con số này là số liệu Platform sẽ hiển thị. Nếu không có dòngval, Platform sẽ tự tạo một split validation ngẫu nhiên cho bạn (xem lỗi thường gặp bên dưới). - Ảnh nền (không có file nhãn) vẫn ổn nếu số lượng vừa phải; chúng giúp model học cách nhận biết "không có gì ở đây". Nếu có hàng trăm ảnh như vậy, thường là nhãn không được xuất thành công.
problems: nonenghĩa là mọi ảnh đều được xử lý. Bất kỳ số lượng nào ở đây đều là file sẽ xuất hiện trong tabErrorshoặc hoàn toàn không được tải lên.
Nén thư mục dataset cùng với data.yaml, rồi kéo archive vào thư viện ảnh. Platform tự động nhận diện định dạng, chỉ lưu một bản đối với các ảnh giống hệt nhau và hỏi bạn muốn Bỏ qua, Giữ cả hai hay Thay thế khi ảnh tải lên trùng với ảnh đã có trong dataset.
Ví dụ thực hành: Lấy mẫu video trước khi Platform xử lý#
Platform lấy mẫu mỗi video ở tốc độ 1 frame/giây và giữ tối đa 100 frame; với clip dài hơn 100 giây, Platform tăng khoảng cách lấy mẫu:
| Độ dài clip | Số frame được giữ | Khoảng cách |
|---|---|---|
| 60 giây | 60 | 1 giây |
| 100 giây | 100 | 1 giây |
| 30 phút (54.000 frame ở 30 fps) | 100 | 18 giây |
Cách này phù hợp để xem nhanh nhưng không đáp ứng được hầu hết dự án thực tế: video ghi lại ca làm việc dài 30 phút sẽ chỉ còn 100 frame, phần lớn là lối đi trống. Hãy tự lấy mẫu video dài rồi tải các frame lên:
Để lấy mẫu đồng đều, chỉ cần FFmpeg:
mkdir -p frames
ffmpeg -i source.mp4 -vf fps=1 frames/%06d.jpg
Để lấy mẫu theo sự kiện, hãy dùng model Ultralytics YOLO đã pretrained để chỉ giữ lại các frame có chứa đối tượng của bạn:
from pathlib import Path

import cv2

from ultralytics import YOLO

model = YOLO("yolo26n.pt")  # or your latest fine-tune
out = Path("frames")
out.mkdir(exist_ok=True)

source = "https://github.com/ultralytics/assets/releases/download/v0.0.0/solutions_ci_demo.mp4"
seen = kept = 0
for i, result in enumerate(model.predict(source, stream=True, vid_stride=5, classes=[0], conf=0.5, verbose=False)):
    seen += 1
    if len(result.boxes):  # keep only frames where a person was detected
        cv2.imwrite(str(out / f"frame_{i:05d}.jpg"), result.orig_img)
        kept += 1
print(f"Kept {kept} of {seen} sampled frames")
Kept 12 of 12 sampled framesvid_stride=5 xem xét mỗi frame thứ năm, classes=[0] giới hạn phát hiện ở người và conf=0.5 bỏ qua các dự đoán thiếu chắc chắn. Clip demo nhộn nhịp này có người trong mọi frame được lấy mẫu; với video ghi lại cảnh hầu như trống, tỷ lệ frame được giữ lại giảm mạnh, kéo theo chi phí gán nhãn cũng giảm. Tăng vid_stride cho đến khi các frame liền kề được giữ lại không còn trông giống hệt nhau.
Đọc các tín hiệu xử lý của Platform#
Sau khi tải lên, Platform xác thực, chuẩn hóa (ảnh lớn hơn 4.096 px sẽ được thay đổi kích thước), tạo thumbnail, phân tích nhãn và tính toán thống kê. Hãy kiểm tra ba nơi:
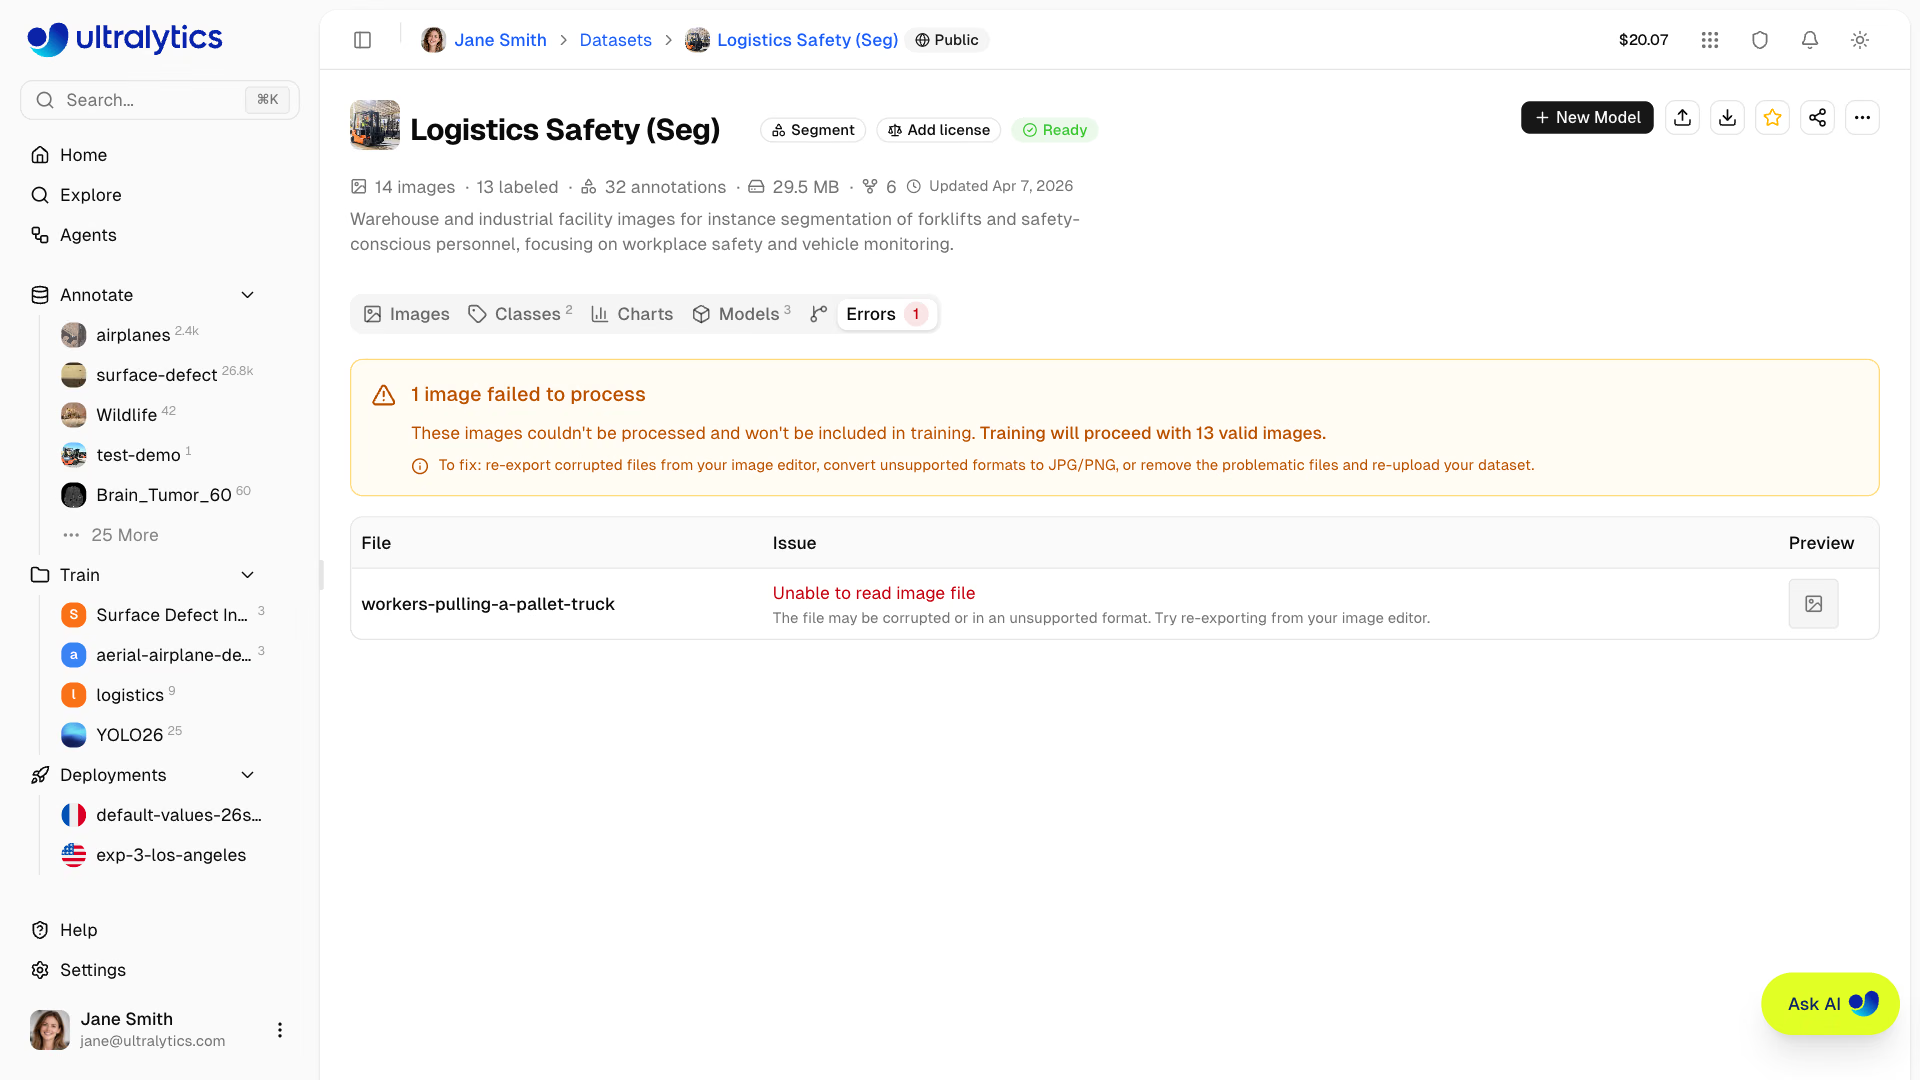
- Tab
Errorschỉ xuất hiện khi có file xử lý thất bại: file bị hỏng, định dạng không được hỗ trợ, ảnh nhỏ hơn 28 px hoặc ảnh ở chế độ màu CMYK và indexed; mỗi trường hợp đều có gợi ý khắc phục. Hãy xuất lại hoặc tải lại các file đó. - Tab
Chartshiển thị phân bố split, các class phổ biến nhất, kích thước ảnh, dung lượng file, vị trí annotation, kích thước box và số đối tượng trên mỗi ảnh. Hãy tìm class hiếm xuất hiện, ảnh quá nhỏ hoặc box tập trung ở một góc. - Huy hiệu trong tiêu đề dataset hiển thị
Readykhi quá trình xử lý hoàn tất và dataset có ít nhất một ảnhtrain, một ảnhvalhoặctest, cùng một ảnh có nhãn. Nhấp vàoNot Readyđể xem điều kiện nào chưa được đáp ứng.

Bắt đầu từ dataset công khai#
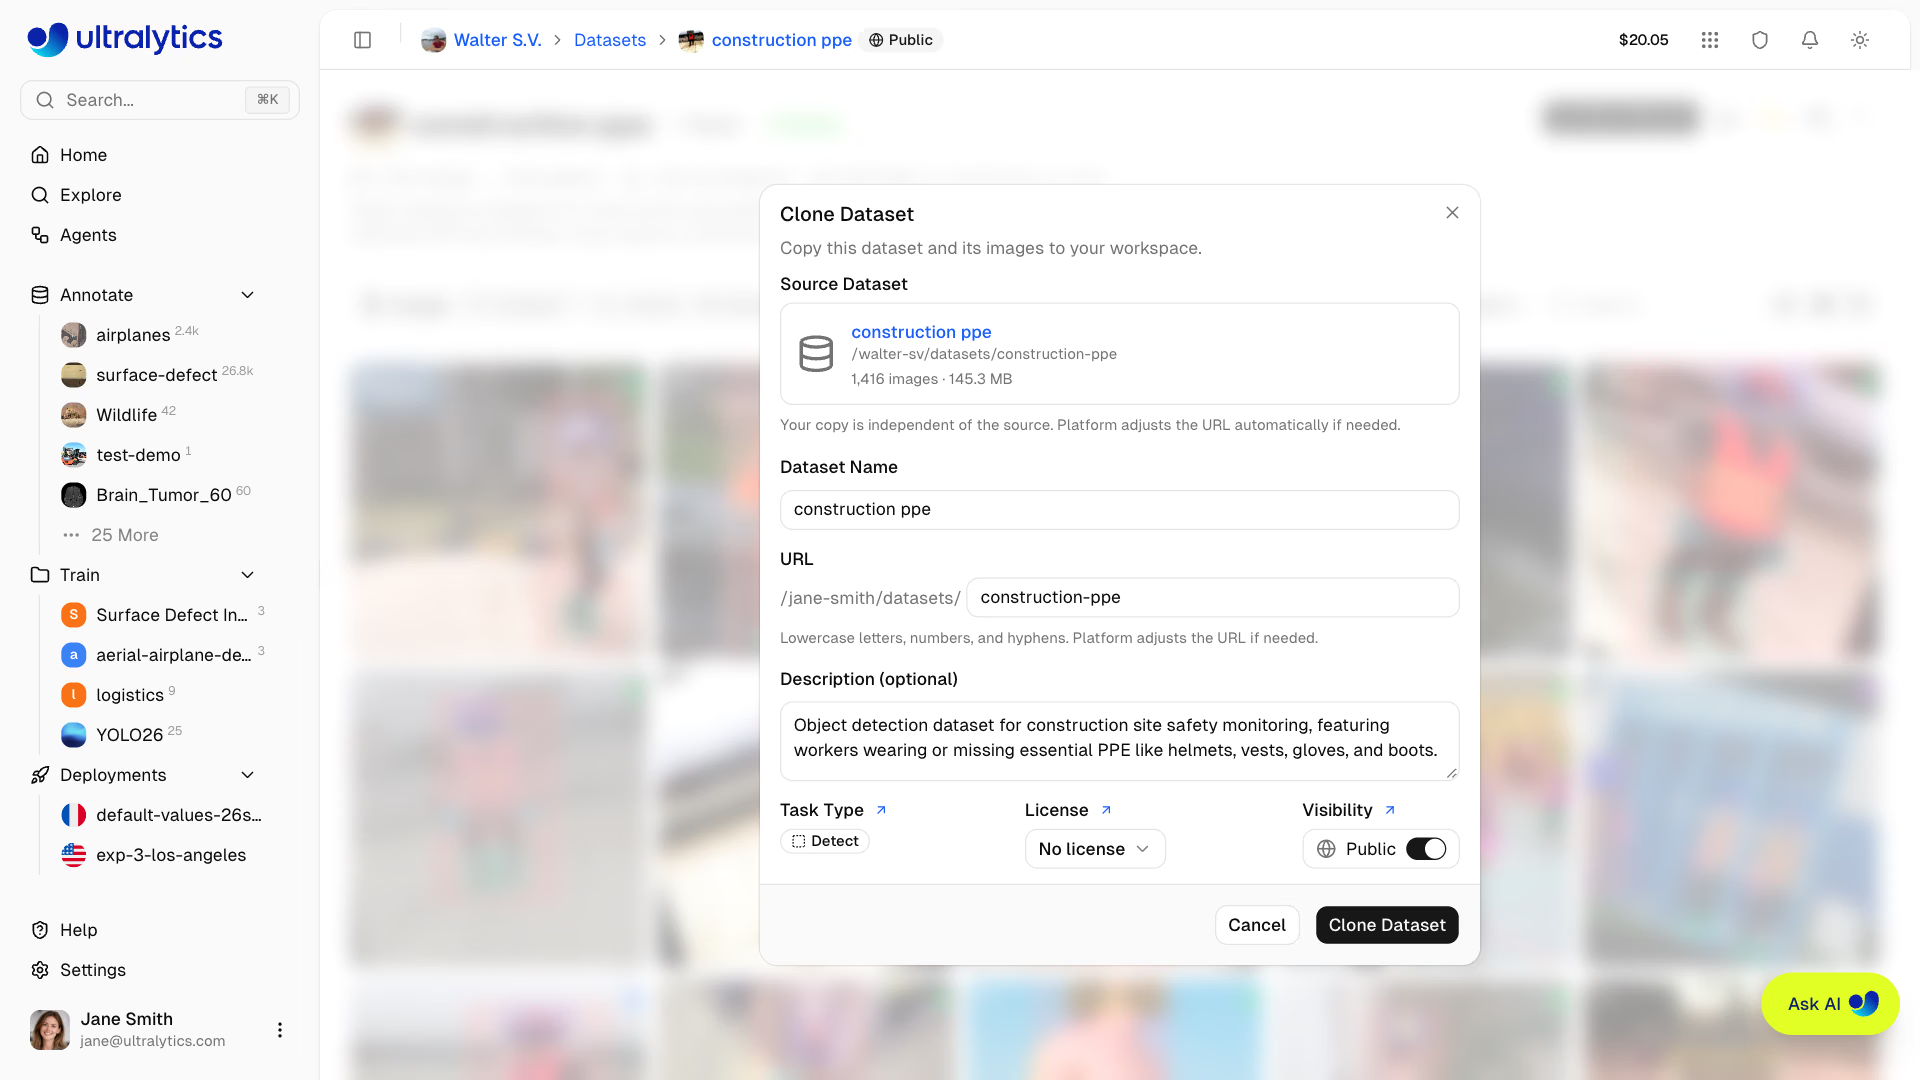
Chưa có dữ liệu? Trang Explore liệt kê các dataset chính thức và do cộng đồng đóng góp. Clone Dataset sao chép ảnh, annotation và class vào workspace của bạn, tính vào dung lượng lưu trữ và mặc định giữ nguyên chế độ hiển thị công khai của nguồn; vì vậy, hãy gạt công tắc trong hộp thoại nếu bạn định thêm dữ liệu nhạy cảm.
Các lỗi thường gặp#
Triệu chứng: tải lên thành công nhưng mọi ảnh đều không có nhãn. Cách khắc phục: Platform phát hiện XML Pascal VOC nhưng không nhập định dạng này. Trước tiên, hãy chuyển đổi sang nhãn YOLO .txt hoặc COCO JSON; bước kiểm tra trước khi tải lên đếm các tệp .xml để bạn phát hiện vấn đề này trước khi tải lên.
Triệu chứng: mAP validation rất tốt nhưng model triển khai thì không. Cách khắc phục: nếu thao tác tải lên không chọn split khiến val trống, Platform sẽ ngẫu nhiên chuyển khoảng 20% ảnh train sang val. Với frame video, cách này khiến các frame liền kề gần như giống hệt nhau nằm trong cả hai split. Thay vào đó, hãy tải lên bằng các thư mục train/ và val/ được chia theo video hoặc camera (bài học 4).
Triệu chứng: bạn không tìm thấy công cụ polygon hoặc keypoint. Cách khắc phục: loại tác vụ quyết định các công cụ khả dụng. Thay đổi loại tác vụ từ header của dataset; mỗi ảnh lưu nhãn cho mọi tác vụ, vì vậy khi chuyển đổi, nhãn của các tác vụ khác sẽ bị ẩn chứ không bị xóa.
Hiển thị lời giải
Đáp án mẫu cho medical pills cộng với video camera dây chuyền dài 4 phút. Kiểm tra trước khi tải lên: 92 ảnh train và 23 ảnh val, tất cả đều có nhãn, không có vấn đề. Video: 240 giây dài hơn 100 giây, nên khoảng cách tăng lên thành ceil(240 / 100) = 3 giây và Platform giữ lại 80 frame (một frame ở 0 giây, 3 giây, …, 237 giây). Số ảnh dự kiến trong thư viện: 92 + 23 + 80 = 195 ảnh. Các frame video được thêm vào mà không có nhãn trong split đang chọn ở bộ lọc thư viện, vì vậy hãy chọn Train trước khi thả video vào để chúng không nằm trong val. Huy hiệu hiển thị Ready vì đã có ảnh train, val và ảnh có nhãn. Nếu bạn chỉ tải video lên, huy hiệu sẽ hiển thị Not Ready: chưa có ảnh nào được gán nhãn.