反映现实的数据集
在标注更多数据前,先审查真实数据集的覆盖缺口,并将这些缺口转化为包含难负样本的数据采集计划。
许多令人失望的视觉模型并非模型本身不好,而是好模型是在一个与部署环境不符的数据集上训练的。上一课中的 COCO 检测器没有检测到任何无人机视角下的船只,因为 COCO 中的船只都是从侧面拍摄的。花五分钟审查数据集,就能在你花钱标注前发现这些缺口。
实践操作
模型学习的是数据集,而不是现实世界#
模型会在见过的示例之间进行插值。如果用晴天白天的街道图像训练,却在夜间雾天的车库中部署,模型就会失效——不是因为汽车看起来不一样,而是因为模型从未见过这种条件下的汽车。这种不匹配称为域偏移;如果验证图像也来自同一个有偏的数据集,验证就无法提醒你存在这个问题:
解决办法是从数据结构入手,而不是改算法:在标注前,有目的地采集部署环境中的数据。数据采集与标注指南介绍了具体操作方法。
审查真实数据集#
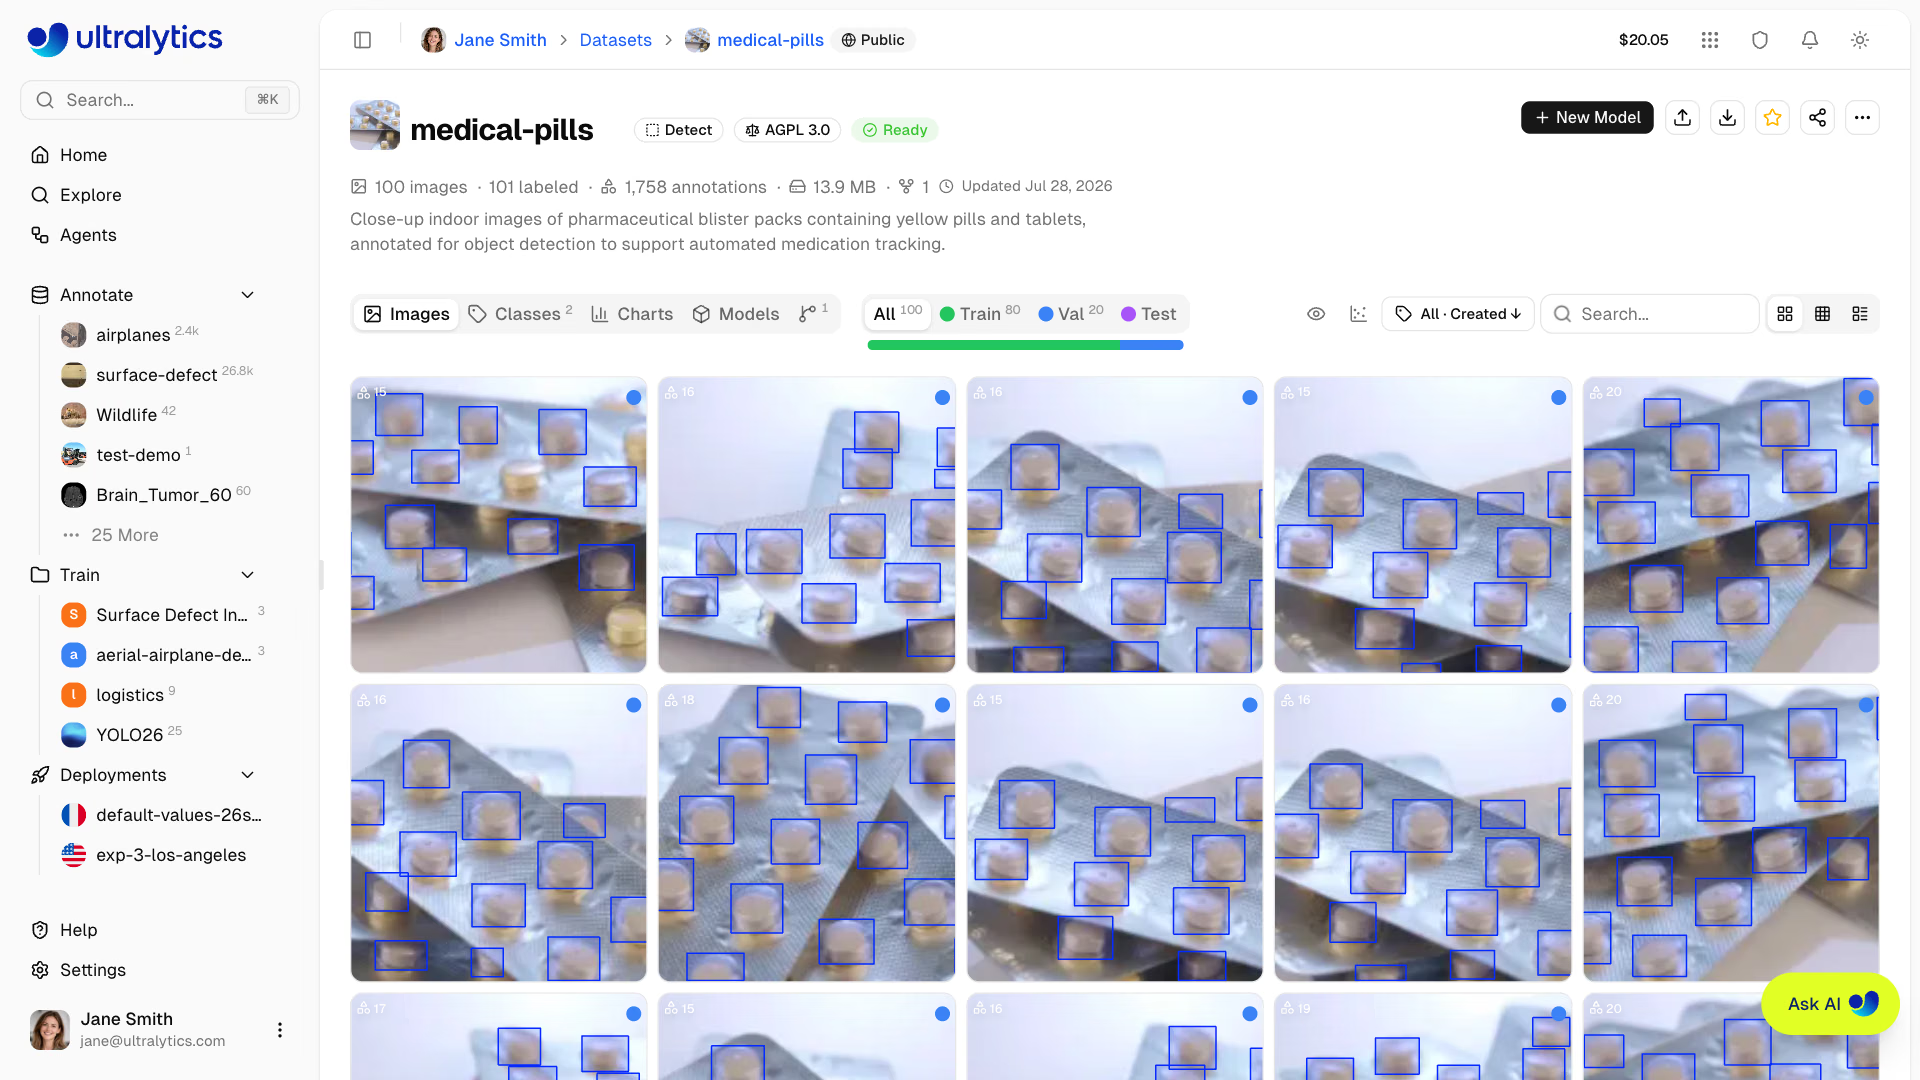
上面的 medical-pills 数据集包含泡罩包装的特写图像,每颗药丸都用边界框标出,是很适合审查的数据集。Ultralytics Platform 会在数据集页面显示主要统计数据;下面的脚本会基于随 ultralytics 一同提供的副本,计算能揭示覆盖情况的统计数据:
from collections import Counter
from pathlib import Path

from PIL import Image, ImageStat
from ultralytics.data.utils import check_det_dataset

data = check_det_dataset("medical-pills.yaml")  # downloads the dataset on first use

for split in ("train", "val"):
    images = sorted(Path(data[split]).glob("*.jpg"))
    labels = [Path(str(p).replace("/images/", "/labels/")).with_suffix(".txt") for p in images]
    rows = [line.split() for f in labels if f.exists() for line in f.read_text().splitlines()]
    classes = Counter(data["names"][int(r[0])] for r in rows)
    backgrounds = sum(not f.exists() or not f.read_text().strip() for f in labels)
    areas = sorted(float(r[3]) * float(r[4]) for r in rows)  # box area as a share of the image
    sizes = Counter(Image.open(p).size for p in images)
    brightness = [ImageStat.Stat(Image.open(p).convert("L")).mean[0] for p in images]
    print(f"{split}: {len(images)} images, {backgrounds} backgrounds, {dict(classes)}, sizes {dict(sizes)}")
    print(f"  boxes: median {areas[len(areas) // 2]:.1%} of the image, {sum(a < 0.01 for a in areas)} of {len(areas)} under 1%")
    print(f"  brightness: {min(brightness):.0f} to {max(brightness):.0f} (0 = black, 255 = white)")
train: 92 images, 0 backgrounds, {'pill': 1623}, sizes {(1920, 1080): 92}
boxes: median 1.4% of the image, 320 of 1623 under 1%
brightness: 171 to 198 (0 = black, 255 = white)
val: 23 images, 0 backgrounds, {'pill': 399}, sizes {(1920, 1080): 23}
boxes: median 1.4% of the image, 79 of 399 under 1%
brightness: 171 to 198 (0 = black, 255 = white)将其作为覆盖情况报告来阅读,每行说明一个发现:
| 发现 | 含义 | 决策 |
|---|---|---|
| 只有一种分辨率,1920×1080 | 只有一台相机、一种设置 | 从你计划部署使用的每种相机型号采集数据 |
| 亮度仅为 171–198 | 明亮、均匀的影棚灯光,没有昏暗场景 | 在部署到药房柜台前,采集昏暗、逆光和混合光照下的图像 |
| 0 张背景图像 | 模型从未见过没有药丸的场景 | 添加空泡罩包装、其他药片和空柜台作为难负样本 |
| 边界框中位数占图像的 1.4%;五个边界框中有一个小于 1% | 小物体 | 保持 imgsz 足够高,并有意加入远景图像 |
一个类别,pill | 没有药丸类型 | 如果只是计数,这样就够了;只有在决策需要时才添加类别 |
这些问题都不会体现在验证分数中,因为验证集也存在这些相同的问题。
覆盖情况的四个维度#
| 维度 | 要采集的内容 | 缺失时的典型故障 |
|---|---|---|
| 光照 | 黎明、正午、黄昏、夜间、眩光、逆光、闪烁的荧光灯 | 交接班时或阳光直射下的召回率会骤降 |
| 天气与大气状况 | 雨、雾、雪、灰尘、镜头凝露 | 将水滴误报为目标,在雾霾中漏检 |
| 遮挡与杂乱 | 部分被遮挡的目标、拥挤场景、被画面边缘截断的物体 | 目标未完全可见时就会漏检 |
| 相机与视角 | 镜头、安装高度和角度、分辨率、压缩、运动模糊 | 在试点相机上运行正常,换到下一个站点就失效 |
码头示例中遗漏的维度是视角:同一类别换一个视角,召回率就降到了零。
难负样本与背景图像#
检测器还必须学会什么不是目标。难负样本表面上看起来很相似:对叉车检测器来说,托盘搬运车、剪叉式升降机、抛光地板上叉车的倒影,以及印有叉车图案的安全海报都是难负样本。
在 YOLO 格式中,背景图像就是没有标签文件的图像——无需标注任何内容。Ultralytics 的训练技巧建议背景图像约占 0–10%,以减少误报;COCO 本身约为 1%。这部分图像应使用你自己的环境中的难负样本填充,而不是随机的空白画面。数据增强可以改变亮度和角度,但无法凭空生成模型从未见过的托盘搬运车。
常见问题#
症状:标注了 10,000 张图像,全是白天拍摄的,也全都来自试点摄像头。解决方法:在几周内从部署摄像头采集数据,覆盖全部条件范围,检查覆盖情况,然后再付费标注。合成数据可以填补已知缺口,但不能替代真实采集的数据。
症状:验证集 mAP 很高,但到了第一个新站点效果很差。解决方法:记住,验证集也有数据集本身的盲点。随机抽取十张训练图像和十帧生产画面,让队友分辨它们;如果队友分得出来,就说明存在域差距。
对于每种条件都有目标数量的采样计划,请继续阅读 构建高性能 YOLO 数据集中的收集高质量、有代表性的数据。
显示解答
对于部署在药房柜台、处于混合店内光照条件下的 medical-pills,请根据审计结果(亮度 171–198,只有一个 1920×1080 来源,没有背景图像)和快速浏览图像的结果填写网格:图像显示,同一批药盒位于同一明亮表面上,没有手部入镜:
| 类别 | 明亮的影棚灯光 | 昏暗或偏暖的店内灯光 | 逆光 / 眩光 | 被手部分遮挡 | 手机相机 |
|---|---|---|---|---|---|
pill | 2,022 | 0 | 0 | 0 | 0 |
| 背景 | 0 | 0 | 0 | — | 0 |
按优先级排序的采集计划:
- 昏暗或偏暖的店内灯光 — 柜台的常见条件,目前没有任何图像。
- 被手部分遮挡 — 几乎每次真实交互都会发生。
- 手机相机 — 第二种传感器和分辨率。
- 逆光 / 眩光 — 铝箔药板会反射窗户和顶灯的光。
难负样本:空药板(铝箔相同,但没有药片)和柜台上的其他圆形物体 — 硬币、纽扣、糖果。将它们作为背景图像加入,约占数据集的 5–10%。