从实验室到生产环境
安装 Ultralytics,在你自己的图像上运行 YOLO26,根据规范检查输出,然后选择下一步。
花 10 分钟使用预训练模型,就能回答一个决定整体计划的问题:现成模型是否已经涵盖你的类别和摄像头场景,还是你需要自己的数据?在这里,你会安装 Ultralytics,在真实图像上运行 YOLO26,并根据你在第一课中编写的规范检查结果。
实践操作
安装#
pip install ultralytics
yolo checks
第一行会安装 ultralytics Python 包和 yolo 命令;如果尚未安装 PyTorch,也会一并安装。yolo checks 会显示你的 Python、PyTorch 和 CUDA 版本,以及 Ultralytics 将使用的硬件,让你在运行任何内容之前确认环境设置。请使用全新的虚拟环境;快速入门介绍了 conda、Docker 和 GPU 环境的设置。
ultralytics 软件包可安装在 Python 3.8 及更高版本上,但当前 PyTorch 版本需要 Python 3.10 或更高版本。如果你的环境版本较旧,请先用较新的 Python 创建一个全新的虚拟环境。
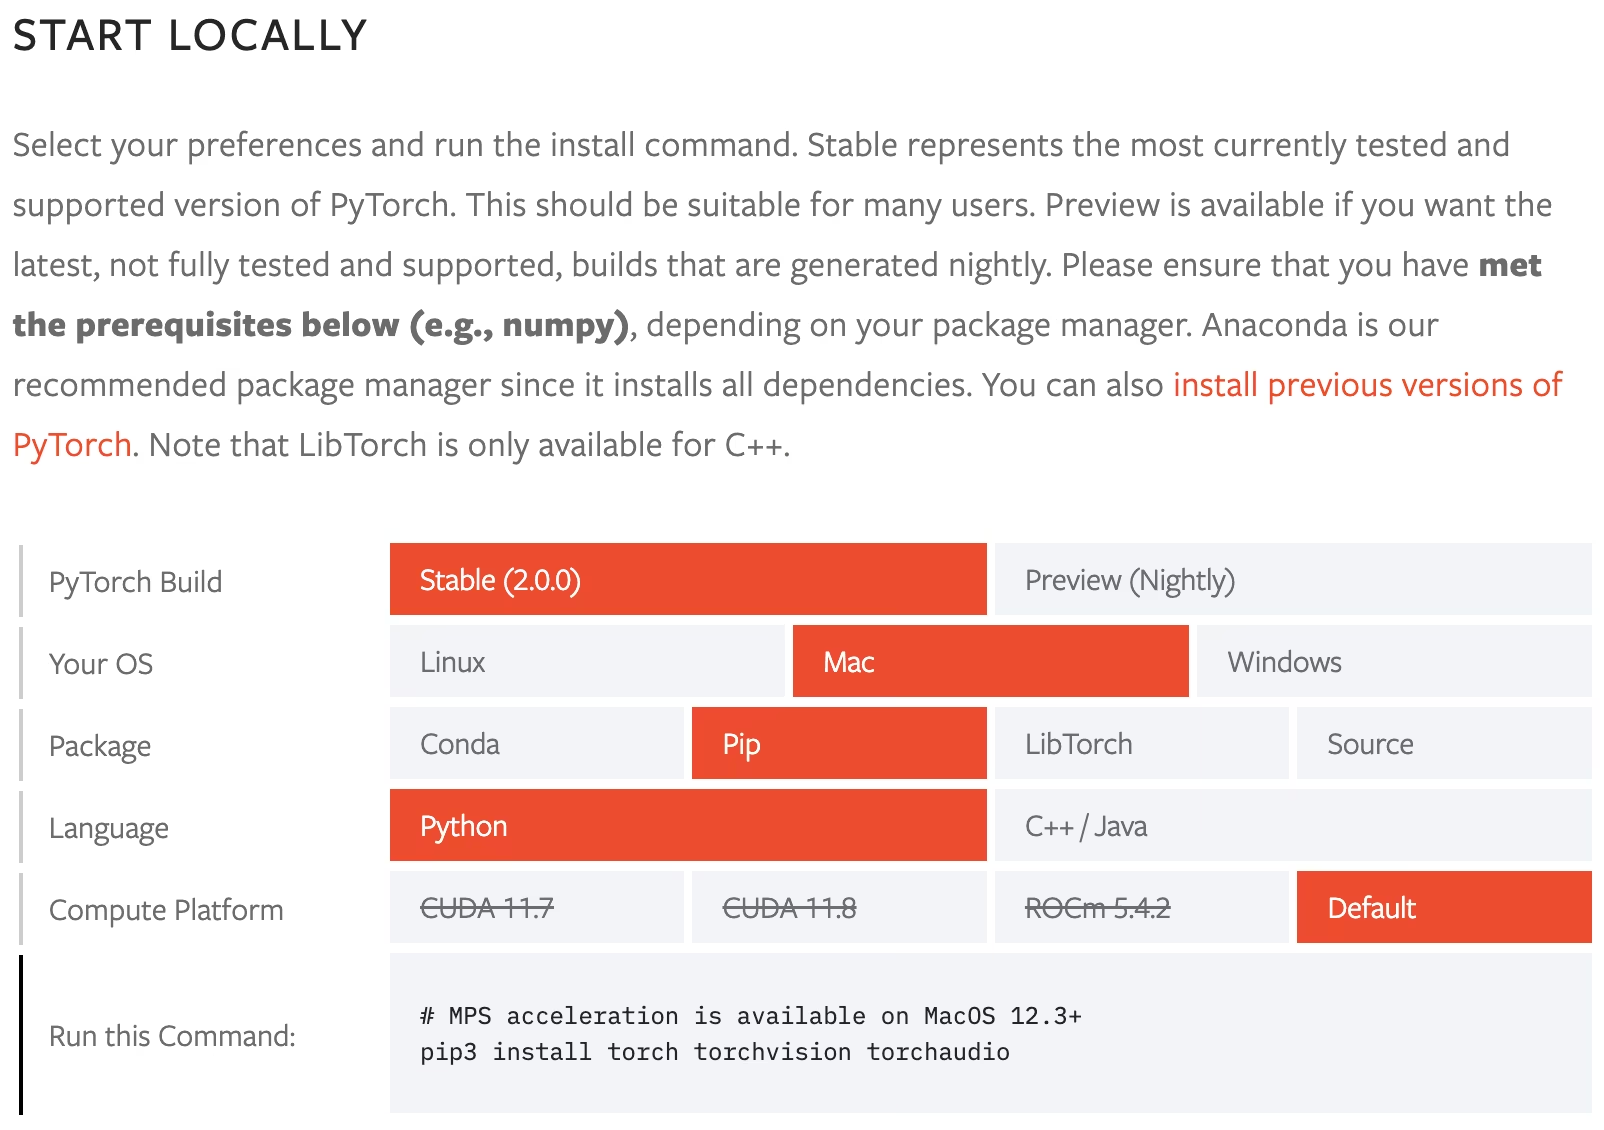
症状:装有 NVIDIA GPU 的机器上,yolo checks 显示使用 CPU,推理速度很慢。原因:安装了仅支持 CPU 的 PyTorch 版本——例如 Windows 上默认的 pip wheel。解决方法:在上方的 PyTorch 选择器中选择操作系统、包管理器和 CUDA 版本,运行显示的命令,然后重新安装 ultralytics。在 Mac 上,和截图中的情况一样,默认构建版本是正确的;除非传入 device=mps 来使用 Apple GPU,否则 Ultralytics 会使用 CPU 运行。
首次预测#
from ultralytics import YOLO

model = YOLO("yolo26n.pt")  # 首次使用时下载约 5 MB 的 nano 模型
results = model("https://ultralytics.com/images/bus.jpg", save=True)

for box in results[0].boxes:
    print(model.names[int(box.cls)], round(float(box.conf), 2))
这两种方式都会为每张图像打印一行摘要,并将带注释的图像保存到 runs/detect/predict:
image 1/1 .../bus.jpg: 640x480 4 persons, 1 bus, 19.7ms
Speed: 0.9ms preprocess, 19.7ms inference, 0.4ms postprocess per image at shape (1, 3, 640, 480)
Results saved to runs/detect/predict
逐行来看:图像被调整为 640×480 以进行推理;模型找到了 4 个人和 1 辆公交车;在笔记本电脑 CPU 上,推理耗时约 20 毫秒。Speed 这一行是你首次检查延迟的依据——将它与规范输入部分中的帧率进行比较。打开保存的图像:每个框都包含检测课程中介绍的类别、框和置信度。
根据规范检查输出#
| 问题 | 如果是 | 如果不是 |
|---|---|---|
| 你的类别是否属于模型认识的 80 个 COCO 类别? | 无需训练即可制作原型 | 你需要标注数据并进行微调(微调指南) |
| 在你自己的图像上,超过阈值的检测框是否落在正确的对象上? | 任务和视角相符 | 预计会有领域差异:从你的摄像头采集数据 |
| 输出类型是否符合决策规则的要求? | 继续使用当前任务 | 更换权重:-seg、-sem、-depth、-pose、-obb 或 -cls |
| 它在目标硬件上是否足以满足你的帧率要求? | 继续下一步 | 尝试更小的模型或经过优化的导出格式 |
第一个问题有明确答案:model.names 列出了预训练模型认识的所有类别。对于叉车规范,person 是 COCO 类别,而 forklift 不是,因此无论阈值设为多少,预训练模型都无法找到叉车。这是首次运行时最常见的结果——模型只涵盖规范中的一部分内容。正确的做法是先用已有类别制作决策逻辑原型,同时为其余类别构建数据集。
生产环境中的变化#
部署后的模型会遇到数据集从未采样过的情况:新摄像头、新季节、新产品、新制服。如果不重新训练,准确率会逐渐下降;如果根据生产环境中遇到的情况定期重新训练,准确率就会恢复:
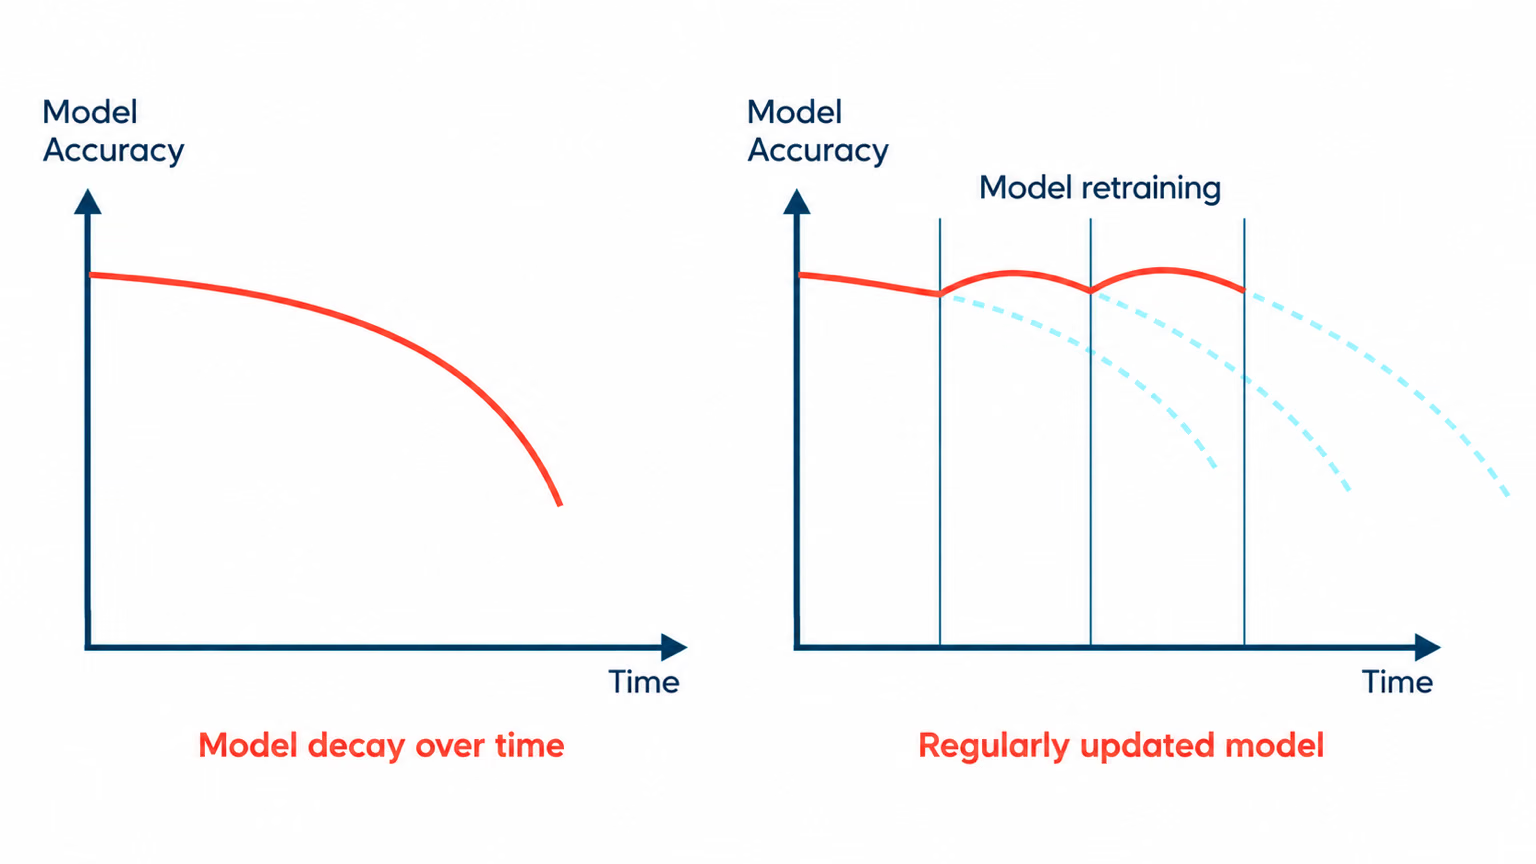
本课程的每一课都会为这个循环提供支持:规范定义失败情况,覆盖率审查指出需要关注的地方,标签检查器和指南让新数据发挥作用,而严谨的数据集划分和指标则告诉你重新训练后的模型是否真的更好。从第一天起养成两个习惯,就能让这个循环有效运转:记录一部分输入和预测,包括低置信度的结果;保留固定测试集,确保每个模型都在同一批图像上进行比较。可观测性与漂移会深入介绍数据漂移监控。
下一步学什么#
| 课程 | 适合学习的情况 |
|---|---|
| 构建高性能 YOLO 数据集 | 你的类别不在预训练类别中,或者你的场景与 COCO 不同 |
| 训练你的第一个 YOLO 模型 | 你有标注数据集,并希望进行微调 |
| 生产环境中的 Ultralytics YOLO | 你已有模型,需要导出、跟踪和监控 |
| 使用 Ultralytics Platform 构建 | 你希望在同一个地方完成数据处理、标注、训练和部署 |
更喜欢基于浏览器的工作流?Ultralytics Platform 可以运行同样的流程——上传、标注、训练、部署——无需本地安装:
显示解答
from pathlib import Path

from ultralytics import YOLO

model = YOLO("yolo26n.pt")

# 1. Which classes in your output line does the pretrained model already know?
spec_classes = {"person", "forklift"}
known = set(model.names.values())
print(f"pretrained: {sorted(spec_classes & known)}  needs your own data: {sorted(spec_classes - known)}")

# 2. What does it find on your images?
sources = [
    "https://ultralytics.com/images/bus.jpg",  # replace with your own images
    "https://ultralytics.com/images/zidane.jpg",
]
for source, result in zip(sources, model.predict(sources, conf=0.25, save=True, verbose=False)):
    names = [result.names[int(c)] for c in result.boxes.cls]
    print(f"{Path(source).name}: {len(names)} detections -> {sorted(set(names))}")
pretrained: ['person'] needs your own data: ['forklift']
bus.jpg: 5 detections -> ['bus', 'person']
zidane.jpg: 3 detections -> ['person', 'tie']对于叉车规范:person 已涵盖,forklift 未涵盖。下一步:现在先用预训练模型在人身上测试区域规则,同时开始学习构建高性能 YOLO 数据集,从仓库摄像头采集并标注叉车。