框与掩码:什么时候你才真正需要分割
在真实图像上衡量掩码相比框多提供了什么,并根据下游使用方判断项目是否需要形状信息。
大多数人想象 AI 视觉时,脑海中浮现的就是掩码;而掩码也是最容易让团队耗尽标注预算的部分。掩码能告诉你目标的精确形状;框只能告诉你目标的位置。这种差异会彻底决定某些产品的方案,但对大多数产品毫无影响。
实践操作
掩码能增加什么#
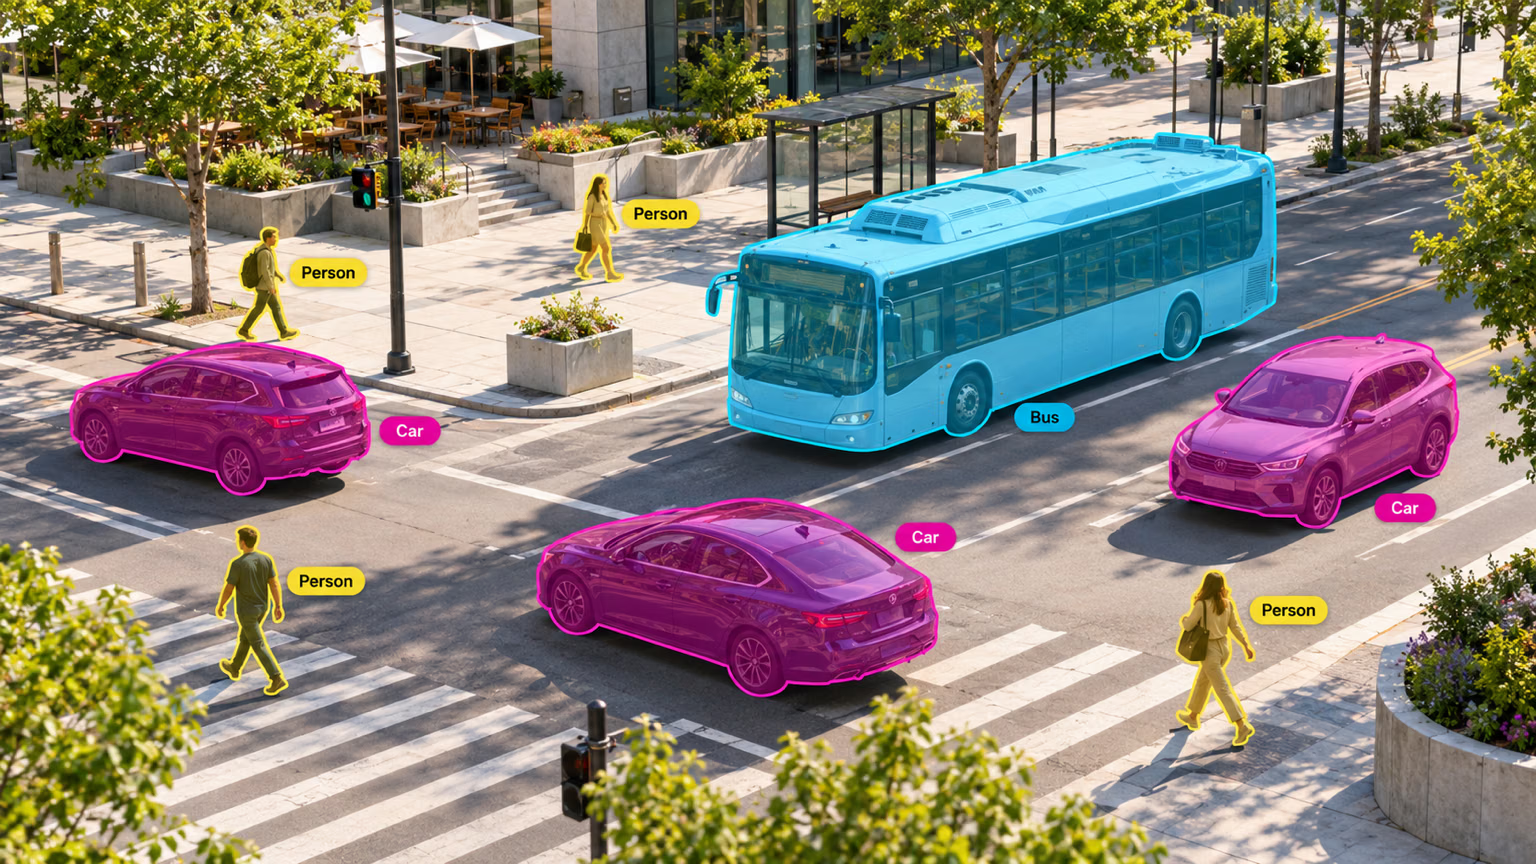
对于每个目标,分割任务会返回检测器提供的所有信息——类别、框、置信度——并额外提供属于该目标的像素,因此上图中的每辆汽车都有自己的轮廓,与公交车和行人分开。你可以将掩码读取为多边形(masks.xy)或二值图像(masks.data)。
形状会对数值产生多大影响?比较每个目标的框面积和掩码面积:
from ultralytics import YOLO

model = YOLO("yolo26n-seg.pt")
result = model("https://ultralytics.com/images/bus.jpg", retina_masks=True, verbose=False)[0]

for box, mask in zip(result.boxes, result.masks.data):
    x1, y1, x2, y2 = box.xyxy[0].tolist()
    box_area = (x2 - x1) * (y2 - y1)
    mask_area = float(mask.sum())  # pixels inside the object's mask
    name, ratio = result.names[int(box.cls)], mask_area / box_area
    print(f"{name:7} box={box_area:7.0f} px  mask={mask_area:7.0f} px  ({ratio:.0%})")
person box= 97116 px mask= 49331 px (51%)
person box= 68102 px mask= 21316 px (31%)
bus box= 410093 px mask= 255265 px (62%)
person box= 55998 px mask= 33524 px (60%)
person box= 23690 px mask= 11109 px (47%)公交车只占其框面积的 62%,一个行人只占 31%。仅根据框计算的任何数值——涂漆面积、溢出面积、货架空置面积——误差都会达到这个幅度。如果你的产品要报告这类数值,就需要掩码。如果产品只负责计数或定位,额外的像素毫无作用。
症状:掩码面积看起来比边界框面积小了 3–4 倍。原因:默认情况下,masks.data 返回的是推理尺寸的结果(这里为 640×480),而边界框使用的是原始图像像素坐标(1080×810)。解决方法:像上面那样传入 retina_masks=True,或自行缩放计数值。
根据使用方做决定,而不是看演示效果#
| 下游需求 | 框够用吗? | 原因 |
|---|---|---|
| 计数目标或检查目标是否存在 | 是 | 位置就是全部所需信息 |
| 目标进入某个区域时发出警报 | 是 | 判断框是否越过一条线就够了 |
| 跨帧跟踪目标 | 是 | 跟踪器会关联各帧中的框 |
| 为第二个分类器裁剪图像 | 是 | 裁剪只需要框 |
| 测量面积或覆盖范围(杂草、锈蚀、溢出) | 否 | 不规则形状会让框面积失去意义 |
| 抠出目标(背景移除、AR) | 否 | 你需要精确的边缘 |
| 检查间隙或接触情况(机器人抓取、碰撞) | 否 | 框会夸大目标尺寸 |
| 分离相互接触的不规则目标 | 通常不够 | 重叠的框难以区分像素分别属于哪个目标 |
如果产品需要的每一项都回答“是”,就部署检测器。只有在形状确实有用时,才选择 YOLO26 分割。
实例分割与语义分割#
实例分割会为每个目标生成独立掩码,因此三辆重叠的汽车仍然是三辆车。语义分割只为每个像素标注类别,不提供其他信息:所有汽车像素都会合并成一个“汽车”区域,目标数量也就无从得知。要计数或测量单个目标——例如细胞、水果、缺陷——使用实例分割。要测量区域覆盖范围——例如道路与人行道、作物与土壤——使用语义分割。
标注形状的成本#
标注一个框只需点击两次。标注一个优质多边形可能需要点击几十次,而且每条边界都可能引发标注人员分歧:袋子算不算人物的一部分?阴影算不算汽车的一部分?与其相信经验法则,不如测量你自己的成本:让一位标注人员分别用框和多边形标注 20 个目标,记录耗时差异,再乘以数据集规模。
AI 辅助工具可以大幅缩小这种差距。智能标注和批量标注可以根据一次点击或一个框生成掩码,让标注人员修正边缘,而不必描摹整个轮廓——但仍然需要有人检查每条边界。
在开始标注之前,先决定如何处理遮挡、透明物体、阴影、被画面边缘截断的物体,以及附属物品(包、把手、货物),并把同一份说明提供给标注人员和审核人员。标注最佳实践介绍了如何落实这些规则;COCO-Seg 数据集展示了如何大规模保持掩码一致。
抽查掩码时,留意越界(掩码溢出边缘)、空洞(目标内部区域漏标)、伪边缘(掩码沿着 JPEG 压缩伪影延伸)和模糊部位(行李箱把手是否属于行李箱掩码?)。
显示解答
假设两个产品共用一台公交车摄像头:一个人数计数器,一个道路占用率报告,用于说明车辆覆盖了多少场景区域。用同一次运行测量这两个结果:
from ultralytics import YOLO

model = YOLO("yolo26n-seg.pt")
result = model("https://ultralytics.com/images/bus.jpg", retina_masks=True, verbose=False)[0]
height, width = result.orig_shape

for name in sorted({result.names[int(c)] for c in result.boxes.cls}):
    rows = [i for i, c in enumerate(result.boxes.cls) if result.names[int(c)] == name]
    union = result.masks.data[rows].amax(dim=0)  # merge masks so overlaps count once
    box_union = sum(float((b[2] - b[0]) * (b[3] - b[1])) for b in result.boxes.xyxy[rows])
    print(f"{name:6} {len(rows)} objects | masks cover {float(union.sum()) / (height * width):.0%} of the image, boxes {box_union / (height * width):.0%}")
bus 1 objects | masks cover 29% of the image, boxes 47%
person 4 objects | masks cover 13% of the image, boxes 28%- 人数计数器 → 框。无论使用哪种方式,计数都是 4;掩码会增加标注成本,却不会改变结果。
- 占用率报告 → 掩码。框显示公交车覆盖了场景的 47%;实际覆盖率只有 29%。基于框的报告误差超过一半。