智能标注与批量标注
通过衡量审核工作量来选择标注模型和置信度阈值,然后运行批量标注,并用编辑率验证效果。
手动绘制框的速度可能只有每小时 100 张图像;审核质量良好的预标注,速度可能快好几倍。但如果标注模型的置信度阈值设置不当,它带来的工作量可能超过节省的工作量;如果不审核预标注就直接使用,模型会从自己的错误中学习,并影响你的下一个模型。本课会在真实的已标注数据上衡量各个阈值下的审核工作量,让你根据数据而不是猜测来选择阈值。
实践操作
三种预标注方式#
在标注编辑器中,Draw 模式(V)为手动模式,Smart 模式(S)则会让模型提出标签建议:
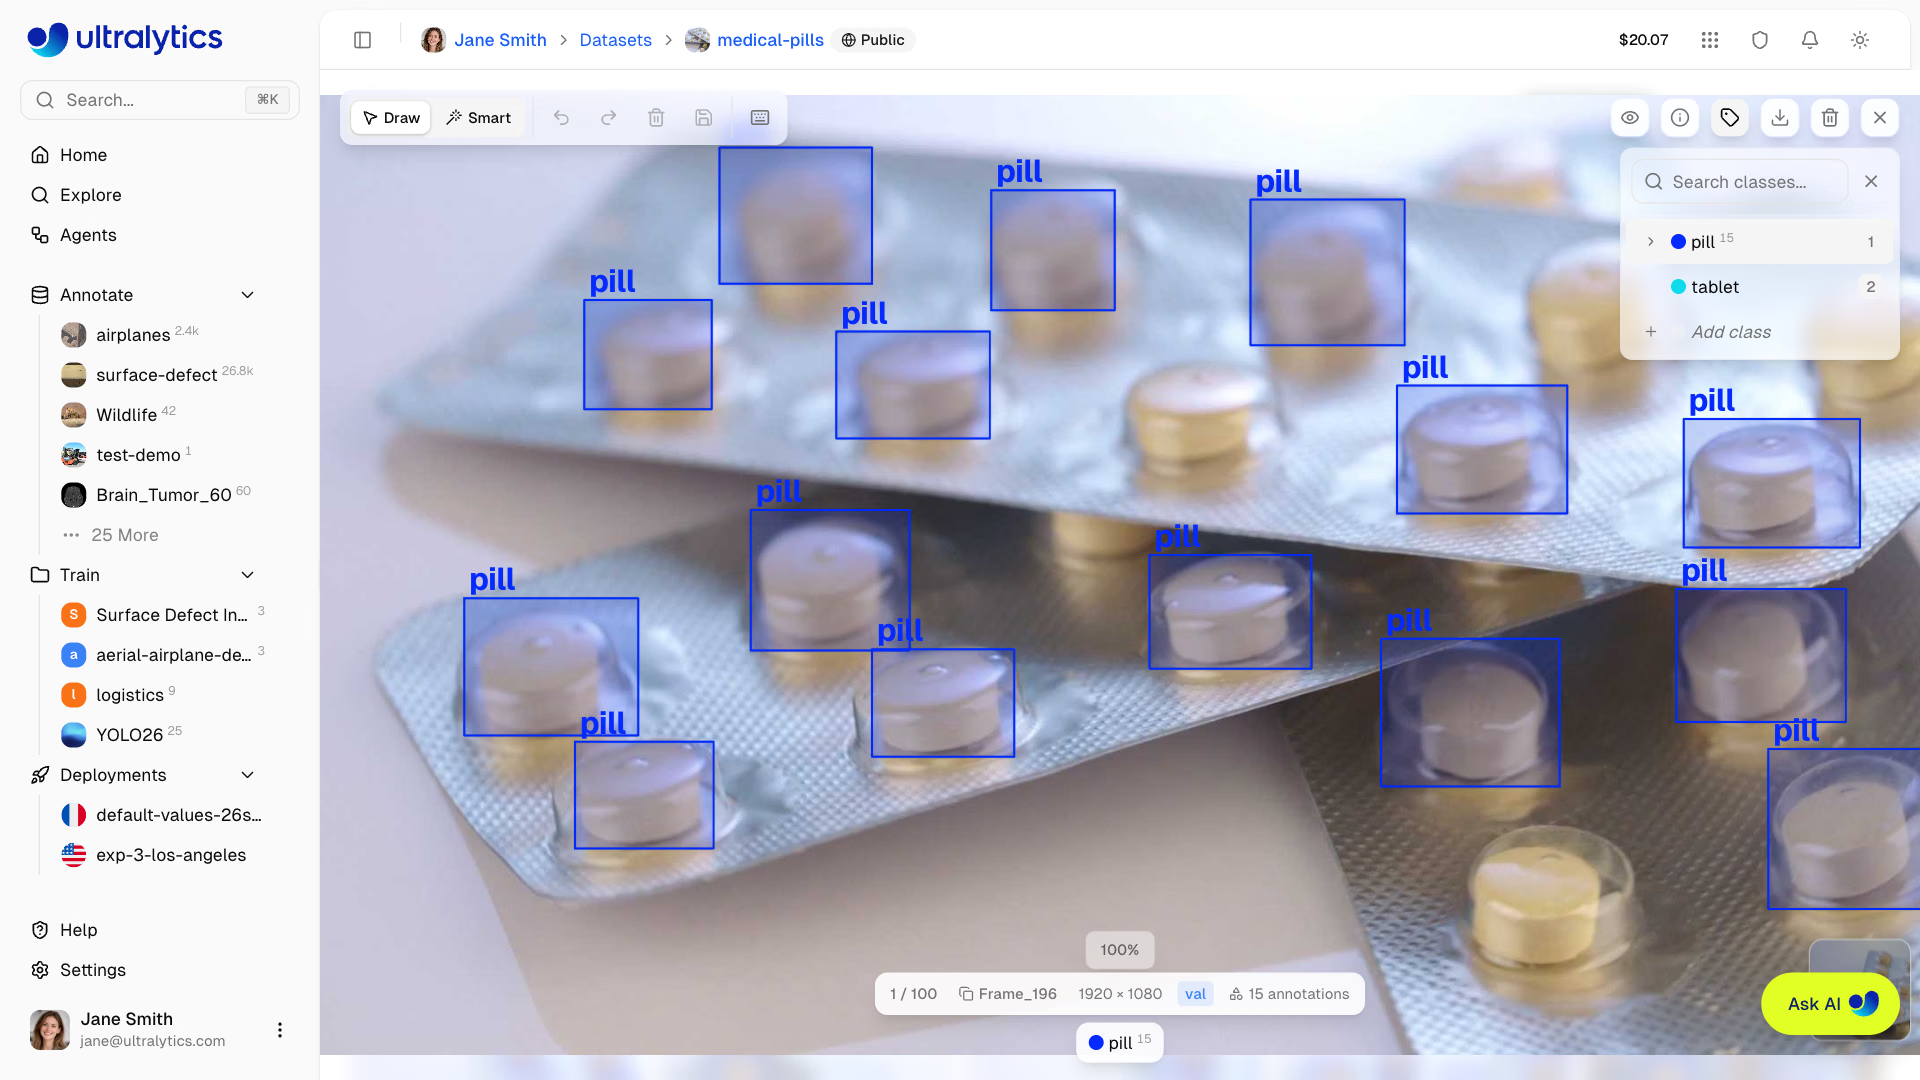
| 类别 | 工作原理 | 任务 | 费用 |
|---|---|---|---|
| SAM(SAM 2.1 Tiny 到 Large、SAM 3、默认使用 SAM 3.1) | 点击对象生成掩码;在对象外点击可添加,在对象内点击可减去;A 用于切换自动应用 | 检测、分割、语义、OBB | Free |
| YOLO(官方模型或你自己的模型) | Predict 会添加模型的检测结果;Map classes 用于对齐模型类别和数据集类别;IoU 达到 0.7 及以上的重复项会被跳过 | 检测、分割、语义、OBB、姿态 | 在编辑器中免费使用 |
| 类别提示(默认使用 Moondream 3.1、YOLOE-26x、SAM 3 Text 等) | 在图像中查找数据集的类别名称;付费提供商模型使用你自己的 API 密钥运行 | 包含 1–200 个类别的检测数据集 | 托管模型免费 |
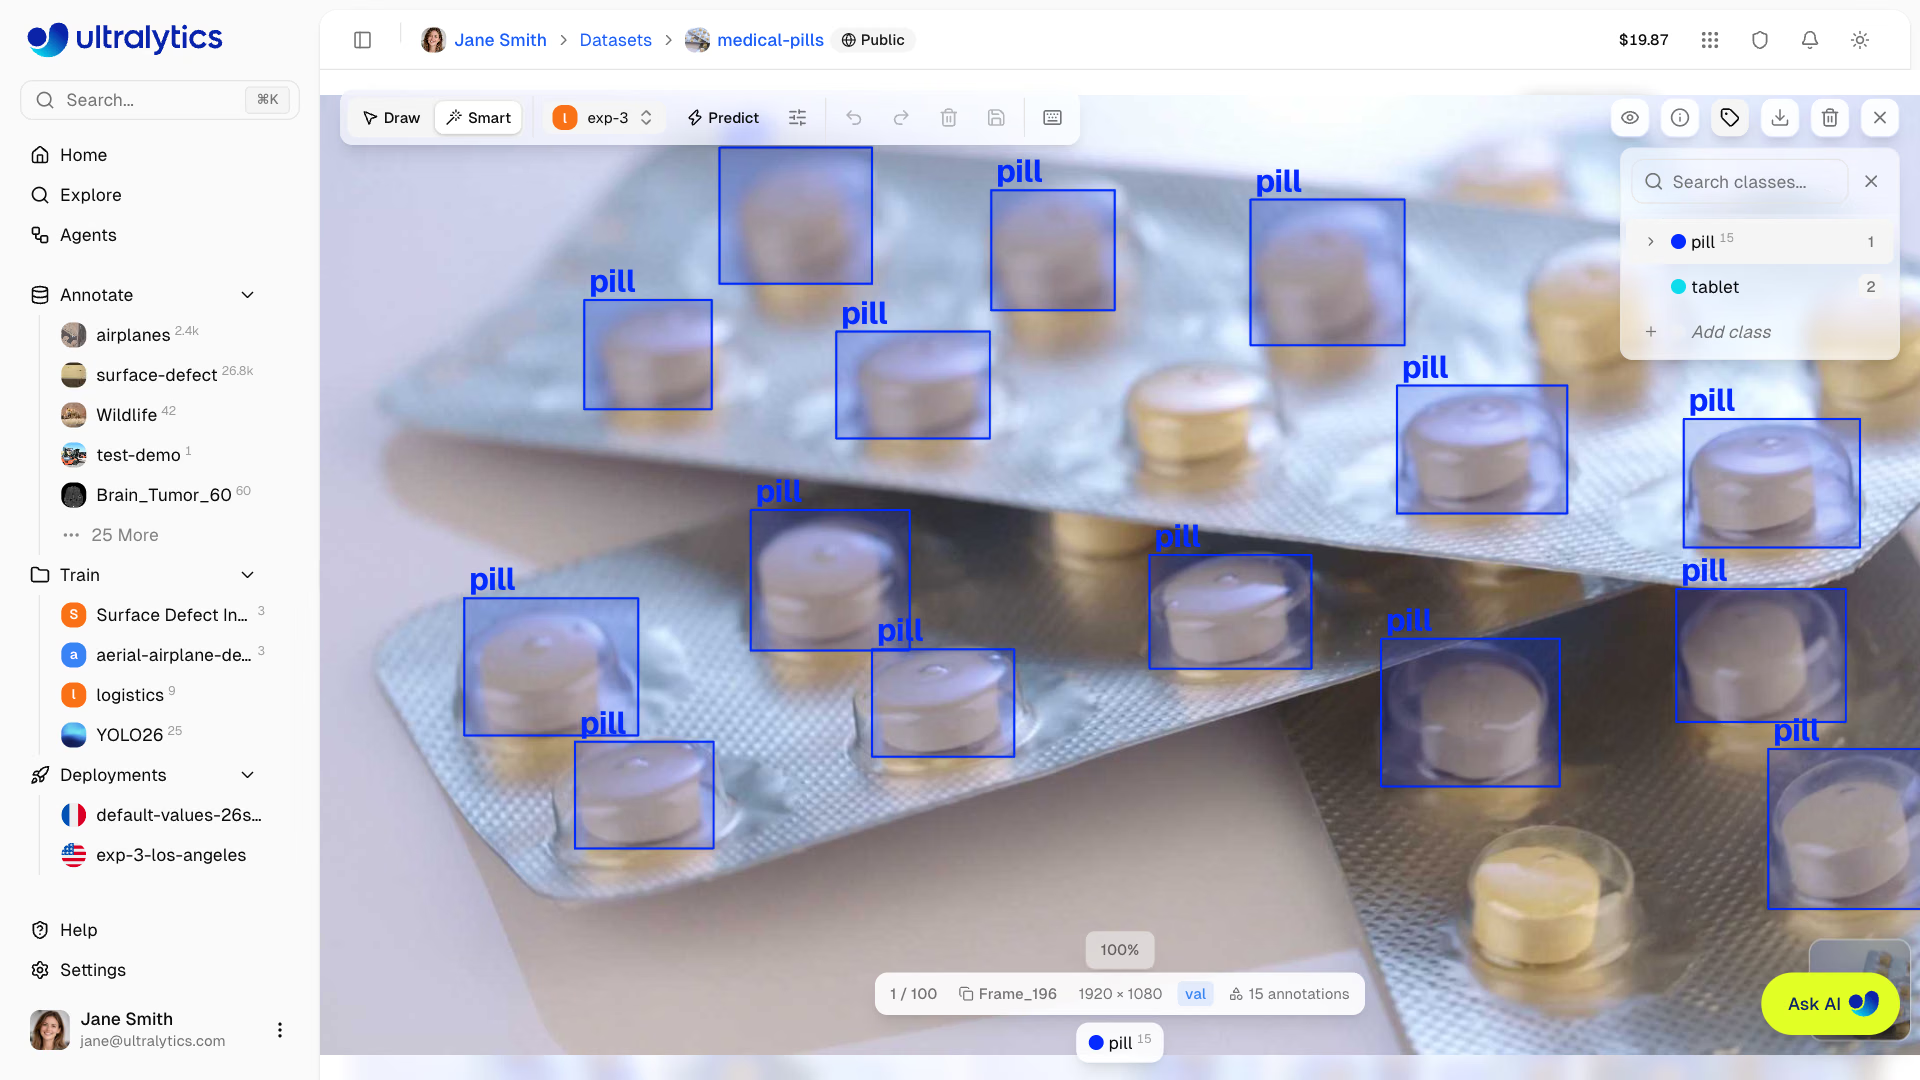
SAM 每个对象需要点击一次,并能提供最贴合对象的形状。模型预测每张图像只需点击一次,但效果取决于模型本身,因此本课余下内容将介绍如何选择和调整模型。
选择标注模型#
用 100–200 个手工标注样本训练的弱 v0,仍然胜过从头开始绘制;到 v1 时,它通常已能成为实用的主动学习伙伴。类别提示模型在不同领域的表现差异很大:有些模型几乎能在日常照片中找到所有对象,却会漏掉 PCB、X 射线或零售图像中的大多数对象,因此在信任模型前先检查十个预测结果。
示例:衡量各阈值下的审核工作量#
置信度阈值决定审核人员把时间花在哪里:阈值过低,他们就得删除错误框;阈值过高,他们就得补画模型漏掉的框。请在已有正确标签的图像上进行衡量,这里使用的是 COCO128 中的 128 张已标注图像,并使用预训练 YOLO26n 作为标注模型:
from pathlib import Path

import torch

from ultralytics import YOLO
from ultralytics.data.utils import check_det_dataset
from ultralytics.utils.metrics import box_iou
from ultralytics.utils.ops import xywhn2xyxy

data = check_det_dataset("coco128.yaml")  # 128 labeled images, downloaded on first use
images = sorted(Path(data["train"]).glob("*.jpg"))
results = YOLO("yolo26n.pt").predict(images, conf=0.05, verbose=False)  # your labeling model

def review_work(result, image, conf):
    """Return (kept, delete, draw): correct pre-labels, false positives to delete, missed objects to draw."""
    label = Path(str(image).replace("images", "labels")).with_suffix(".txt")
    lines = label.read_text().splitlines() if label.exists() else []  # no label file = background image
    gt = torch.tensor([[float(x) for x in line.split()] for line in lines]).reshape(-1, 5)
    h, w = result.orig_shape
    gt_boxes, gt_cls = xywhn2xyxy(gt[:, 1:], w=w, h=h), gt[:, 0]
    boxes = result.boxes[result.boxes.conf >= conf]
    iou = box_iou(boxes.xyxy, gt_boxes) * (boxes.cls[:, None] == gt_cls[None])  # IoU with same-class boxes only
    matched = set()
    for row in iou:  # greedily match each prediction to its best unmatched ground-truth box
        for j in row.argsort(descending=True).tolist():
            if row[j] >= 0.5 and j not in matched:
                matched.add(j)
                break
    return len(matched), len(boxes) - len(matched), len(gt) - len(matched)

print("conf  kept  delete  draw  edits/image")
for conf in (0.1, 0.25, 0.4, 0.5, 0.7):
    kept, delete, draw = (sum(t) for t in zip(*(review_work(r, i, conf) for r, i in zip(results, images))))
    print(f"{conf:<5} {kept:>4} {delete:>7} {draw:>5} {(delete + draw) / len(images):>12.1f}")
conf kept delete draw edits/image
0.1 590 490 339 6.5
0.25 468 138 461 4.7
0.4 386 58 543 4.7
0.5 328 35 601 5.0
0.7 230 6 699 5.5工作原理及结果说明:
- 模型先以较低的
conf=0.05进行一次预测;之后每个阈值都会筛选同一批预测,因此测试过程很快。 review_work会将每个预测与类别相同且 IoU 至少为 0.5 的真实标注框进行匹配。未匹配的预测是审核人员需要删除的框;未匹配的真实标注对象是审核人员需要绘制的对象。- 每张图像的编辑次数在 0.25–0.4 时最低(4.7 次)。低于这个范围,删除次数会激增;高于这个范围,漏检就会增多。
- 即使在最佳阈值下,审核人员每张图像仍需绘制约 3.6 个框,因为 nano 模型难以处理 COCO 中大量的小型对象。
决策规则:选择每张图像编辑次数最少的阈值。如果绘制在所有阈值下都占主导,说明标注模型对这些数据来说太弱,请改用更大的模型或微调模型。如果即使在 0.5 时删除仍占主导,说明模型会混淆外观相似的类别,请在继续标注前检查混淆矩阵。在你自己的项目中,用你的微调模型在 50–100 张已标注图像上进行阈值测试。
运行批量标注#
批量标注会在整个数据集上运行一个 YOLO 或类别提示模型。你可以从更多操作 > 批量标注打开此功能,或在编辑器中预测后点击提示消息上的全部标注:
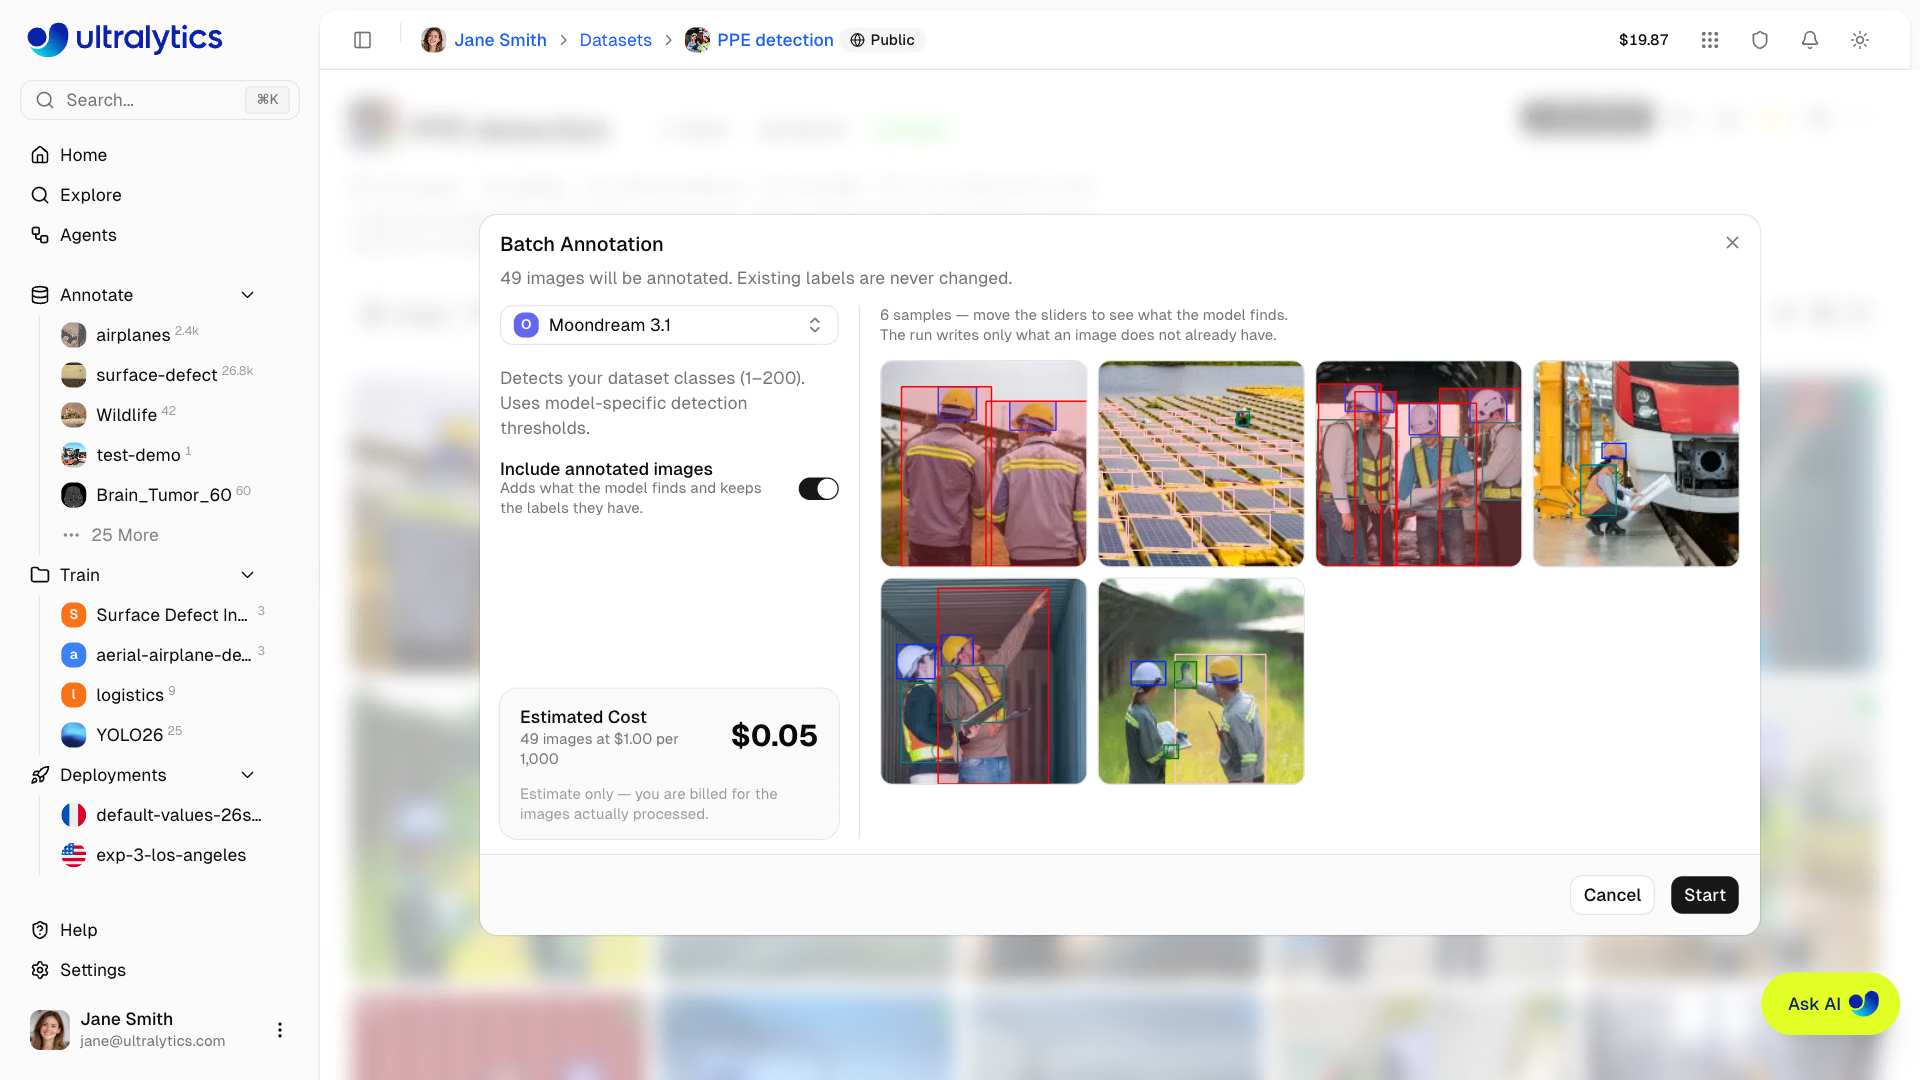
- 选择模型。检测数据集打开时默认选择 Moondream 3.1;你可以切换到自己的微调模型或 YOLO 模型。
- 对于 YOLO 模型,将置信度设为阈值测试选出的值(默认值为
0.25),并设置 IoU(0.7),然后检查示例预览。 - 关闭包含已标注图像,只为未标注图像添加标签。
- 检查预计费用(每 1,000 张图像 $1.00,最低 $0.01),然后点击开始。
开始运行前,系统会先保存一个数据集版本,因此你可以恢复运行前的状态。点击停止会保留已处理的图像,并按这些图像计费。
先审核,再衡量编辑率#
预测结果会作为普通标注保存,因此没有任何标记表明它们尚未审核。先按类别筛选,检查稀有类别;再按标注数量升序排序(可能存在漏检)和降序排序(框可能合并的密集场景)。然后创建一个版本,在“版本”选项卡中打开比较版本,并选择 v_auto 作为起始版本:
| 计数项 | 含义 |
|---|---|
| 新增 | 模型漏掉的对象,以及每个已修正框的修正副本 |
| 移除 | 误报,以及每个已修正框的原始框 |
| 编辑率 | (新增 + 移除)÷ v_auto 中的标注数量;这是一个上限,因为修正一个框会被计数两次 |
跟踪每个批次的编辑率。编辑率上升是一个早期警告,表示新图像与标注模型已知的内容出现偏差。标注最佳实践课程会介绍标注指南和审核人员之间的一致性。
常见问题#
症状:每次重新训练的得分都差不多,而且总是漏掉同一批目标。解决方法:未经审核的预标注会把标注模型的系统性错误当作事实写入数据集:相似类别被混淆、边界框边缘长期偏松,以及模型从未检测到的目标。每张图像在进入训练版本前都必须经过审核。
症状:批量标注已完成,大多数目标却仍没有标签。解决方法:先在编辑器中用十张有代表性的图像运行模型。如果它漏掉的目标不止少数几个,就手动标注一个种子集,并先训练 v0。
症状:预测框带有错误的类别名称。解决方法:当模型的类别与数据集的类别不同时,映射类别步骤会将每个模型类别映射到一个数据集类别,或跳过该类别。请谨慎映射;映射错误会导致该类别的所有框都被错误标注。
显示解答
示例:在药片检查微调任务中,阈值扫描选出 0.35。Batch Annotation 保存了包含 1,240 个标注的 v4。检查后,Compare versions v4 → v5 显示新增 96 个、移除 152 个,因此编辑率为 (96 + 152) ÷ 1,240 = 20%。移除数多于新增数,说明存在过度预测:检查移除的框后发现,模型把泡罩包装上的反光标成了药片。接下来采取两项措施:将置信度提高一个档位(0.35 → 0.45),用于下一批数据,并确认编辑率下降;再向下一个训练版本添加 30 张已检查的光面包装图像,让微调模型学会区分两者。