部署并调用端点
在 42 个区域中的一个创建专用端点,根据流量为端点选择合适的规格,并使用能够处理冷启动、429 错误和无效密钥的客户端调用端点。
可缩容至零的免费端点,处理第一个请求时可能需要最多一分钟;简单的客户端会因此导致面向用户的超时。即使删除泄露的密钥,该密钥仍然有效。本课将部署你的最佳模型、合理选择端点规格,并编写每个生产集成所需的小型客户端。
实践操作
共享推理还是专用端点#
每个模型都可以通过 Platform 的共享推理 API调用,适合用于测试。生产流量应使用专用端点:
| 共享推理 | 专用端点 | |
|---|---|---|
| 服务 | 由 Platform 用户共享 | 单模型、单租户 |
| 区域 | 你的数据所在区域(US、EU 或 AP) | 42 个区域中的任意一个 |
| 速率限制 | 每个密钥每分钟 20 个请求 | 直接调用不受 Platform 限制 |
| 请求大小 | 约 4.5 MB | 32 MB,每个请求最长 1 小时(支持视频) |
| 身份验证 | 任意工作区 API 密钥 | 仅限绑定到该部署的密钥 |
创建并配置端点大小#
打开模型的 Deploy 选项卡。浏览器会测量到全部 42 个区域的延迟(美洲 14 个、欧洲 13 个、亚太地区 12 个、中东和非洲 3 个),并按延迟对表格排序:
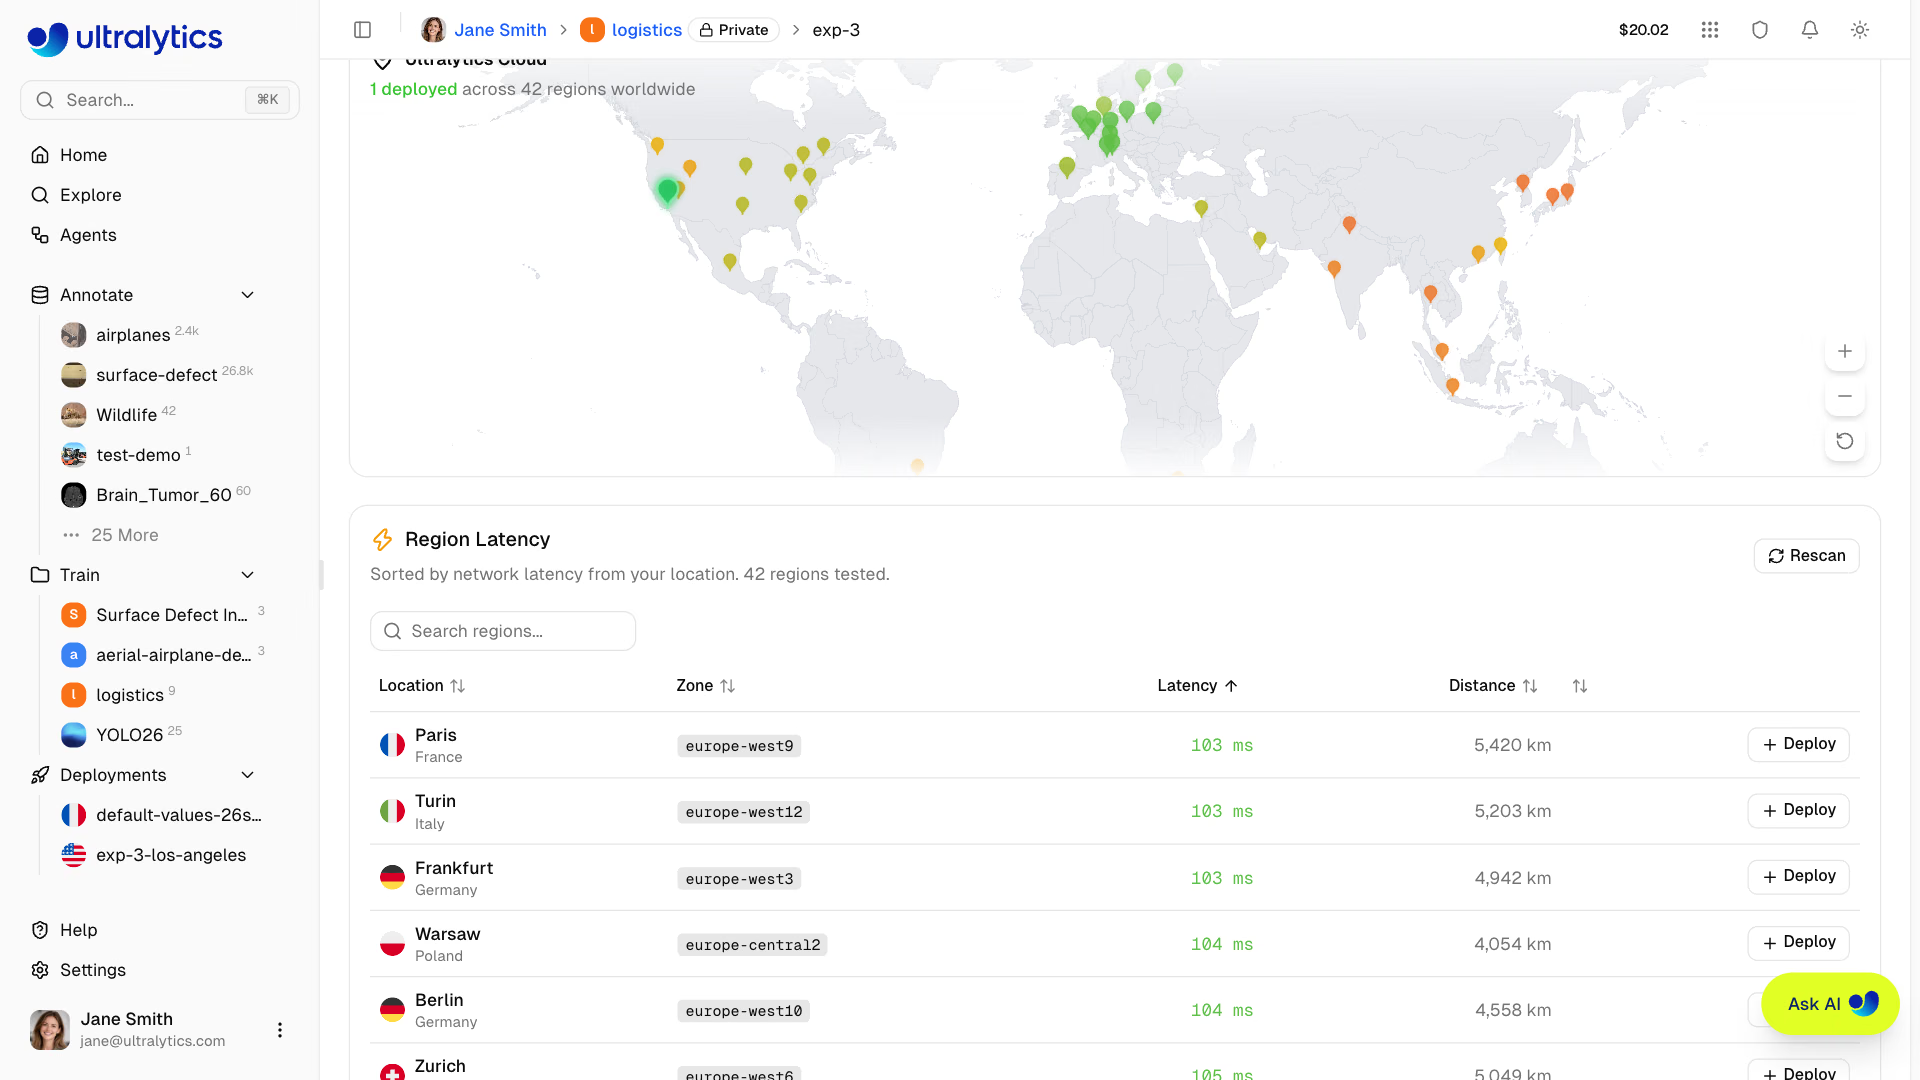
点击距离你的调用方最近的行中的 Deploy,检查 CPU、内存、价格和自动生成的名称(例如 yolo26n-iowa),然后点击 Create Deployment。你也可以从个人资料中 Deployments 选项卡里的 New Deployment 开始:
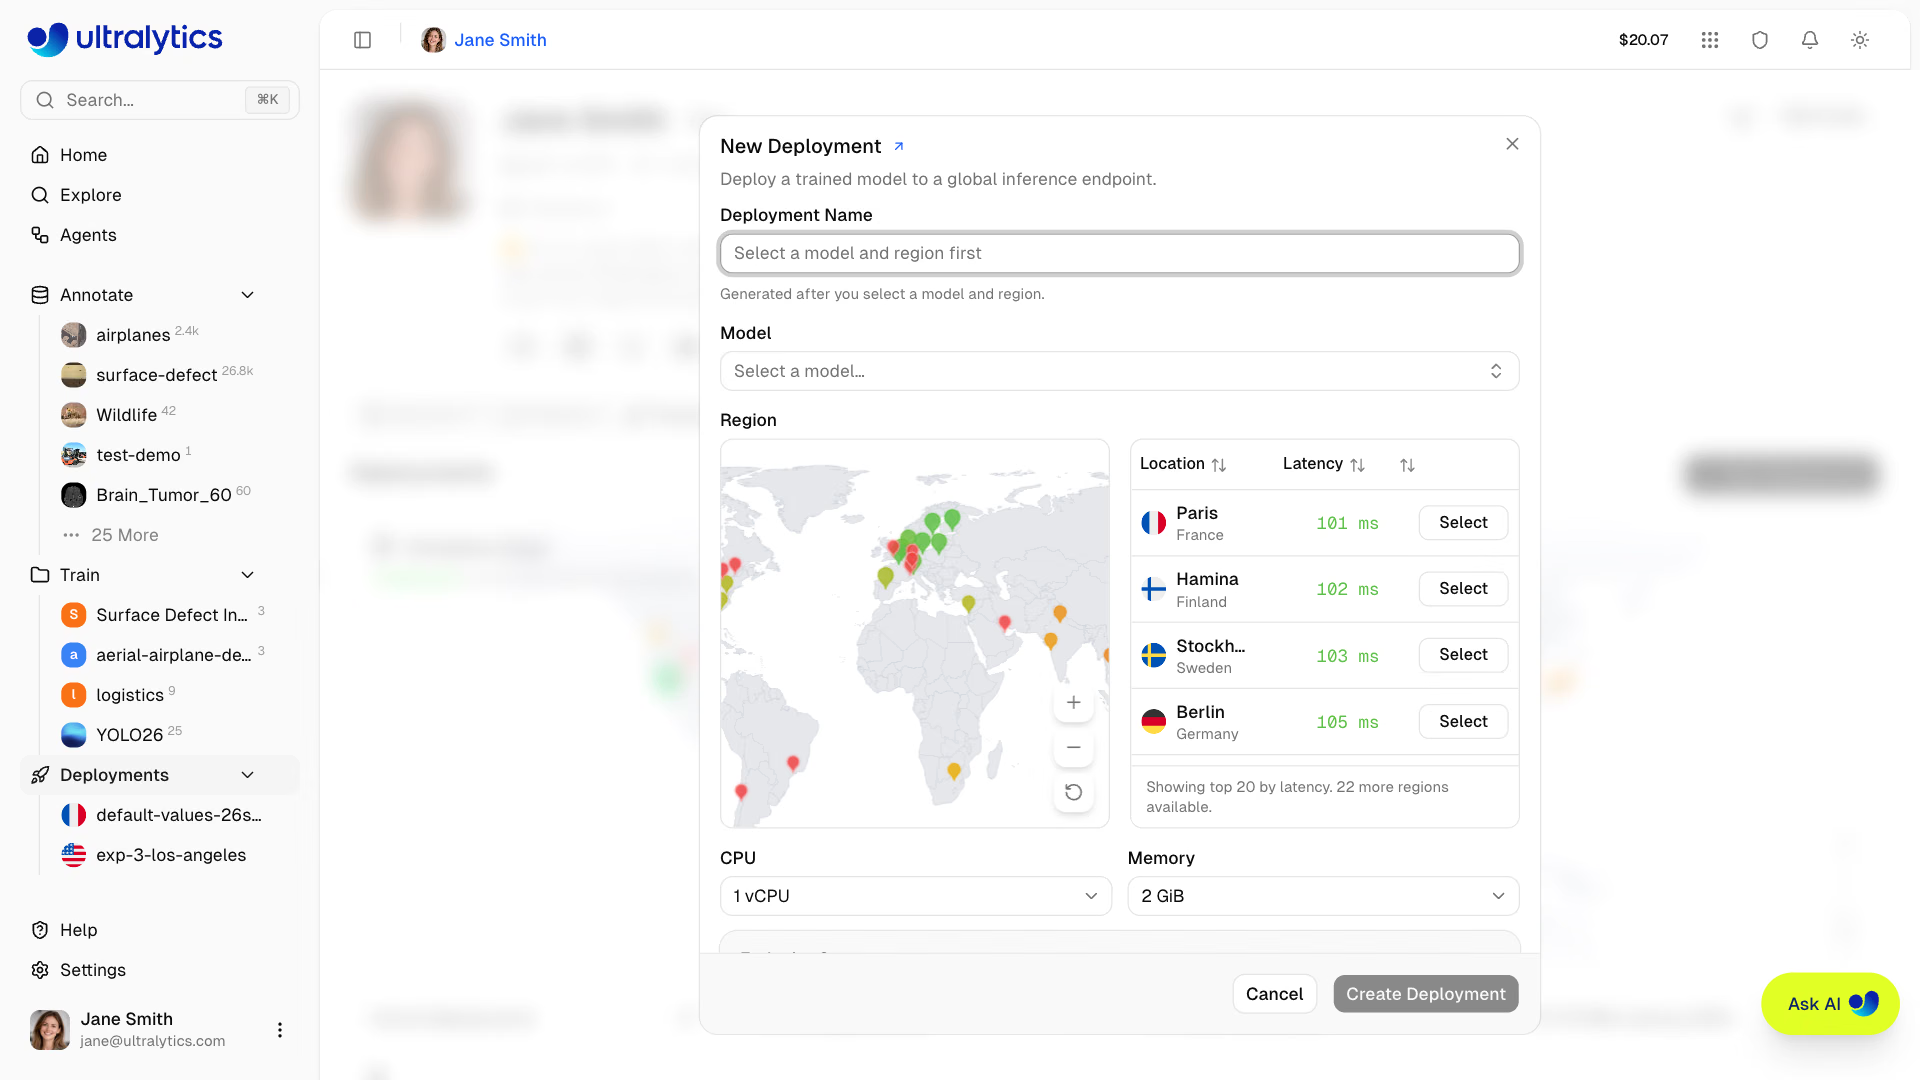
根据流量模式选择规格:
| 流量类型 | 规模 | 费用 |
|---|---|---|
| 批处理作业、内部工具、流量突增的演示 | 默认配置为 1 vCPU、2 GiB;可缩容至零 | 所有套餐均免费 |
| 无法等待冷启动的稳定实时流量 | 自定义规格(1–8 vCPU、2–32 GiB),保持一个实例处于预热状态 | 从就绪到停止按小时计费,包括空闲时间:在爱荷华州,1 vCPU、4 GiB 的费用约为 $0.12/h |
| 用户分布在多个大洲 | 每个区域部署一个端点,并置于你自己的路由器后 | 每个端点按其规格计费 |
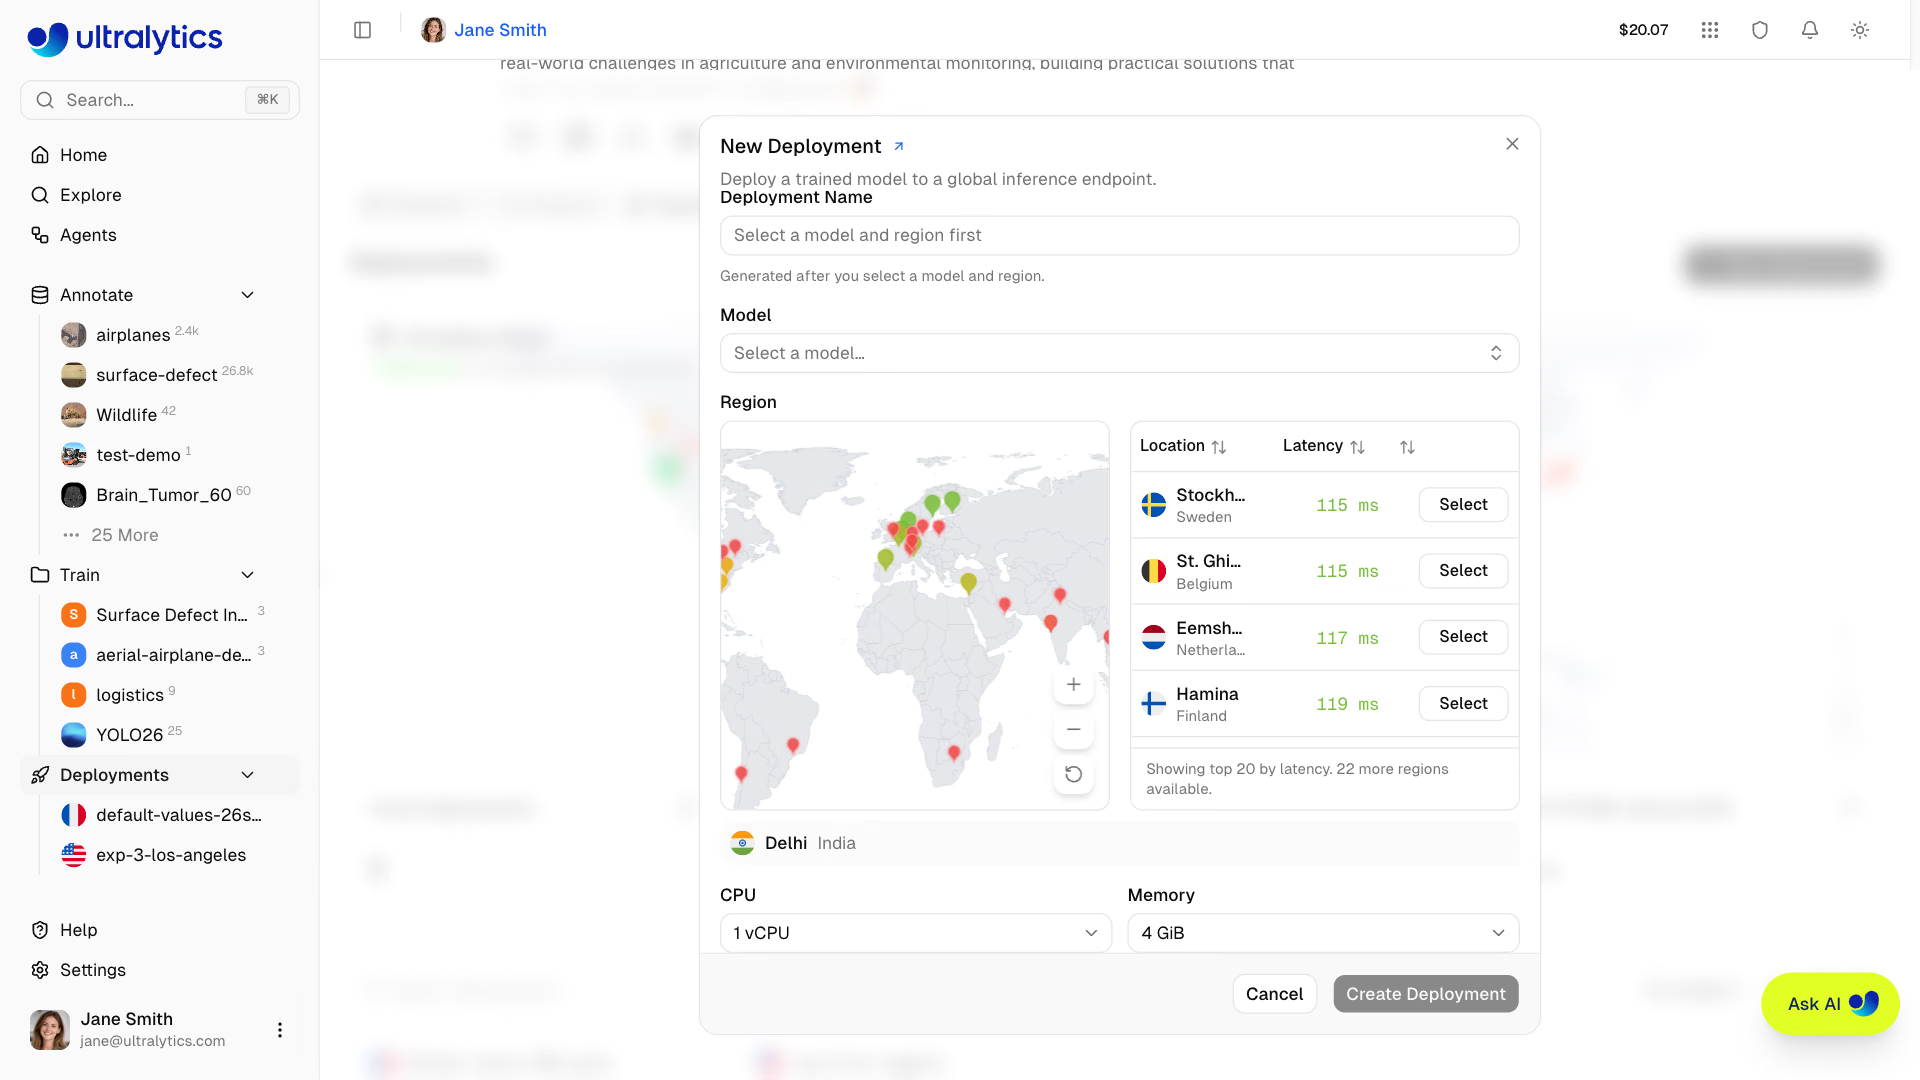
套餐允许部署 3 个(Free)、10 个(Pro)或不限数量(Enterprise),已停止的端点仍计入数量。端点徽标显示 Ready 后即可接收流量:
实战示例:经受住生产环境考验的客户端#
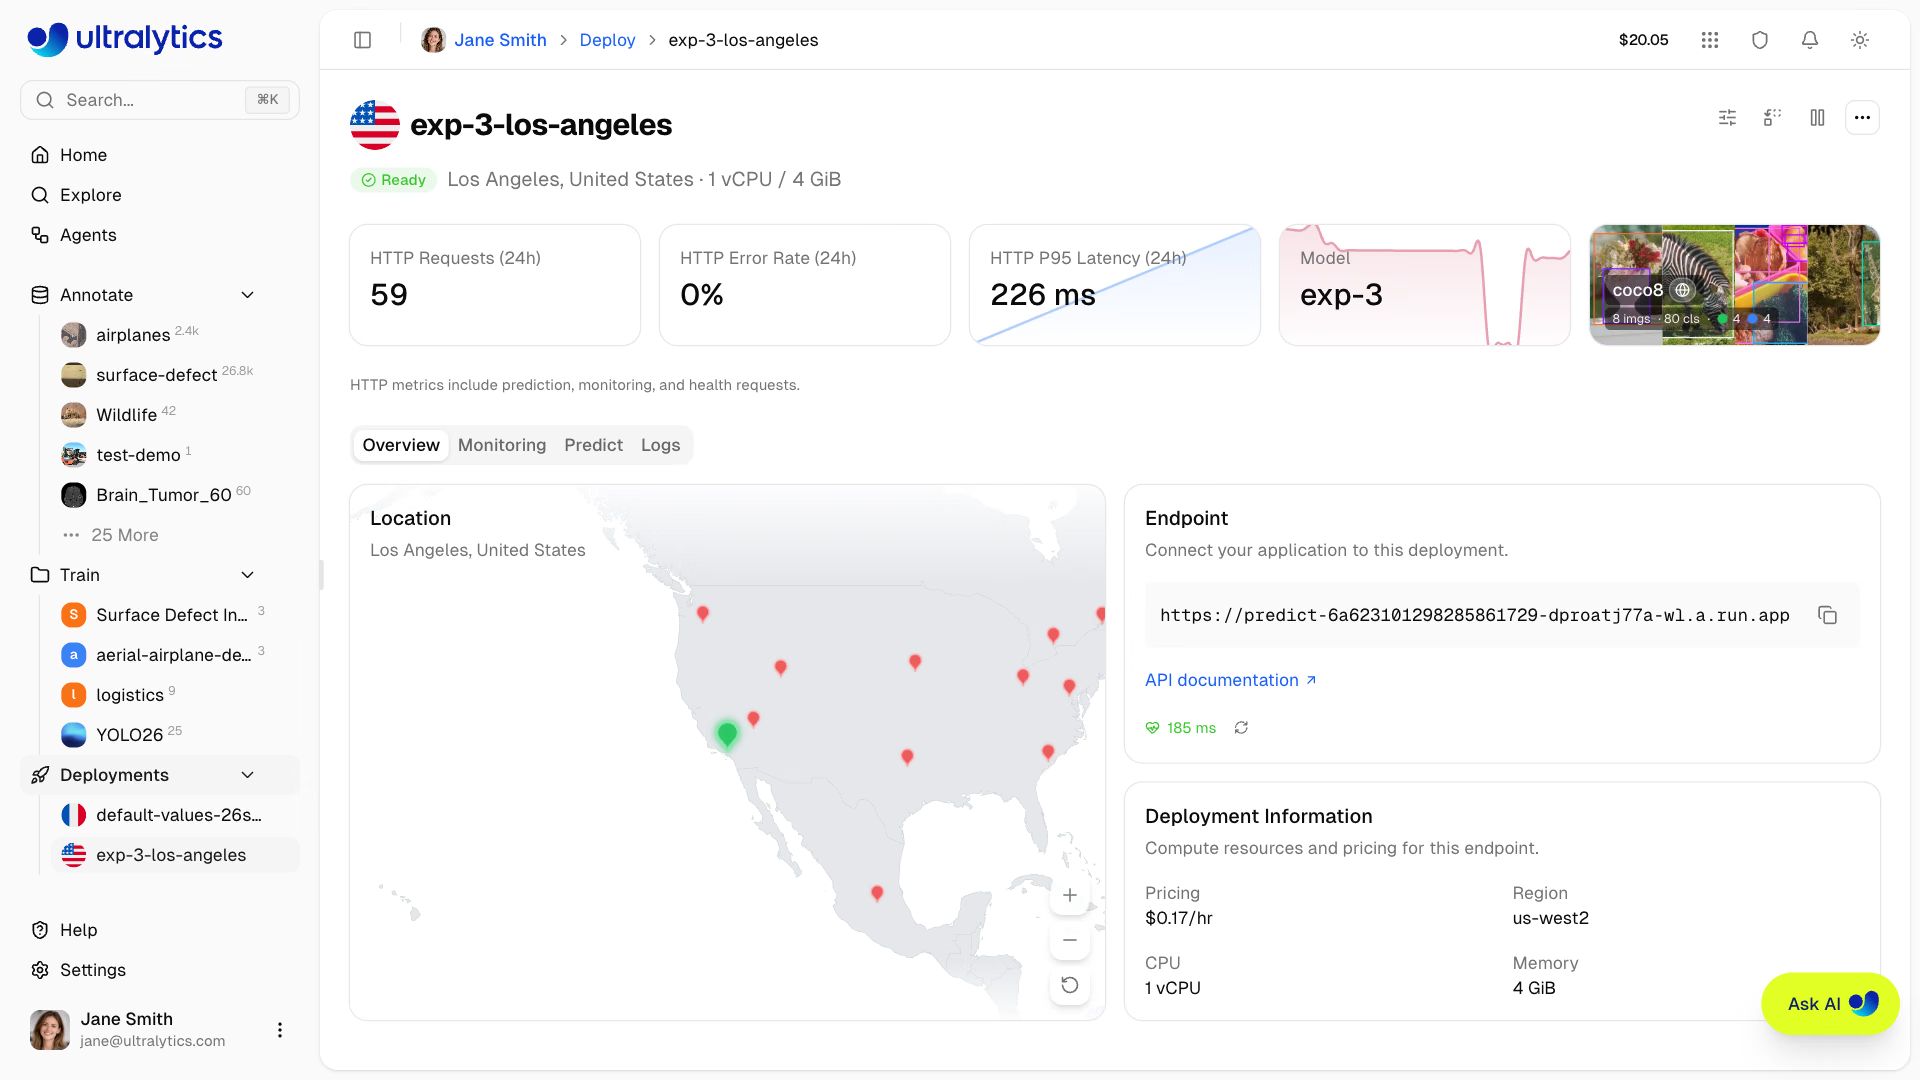
每个端点都有一个类似 https://predict-<id>-<hash>-<region>.a.run.app 的 URL,可提供 /predict(POST)、/health,以及交互式 /docs 页面。端点只接受创建时绑定的 API 密钥;工作区所有者会在部署的 Predict 选项卡 Docs 下看到预填的密钥,以及 Python、JavaScript 和 cURL 代码片段。这些代码片段只发送一次请求;生产代码还必须能应对冷启动和实例繁忙的情况:
import os
import time
from collections import Counter

import httpx

URL = "https://YOUR_DEPLOYMENT_URL.run.app/predict"
HEADERS = {"Authorization": f"Bearer {os.environ['ULTRALYTICS_API_KEY']}"}  # the deployment's bound key, server-side only

def predict(client, path, conf=0.25, attempts=4):
    """POST one image; retry timeouts, 429, and 5xx with backoff; fail fast on other errors."""
    for attempt in range(attempts):
        try:
            with open(path, "rb") as f:
                r = client.post(URL, headers=HEADERS, data={"conf": conf}, files={"file": f}, timeout=90)
            if r.status_code < 400:
                return r.json()
            if r.status_code != 429 and r.status_code < 500:
                r.raise_for_status()  # 401 wrong key, 413 too large: retrying won't help
            wait, reason = float(r.headers.get("Retry-After", 2**attempt)), r.status_code
        except httpx.TimeoutException:  # a scaled-to-zero endpoint can take up to a minute to wake
            wait, reason = 2**attempt, "timeout"
        print(f"attempt {attempt + 1}: {reason}, retrying in {wait:.0f} s")
        time.sleep(wait)
    raise RuntimeError(f"endpoint still unavailable after {attempts} attempts")

with httpx.Client() as client:
    response = predict(client, "bus.jpg")
for image in response["images"]:
    counts = Counter(d["name"] for d in image["results"])
    print(f"{sum(counts.values())} objects {dict(counts)} in {image['speed']['inference']:.1f} ms")
我们使用本地存根进行了测试:存根先对 429 作出一次响应,然后按照端点的响应格式,对 bus.jpg 返回真实的 YOLO26n 结果:
attempt 1: 429, retrying in 2 s
5 objects {'bus': 1, 'person': 4} in 34.9 ms
逐行来看,以下是关键决策:
timeout=90可应对最长约一分钟的冷启动;大多数 HTTP 客户端的默认超时时间要短得多。- 429 和 5xx 错误会重试;如果端点发送
Retry-After,重试时会遵循该值。每个端点由单个实例提供服务,实例繁忙时会通过429限流。 - 其他 4xx 错误会立即失败:
401表示密钥错误,413表示请求体超过 32 MB;这两种情况都不会自行恢复。 - 响应在
images中为每张图像(或每个视频帧)包含一个条目,每个条目都包含results(class、name、confidence、box,以及x1、y1、x2、y2)和以毫秒为单位的speed。
可选表单字段包括 conf(默认值为 0.25)、iou(0.7)、imgsz(模型的训练尺寸)、用于视频的 vid_stride,以及用于 0–1 坐标的 normalize=true。对应的 cURL 命令中,每个字段占一行:
curl -X POST "https://YOUR_DEPLOYMENT_URL.run.app/predict" \
  -H "Authorization: Bearer $ULTRALYTICS_API_KEY" \
  -F "file=@bus.jpg" -F "conf=0.25" -F "iou=0.7" -F "imgsz=640"
发布新版本,无需更改 URL#
部署页面上的 Replace model 会替换为同一工作区中另一个已完成的模型。新模型就绪前,旧模型会继续提供服务;URL、区域和密钥保持不变;如果发布失败,旧模型会继续运行。回滚的操作相同,只需选择之前的模型,因此请将它保留在项目中。Update configuration 会原地调整规格,而 Stop 会暂停计费并保留 URL。
某些更改需要新建端点:区域是固定的(迁移意味着删除后重新创建,并获得新 URL),且不支持自定义域名,因此如果调用方需要稳定的品牌主机名,请在前面接入你自己的网关。若要在 Platform 之外运行,请导出模型(导出以供部署)或在 Triton Inference Server 后自行托管。
常见问题#
症状:你的端点收到无法追溯来源的流量。解决方法:绝不要将密钥放在 Web 或移动应用中;应从后端调用端点。删除或停用绑定的密钥不会锁定端点,因为端点仍会接受该密钥字符串。要撤销访问权限,请停止或删除部署,然后创建一个绑定到新密钥的新部署。
症状:早上的第一个请求失败,重试后却成功。解决方法:默认尺寸的端点会缩容至零。请将超时时间设为至少 90 秒;在预期有流量前,先通过 /health 调用预热端点;或者,如果每个请求都必须快速响应,请切换到自定义尺寸。
症状:上传失败并出现 413。解决方法:专用端点接受的请求正文最大为 32 MB。请将长视频拆分成较短的片段,或发送抽帧后的图像,并传入 vid_stride 以跳过服务器端的帧。
显示解答
药片生产线摄像头的示例答案:将 v2-finetune 部署到 europe-west1(圣吉斯兰,这是从德国工厂测得的最低延迟区域),并使用默认规格。空闲一小时后的冷请求耗时 38 秒,90 秒超时可以应对;预热请求耗时 0.3 秒。决策:生产线 PLC 在班次期间每 30 秒发送一帧,因此端点会在整个班次保持预热,只有第一帧需要承担冷启动耗时。生产线控制器在每个班次开始前 2 分钟调用 /health,还能消除这次冷启动,因此继续使用免费的默认规格,相比自定义的 1 vCPU、4 GiB 实例每月可节省约 $90。将模型替换回 v1-baseline 后,同一 URL 会返回 v1 的结果;再替换为 v2 即可完成。