添加并准备数据
上传前在本地检查数据集,有计划地抽取视频帧,并确保平台数据集首次就能达到 Ready 状态。
最省钱的数据集问题,是在上传前就发现的问题。Pascal VOC 标签会被静默跳过,小于 28 像素的图像会被拒绝,而 30 分钟的视频最终只会变成 100 帧,其中大多数还是空场景。本课会介绍两分钟的上传前检查、有目的的视频抽帧,以及如何读取平台的处理状态信号,确保你的训练数据完整到位。
实践操作
创建数据集#
在侧边栏中打开 Annotate 并点击 New Dataset。对话框会要求你选择来源、名称、任务类型、可选许可证、人脸模糊处理选项和可见性:

| 来源 | 适用场景 | 计划 |
|---|---|---|
| 上传 | 文件位于你的电脑上:图像、视频、压缩包或 NDJSON 导出文件 | 全部 |
| URL | 存在公开的 .zip、.tar、.tar.gz、.tgz 或 .ndjson 链接;平台会在服务器端下载文件 | 全部 |
| 云端 | 数据已存储在 Google Cloud Storage、Amazon S3 或 Azure Blob Storage 中,并且应继续保留在那里 | Pro、Enterprise |
| 本地部署 | 像素数据绝不能离开你的设备 | Enterprise |
决策规则:本课程请上传一份副本。云端和本地部署数据集会将像素数据保留在平台之外,因此无法使用智能标注、聚类、克隆和版本快照功能。
任务类型决定会显示哪些工具和模型。平台支持 Ultralytics YOLO 的全部七种任务:
| 任务 | 标注方式 |
|---|---|
| 检测 | 矩形框,或使用 SAM 和 YOLO 智能标注 |
| 分割 | 多边形,或使用 SAM 和 YOLO 智能标注 |
| 语义分割 | 多边形,或使用 SAM 和 YOLO 智能标注;可直接导入 PNG 掩码 |
| 姿态估计 | 使用内置或自定义骨架标注关键点;使用 YOLO 姿态模型进行智能标注 |
| OBB | 定向框,或使用 SAM 和 YOLO 智能标注 |
| 分类 | 在侧边栏中选择类别 |
| 深度 | 不绘制:上传带有配对深度图的图像(仅支持上传或 URL) |
示例:上传前检查数据集#
Platform 接受 JPEG、PNG、WebP、BMP、TIFF、HEIC、AVIF、JP2、DNG 和 MPO 图像,文件大小不超过 50 MB,短边至少为 28 px;并可读取 YOLO、COCO、LabelMe、Ultralytics 或 Labelbox NDJSON,以及语义 PNG 掩码标签。系统会检测 Pascal VOC XML,但不会导入。本脚本会根据这些规则检查本地 YOLO 数据集,这里使用的是公开的医用药丸数据集:
from collections import Counter
from pathlib import Path

from PIL import Image

from ultralytics.data.utils import check_det_dataset

ACCEPTED = {".jpg", ".jpeg", ".png", ".webp", ".bmp", ".tif", ".tiff", ".heic", ".avif", ".jp2", ".dng", ".mpo"}
data = check_det_dataset("medical-pills.yaml")  # your local dataset YAML
root = Path(data["path"])

problems = Counter()
for split in ("train", "val", "test"):
    if not data.get(split):
        continue
    files = [p for p in Path(data[split]).rglob("*") if p.is_file()]
    images = [p for p in files if p.suffix.lower() in ACCEPTED]
    labeled = 0
    for img in images:
        label = Path(str(img).replace("images", "labels")).with_suffix(".txt")
        labeled += label.exists() and label.stat().st_size > 0
        if min(Image.open(img).size) < 28:
            problems["under 28 px (rejected)"] += 1
        if img.stat().st_size > 50 * 1024**2:
            problems["over 50 MB (rejected)"] += 1
    problems["unsupported files (skipped)"] += len(files) - len(images)
    print(f"{split:<5} {len(images):>4} images, {labeled:>4} labeled, {len(images) - labeled:>3} background")
problems["Pascal VOC .xml labels (not imported)"] += len(list(root.rglob("*.xml")))
print("classes:", data["names"])
print("problems:", {k: v for k, v in problems.items() if v} or "none")
train 92 images, 92 labeled, 0 background
val 23 images, 23 labeled, 0 background
classes: {0: 'pill'}
problems: none输出说明:
- 各数据集拆分的数量。
train/、val/和test/文件夹中的图像上传后会保留对应的数据集拆分,因此这些数量就是 Platform 上显示的数量。如果没有val这一行,Platform 就会为你随机划分验证集(见下方的注意事项)。 - 背景图像(没有标签文件)适量使用没有问题;它们能让模型学会“这里什么都没有”的样子。背景图像有数百张时,通常意味着标签导出失败。
problems: none表示每张图像都会被处理。这里显示的任何数量,都代表文件将进入Errors选项卡或根本不会上传成功。
将数据集文件夹及其 data.yaml 打包成 ZIP,然后把压缩包拖到图库中。Platform 会自动检测格式,只存储一次相同图像;如果上传内容与数据集中已有图像冲突,Platform 会询问你要跳过、同时保留还是替换。
示例:在 Platform 处理视频前先抽帧#
Platform 会以每秒 1 帧的频率抽取每段视频,最多保留 100 帧;对于超过 100 秒的片段,会增大抽帧间隔:
| 片段时长 | 保留帧数 | 间隔 |
|---|---|---|
| 60 秒 | 60 | 1 秒 |
| 100 秒 | 100 | 1 秒 |
| 30 分钟(30 fps 下共 54,000 帧) | 100 | 18 秒 |
这适合快速查看,却不适用于大多数真实项目:一段 30 分钟的轮班录像会变成 100 帧,而且大多是空荡荡的通道。请自行抽取长视频的帧,然后上传这些帧:
均匀抽帧只需 FFmpeg:
mkdir -p frames
ffmpeg -i source.mp4 -vf fps=1 frames/%06d.jpg
如需按事件抽帧,可以让预训练的 Ultralytics YOLO 模型只保留包含目标对象的帧:
from pathlib import Path

import cv2

from ultralytics import YOLO

model = YOLO("yolo26n.pt")  # or your latest fine-tune
out = Path("frames")
out.mkdir(exist_ok=True)

source = "https://github.com/ultralytics/assets/releases/download/v0.0.0/solutions_ci_demo.mp4"
seen = kept = 0
for i, result in enumerate(model.predict(source, stream=True, vid_stride=5, classes=[0], conf=0.5, verbose=False)):
    seen += 1
    if len(result.boxes):  # keep only frames where a person was detected
        cv2.imwrite(str(out / f"frame_{i:05d}.jpg"), result.orig_img)
        kept += 1
print(f"Kept {kept} of {seen} sampled frames")
Kept 12 of 12 sampled framesvid_stride=5 会每隔五帧查看一次,classes=[0] 会将检测范围限制为人,conf=0.5 会忽略置信度较低的预测。这个繁忙的演示片段中,每个抽取的帧都有人;而在大部分场景空荡荡的录像中,保留帧的比例会大幅下降,你的标注费用也会随之降低。逐步调高 vid_stride,直到相邻的保留帧不再看起来一模一样。
解读 Platform 的处理状态#
上传后,Platform 会验证并规范化数据(超过 4,096 px 的图像会调整尺寸)、生成缩略图、解析标签并计算统计信息。请检查以下三个位置:
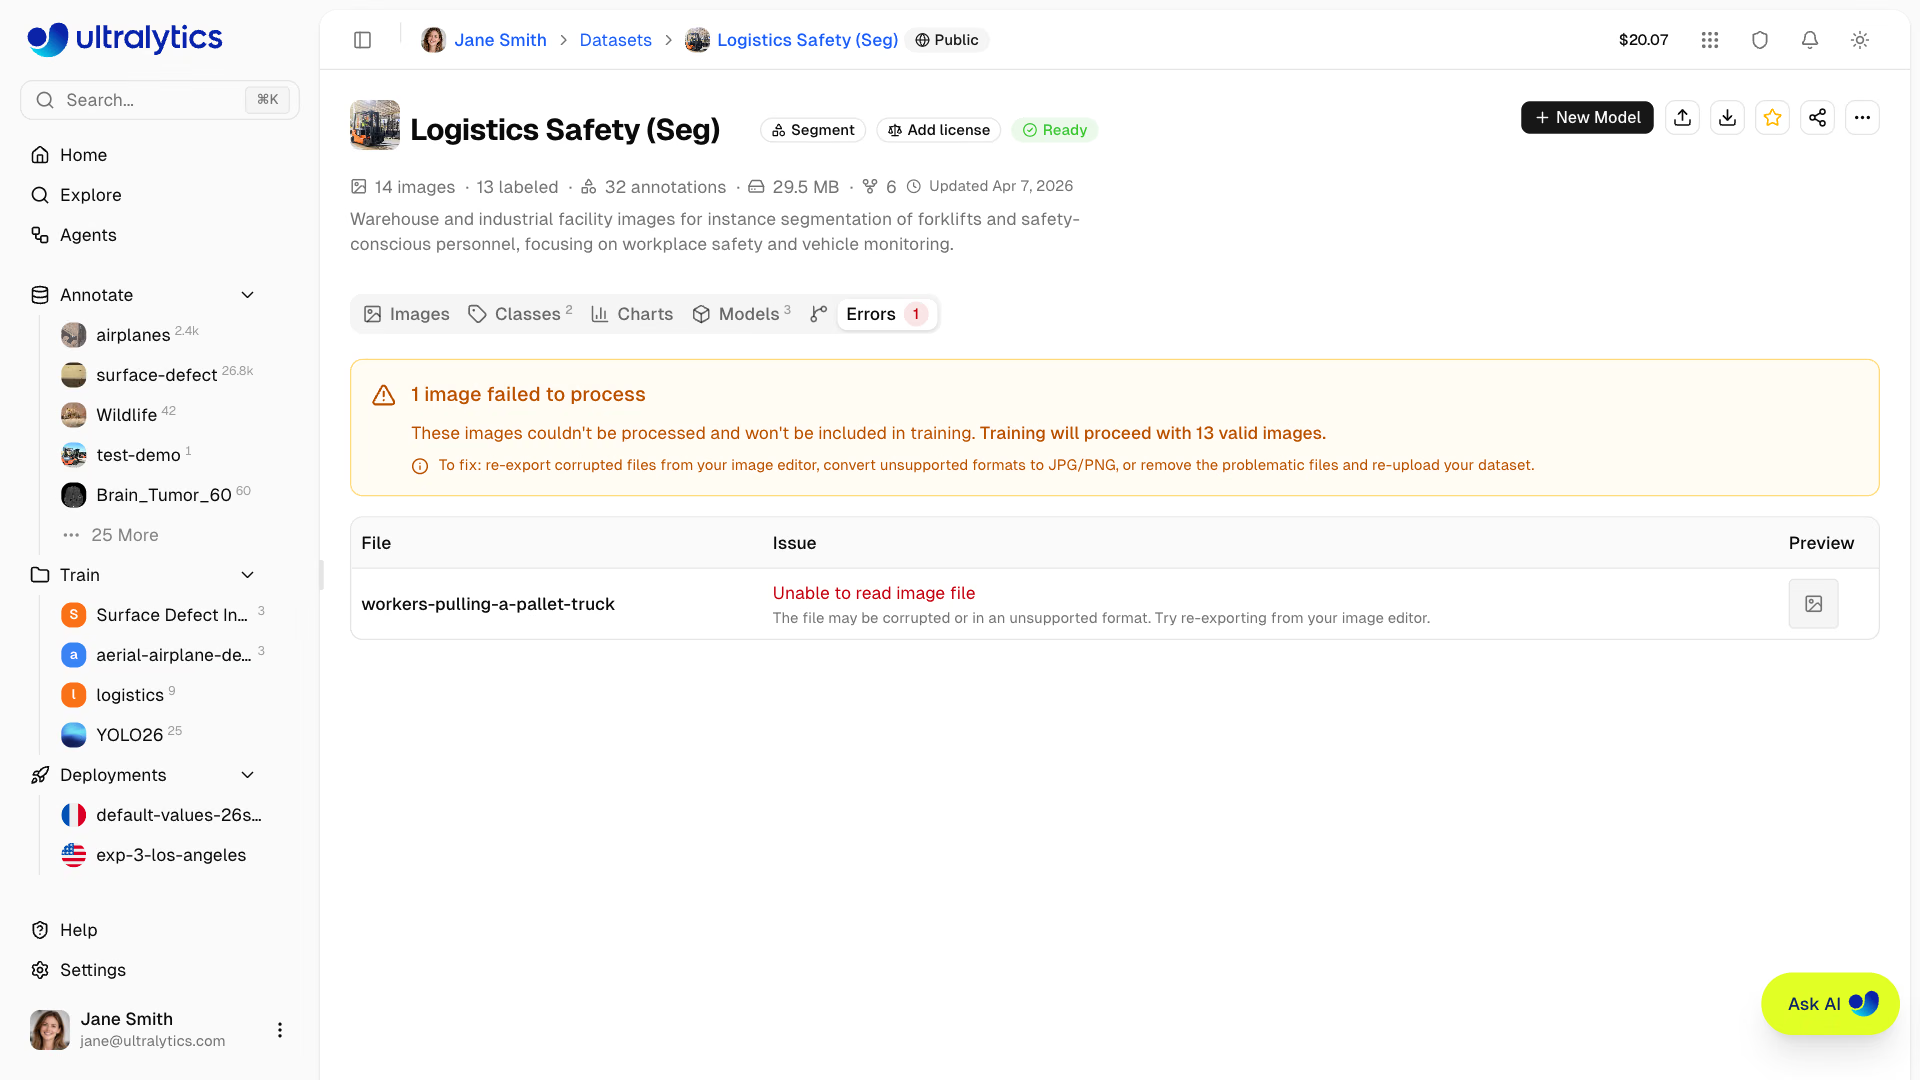
- 只有文件处理失败时才会出现
Errors选项卡:其中会列出损坏文件、不支持的格式、尺寸小于 28 px 的图像,以及 CMYK 和索引颜色模式的图像,并为每项提供修复提示。请重新导出或重新上传这些文件。 Charts选项卡会显示数据集拆分分布、主要类别、图像尺寸、文件大小、标注位置、框的尺寸以及每张图像中的对象数量。请留意出现频率极低的类别、尺寸过小的图像,或集中在某个角落的框。- 处理完成且数据集中至少有一张
train图像、一张val或test图像,以及一张带标签的图像后,数据集标题中的徽章会显示Ready。点击Not Ready查看缺少哪项条件。

从公开数据集开始#
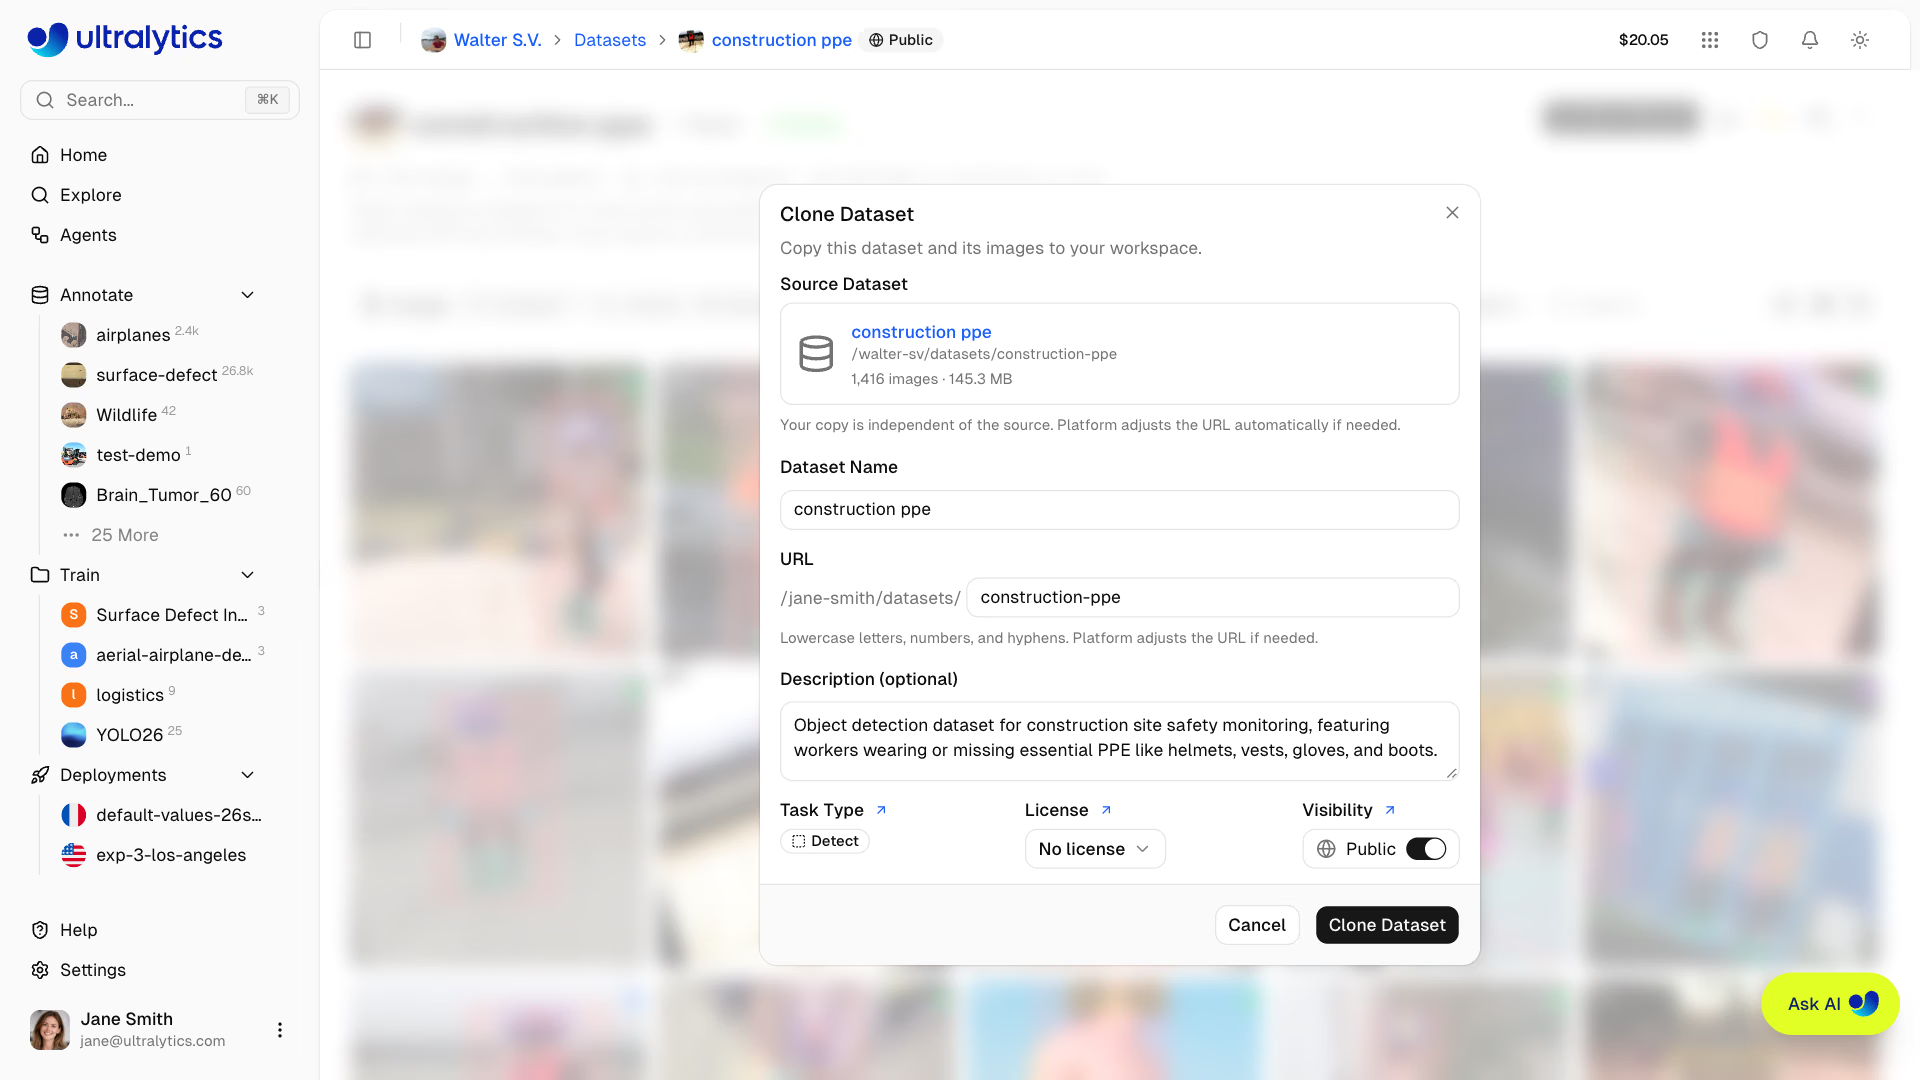
还没有数据?探索页面列出了官方和社区数据集。克隆数据集会将图像、标注和类别复制到你的工作区,占用你的存储空间,并默认保留源数据集的公开可见性;如果你要添加任何敏感内容,请在对话框中关闭可见性开关。
常见问题#
症状:上传成功,但所有图像都没有标签。解决方法:Platform 能检测到 Pascal VOC XML,但不会导入。请先转换为 YOLO .txt 标签或 COCO JSON;上传前检查会统计 .xml 文件,让你在上传前发现这个问题。
症状:验证 mAP 很高,部署后的模型表现却不佳。解决方法:如果上传时未选择划分方式,且 val 为空,Platform 会随机将约 20% 的训练图像移到 val。对于视频帧,这会让几乎相同的相邻帧分散到两个划分中。请上传到按视频或摄像头划分的 train/ 和 val/ 文件夹(课程 4)。
症状:你找不到多边形工具或关键点工具。解决方法:工具由任务类型决定。请在数据集页眉中更改任务类型;每张图像都会存储各任务的标签,因此切换任务只会隐藏其他任务的标签,不会删除它们。
显示解答
医用药丸数据集加一段 4 分钟线扫相机视频的示例答案。上传前检查:92 张训练图像和 23 张验证图像,均带标签,没有问题。视频:时长 240 秒,超过 100 秒,因此间隔增至 ceil(240 / 100) = 3 秒,Platform 会保留 80 帧(0 秒、3 秒、……、237 秒各一帧)。图库中的预期图像数量:92 + 23 + 80 = 195 张。视频帧会以无标签状态进入图库筛选器中选定的数据集拆分;因此,拖入视频前请选择训练集,以免这些帧进入验证集。训练集、验证集和带标签图像都存在,因此徽章显示 Ready。如果你只上传了视频,徽章会显示 Not Ready:目前还没有带标签的图像。