整理、去重与拆分
用两个简短脚本找出跨拆分重复项和类别缺口,按重要的单位拆分,并冻结经过审计的数据集版本。
验证分数是否可信,取决于数据拆分是否可靠。热门演示数据集 COCO128 按设计使用相同的 128 张图像作为训练集和验证集;如果你自己的数据也意外出现这种情况,模型看起来会“表现出色”,却会在下一台摄像机上失效。本课会在真实数据上执行两项审计:重复项检查和逐拆分类别审计,然后按摄像机拆分,并冻结通过两项审计的版本。
实践操作
示例:查找在不同拆分之间共享的图像#
Platform 会在每个拆分中保留一份图像副本,并在上传时询问如何处理冲突,但无法阻止同一张图像或同一场景同时进入训练集和验证集。请在上传前检查一次,在合并数据集后再检查一次:
import hashlib
from pathlib import Path

from ultralytics.data.utils import check_det_dataset

data = check_det_dataset("coco128.yaml")  # any local YOLO dataset YAML before you upload it

def hashes(split_dir):
    return {hashlib.md5(p.read_bytes()).hexdigest(): p.name for p in Path(split_dir).rglob("*.jpg")}

train, val = hashes(data["train"]), hashes(data["val"])
shared = train.keys() & val.keys()
print(f"train {len(train)} images, val {len(val)} images, identical in both: {len(shared)}")
print("examples:", sorted(val[h] for h in shared)[:3])
train 128 images, val 128 images, identical in both: 128
examples: ['000000000009.jpg', '000000000025.jpg', '000000000030.jpg']COCO128 的每张验证图像也都是训练图像。这对于烟雾测试数据集来说是有意为之,也正因如此,它的验证 mAP 无法说明模型的泛化能力。在你的数据中,只要数量不为零,就说明存在数据泄漏:训练前请移动或删除每组重复图像中的一份。
用 Clustering 捕获近似重复项#
哈希只能捕获字节完全相同的图像。连续视频帧、连拍照片和重新编码的副本只会有少数像素不同。打开图库工具栏中的散点图图标,然后点击 Analyze Dataset(仅限已上传的数据集,支持 20 到 200,000 张图像):
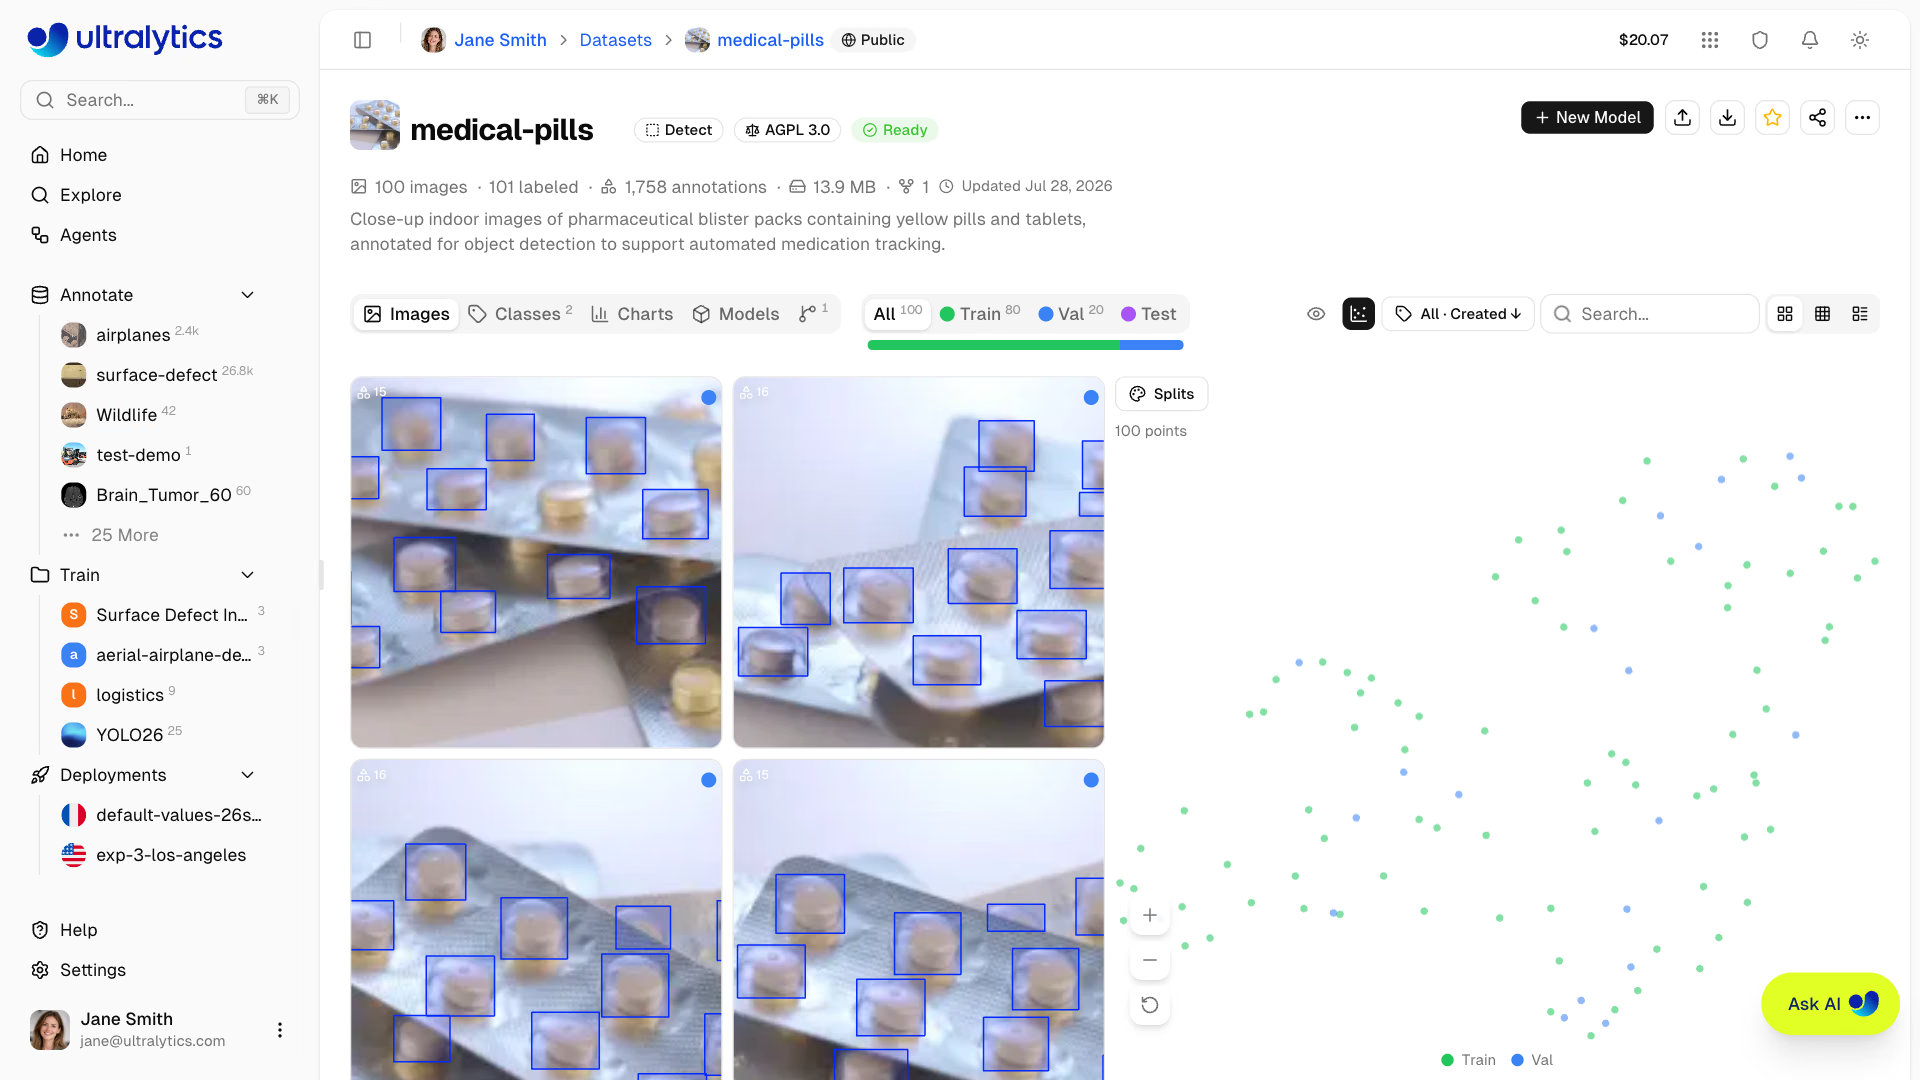
- 按拆分着色:紧密聚集且混有训练集和验证集点的区域,表示存在近似重复项导致的数据泄漏。
- 按聚类或类别着色:单一类别占据的大型区域,说明数据集中过度代表了什么;孤立点则是离群项(摄像机不匹配、帧损坏或图像标注错误)。
- 套索选择或点击某个区域,将图库筛选为这些图像(最多 1,000 张),然后删除、移动或重新标注。
相同的嵌入也支持图像上下文菜单中的 查找相似图像,可从公开数据集和团队数据集中将相似图像作为未标注图像添加到 train:这是补充下方审计所发现缺口的最快方式。
示例:按拆分审计类别#
从数据集标题栏或 Versions 选项卡下载 NDJSON 导出文件。标题行之后的每一行都对应一张图像及其拆分和标签,因此只需几行 Python 代码,就能统计每个拆分中的每个类别。下面的示例使用公开的 COCO8 导出文件运行:
import json
from collections import Counter, defaultdict

counts = defaultdict(Counter)  # split -> class name -> instances
images = Counter()
with open("coco8.ndjson") as f:  # the NDJSON export from the dataset header or Versions tab
    header = json.loads(f.readline())
    names = header["class_names"]
    for line in f:
        record = json.loads(line)
        images[record["split"]] += 1
        for box in (record.get("annotations") or {}).get("boxes", []):
            counts[record["split"]][names[str(box[0])]] += 1

print("images per split:", dict(images))
for name in sorted(set(counts["train"]) | set(counts["val"])):
    train, val = counts["train"][name], counts["val"][name]
    flag = "missing in train" if not train else "too few in val" if val < 10 else ""
    print(f"{name:<14} train {train:>3}  val {val:>3}  {flag}")
images per split: {'train': 4, 'val': 4}
bowl train 3 val 0 too few in val
broccoli train 1 val 0 too few in val
dog train 0 val 1 missing in train
elephant train 0 val 2 missing in train
giraffe train 2 val 0 too few in val
horse train 0 val 2 missing in train
orange train 4 val 0 too few in val
person train 0 val 10 missing in train
potted plant train 1 val 1 too few in val
umbrella train 0 val 1 missing in train
vase train 1 val 0 too few in val
zebra train 1 val 0 too few in val读取结果:标题行包含 class_names;每个检测框都是 [class, x, y, w, h]。训练集中缺失表示模型完全无法学习该类别,其验证 AP 将为零。验证集样本过少表示每次运行的 AP 都会大幅波动:如果验证集中只有 7 个托盘,漏掉一个托盘就会使托盘 AP 变化约 14 个百分点。COCO8 是包含 8 张图像的烟雾测试数据集,因此每个类别都会不达标;你的生产版本不应显示任何标记。请通过收集更多样本来弥补缺口,而不是调整参数。
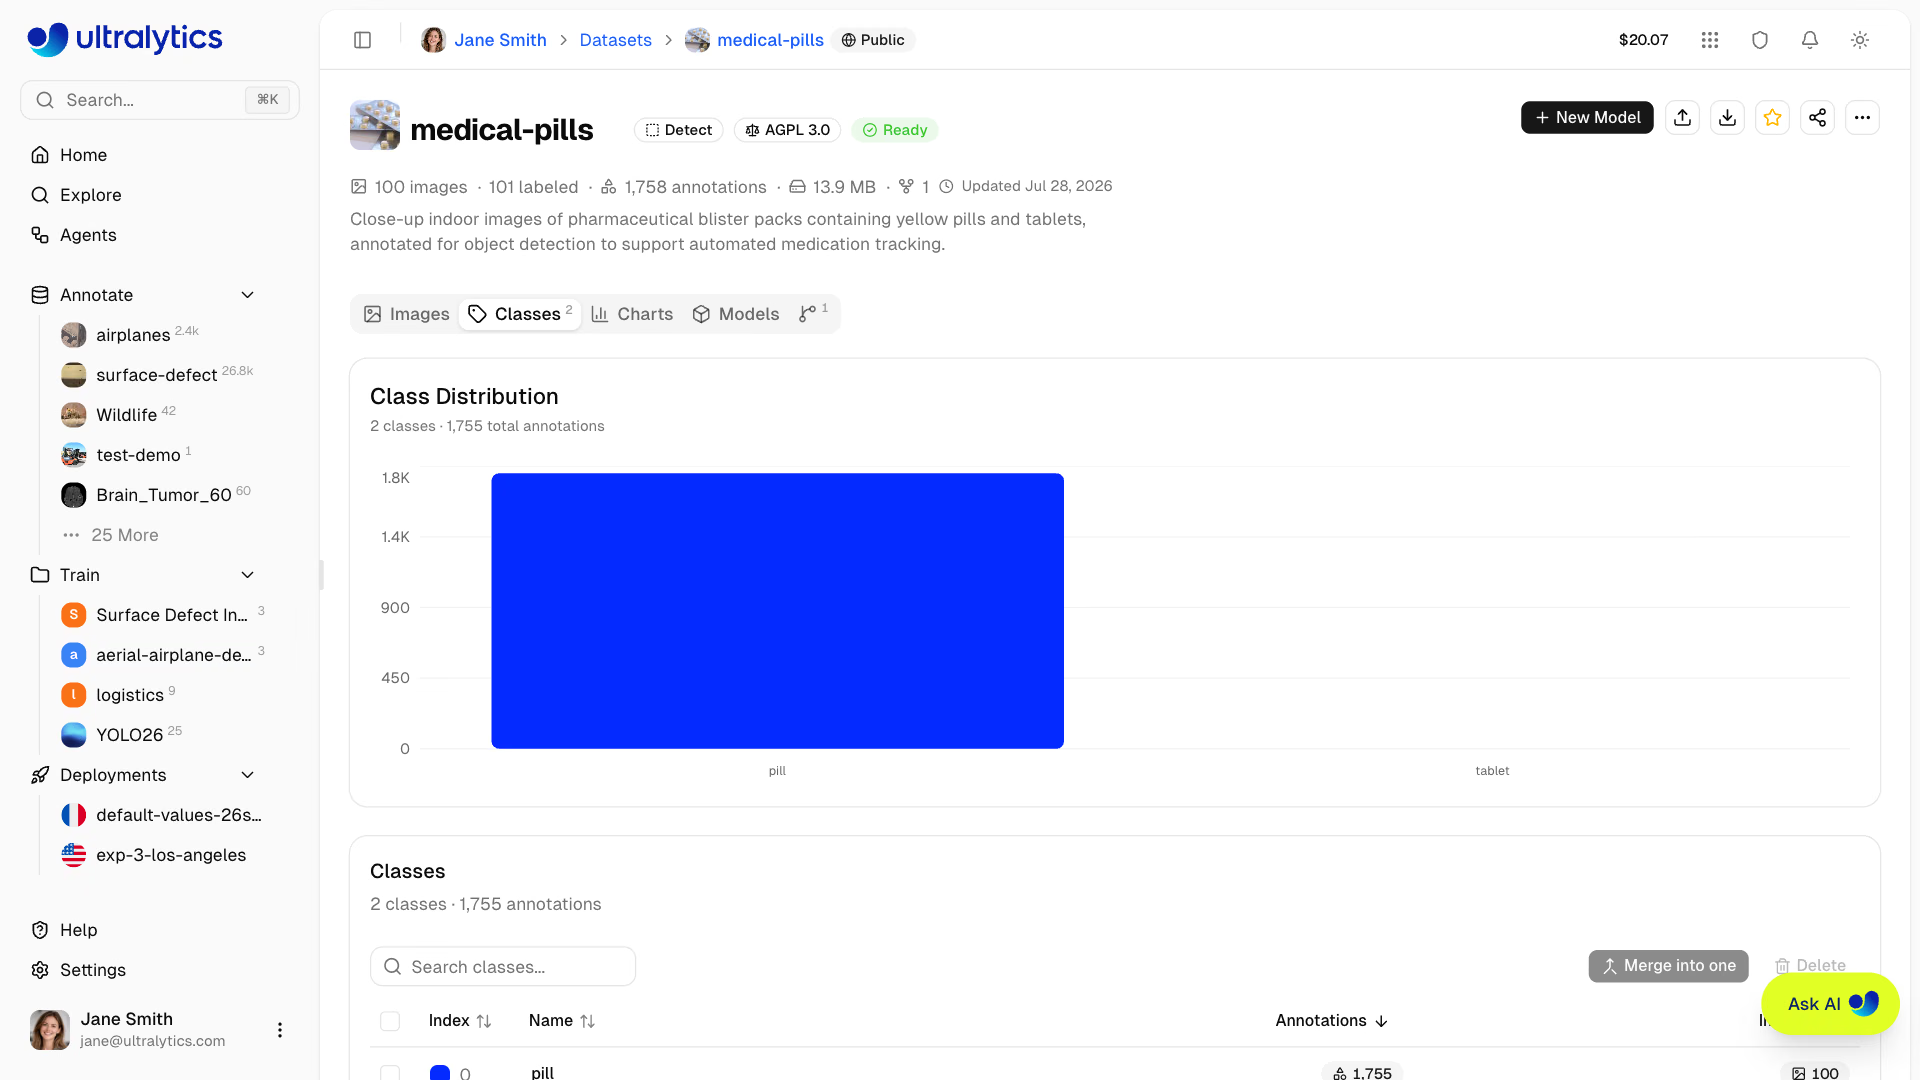
Classes 选项卡会显示实时数据集的相同统计信息,并提供用于不平衡数据的对数刻度开关。合并为一个会将 car、automobile 和 vehicle 等重复类别合并为一个类别,同时保留所有标注;删除则会移除一个类别及其所有标注。
按你希望模型泛化的单位拆分#
来自同一摄像机、采集会话或同一天的帧彼此相关。如果这些帧同时出现在训练集和验证集中,模型评估时面对的就是已经见过的场景。请留出生产环境中会发生变化的完整单位:如果是换摄像机,就留出整台摄像机;如果是同一摄像机但换了日期,就留出整天的数据。
Platform 的拆分工具恰好在这一点上有所不同:
| 工具 | 分配方式 | 用途 |
|---|---|---|
上传内容中的 train/、val/、test/ 文件夹 | 保留你的分配方式 | 离线准备的分组拆分 |
| 上传前设置拆分筛选条件 | 该次上传中的每个文件都会进入所选拆分 | 每个拆分上传一台摄像机的数据 |
| 表格视图中的 移动到拆分 | 移动所选图像 | 修正特定图像 |
| 拆分栏中的 重新分配拆分 | 随机重新分配所有图像 | 仅适用于相互独立的照片 |

正确拆分数据集课程介绍了如何选择拆分单位;对于非常小的数据集,k 折交叉验证可以提取更多有效信息。若要在上传后检查分组,请在类别审计中添加一个分组键(例如,为名为 cam07_000123.jpg 的文件使用 record["file"].split("_")[0],或者使用图像元数据中的 camera 字段),并报告出现在两个拆分中的所有分组。
冻结通过审计的版本#
训练需要一个固定快照。在 Versions 选项卡中输入说明(“v5:留出 cam07,+80 张托盘图像”),然后点击 New Version。每个版本都是不可变的编号 NDJSON 快照,你可以下载、比较或恢复;训练对话框中的 Save Dataset Version 会在启动时执行同样操作,并在数据未更改时复用匹配的版本。连接的云数据集或 On Premise 数据集不支持版本功能。
常见问题#
症状:点击 自动 80/20 后,验证 mAP 飙升,生产环境中的准确率却没有提升。解决方法:重新分配拆分会随机重新分配每张图像(并在此过程中移除完全重复的图像),导致相邻帧分别进入训练集和验证集。对于分组数据,请使用上传文件夹或 移至拆分。
症状:旧版导出结果或模型预测突然带有错误的类别名称。解决方法:类别 ID 按位置分配,因此合并或删除一个类别会使所有更高的索引下移。进行任何类别更改前先创建一个版本,并重新训练,而不是重复使用旧标签文件。
症状:新一轮运行的得分低了 5 分,其他一切都没变。解决方法:只有在相同拆分上,指标才具有可比性。更改拆分时,请在版本描述中注明,并在新版本上重新运行基线,然后再进行比较。
显示解答
8 台摄像机的叉车数据集示例答案。重复项检查发现训练集和验证集之间有 41 张完全相同的图像,全部来自一个重新上传的文件夹;请删除验证集中的副本。使用 group = record['file'].split('_')[0] 扩展审计后发现,cam02 同时出现在训练集和验证集中,因此请在表格视图中选中它在验证集中的图像,然后选择 移动到拆分 > 训练集。审计还标记了 pallet: train 63, val 7, too few in val:对两张托盘图像使用“查找相似图像”添加 40 张相似的未标注图像,为其添加标注,并将 15 张 cam07 托盘图像移入验证集,以保证 cam07 的数据完整保留在同一拆分中。重新运行检查:重复项为 0,泄漏分组为 0,验证集中的托盘图像为 22 张。按拆分着色的 Clustering 显示没有混合区域。保存 v5: cam07 val, cam08 test, +40 pallets。