正确划分数据集
衡量随机划分造成的数据泄漏;使用脚本按完整组(如视频片段、摄像头或日期)划分;检查类别覆盖情况,并锁定测试集。
粗心划分会产生一个你信以为真的指标,但它并不真实。如果相邻视频帧同时进入训练集和验证集,验证集 mAP 衡量的就是模型的记忆能力,而不是泛化能力;这个差距只有到了生产环境才会显现。你报告的每个模型指标都与这次划分有关,因此要谨慎地做一次选择,并保持划分不变。
实践操作
三种划分,各司其职#
| 划分 | 常见占比 | 用途 |
|---|---|---|
| 训练集 | 70% | 模型从中学习权重 |
| 验证集 | 15% | 选择最佳轮次、比较运行结果、调整设置 |
| 测试集 | 15% | 根据验收测试做一次最终的通过/不通过判定 |
Ultralytics 指南建议训练集占 70–80%,验证集和测试集各占 10–20%:计算机视觉项目的步骤建议两者各占 10–15%,而预处理指南采用 70/20/10。除了图像数量,还要统计对象数量,因为一张拥挤的图像所含标签可能比十张稀疏图像还多。具体百分比远没有每个划分的用途重要。
随机划分会导致相关数据泄漏#
同一视频片段中的第 124 帧和第 125 帧几乎一模一样。如果一帧进入训练集,另一帧进入验证集,那么模型实际上已经见过验证集中的图像,却还要在这些图像上接受评估。使用采集高质量、有代表性的数据中的练习数据集来衡量这一点,该数据集的文件名以摄像头-日期组键开头:
import random
from pathlib import Path

images = sorted(Path("datasets/practice/images").glob("*.jpg"))
random.Random(0).shuffle(images)
train, val = images[:90], images[90:109]  # a random per-image 70/15 split

def group(image):
    return image.stem.rsplit("_", 1)[0]

shared = {group(p) for p in train} & {group(p) for p in val}
print(f"{len(shared)} of {len({group(p) for p in val})} val groups also appear in train")
13 of 13 val groups also appear in train验证集中的每个摄像头-日期组合也都出现在训练集中。在真实视频中,这意味着验证帧与训练帧共享光照、背景,而且往往还有完全相同的对象,因此验证集 mAP 看起来很高,生产环境中的 mAP 却不然。
选择划分单位#
选择与你的部署所需泛化能力相匹配的组:
如果拿不准,就选择你能承受的最通用单位来划分:这样得到的指标最真实。只有当每张图像都是独立采集的(例如间隔数周拍摄的产品照片)时,按图像随机划分才安全。
用代码按组划分#
此脚本会将完整组分配到各个划分,直到每个划分达到 70/15/15 的占比;随后写出数据 YAML 可接受的文件列表,并报告类别覆盖情况:
import random
from collections import Counter, defaultdict
from pathlib import Path

root = Path("datasets/practice")  # contains images/ and labels/

def group(image):
    return image.stem.rsplit("_", 1)[0]  # "cam2_2026-05-01_000124" -> "cam2_2026-05-01"

groups = defaultdict(list)
for image in sorted((root / "images").glob("*.jpg")):
    groups[group(image)].append(image)

keys = sorted(groups)
random.Random(0).shuffle(keys)  # fixed seed: the same split on every run
total, assigned = sum(len(v) for v in groups.values()), 0
splits = {"train": [], "val": [], "test": []}
for key in keys:  # assign whole groups until each split reaches its 70/15/15 share
    share = assigned / total
    splits["train" if share < 0.70 else "val" if share < 0.85 else "test"] += groups[key]
    assigned += len(groups[key])

counts = {}
for split, images in splits.items():
    (root / f"{split}.txt").write_text("".join(f"./images/{p.name}\n" for p in images))
    labels = [root / "labels" / f"{p.stem}.txt" for p in images]
    counts[split] = Counter(int(r.split()[0]) for f in labels if f.exists() for r in f.read_text().splitlines() if r.strip())

all_classes = set().union(*counts.values())
for split, images in splits.items():
    missing = len(all_classes - set(counts[split]))
    print(f"{split:>5}: {len(images):3d} images, {len({group(p) for p in images}):2d} groups, {missing} of {len(all_classes)} classes missing")
train: 90 images, 11 groups, 5 of 71 classes missing
val: 20 images, 2 groups, 36 of 71 classes missing
test: 18 images, 3 groups, 41 of 71 classes missing如何解读:
- 按设计,不会有组跨越划分边界。这样就修复了数据泄漏。
- 验证集只有 2 个组,且缺少 36 个类别,因此无法测量这些类别的 AP。128 张图像中有 71 个类别,无论随机种子是什么都解决不了这个问题;真正的解决办法是增加组(更多摄像头或日期),这也是每个类别有 1,500 多张图像的生产数据集所具备的条件。
- 训练集缺少 5 个类别,这些类别只出现在验证集或测试集中。模型无法通过这个划分学会识别它们。
判定规则:如果某个划分缺少一个类别,就添加或移动包含该类别的完整组,绝不要移动单帧,否则会重新引入数据泄漏。将数据 YAML 的 train、val 和 test 键指向三个 .txt 文件;编写数据集 YAML介绍了文件的其余部分。
平衡各划分中的类别#
对于分类任务,scikit-learn 的 train_test_split(..., stratify=labels) 只需一个参数,就能让各划分中的类别比例保持一致。检测图像通常同时包含多个类别,因此要在组级别进行平衡:运行 group_split.py 后,比较各划分中每个类别的数量,并交换完整组,直到每个类别的数量都在预期占比的 ±20% 左右。

在 Ultralytics Platform 上,重新分配划分会随机重新分配图像,而 Auto 会设置建议的 80/20 训练集/验证集划分(划分文档)。此功能会在重新分配时移除完全重复的图像,但无法识别你的组,因此只适用于独立采集的图像;对于视频或多摄像头数据,请上传已按组划分的数据。
分别跟踪两个验证集#
你通常需要两个验证集:一个稳定、经过整理的回归测试集,以及一个随着新采集帧不断轮换、贴近生产实际的数据集。数据 YAML 可以接受验证文件夹列表,但会将它们合并为一个验证集,并只给出一个分数:
path: ./datasets/forklift
train: images/train
val:
  - images/val_curated      # stable, your regression suite
  - images/val_production   # rotates with newly collected frames
test: images/test
要查看各自的分数,请为每个验证集保留一个数据 YAML(使用相同的 train 和 names,但使用不同的 val),并分别用每个验证集评估训练好的权重:
from ultralytics import YOLO

model = YOLO("runs/detect/train/weights/best.pt")  # your fine-tuned checkpoint
for data in ("val_curated.yaml", "val_production.yaml"):
    metrics = model.val(data=data)
    print(f"{data:<20} mAP50-95={metrics.box.map:.3f}")
整理好的验证集分数下降,说明出现了回归;生产验证集分数下降,则说明发生了领域偏移。
锁定测试集#
代价最高的数据划分错误,是在测试集上比较十种模型变体。一旦测试集影响了任何决策,最终数值就会偏乐观。所有调参和运行结果比较都应在验证集上完成,最后只在测试集上运行一次验收测试。
你发布的每个指标都与这次数据划分绑定。之后重新打乱数据会改变所有数值,使新旧运行结果无法比较。请将划分单位、随机种子和三个文件列表与数据集一并保存。
小型数据集的 K 折交叉验证#
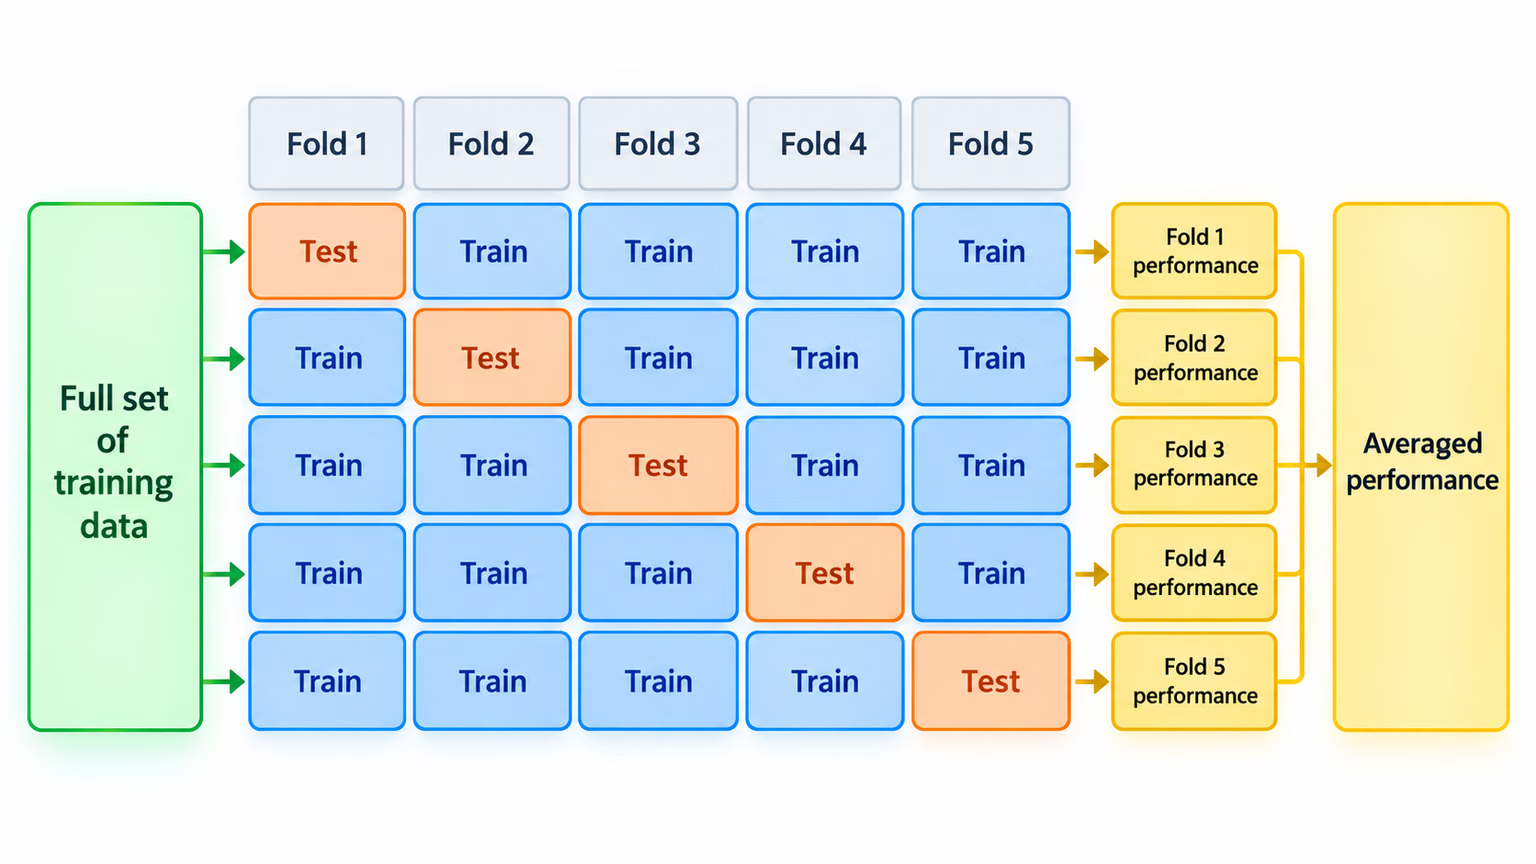
当数据集较小(每个类别约少于 500 张图像),且单次划分在统计上显得不够可靠时,K 折交叉验证会在轮换的划分上训练 k 个模型,并对结果取平均:计算量增加 k 倍,估计结果却稳定得多。与划分数据集时一样,应按组构建各折,否则每一折都会发生数据泄漏。
显示解答
对于必须在新日期持续正常工作的固定仓库摄像头,按摄像头-日期划分:cam2_2026-05-01。运行 group_split.py 后,确认没有组跨越划分边界:
from pathlib import Path

root = Path("datasets/practice")
groups = {s: {Path(p).stem.rsplit("_", 1)[0] for p in (root / f"{s}.txt").read_text().split()} for s in ("train", "val", "test")}
print("train & val: ", groups["train"] & groups["val"] or "none")
print("train & test:", groups["train"] & groups["test"] or "none")
print("val & test:  ", groups["val"] & groups["test"] or "none")
train & val: none
train & test: none
val & test: none练习划分通过了泄漏检查,但没有通过覆盖检查:验证集缺少 71 个类别中的 36 个。解决办法是制定采集计划,而不是重新洗牌。至少再采集两个摄像头-日期组合的数据用于验证集和测试集,每组数据都要涵盖规范最关注的类别,然后重新运行两个脚本。