判断数据集是否已准备就绪
通过八项通过/未通过检查来决定是否启动首次训练,自动化其中脚本可以验证的三项,并了解每项检查失败时该如何修复。
每个项目都会迎来团队想要开始训练的时刻。有时数据集已准备就绪;有时它仍存在划分泄漏或标注不足的类别,白白耗费一周 GPU 时间,得到一个不值得信任的指标。对每项检查给出“是”“否”或“有记录的例外”这三种结果,共八项检查,可以让决策客观,而不是凭感觉做决定。
实践操作
八项检查#
| # | 检查项 | 通过标准 | 未通过时,返回 |
|---|---|---|---|
| 1 | 明确的目标 | 目标、任务、类别和验收测试均已记录并达成一致 | 从业务目标开始 |
| 2 | 已定义的类别 | 每个类别都有定义,并明确指出一个不属于该类别的相似对象 | 目标和标注指南 |
| 3 | 有代表性的图像 | 每种规格场景都达到配额,且图像主要来自实际生产场景 | 收集高质量、有代表性的数据 |
| 4 | 足够的数据量 | 每个类别 ≥ 1,500 张图像且 ≥ 10,000 个实例,或有记录的例外 | 规格和数据收集 |
| 5 | 一致的标注 | 已编写指南、完成校准轮次,标注一致率 ≥ 90% | 标注最佳实践 |
| 6 | 已完成质量控制 | 审计脚本无异常、可疑项已复核、质量控制记录已完成 | 数据集质量控制 |
| 7 | 干净的数据划分 | 按组划分、每个组只出现在一个划分中、每个划分都包含所有类别 | 正确划分数据集 |
| 8 | 背景图像 | 0–10% 的图像是标注为空的画面 | 规格和数据收集 |
这份清单逐项检查了数据收集和标注指南中涵盖的同一组决策;在这里,这些决策汇总为一个是否启动训练的判断。
自动化可计数的检查#
第 4、7 和 8 项检查都是算术问题,因此脚本每次都能以相同方式评分。以下脚本读取练习集和上一课中由 group_split.py 写出的划分列表:
from collections import Counter
from pathlib import Path

root = Path("datasets/practice")  # images/, labels/, and the train/val/test.txt lists from group_split.py
splits = {s: [Path(p).stem for p in (root / f"{s}.txt").read_text().split()] for s in ("train", "val", "test")}

def classes(stem):
    label = root / "labels" / f"{stem}.txt"
    return [int(r.split()[0]) for r in label.read_text().splitlines() if r.strip()] if label.exists() else []

stems = [s for split in splits.values() for s in split]
instances = Counter(c for s in stems for c in classes(s))
images = Counter(c for s in stems for c in set(classes(s)))
background = sum(not classes(s) for s in stems) / len(stems)
groups = {split: {s.rsplit("_", 1)[0] for s in names} for split, names in splits.items()}
per_split = {split: {c for s in names for c in classes(s)} for split, names in splits.items()}
shared = (groups["train"] & groups["val"]) | (groups["train"] & groups["test"]) | (groups["val"] & groups["test"])
weakest = min(instances, key=lambda c: (images[c], instances[c]))

checks = {
    "4 volume": (images[weakest] >= 1500 and instances[weakest] >= 10_000,
                 f"weakest class {weakest}: {images[weakest]} images, {instances[weakest]} instances"),
    "7 no shared groups": (not shared, f"{len(shared)} groups appear in more than one split"),
    "7 every class in every split": (all(per_split[s] == set(instances) for s in splits),
                                     ", ".join(f"{s} misses {len(set(instances) - per_split[s])}" for s in splits)),
    "8 background 0-10%": (background <= 0.10, f"{background:.1%} background images"),
}
for name, (ok, detail) in checks.items():
    print(f"{'PASS' if ok else 'FAIL'}  {name:<29} {detail}")
FAIL 4 volume weakest class 30: 1 images, 1 instances
PASS 7 no shared groups 0 groups appear in more than one split
FAIL 7 every class in every split train misses 5, val misses 36, test misses 41
PASS 8 background 0-10% 1.6% background images按组划分修复了泄漏问题,但练习集离就绪还差得很远:其中最弱的类别(30,skis)只有一个已标注实例,而且验证集无法评估一半的类别。对于 128 张演示图像,这就是预期的结论;这项检查的目的正是在一周的训练开始前给出这样的结论。
脚本只能覆盖可计数的项目。检查项 1、2、3、5 和 6 需要人工完成:明确一致的目标、书面定义、规范覆盖范围、测得的一致性分数以及质检备注。请手动评分,并为每项提供一行证据。
做出决定:开始训练、带着缺口交付,还是先修复#
检查未通过时,人们很容易选择下一步做点别的,而不是修复数据:
| 诱人的捷径 | 行不通的原因 |
|---|---|
| “试试更大的模型。” | 更大的模型同样会如实学到标签噪声。 |
| “调整学习率。” | 任何优化器设置都无法补上缺失的类别或场景。 |
| “增加训练轮数。” | 在覆盖面狭窄的数据上增加训练轮数,只会让过拟合更快发生。 |
| “增加数据增强。” | 数据增强无法创造数据中从未包含的场景。 |
三种看似就绪但仍未通过的情况#
| 模式 | 未通过的检查 | 具体表现 | 解决方法 |
|---|---|---|---|
| 数据量大但缺乏变化 | 3 | 5,000 张图像,只有一台相机,没有边缘案例 | 训练前从更多相机、地点和时段收集数据 |
| 变化丰富但缺乏一致性 | 5 | 标注人员对边界框范围和遮挡情况意见不一 | 完善指南、进行校准,并重新标注受影响的样本 |
| 隐蔽的数据泄漏 | 7 | 对视频帧按图像随机划分 | 按视频片段、摄像头或日期重新划分;预计验证集 mAP 会下降,因为这一下降反映了真实情况 |
带着已知缺口上线#
通常,正确的做法是在所有检查都通过之前,先推出一个范围明确的首版模型:可以是试点、原型,或仅覆盖部分摄像头的 v1。模型投入生产后,比在黑暗中反复打磨数据集更快地暴露实际问题。如果你带着缺口上线,请记录以下三点:
- 哪项检查未通过。
- 预期影响,例如“没有夜间数据;预计天黑后召回率会降低”。
- 在 v1 运行期间弥补缺口的数据采集计划。
“数量:例外”对接手的人毫无帮助。“数量:pallet,共 700 个实例,预计拥挤货位中的托盘召回率会较低;计划在六月前再标注 2,000 个”才是受控风险。每项例外都必须说明它对验收测试的预期影响。
每次重新训练前都重新运行检查#
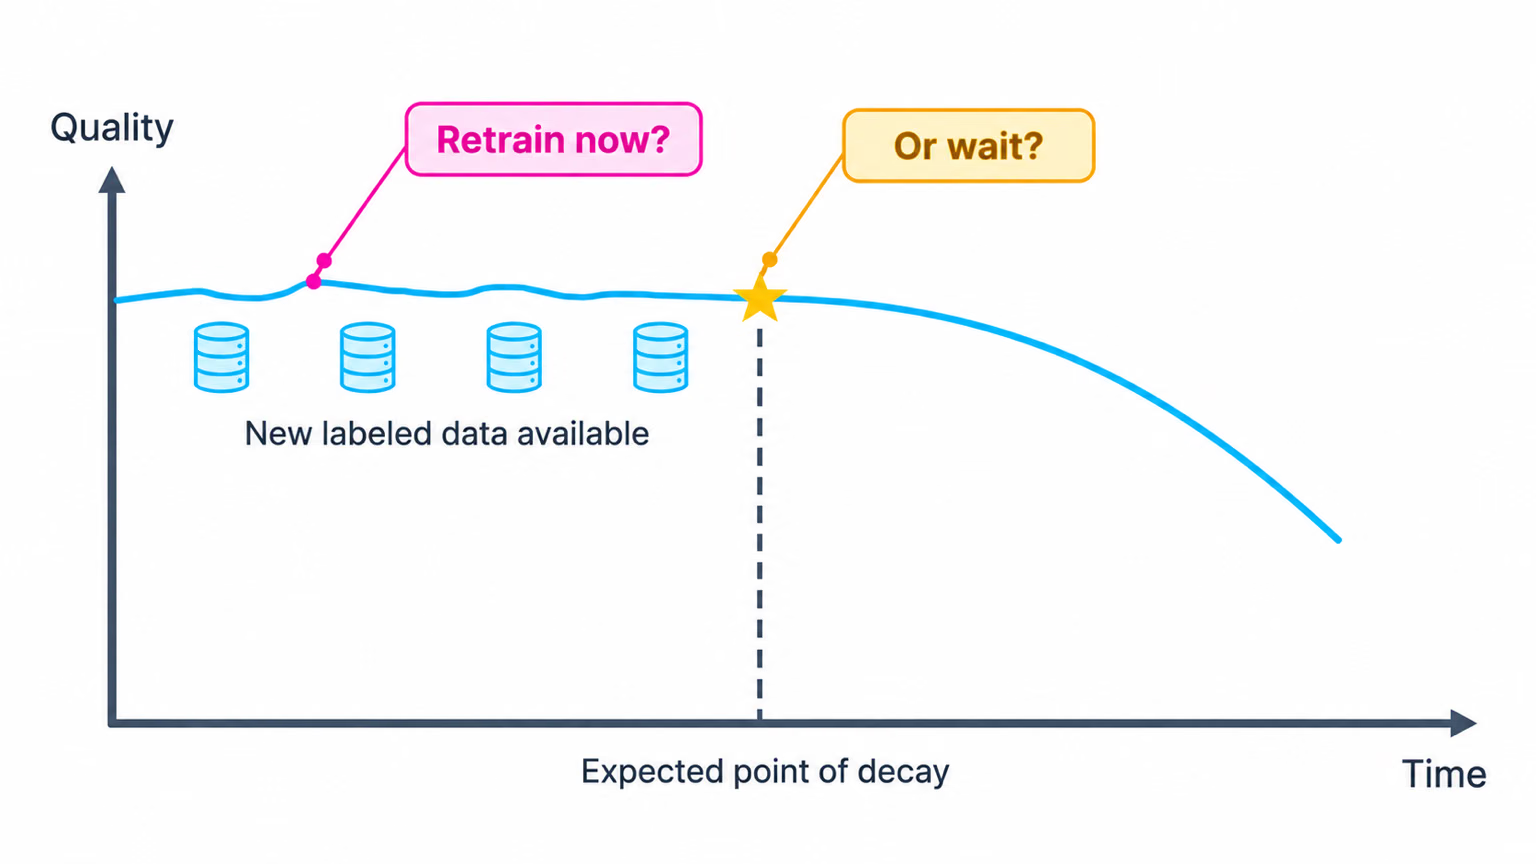
适用于 v1 的数据集并不一定自动适用于 v3。新增类别、新数据源和新标注人员都可能导致原本通过的检查失败;与此同时,生产数据会持续漂移,而新标签也在不断累积。每次重新训练前都重新运行 readiness.py 并重新评估人工检查项;这只需几分钟,但跳过这一步可能导致你在有问题的数据集上训练一周。
显示解答
练习集的评分检查清单:
| # | 检查项 | 评分 | 证据 |
|---|---|---|---|
| 1 | 目标明确 | 是 | 第 1 课中的 objective.md 和 acceptance_test.py |
| 2 | 类别已定义 | 否 | COCO 的 80 个类别名称没有书面定义,也没有说明哪些相似类别应排除 |
| 3 | 图像具有代表性 | 否 | coverage.py:cam2–cam4 未达到配额 |
| 4 | 数据量充足 | 否 | readiness.py:最弱类别只有 1 张图像 |
| 5 | 标签一致 | 否 | 校准轮次的一致率为 47% |
| 6 | QC 已完成 | 部分完成 | 已运行审计;000000000438.jpg 中的疑似问题仍未解决 |
| 7 | 划分干净 | 否 | 没有共享组,但验证集缺少 71 个类别中的 36 个 |
| 8 | 背景图像 | 是 | 1.6% |
决定:先修复。按对验收测试的风险排序:(1) 将类别列表缩减到目标所需类别,一次性减少第 2、4 和 7 项检查的工作量;(2) 为这些类别采集更多数据组;(3) 完成指南中关于远处人物的规则并重新标注。演示集未通过这项检查,这是应该的。