课程初级
企业客户清单
一页客户启动清单,用于记录采集前的每项数据集决策,并为每次重新训练设置关卡。
要让成功可以重复,比训练出第一个模型更难。大多数失败的视觉项目,都可以追溯到启动会议上没人提出的一个问题:模型会在哪里运行、怎样才算成功,或者测试集是否真的未被使用过。这份清单将整个课程浓缩成一页,客户无需工程师翻译就能填写,让这些问题能在仍然容易解决时得到提出。
实践操作
启动清单#
将这份清单复制到项目代码库或 wiki 中。每个部分都对应本课程中的一课,并使用非工程师也能回答的措辞:
# Vision Project Kickoff Checklist

Project: ...   Owner: ...   Date: ...

## 1. What should the model do?
   Business goal (one sentence, with a deadline): ...
   Task: [ ] detect [ ] segment [ ] semantic [ ] classify [ ] pose [ ] OBB [ ] depth
   Classes, each with a definition and a look-alike it excludes: ...

## 2. Where will the model run?
   [ ] Cloud GPU  [ ] Cloud CPU  [ ] Edge device  [ ] Mobile  [ ] Browser
   Latency target: ... ms   Cameras / resolution: ...

## 3. What visual variation exists?
   Times of day: ...   Weather: ...   Sites: ...
   Cameras: ...   Operators / shifts: ...   Variants: ...

## 4. Which edge cases matter?
   ...

## 5. Do we have background images?
   [ ] Yes, ...% of images (target 0-10%)   [ ] No, collect first

## 6. Are labels consistent?
   [ ] Labeling guide written   [ ] Agreement measured: ...%
   [ ] QC audit and suspect review run, notes attached

## 7. Did we check for leakage?
   Split unit: [ ] clip [ ] camera [ ] day [ ] site [ ] customer
   [ ] No group appears in more than one split
   [ ] Every class appears in every split

## 8. Is the test set truly unseen?
   [ ] Locked; used once for the final go/no-go

## 9. What defines success?
   Acceptance test (metric, threshold, holdout): ...

Volume: [ ] >=1,500 images and >=10,000 instances per class
        [ ] or documented exception with expected impact: ...

Ready to fine-tune YOLO26? [ ] Yes [ ] No, fix item ... first每个部分如何为项目设置关卡#
| 阶段 | 必须回答的部分 | 可防止的问题 |
|---|---|---|
| 启动会议 | 1, 2, 9 | 为错误的硬件构建错误的模型 |
| 采集前 | 3, 4, 5 | 采集的数据未涵盖部署条件 |
| 标注前 | 6 | 花钱把同一事物按三种不同方式标注 |
| 训练前 | 7、8、数据量 | 相信因数据泄漏或过于乐观而失真的指标 |
| 每次重新训练前 | 全部 | 新数据悄然破坏原本通过的检查 |
召开启动会议#
与负责业务结果的人一起逐项查看这页内容,而不只是与工程师讨论。以下三个习惯有助于做好这件事:
- 在第 9 部分上花时间。 验收测试最容易暴露真正的分歧;花一小时达成共识,可以省下数周争论模型是否达标的时间。
- 接受“不知道”这个答案。 在旁边写下负责人和日期。未回答的问题就是接下来两周的项目计划。
- 尽早询问第 2 部分。 部署目标决定模型大小和图像大小的上限,而这两者又决定数据集必须覆盖的最小对象尺寸。
检查清单如果只由工程师填写,就失去了意义
检查清单的价值在于利益相关方对第 1、3、4 和 9 部分的回答。如果工程师靠猜测填写这些内容,记录的就是假设,而不是共识。安排一次会议;对于目前还没人知道答案的问题,先留空。
将填写完成的清单与数据集放在一起,放在 QC 记录和数据集划分文件旁边。几个月后有人问起模型为何表现如此时,答案通常就从这页开始找。
现在你可以做什么#
你现在可以把业务目标转化为验收测试,编写带有配额的数据集规范,在每个文件名中加入元数据以采集有代表性的数据,保持标注一致并衡量一致性,用脚本审核质量,按组划分数据以避免泄漏,选择符合部署场景的数据增强方式,通过就绪检查设置训练关卡,并将基线运行结果转化为下一项数据集改进。
下一步学什么#
- 训练你的第一个 YOLO 模型:先在准备自定义数据集中转换标签,然后进行训练、验证和导出。
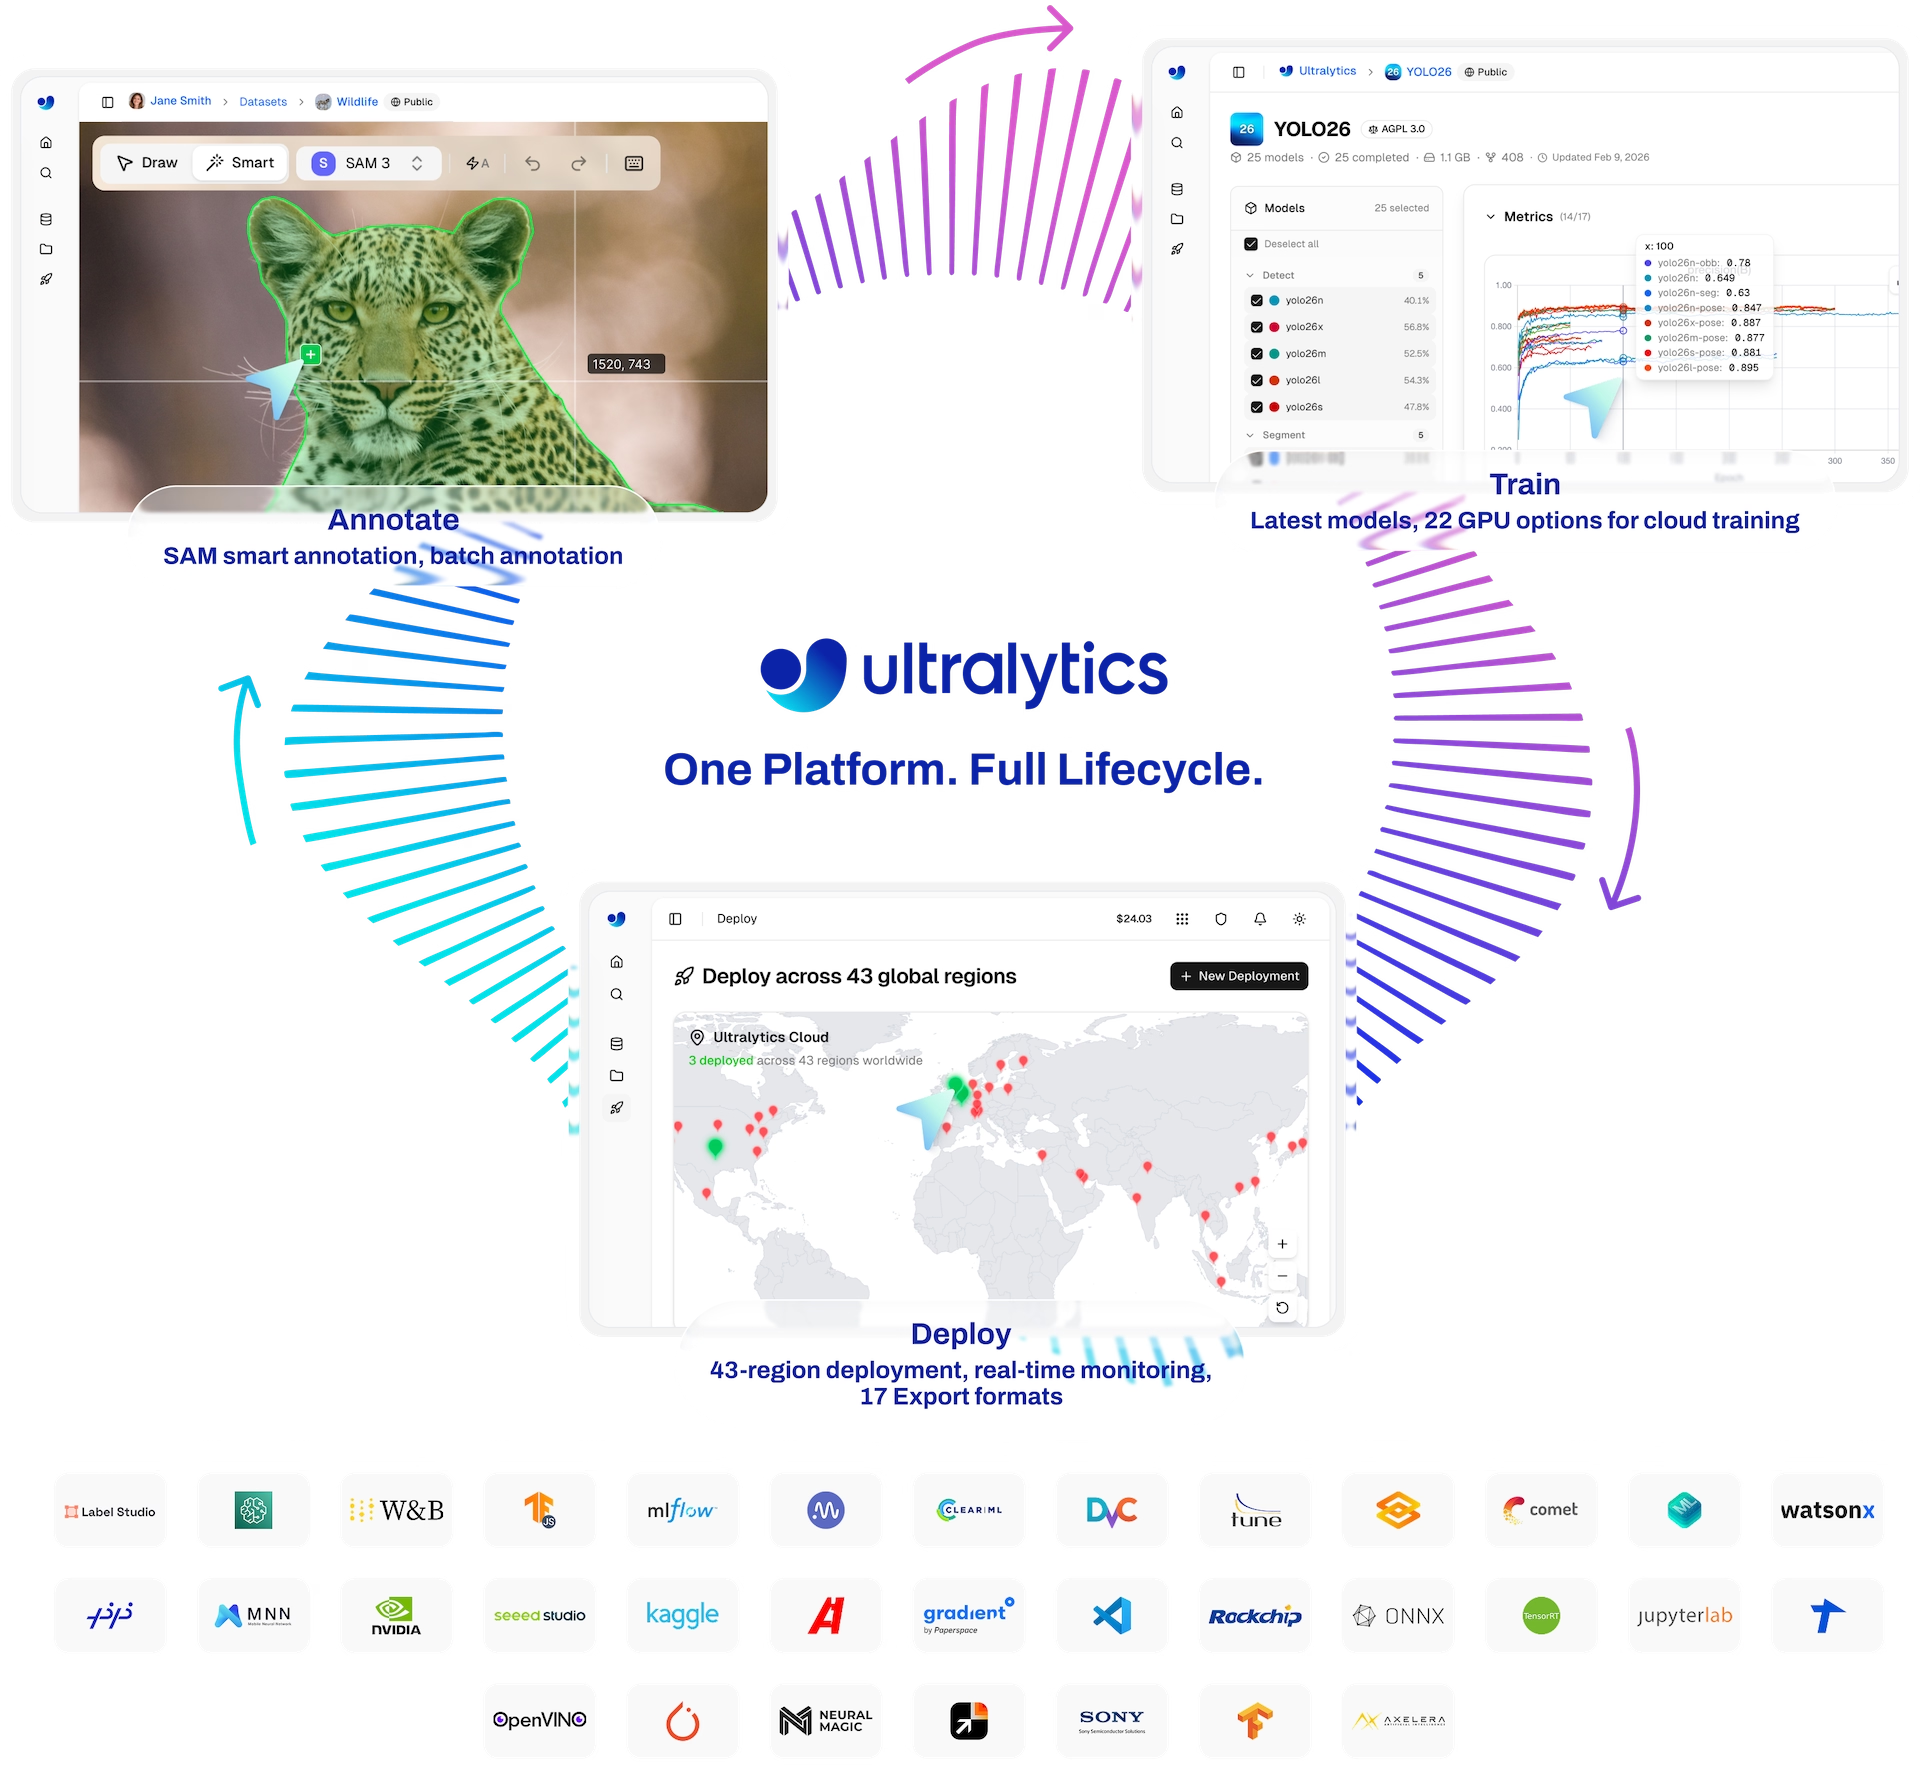
- 使用 Ultralytics Platform 构建:在同一平台中完成相同的生命周期流程(标注、整理、云端训练、部署、监控),从整理、去重和划分数据开始。
- 生产环境中的 Ultralytics YOLO:导出并部署模型,在模型上线后持续监控其漂移。
- 微调指南:当默认设置不够用时,了解冻结层、两阶段训练和优化器选择。
显示解答
第 1 课中仓库项目的启动清单填写示例:
Project: dock-safety-v1   Owner: site operations lead   Date: 2026-05-02

1. Goal: cut dock-door near misses 30% in six months.  Task: [x] detect
   Classes: forklift (excludes hand pallet jacks), person (excludes reflections),
            pallet (excludes crates without a pallet base)
2. [x] Edge device   Latency: <= 100 ms   Cameras: 4 x 1080p, 12 fps
3. Day and night shifts; rain at bays B-C; sites: dock A only for v1
4. People behind stacked pallets; forklifts half out of frame at bay edges
5. [ ] No: collect 150 empty-dock frames (owner: shift lead, by 2026-05-16)
6. [ ] Guide written  [ ] Agreement measured  -> owner: annotation lead, by 2026-05-23
7. Split unit: [x] camera + day
8. [x] Locked: cam-4, 2026-06-01 to 2026-06-07, never used for tuning
9. Recall(person) >= 0.95 at precision >= 0.85 on the locked cam-4 week
Volume: [ ] exception: pallet target 2,000 instances for v1; expect lower
        pallet recall in crowded bays

Ready to fine-tune YOLO26?  [ ] No, fix items 5 and 6 first
两个“不知道”的回答都转化成了注明日期的行动;边缘设备目标确定了延迟上限;锁定的测试周让验收测试变得明确具体。