准备自定义数据集
按照 Ultralytics YOLO 格式整理图像和标注,将像素框转换为归一化标注行,并在训练前找出有问题的标注。
文件夹名称写错或标注未归一化,不会导致训练崩溃。Ultralytics 会跳过有问题的图像并继续运行,所以你实际使用的只是部分数据,得到的模型表现平平,还会浪费一个下午,在错误的地方寻找原因。
本课介绍数据集检测的实际操作部分:文件夹、标注行、格式转换和检查。你将使用本课程其余部分用于训练的真实 115 张药片数据集。关于应该收集什么以及如何标注,请参阅标注最佳实践。
实践操作
获取练习数据集#

以下目录结构也可以作为 zip 文件上传到 Ultralytics Platform 的“新建数据集”对话框,因此你在这里准备的数据集可以直接上传,无需修改。下载药片泡罩包装的 92 张训练帧和 23 张验证帧,并解压到 my_dataset:
curl -L -o medical-pills.zip https://github.com/ultralytics/assets/releases/download/v0.0.0/medical-pills.zip
unzip -q medical-pills.zip -d my_dataset
my_dataset/
├── images/
│ ├── train/ Frame_0.jpg, Frame_100.jpg, ... (92 images)
│ └── val/ Frame_144.jpg, ... (23 images)
└── labels/
├── train/ Frame_0.txt, Frame_100.txt, ... (92 files)
└── val/ Frame_144.txt, ... (23 files)这里没有清单文件。Ultralytics 会在图像路径中将 /images/ 替换为 /labels/,并将扩展名替换为 .txt,以此查找每个标注文件,因此 images/val/Frame_144.jpg 会读取 labels/val/Frame_144.txt。由此有两点需要注意:
- 这两个文件夹必须并排放置,并且名称必须准确为
images和labels。 - 标注文件为空或缺失的图像属于背景图像:这是有效的,也有助于教会模型哪些内容不应检测,但前提是这是你的有意选择。
解读标注行#
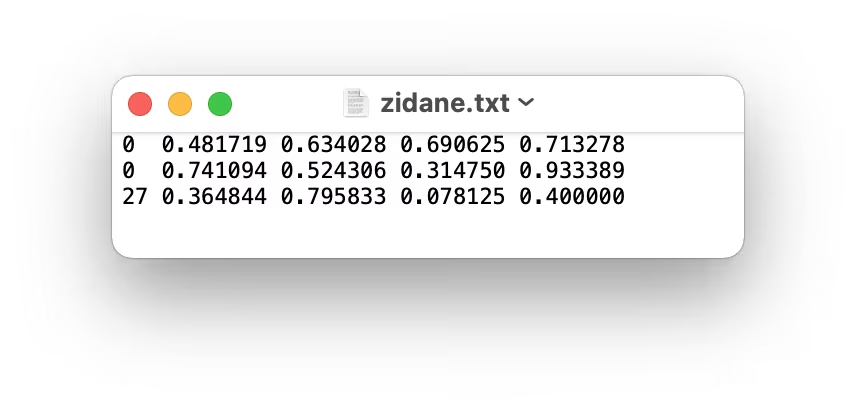
每行表示一个对象:先是整数类别索引,然后是以图像宽度和高度为基准的边界框中心点和尺寸比例。来自 labels/train/Frame_0.txt 的一行实际标注如下:
0 0.330729 0.816204 0.103125 0.1212960:类别索引 0,YAML 会将其命名为pill。0.330729 0.816204:边界框中心位于图像宽度的 33% 处、图像高度的 82% 处。0.103125 0.121296:边界框约占图像宽度的 10%、高度的 12%。
示例:转换像素框#
标注工具通常会以像素坐标导出框的角点(x1, y1, x2, y2)。将它们除以图像尺寸。上一课中,810×1080 的 bus.jpg 里最左边的人物范围从 (49, 398) 到 (240, 902):
| 字段 | 公式 | 值 |
|---|---|---|
x_center | (x1 + x2) / 2 / width | (49 + 240) / 2 / 810 = 0.178395 |
y_center | (y1 + y2) / 2 / height | (398 + 902) / 2 / 1080 = 0.601852 |
width | (x2 − x1) / width | 191 / 810 = 0.235802 |
height | (y2 − y1) / height | 504 / 1080 = 0.466667 |
大多数标注工具以及 Roboflow 等工具都可以直接导出 YOLO 格式。对于 COCO JSON,请参阅 COCO JSON 训练指南;其他格式可参考 JSON2YOLO 仓库。对于 Pascal VOC XML,上面的公式可以用一个简短的脚本实现:
import xml.etree.ElementTree as ET
from pathlib import Path

CLASSES = ["person", "bus"]  # index = class id; must match names in data.yaml

def voc_to_yolo(xml_file: Path, out_dir: Path) -> None:
    root = ET.parse(xml_file).getroot()
    w, h = int(root.find("size/width").text), int(root.find("size/height").text)
    lines = []
    for obj in root.iter("object"):
        name = obj.find("name").text
        if name not in CLASSES:
            continue
        box = obj.find("bndbox")
        x1, y1, x2, y2 = (float(box.find(k).text) for k in ("xmin", "ymin", "xmax", "ymax"))
        xc, yc, bw, bh = (x1 + x2) / 2 / w, (y1 + y2) / 2 / h, (x2 - x1) / w, (y2 - y1) / h
        lines.append(f"{CLASSES.index(name)} {xc:.6f} {yc:.6f} {bw:.6f} {bh:.6f}")
    out_dir.mkdir(parents=True, exist_ok=True)
    (out_dir / f"{xml_file.stem}.txt").write_text("\n".join(lines) + "\n")

voc_to_yolo(Path("bus.xml"), Path("labels"))
print(Path("labels/bus.txt").read_text())
在包含上一课中人物和公交车边界框的 bus.xml 上运行时,它会打印示例计算结果和公交车的计算结果:
0 0.178395 0.601852 0.235802 0.466667
1 0.495679 0.454167 0.991358 0.482407训练前检查#
将一些标注文件绘制到对应图像上。类别错位、x 和 y 互换,或边界框框住阴影,这些问题肉眼一看就很明显,但指标却看不出来:
from ultralytics.data.utils import visualize_image_annotations

visualize_image_annotations(
    "my_dataset/images/train/Frame_0.jpg",
    "my_dataset/labels/train/Frame_0.txt",
    {0: "pill"},
)
然后让 Ultralytics 检查每个文件。首次读取数据集时,它会扫描标注,并逐行判断每张图像是否可用:
扫描结果会报告检查结果:23 images, 0 backgrounds, 0 corrupt 是数据集正常时的显示内容。其他任何结果都对应下面列出的某种错误。
避免这些错误#
症状:出现 ignoring corrupt image/label: non-normalized or out of bounds coordinates [634. 881. 198. 163.],且 corrupt 计数非零。原因:使用了像素值,而不是比例值。解决方法:分别除以图像的宽度和高度。任何大于 1 的标签值都表示边界框未经过归一化。
症状:yolo val 扫描 0 images, 23 backgrounds 并发出 No labels found 警告,训练随后以 ValueError: train: No labels found 停止——此处是因为标签文件夹名为 annotations。解决方法:文件夹必须准确命名为 images 和 labels,且文件名要匹配。
症状:Label class 1 exceeds dataset class count 1. Possible class labels are 0-0。原因:导出工具从 1 开始为类别编号。解决方法:YOLO 类别索引从 0 开始;在转换脚本中减去 1,或修正导出设置。
如果绘制的边界框向下、向右偏移了半个框,说明你写的是 x1 y1 w h,而不是 x_center y_center w h。绘制一个文件几秒钟就能发现这个问题;任何扫描检查都做不到。
如需对整个数据集进行系统性检查,请参阅数据集质量控制。内置数据集(例如 coco8、coco128 和 african-wildlife)都是值得参考的目录结构;数据集概览列出了所有数据集。训练器会在你的标注基础上应用数据增强,因此先在这里快速清理数据,每个训练轮次都会受益。
显示解答
for s in train val; do
  echo "$s: $(ls my_dataset/images/$s | wc -l) images, $(ls my_dataset/labels/$s | wc -l) labels"
done
# train: 92 images, 92 labels
# val:   23 images, 23 labels
from pathlib import Path
for txt in Path("my_dataset/labels").rglob("*.txt"):
for line in txt.read_text().splitlines():
values = [float(v) for v in line.split()[1:]]
if any(v < 0 or v > 1 for v in values):
print(txt, line)脚本没有输出,说明所有坐标都已归一化。每个划分中的文件数量相同,说明每张图像都有对应的标注文件;下一课的扫描结果会确认没有损坏的文件。