训练你的第一个模型
只需一次调用,就能在你的数据集上微调 YOLO26;逐行查看实时训练日志,并在运行文件夹中找到 best.pt 和重要图表。
从头开始训练检测器需要数天时间和海量数据。在笔记本电脑 CPU 上,使用约一百张图像微调预训练 YOLO26 只需约一分钟,因为迁移学习会复用模型已掌握的边缘、形状和物体知识。
本课中,你会在药丸数据集上训练,观察 mAP50-95 在十个 epoch 内从接近零的基线升至 0.66,并学习如何尽早从日志判断运行是否正常,还是在浪费时间。
实践操作
示例:训练药丸检测器#
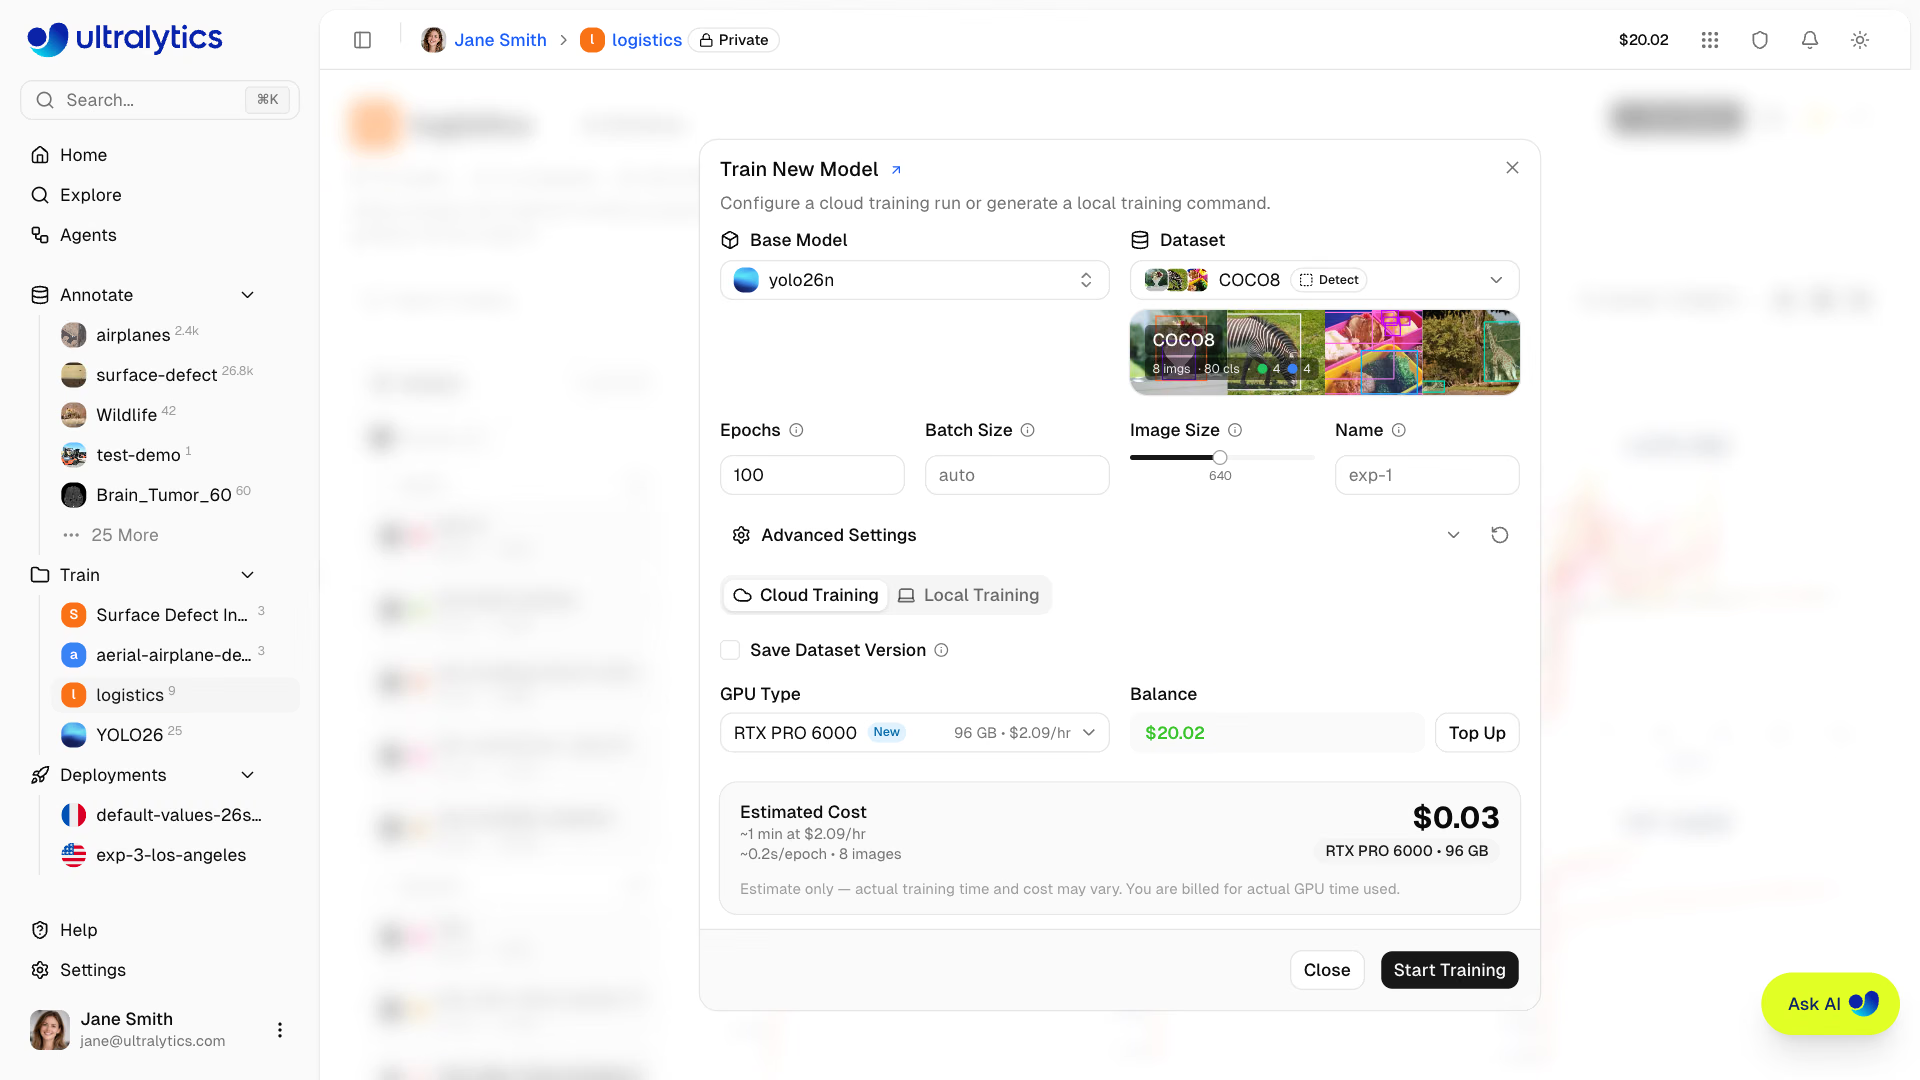
Ultralytics Platform 的“Train New Model”对话框要求你选择与下方代码相同的选项——基础模型、数据集、epoch 数和图像尺寸——然后在云端 GPU 上运行,或生成对应的本地命令。这些设置在笔记本电脑 CPU 上约一分钟即可完成:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")  # 在 COCO 上预训练
results = model.train(data="my_dataset/data.yaml", epochs=10, imgsz=320, name="pills_v1")
print(results.save_dir)
CLI 和 Python 的功能等效。epochs=10 和 imgsz=320 可缩短 CPU 运行时间;使用 GPU 时,去掉这两个参数并采用默认值(epochs=100、imgsz=640),因为增加 epoch 数和像素数几乎总是有帮助。Train 模式会替你运行这个循环:
逐行阅读日志#
实际输出,精简为前两个和最后两个 epoch:
optimizer: AdamW(lr=0.002, momentum=0.9) with parameter groups ...
Using 92 train, 23 val images for fraction=1.0 at imgsz=320
      Epoch    GPU_mem   box_loss   cls_loss    l1_loss  Instances       Size
       1/10         0G      1.818      3.899   0.008805        206        320: 100% 6/6 3.3s
                   all         23        399      0.957      0.805      0.927      0.548
       2/10         0G      1.434      3.291   0.006285        208        320: 100% 6/6 4.4s
                   all         23        399      0.953      0.911      0.964      0.592
       ...
       9/10         0G      1.121      1.103   0.005143        194        320: 100% 6/6 5.0s
                   all         23        399      0.949      0.957      0.975      0.656
      10/10         0G      1.174      1.125   0.005068        212        320: 100% 6/6 5.1s
                   all         23        399       0.97      0.957      0.977      0.659
10 epochs completed in 0.015 hours.
optimizer: AdamW(lr=0.002 ...):默认的optimizer=auto已替你选择优化器和学习率。Using 92 train, 23 val images:确认这些数字与你的数据集相符。数字较小表示有图像被跳过。GPU_mem 0G:正在 CPU 上训练。在 GPU 上,这里会显示内存使用情况;如果在 GPU 机器上看到0G,说明 GPU 没有被使用。- 每个 epoch 的第一行:训练集的三项损失、最后一个批次中标注对象的数量(
Instances),以及图像尺寸。 - 每个 epoch 的
all行:验证集上的精确率、召回率、mAP50 和 mAP50-95。这一行最值得关注。
| 列 | 含义 | 正常趋势 |
|---|---|---|
box_loss | 预测框与标注框之间的偏差 | 先下降,然后趋于平稳 |
cls_loss | 类别分数的错误程度 | 先下降,然后趋于平稳 |
l1_loss | YOLO26 直接计算的框坐标误差 | 下降 |
P, R | 验证集上的精确率和召回率 | 上升并保持平衡 |
mAP50, mAP50-95 | 检测质量;mAP50-95 也会奖励更贴合的边界框 | 上升,然后趋于平台期 |
这里,mAP50-95 从 0.0002 的基线升至第一个 epoch 后的 0.548,并在十个 epoch 后达到 0.659。精确率在第 4 个 epoch 降至 0.80 后又恢复:在 23 张验证图像上,单个 epoch 的结果波动较大,因此应判断趋势,而不是只看某一行。运行过程中可参考以下判断规则:
- 损失下降且 mAP 上升:继续运行。
- 从第 1 个 epoch 起损失就持平:按 Ctrl+C 停止,并检查标签和 YAML。
- 精确率远高于召回率:模型过于谨慎,会漏掉物体。召回率远高于精确率:模型会把不存在的物体也检测出来。
- mAP 多个 epoch 都没有变化:增加 epoch 数没有帮助;应更改数据或
imgsz。
三项损失是 YOLO26 损失函数的组成部分;性能指标指南会深入解释每项指标。
查看运行生成的内容#
所有内容都会写入 runs/detect/pills_v1/:
| 文件 | 用途 |
|---|---|
weights/best.pt | 在各个epoch中验证适应度最高的检查点;用于推理和导出 |
weights/last.pt | 最新检查点;用于恢复中断的运行 |
args.yaml | 运行使用的所有参数,可用于复现 |
results.csv, results.png | 每个 epoch 的损失和指标,包括数据文件和图表 |
labels.jpg | 类别数量以及边界框尺寸和位置直方图 |
train_batch*.jpg | 绘有标签的增强训练批次 |
val_batch*_labels.jpg, val_batch*_pred.jpg | 验证图像上的真实标注与预测结果 |
confusion_matrix*.png, Box*_curve.png | 混淆矩阵以及精确率、召回率、F1 和 PR 曲线 |
先打开 train_batch0.jpg。如果其中的边界框没有框住物体,说明标签有误,增加多少个 epoch 都无法解决。
优先调整这些参数#
| 参数 | 默认 | 何时更改 |
|---|---|---|
epochs | 100 | 短时 CPU 实验或开始过拟合的小型数据集(调低);仍在持续改进的大型数据集(调高至 200–300) |
imgsz | 640 | 小物体(增至 1024 或 1280)或 CPU 实验(调低) |
batch | 16 | 批次大小:遇到内存不足错误时调低,或使用 -1,将批次大小自动调整为 GPU 内存的约 60% |
patience | 100 | 如果验证适应度连续 N 个 epoch 没有提升,则提前停止,例如 patience=20 |
device | 自动 | 强制指定 cpu、mps、类似 0 的 GPU 索引,或类似 [0, 1] 的多个 GPU 索引 |
name | train | 始终根据变更内容为运行命名 |
model.train(data="my_dataset/data.yaml", epochs=200, imgsz=1024, batch=-1, patience=20, name="pills_v1_1024")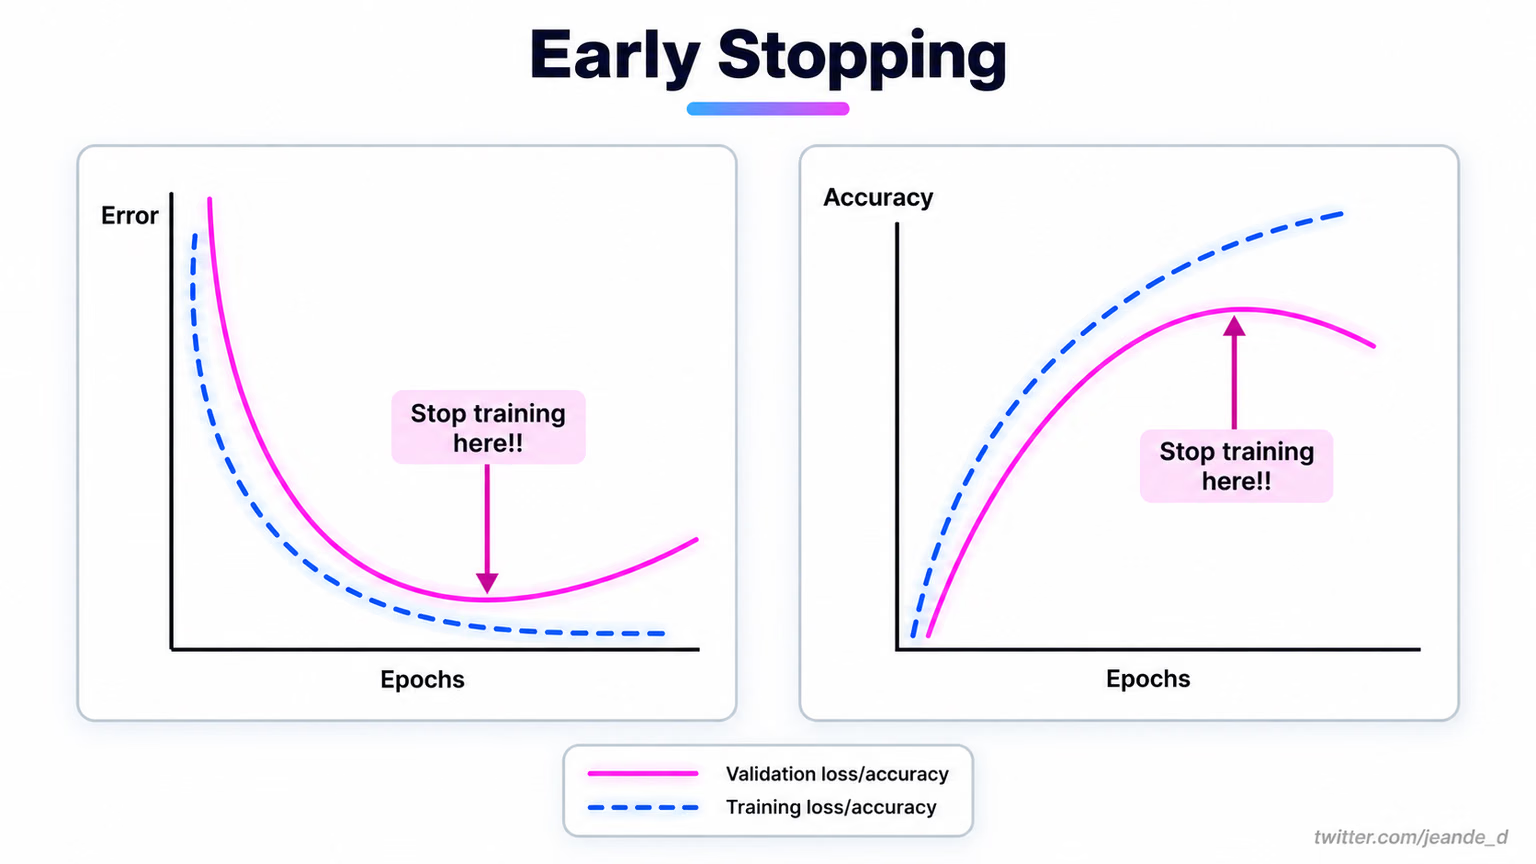
patience 的默认值 100 意味着 100 个 epoch 的运行永远不会提前停止。设置更小的值,会在运行停滞时结束训练;上图中的曲线也表明此时应停止。无论如何,都会保留 best.pt。
使用多张 GPU 时,传入类似 device=[0, 1, 2, 3] 的列表:Ultralytics 会替你启动分布式数据并行(DDP)训练,batch 表示所有 GPU 的总量,并且默认使用混合精度训练(amp=True)。当运行规模超出笔记本电脑的承受能力时,同一数据集和参数也可以在 Ultralytics Platform 的云端 GPU 上运行,具体内容见训练、查看和微调运行。
避免这些错误#
症状:在小型数据集上训练许多轮后,mAP 仍接近零。原因:模型来自 yolo26n.yaml(随机权重),而不是 yolo26n.pt。解决方法:始终从预训练的 .pt 开始。只有进行 backbone 研究或使用非常大的数据集时,从头训练才值得。
症状:第一轮训练就出现 CUDA out of memory。解决方法:将 batch 减半,或设置 batch=-1,让 AutoBatch 选择适合内存的尺寸。降低 imgsz 也有帮助,但会改变模型能看到的内容。
last.pt 是最后一轮训练的结果,可能不如较早某一轮。best.pt 是验证适应度最高的那一轮,也是应该用于验证、导出和部署的权重。
显示解答
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
results = model.train(data="my_dataset/data.yaml", epochs=10, imgsz=320, name="pills_v1")
print(results.save_dir)  # runs/detect/pills_v1
Baseline (yolo26n.pt, no pill class): mAP50 0.001, mAP50-95 0.0002
pills_v1 (10 epochs, imgsz 320, CPU, ~1 min): mAP50 0.977, mAP50-95 0.659
Plateau: mAP50-95 gains shrink after epoch 8 (0.649 -> 0.656 -> 0.659)
train_batch0.jpg: yes, boxes sit on the pills具体数值会因硬件和软件包版本略有不同。