验证与诊断
将 best.pt 与基线进行验证,查看混淆矩阵、各类别指标和预测图像,并据此制定具体的修正清单。
单个 mAP 数值只能告诉你模型错了 多少,不能告诉你 错在哪里。漏检小物体、混淆两个类别以及边界框不够贴合都会拉低 mAP,而每种情况都需要不同的修正方法。猜错原因,你可能会花一周时间收集错误的数据。
本课中,你会在 best.pt 上运行 Val 模式,与基线进行比较,并查看混淆矩阵和预测图像,直到能够写出下一轮的修正清单。性能指标指南提供了更详细的介绍。
实践操作
示例:验证 best.pt#
from ultralytics import YOLO

model = YOLO("runs/detect/pills_v1/weights/best.pt")
metrics = model.val(data="my_dataset/data.yaml")

print(f"precision {metrics.box.mp:.3f}  recall {metrics.box.mr:.3f}")
print(f"mAP50 {metrics.box.map50:.3f}  mAP50-95 {metrics.box.map:.3f}")
val.py 的实际输出:
precision 0.970  recall 0.957
mAP50 0.977  mAP50-95 0.659
图表会写入新的 runs/detect/val 文件夹(接着是 val-2,依此类推)。将这些数值与基线并列:
| 模型 | mAP50 | mAP50-95 |
|---|---|---|
预训练的 yolo26n.pt(没有药丸类别) | 0.001 | 0.0002 |
pills_v1(10 个 epoch,imgsz 320,CPU) | 0.977 | 0.659 |
数字说明了什么:
- Precision 0.970,recall 0.957:两者均衡。误报少,漏检也少。
- mAP50 0.977:在重叠要求较宽松时,模型几乎能找到每一颗药丸。
- mAP50-95 0.659:在重叠要求严格时,许多框不够贴合。如此大的差距说明问题在于定位——应增加训练轮数、使用更大的
imgsz或收紧标注,而不是缺少数据。
关于 precision、recall 和 mAP 之间的权衡,请参阅诚实解读检测指标。
了解每个文件能回答什么问题#
| 问题 | 文件 |
|---|---|
| 哪些类别容易混淆,哪些类别容易漏检? | confusion_matrix_normalized.png |
| 每个类别如何在precision和recall之间取舍? | BoxPR_curve.png |
| 应该部署在哪个confidence阈值? | BoxF1_curve.png:它的峰值是一个不错的起始 conf |
| 失败案例是什么样的? | val_batch0_labels.jpg 与 val_batch0_pred.jpg |
| 模型是否过拟合? | 训练文件夹中的 results.png |
解读混淆矩阵#
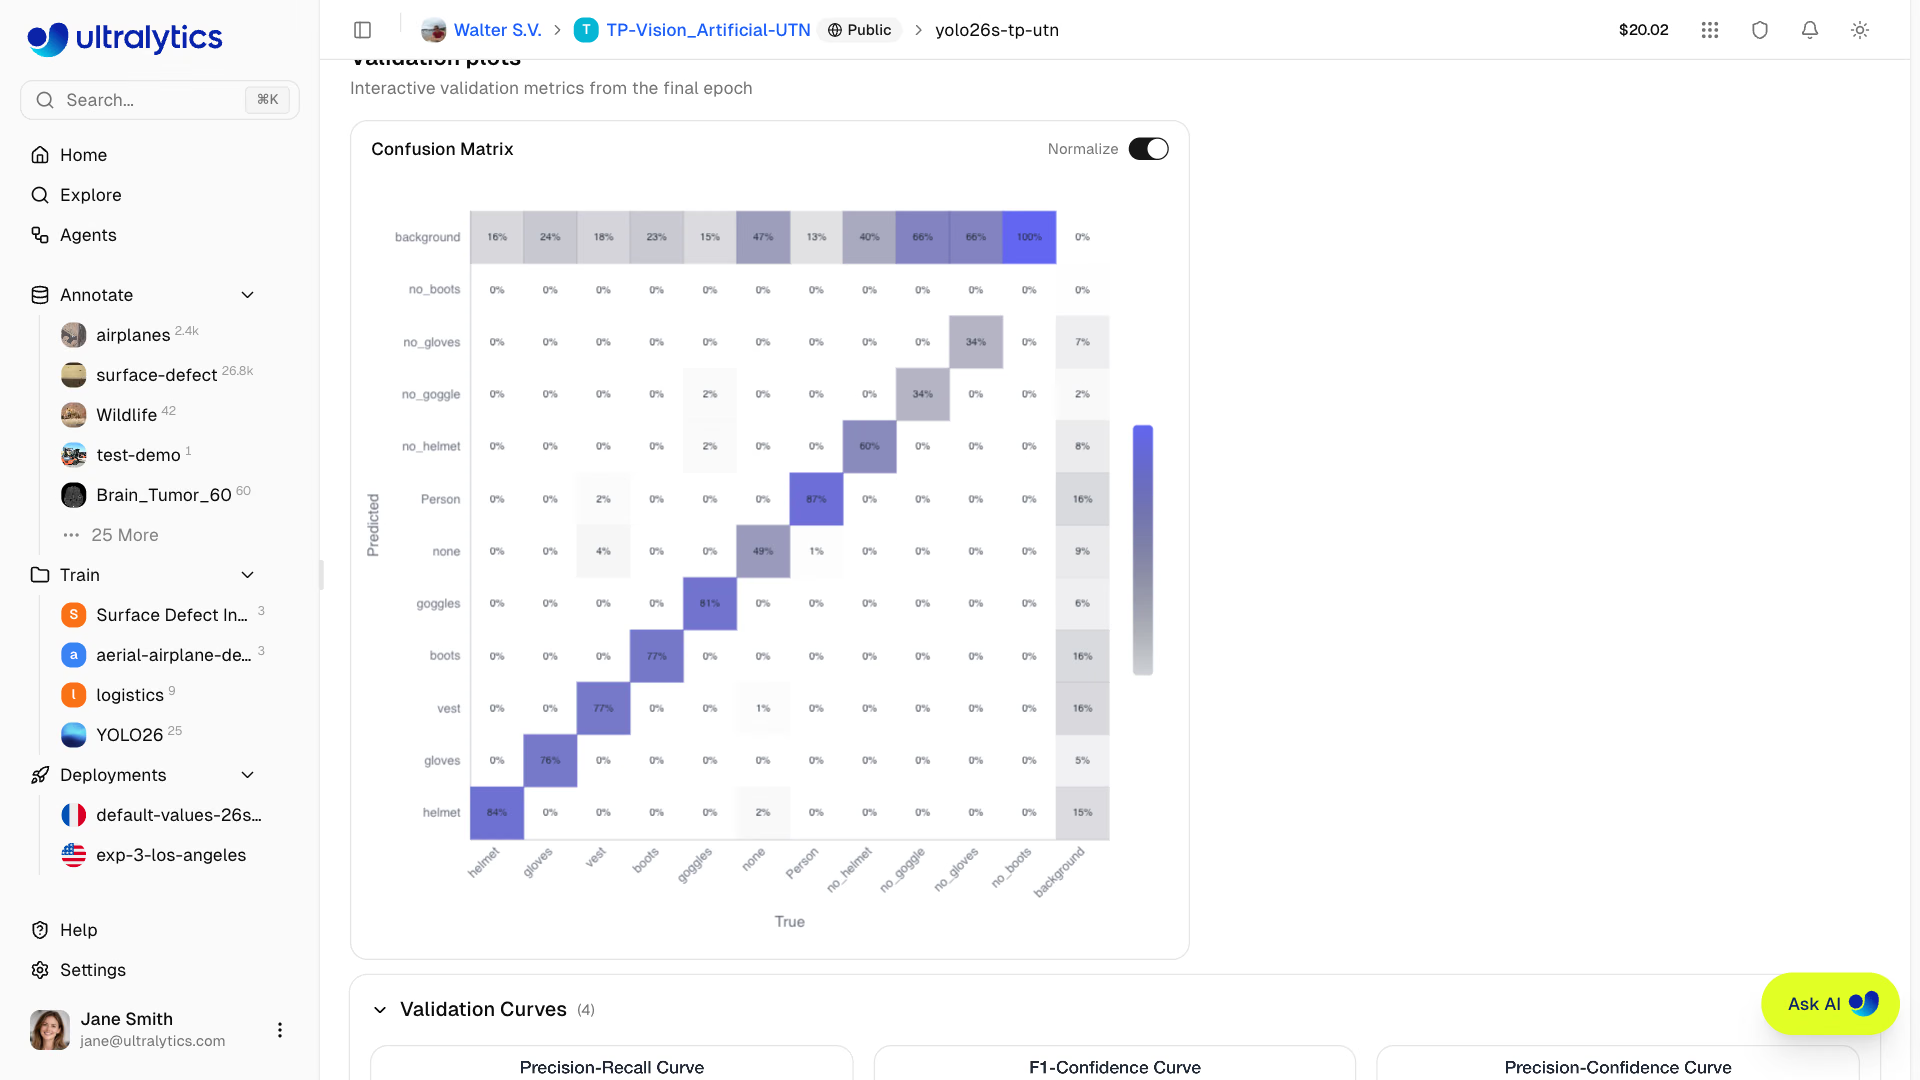
混淆矩阵是最有用的单项诊断工具。在 Ultralytics 绘图中,列是真实类别,行是预测类别,并额外包含 background 行和列。归一化版本会将每列除以该列总和,因此每列显示该类别的目标最终被分到了哪里。Pills 只有一个类别,因此可以用下面这个三类别仓库示例练习(数字仅供说明):
| 预测 ↓ / 真实 → | 叉车 | 人员 | 托盘 | 背景 |
|---|---|---|---|---|
| 叉车 | 0.78 | 0.03 | 0.18 | 0.45 |
| 人员 | 0.04 | 0.91 | 0.00 | 0.20 |
| 托盘 | 0.10 | 0.00 | 0.65 | 0.35 |
| 背景 | 0.08 | 0.06 | 0.17 | — |
- 对角线:各类别被正确检测的比例。托盘的数值为 0.65,是表现较差的类别。
- 非对角线:类别混淆。18% 的真实托盘被预测为叉车,10% 的叉车被预测为托盘。
- 背景行:漏检。17% 的托盘完全没有被检测到。
- 背景列:误报,即在空白区域画出的框。其中 45% 被判为叉车。
每种单元格类型都对应一种修复方法:
| 模式 | 解决方法 |
|---|---|
| 两个类别互相混淆 | 添加能区分这两个类别的示例:载着托盘的叉车,以及堆放在叉车旁边的托盘 |
| 背景行数值高(漏检) | 增加该类别在容易漏检条件下的示例 |
| 背景列数值高(误报) | 添加会触发误报场景的背景图像,例如空走廊 |
查看各类别的具体数值#
类别较多时,验证日志会按类别逐行打印结果,而 metrics.box.maps 则保存供代码使用的各类别 mAP50-95。继续看仓库示例:
                 Class     Images  Instances      Box(P          R      mAP50  mAP50-95)
                   all         50        102       0.78       0.71       0.74       0.51
              forklift         30         45       0.85       0.78       0.81       0.58
                person         40         50       0.92       0.88       0.91       0.64
                pallet          5          7       0.58       0.48       0.51       0.31
pallet 远低于其他类别,而且验证集中只有 7 个实例。可能是模型不擅长检测托盘,也可能是验证数据太少,无法得出结论。两种情况都需要采取相同的措施:收集更多托盘数据用于训练和验证。
检查失败案例#
并排打开 val_batch0_labels.jpg 和 val_batch0_pred.jpg。两者之间的差异就是可视化的失败案例,而这些案例中的规律就是诊断线索:图像边缘处漏检、小目标、某种光照条件,或外观相似的干扰物。数据集中的这类规律几乎总比调超参数更值得优先处理。
在药丸模型的验证图像中,清晰可见的药丸置信度接近 1.0。置信度较低、约为 0.3–0.5 的框集中出现在部分被另一板泡罩包装遮挡的药丸,以及被图像边缘截断的药丸上。这不是通过调整 conf 就能解决的问题,而是标注策略问题。半遮挡的药丸是否应该计入?确定规则、记录下来,并以相同方式标注每张图像。
然后打开 results.png。训练损失和验证损失应该同步下降。如果训练损失持续下降,而验证损失上升,模型就是过拟合;如果两者都长期居高不下,则是欠拟合。偏差-方差权衡是理解这两种情况的视角。
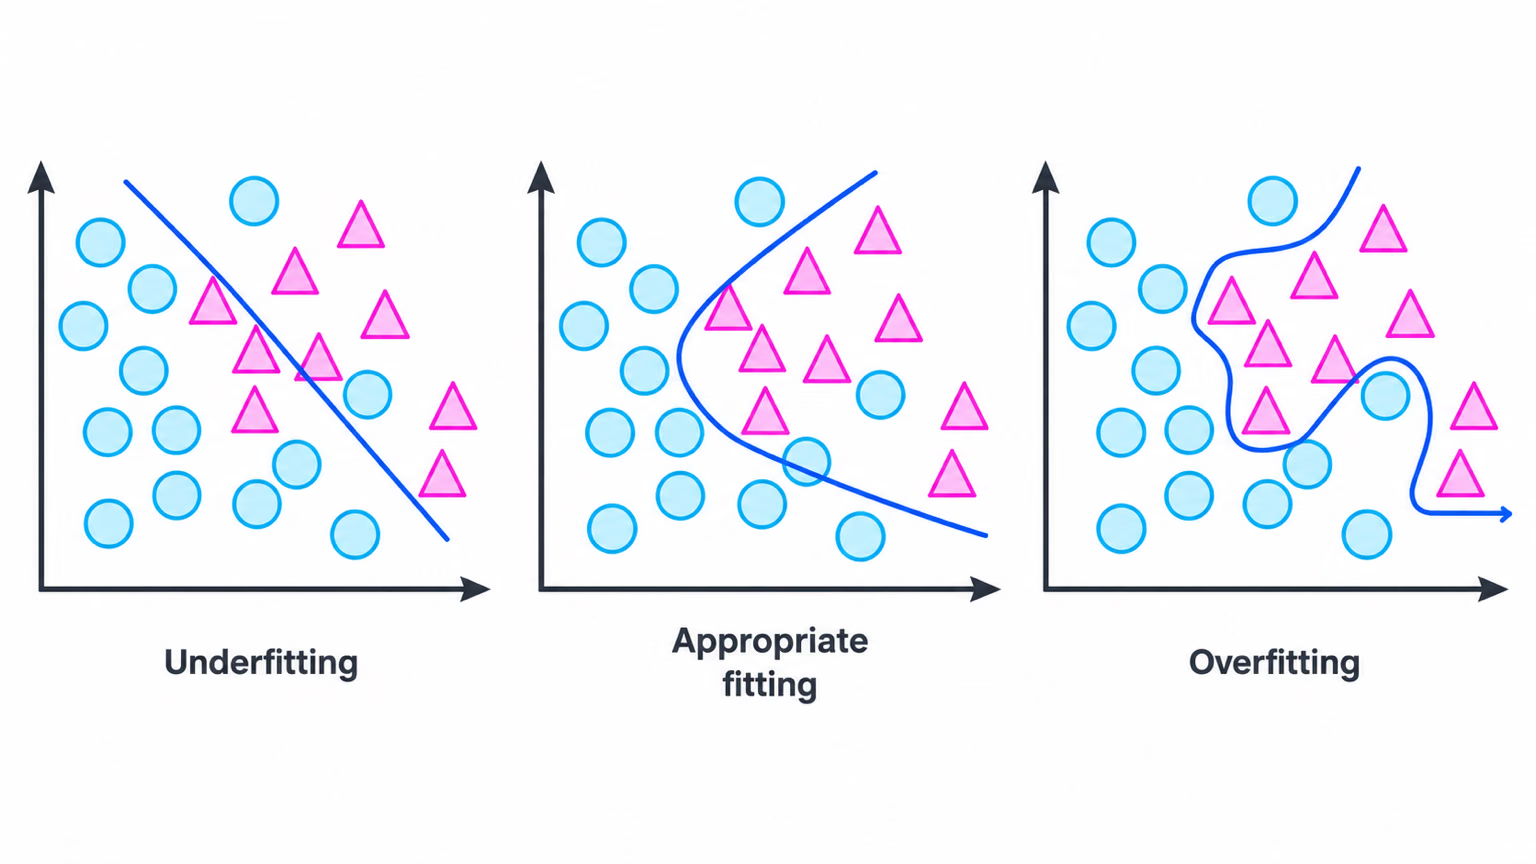
针对过拟合,按有效频率从高到低排列的修复方法是:增加更多样化的数据;减少训练轮数或使用更紧凑的 patience;以及数据增强(hsv_h、degrees、translate、scale、fliplr、mosaic、……)。默认增强配置已经很强;只有在有明确理由时才修改,例如左右方向很重要时关闭 fliplr。
将发现转化为修复清单#
先修复数据,再调超参数;每轮只改一项,这样你才能知道哪些改动起了作用。关于这个循环中的数据集部分,请参阅首次微调与迭代循环。
避免这些错误#
症状:模型的 mAP50-95 从 0.659 突然降到 0.403。原因:pills_v1 在 imgsz=320 尺寸下训练,却使用 imgsz=640 进行验证;物体看起来比模型学过的尺寸大一倍。解决方法:使用训练时的 imgsz 尺寸进行验证和部署,并且只在相同尺寸下比较运行结果。
验证时会使用 conf=0.001,以便绘制完整的精确率-召回率曲线,因此 val_batch0_pred.jpg 会显示应用永远不会报告的边界框。根据 BoxF1_curve.png 选择部署阈值,然后用 predict 检查。
只有 23 张图像时,某一轮训练的精确率从 0.93 降到 0.80,然后又升回去。要结合多个训练轮次和运行结果判断趋势;在相信一两个百分点的差异之前,先扩大验证集。
显示解答
Baseline mAP50-95 0.0002 -> pills_v1 0.659 (mAP50 0.977), both at imgsz=320

Failures:
- Low-confidence boxes (about 0.3-0.5) on pills half-hidden under another pack.
- Low-confidence or missing boxes on pills cut off at the image edge.

Overfitting: none. val/box_loss flattened near 1.05; val/cls_loss spiked at epochs 4-6
and then fell to its lowest value (1.08) at epoch 10.

Fix list:
1. Write a labeling rule for partly hidden and edge pills, then relabel the val set to match.
2. Train longer and larger: epochs=50, imgsz=640 (mAP50-95 lags mAP50, so box tightness is the gap).
3. Add 20 frames with overlapping packs, labeled under the new rule.