首次微调与迭代循环
使用默认设置微调预训练 YOLO26 权重,按 AP 对类别排序并统计漏检和混淆情况,再将最弱类别转化为下一项数据集修复任务。
本课的练习运行得到 0.66 mAP50,这听起来像是学习率问题。但逐类别表格说明了另一种情况:cup 在验证集中有 14 个已标注目标,模型却一个都没找到。这是数据问题,任何超参数都无法解决。把首次运行当作诊断工具,用它确定下一步该修复哪个类别。
实践操作
从预训练权重开始#
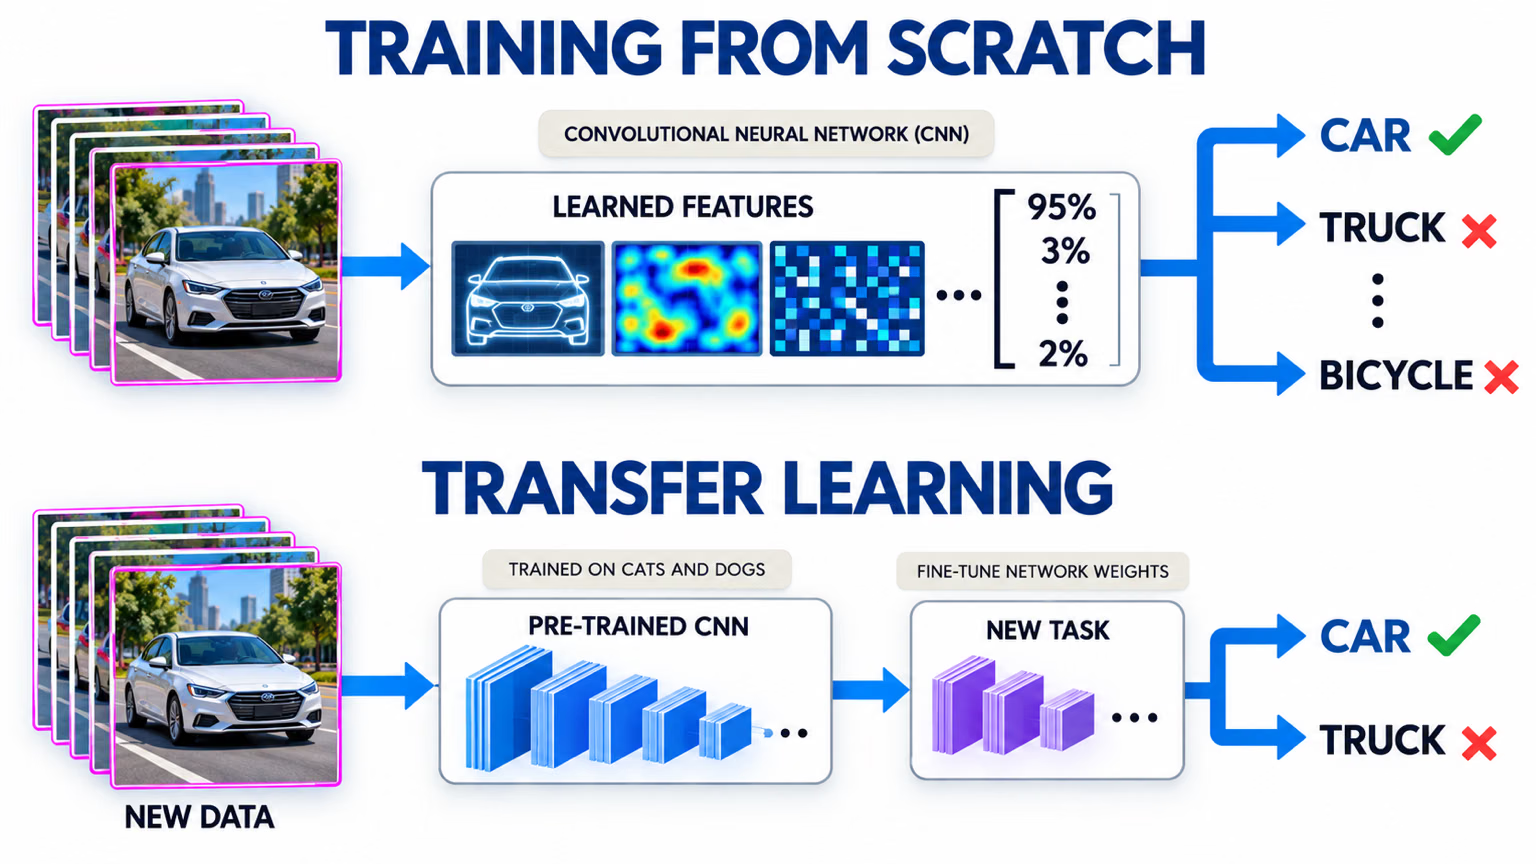
微调从已有权重开始,这些权重已经能够识别边缘、纹理和形状,因此收敛更快,所需数据也远少于从随机权重开始训练。选择与你的任务匹配的 YOLO26 检查点:
| 任务 | 预训练检查点 | 预训练数据 |
|---|---|---|
| 检测 | yolo26n.pt | COCO |
| 分割 | yolo26n-seg.pt | COCO |
| 语义分割 | yolo26n-sem.pt | Cityscapes |
| 姿态 | yolo26n-pose.pt | COCO 关键点 |
| OBB | yolo26n-obb.pt | DOTAv1 |
| 分类 | yolo26n-cls.pt | ImageNet |
| 深度估计 | yolo26n-depth.pt | 大型室内外深度数据混合集 |
主干网络和颈部网络会直接迁移;任务头会部分重新初始化,以匹配你的类别数量。只有在数据集非常庞大、领域极为特殊时,从头训练才值得考虑。先使用 nano(n)模型快速建立基线,只有在数据迭代不再带来收益后,才扩大模型规模。微调指南介绍了内部的具体变化。
运行基线#
使用默认设置训练;首次运行的目的是建立基线,而不是创造纪录。这会使用正确划分数据集一文中的练习集划分进行训练,首先写入数据 YAML:
from ultralytics import YOLO
from ultralytics.data.utils import check_det_dataset
from ultralytics.utils import YAML

names = check_det_dataset("coco128.yaml")["names"]  # 练习集沿用 COCO 的类别名称
YAML.save("practice.yaml", {"path": "datasets/practice", "train": "train.txt", "val": "val.txt", "test": "test.txt", "names": names})

model = YOLO("yolo26n.pt")  # 在 COCO 上预训练;请使用适用于你任务的检查点
model.train(data="practice.yaml", epochs=3, imgsz=320)  # 实际运行:epochs=100, imgsz=640
Class Images Instances Box(P R mAP50 mAP50-95)
all 20 143 0.614 0.6 0.664 0.486运行文件夹(runs/detect/train/)现在包含 weights/best.pt。首次运行时只有三个参数值得考虑:
| 参数 | 默认 | 何时调整 |
|---|---|---|
epochs | 100 | 极小的数据集可减少;非常大的数据集可设为 200–300 |
imgsz | 640 | 如果画面中有很多小目标,可设为 1024 或 1280 |
batch | 16 | 使用 -1 自动调整批次大小;出现显存不足错误时调低 |
训练你的第一个模型详细介绍了训练调用及其实时日志。
对类别排序并分析漏检#
整体 mAP 会掩盖问题所在。按 AP50-95 对类别排序,并使用混淆矩阵,将每个类别的错误分成模型完全漏掉的目标,以及被模型判成其他类别的目标:
from ultralytics import YOLO

model = YOLO("runs/detect/train/weights/best.pt")  # your fine-tuned checkpoint
metrics = model.val(data="practice.yaml", imgsz=320, verbose=False)  # same data YAML and imgsz as training

matrix = metrics.confusion_matrix.matrix  # rows: predicted class, columns: true class; last row = background
for ap, cls in sorted(zip(metrics.box.ap, metrics.box.ap_class_index))[:5]:  # weakest five classes first
    total, missed, correct = matrix[:, cls].sum(), matrix[-1, cls], matrix[cls, cls]
    print(f"{model.names[cls]:>8}  AP50-95={ap:.3f}  {total:2.0f} labeled: {correct:2.0f} found, "
          f"{missed:2.0f} missed, {total - correct - missed:2.0f} called another class")
car AP50-95=0.000 4 labeled: 0 found, 4 missed, 0 called another class
fork AP50-95=0.000 1 labeled: 0 found, 0 missed, 1 called another class
handbag AP50-95=0.025 1 labeled: 1 found, 0 missed, 0 called another class
cup AP50-95=0.039 14 labeled: 0 found, 10 missed, 4 called another class
sink AP50-95=0.075 1 labeled: 1 found, 0 missed, 0 called another class不同类型的错误对应不同的数据集修复方法:
- 验证集实例过少(
fork、handbag、sink,各 1 个):AP 只是噪声。在验证集至少包含几十个该类别的实例之前,不要对该类别采取行动;先收集更多验证组。 - 漏检(
car4 个中漏掉 4 个,cup14 个中漏掉 10 个):模型完全没有检测到目标。检查训练集中对此类场景的覆盖情况,并使用suspect_labels.py查找漏标。 - 判为其他类别(
cup14 个中有 4 个):类别定义存在重叠。打开这些图像,明确类别定义,并在指南中注明相似类别。
这里值得采取行动的发现是 cup:有 14 个已标注实例,但一个都没找到。
将运行文件夹作为数据反馈来解读#

每次训练运行都会写入这些文件;在云端训练期间,Ultralytics Platform 也会实时绘制相同的曲线:
| 文件 | 它能告诉你哪些数据问题 |
|---|---|
confusion_matrix_normalized.png | 哪些类别彼此混淆,或被误判为背景 |
BoxPR_curve.png | 逐类别精确率-召回率曲线;曲线较低表示该类别较弱 |
val_batch0_pred.jpg | 真实验证图像上的预测结果;查找系统性漏检 |
labels.jpg | 模型训练所用的类别数量和边界框尺寸 |
results.png | 损失和指标曲线;验证损失上升而训练损失下降,说明出现了过拟合 |
验证与诊断介绍了每张图表;在这里,始终要问的是数据缺少什么。
以数据为先的迭代循环#
一次典型迭代:选择验证集实例数量充足的最弱类别,审查约 50 张包含该类别的图像,修复数据,使用相同设置和数据划分重新训练,并比较逐类别 AP。然后转向下一个最弱类别。
如果你在同一次重新训练中添加 300 张图像并调高 imgsz,就无法判断究竟是哪项改动影响了分数。迭代数据时保持设置和数据划分不变,这样每次比较都能单独反映一项数据改动。
何时开始调整超参数#
经过两到三轮数据迭代后,如果剩余的弱类别已无法追溯到覆盖范围、标签或类别定义问题,就可以通过调参争取最后几个百分点。微调指南介绍了层冻结、学习率和优化器选择。不过,如果在数据准备好之前就调参,你可能会花上数周优化一个基于错误数据集的模型。
当模型在锁定的测试集上通过 acceptance_test.py 后,Ultralytics YOLO 生产部署介绍导出和服务部署;而 使用 Ultralytics Platform 构建中的监控健康状况与准确率和自动化重新训练循环则介绍重新训练循环。
显示解答
根据试跑结果,cup 是需要处理的类别:验证集中有 14 个已标注实例,模型检出 0 个,漏检 10 个,另有 4 个被判为其他类别。按规模制定计划:
| 发现 | 数据集操作 | 规模 |
|---|---|---|
| 14 个杯子中漏检了 10 个 | 检查训练集覆盖情况:按摄像头拍摄日统计包含杯子的训练图像数量;在没有杯子的分组中采集杯子图像 | 新增 40 张包含杯子的图像,覆盖 4 个摄像头拍摄日 |
| 14 个杯子中有 4 个被判为其他类别 | 在 val_batch0_pred.jpg 和混淆矩阵中查看这些实例;如果它们被判为 wine glass 或 bowl,就在 cup 的定义中加入这两个易混淆类别 | 根据新规则重新标注约 30 张训练图像 |
| 仅有 1 个实例的类别 | 暂时不要处理;添加包含这些类别的验证集分组 | 下一轮采集 |
然后使用 epochs、imgsz,并保持数据集划分不变,重新训练;再次运行 rank_classes.py,并比较 cup 的 AP。如果 AP 上升,瓶颈就在数据;如果没有上升,在调整任何超参数之前,先审查接下来的 50 张图像。