标注最佳实践
编写标注指南、选择工具、避免十种会悄然降低准确率的错误,并在扩大规模前用脚本衡量标注人员之间的一致性。
标签质量决定了模型质量的上限。十名标注人员对“托盘”的理解各有细微差异,最终生成的数据集会同时教会模型这十种理解方式,再多的训练也无法消除这种矛盾。书面指南、经过衡量的校准轮次,以及一份简短的已知错误清单,无论是一个人标注 500 张图像,还是一个团队标注 50,000 张图像,都能确保标签一致。
实践操作
选择标注工具#
合适的工具取决于任务、团队以及训练的执行位置:
| 工具 | 最适用于 | 说明 |
|---|---|---|
| Ultralytics Platform | 适用于 YOLO 的全部七种任务:提供用于绘制框、多边形、语义掩码、关键点和旋转框,以及标注图像类别的编辑器;还支持上传深度图和使用 SAM 智能标注 | 在同一处管理标签、数据集图表和训练;无需导出 |
| CVAT | 大型团队、视频和复杂的审核工作流 | 可自托管或使用云服务 |
| Label Studio | 多模态项目(图像 + 文本 + 音频) | 配置灵活,但学习曲线更陡 |
| Labelme | 小型团队的多边形标注 | 简单的桌面应用 |
| LabelImg | 快速制作仅含框的原型 | 轻量级;其代码仓库已归档 |
在 Ultralytics Platform 上,SAM 2.1、SAM 3 和 SAM 3.1智能标注支持 detect、segment、semantic 和 OBB 数据集。无论你选择哪种工具,都要确认它能导出任务所需的 YOLO 格式;准备自定义数据集介绍了标签格式和转换方法。
七种标签类型#

| 标签类型 | 绘制内容 | 任务 |
|---|---|---|
| 类别标签 | 每张图像一个标签 | 分类 |
| 边界框 | 为每个对象绘制轴对齐矩形 | 检测 |
| 多边形 | 勾勒每个对象实例的轮廓 | 实例分割 |
| 稠密掩码 | 为每个像素分配一个类别 | 语义分割 |
| 关键点 | 带名称的点,例如关节点 | 姿态 |
| 定向框 | 为每个对象绘制旋转矩形 | OBB |
| 深度图 | 无需绘制:由深度传感器生成、与每张图像配对的逐像素距离图 | 深度估计 |
先编写标注指南#
在任何人开始绘制框之前,先编写一份包含以下五个部分的指南:
- 类别定义:每个类别用一段话说明,包括正例、外观相似但不属于该类别的对象,以及边缘案例。
- 绘制规则:为可见对象绘制紧贴边缘的框;多边形沿可见轮廓绘制。
- 遮挡和尺寸规则:为部分可见对象设定一个阈值(“能识别类别就标注”),为微小对象设定另一个阈值(“标注高度超过 10 像素的人”),并在所有场景中统一执行。
- 模糊案例记录:记录每个“这个该怎么处理?”的问题、达成一致的答案和屏幕截图。
- 跳过哪些内容:列出此任务中不值得标注的所有对象。
配上屏幕截图的一两页说明就足够了。随后,按照以下简短流程执行,再扩大标注规模:
标注每张图像中的所有相关物体。未标注的叉车会让模型学到叉车有时属于背景,于是模型就会漏检叉车。在开始训练之前,部分标注的数据集看起来和完整标注的小型数据集毫无区别。完成一张图像的标注后再处理下一张。
十种会降低准确率的错误#
以下是 Ultralytics 标注团队最常见的错误示例,图中包括叉车、人和托盘(改编自 Alexis Schutzger 的演示文稿)。将这些内容作为标注指南的首批条目。
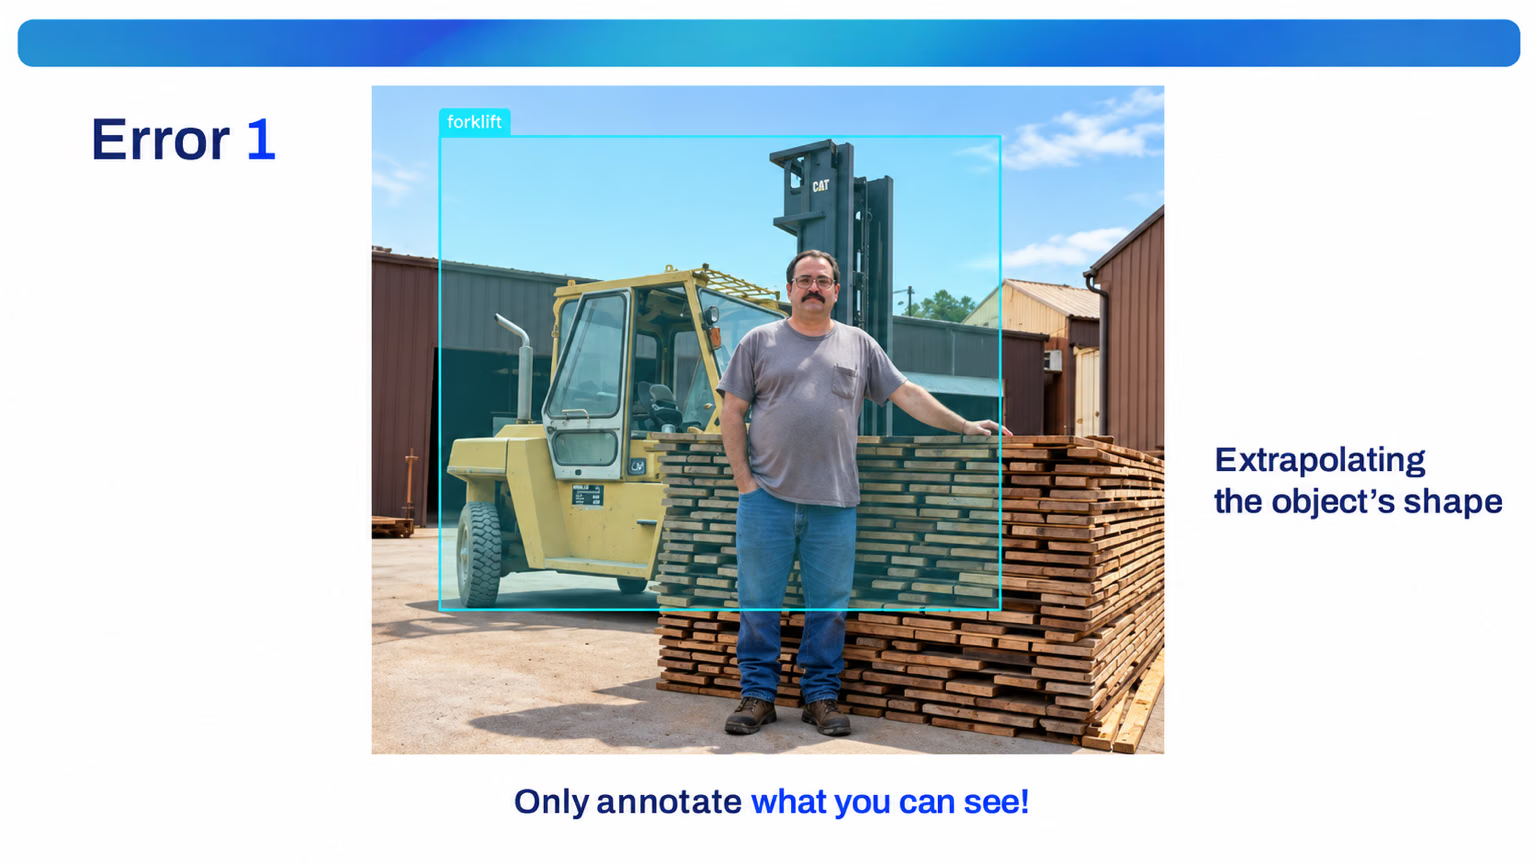
1. 臆测对象形状。只标注你能看到的部分。这里的叉车停在人和一堆木材后面,但标注框却横跨两者,延伸到标注人员想象中卡车其余部分所在的位置。只框出可见部分。
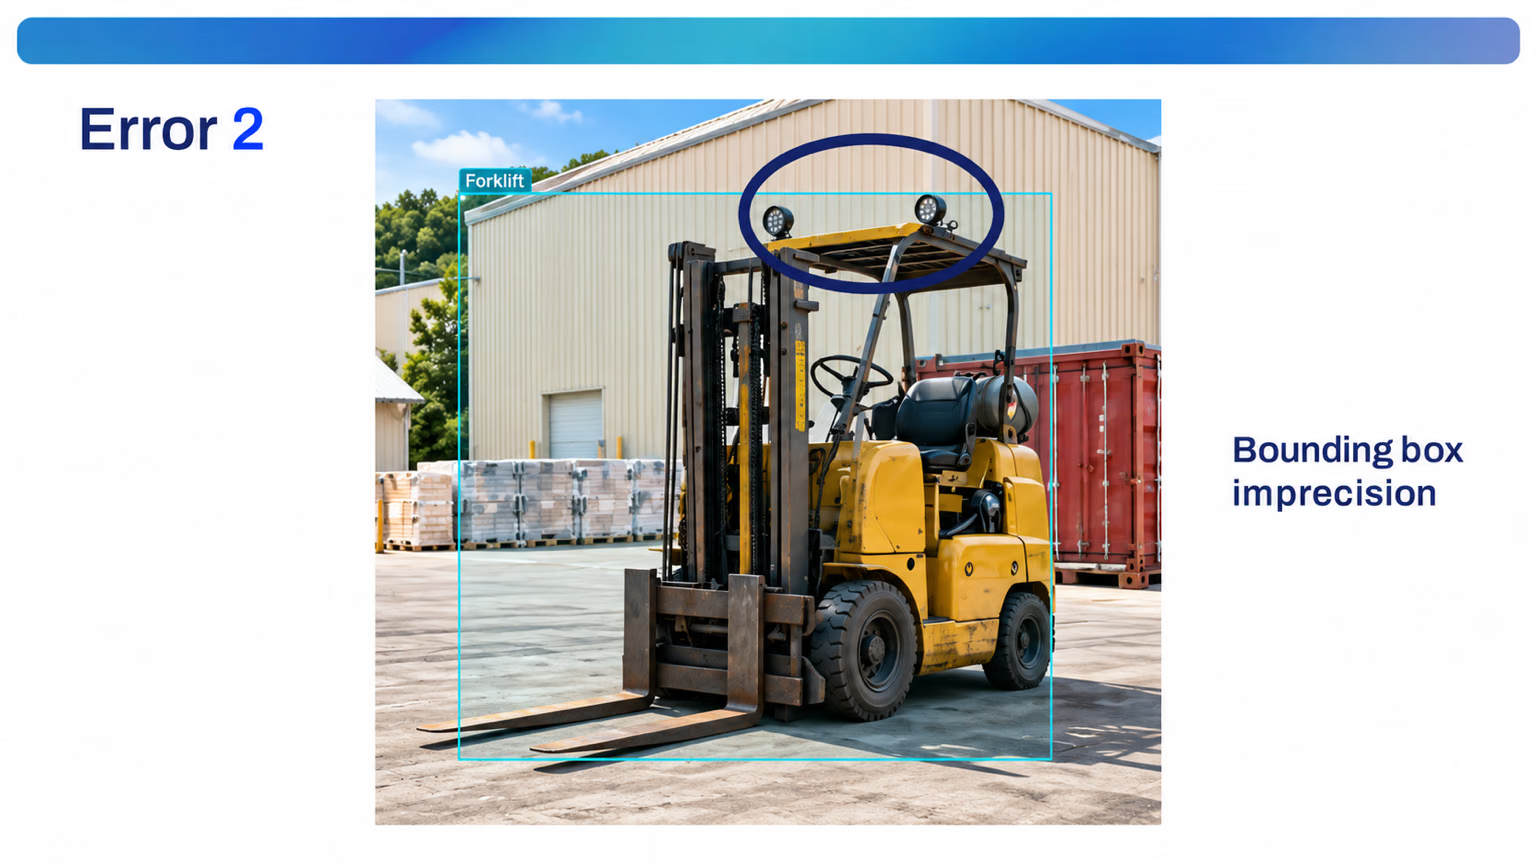
2. 标注框不准确。标注框必须紧贴对象。这里的框切过了顶棚护架上的灯;框切掉对象的一部分,或在对象周围留出地面边距,都会让模型学到错误的范围。
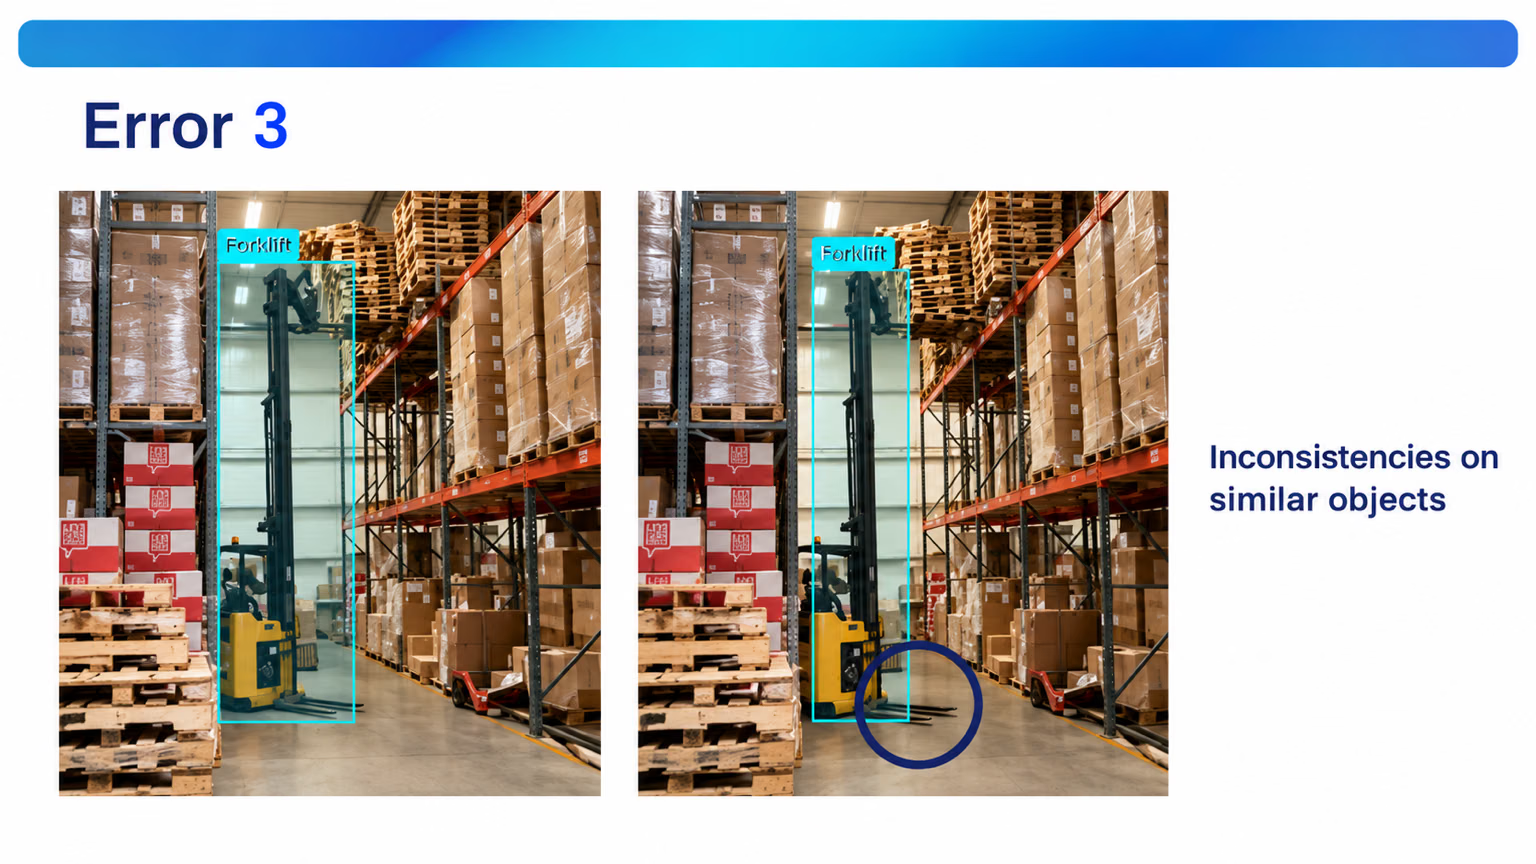
3. 相似对象的标注规则不一致。左侧的框包含货叉,右侧的框却没有。模型会对同一个问题得到两种答案,因此要明确写下规则:包含货叉,还是不包含货叉。
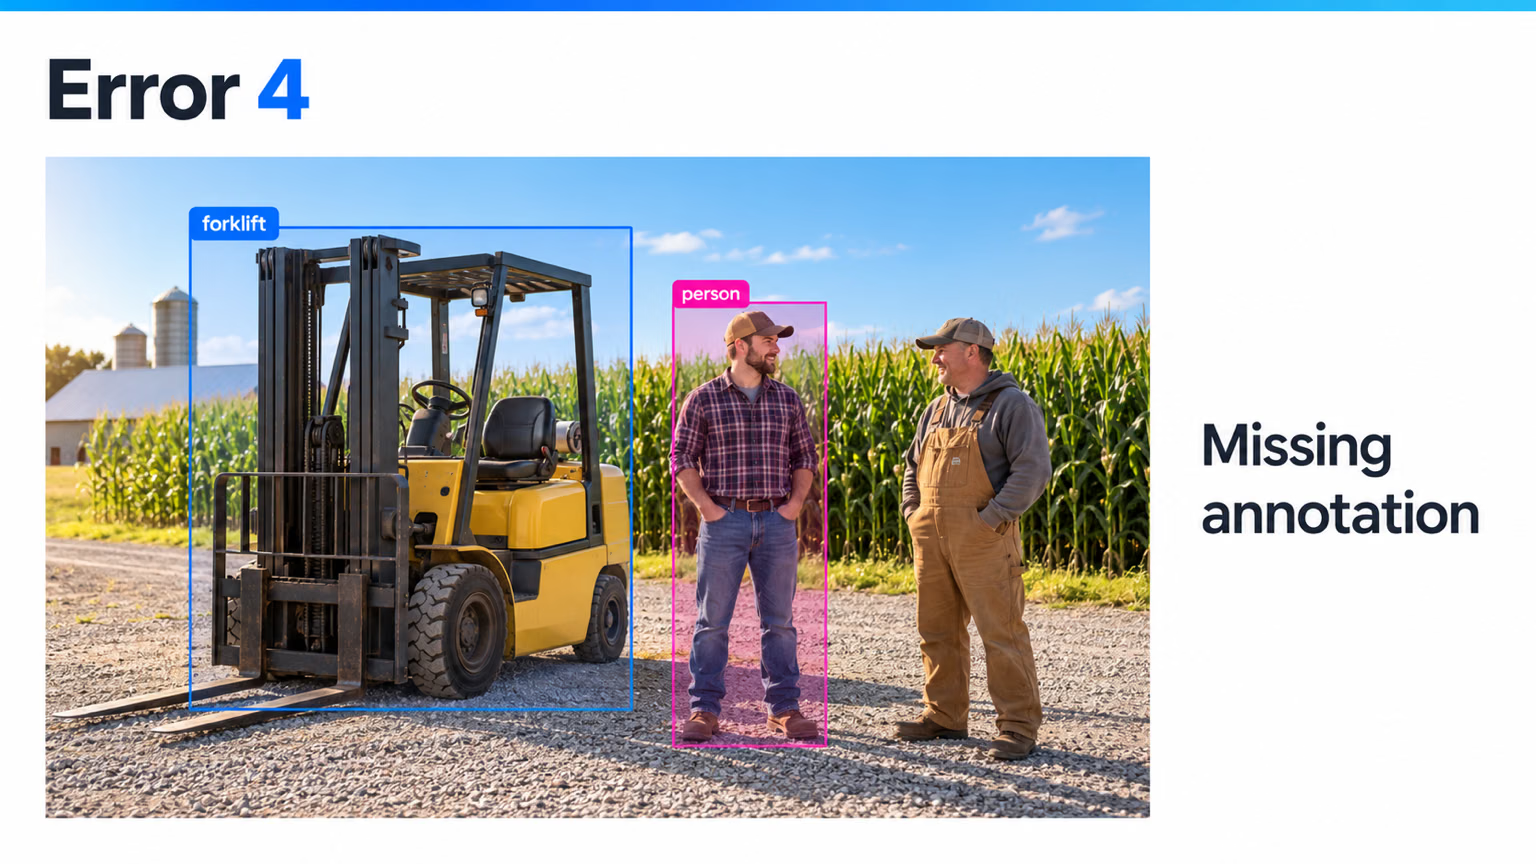
4. 漏标。两个人站在叉车旁边,但只有一个人被框出。未标注的那个人会让模型学到“人属于背景”。
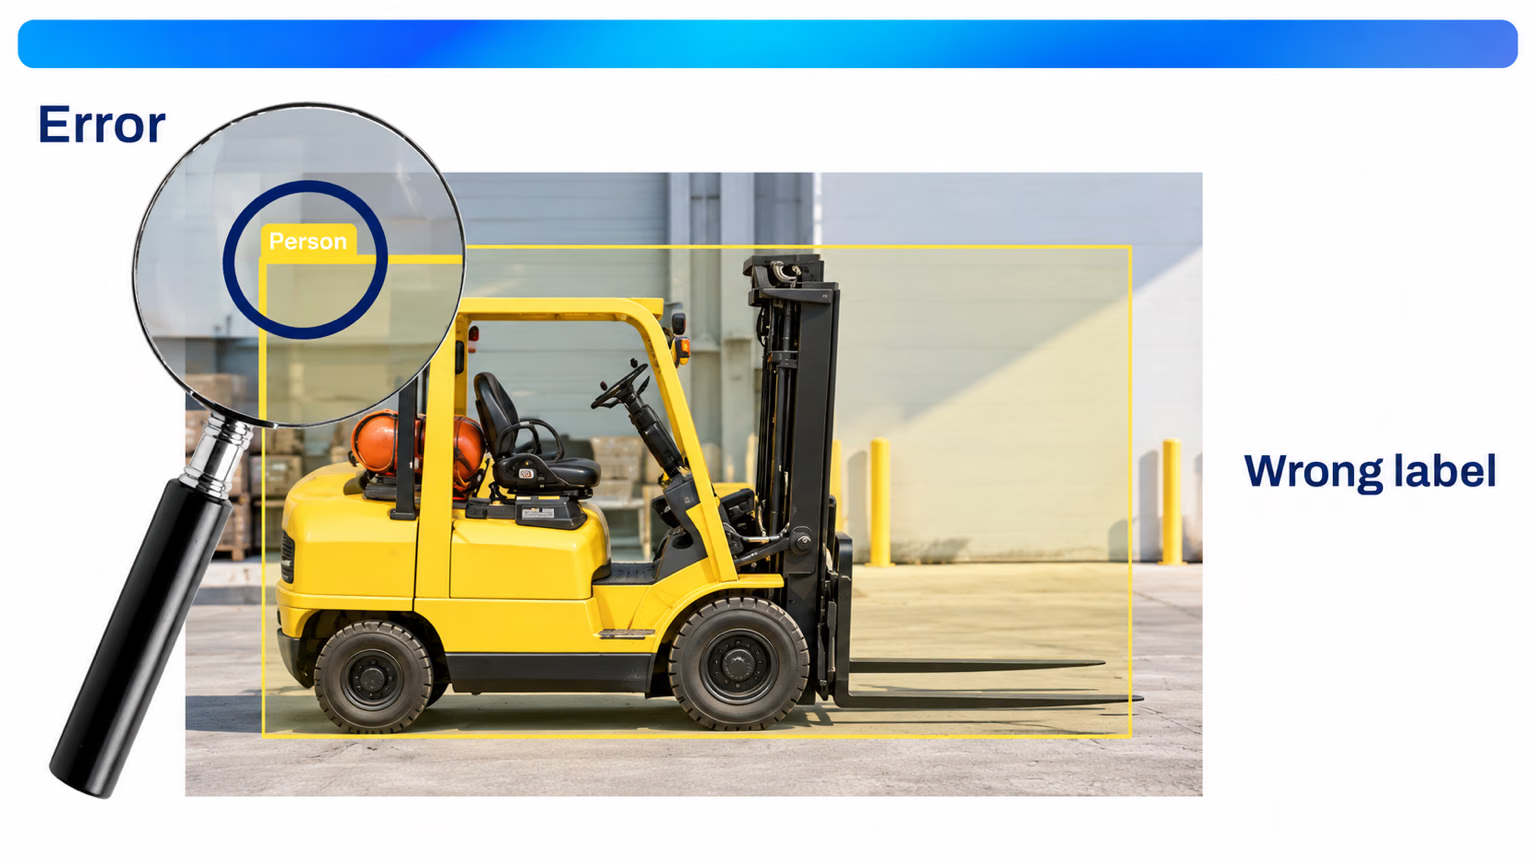
5. 类别错误。 检查类别,而不只是边界框。叉车的边界框画得正确,却被标记为 person,会同时污染两个类别;这通常是误按了键盘快捷键。
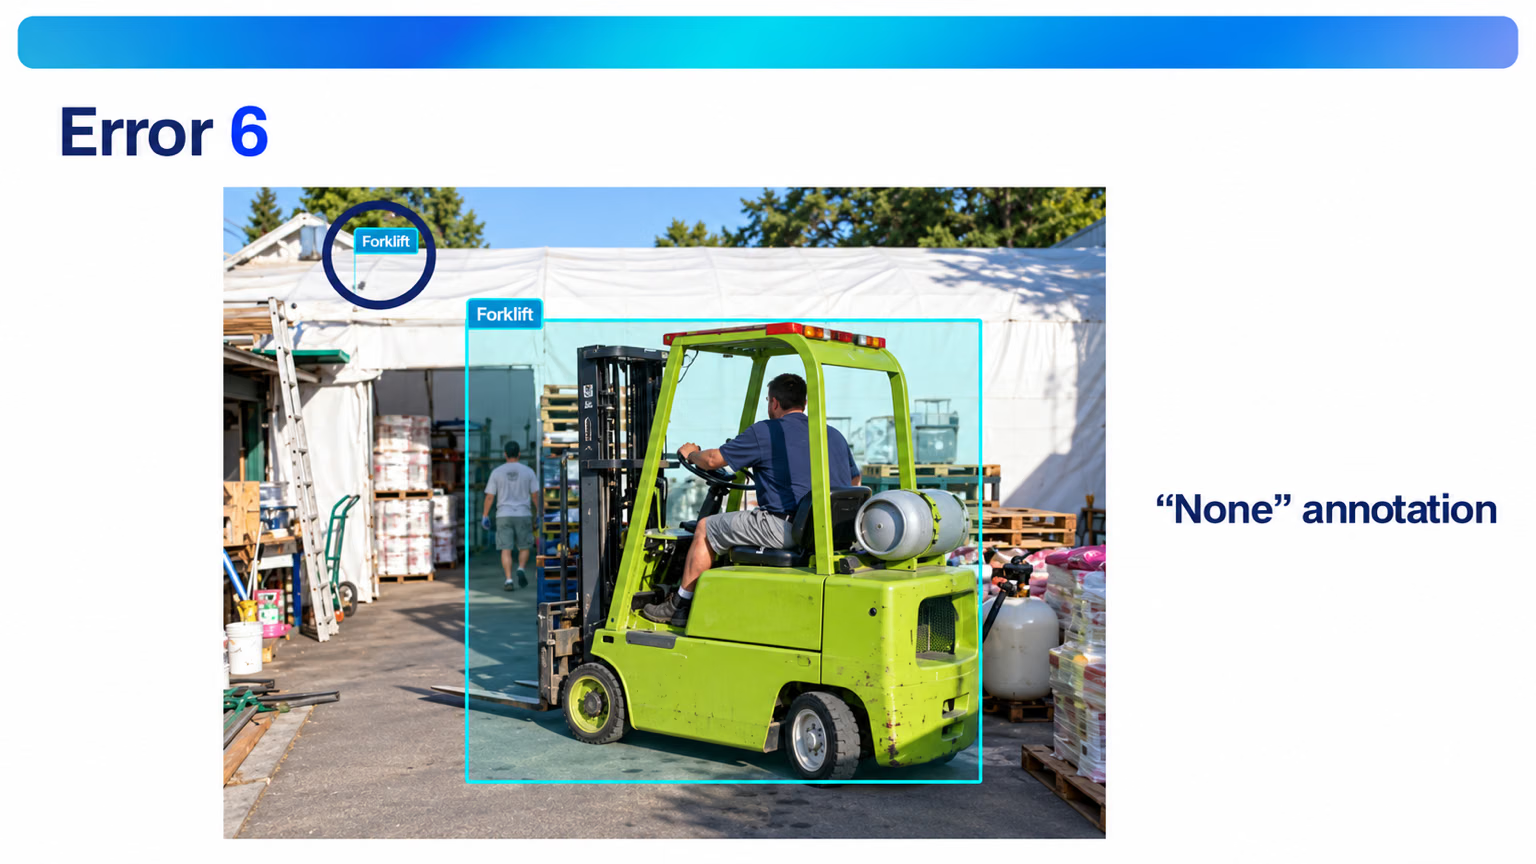
6. 空标注或多余标注。 每个标注都必须对应真实物体和真实类别。误点会留下一个几乎为空的边界框,就像这里角落里的那个;未指定类别就保存的边界框,导出时可能会被标记为 None 或类别 0。请修正或删除这些标注。
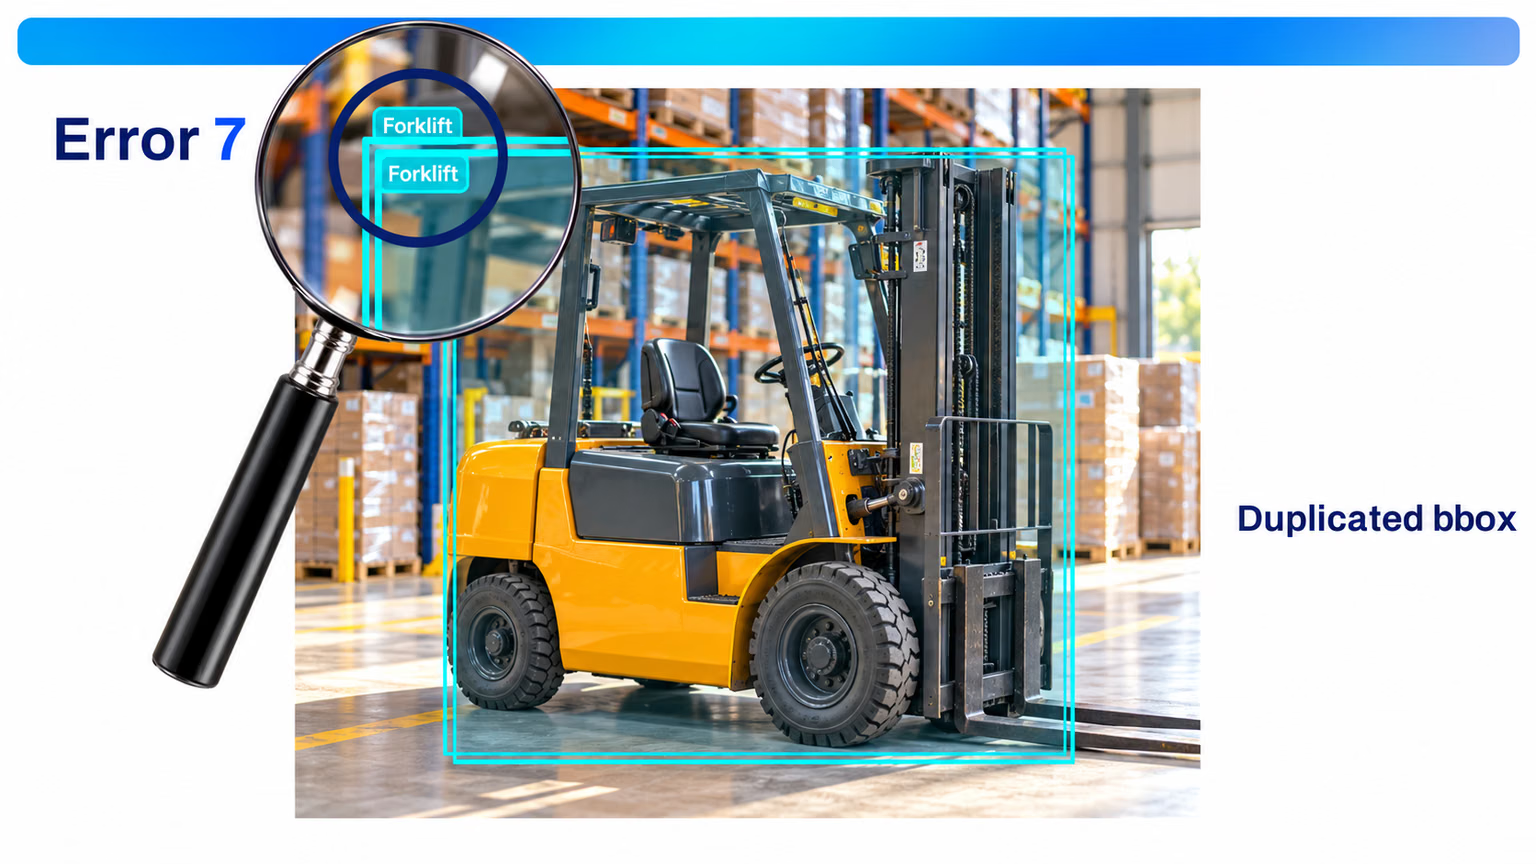
7. 边界框重复。 一个物体,一个边界框。同一辆叉车上有两个重叠的边界框,会虚增实例数量,还会让模型学会预测重复目标。
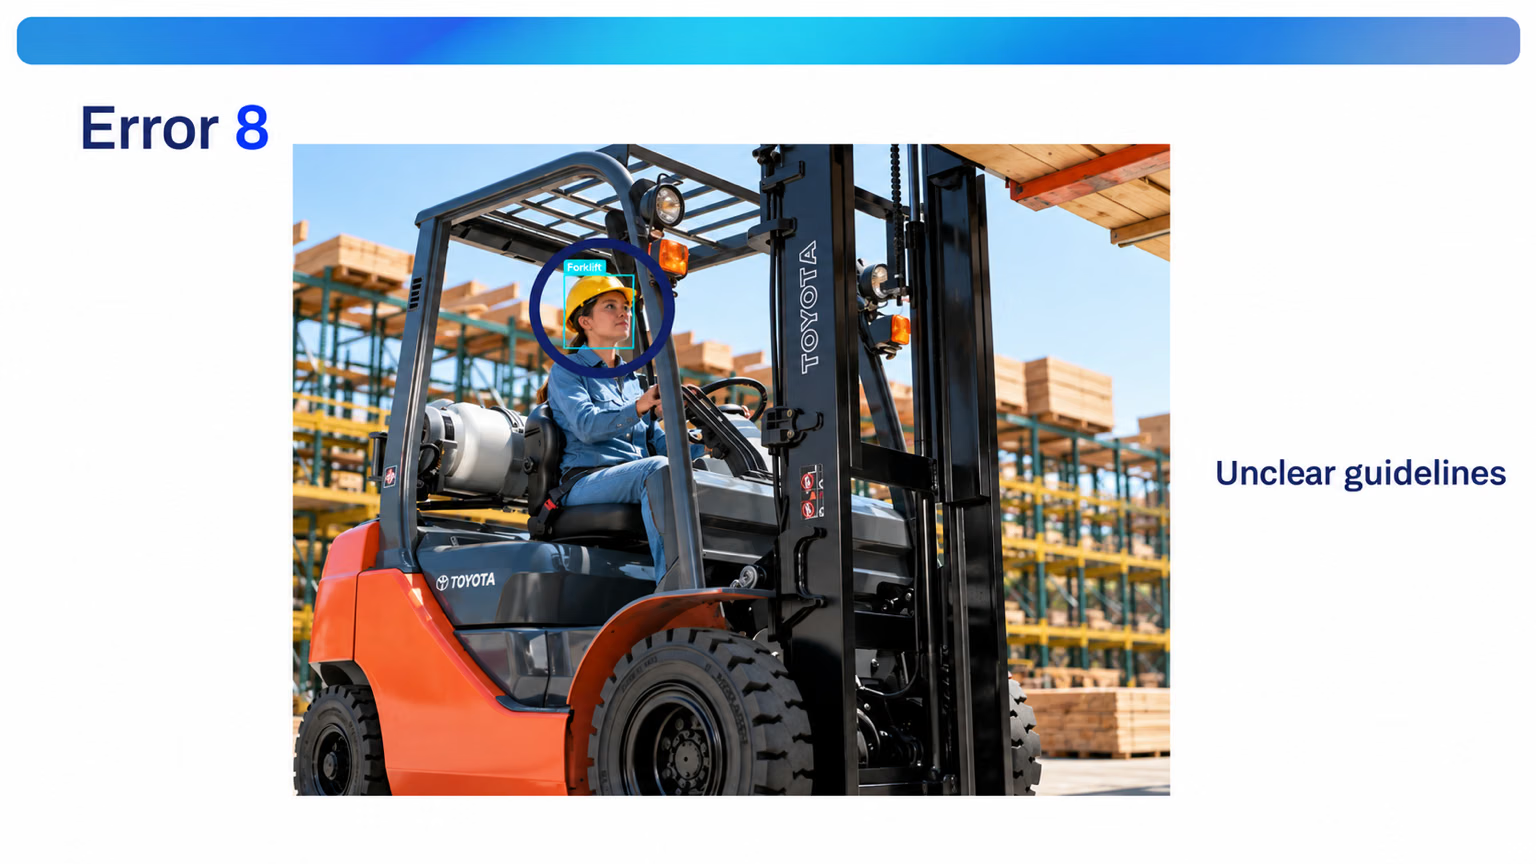
8. 指南不明确。 没有书面规则,标注人员就会自行判断:这里有个人只框出了司机的头部,并将其标记为 forklift。司机是叉车的一部分,还是单独的 person?在指南中明确说明一次。
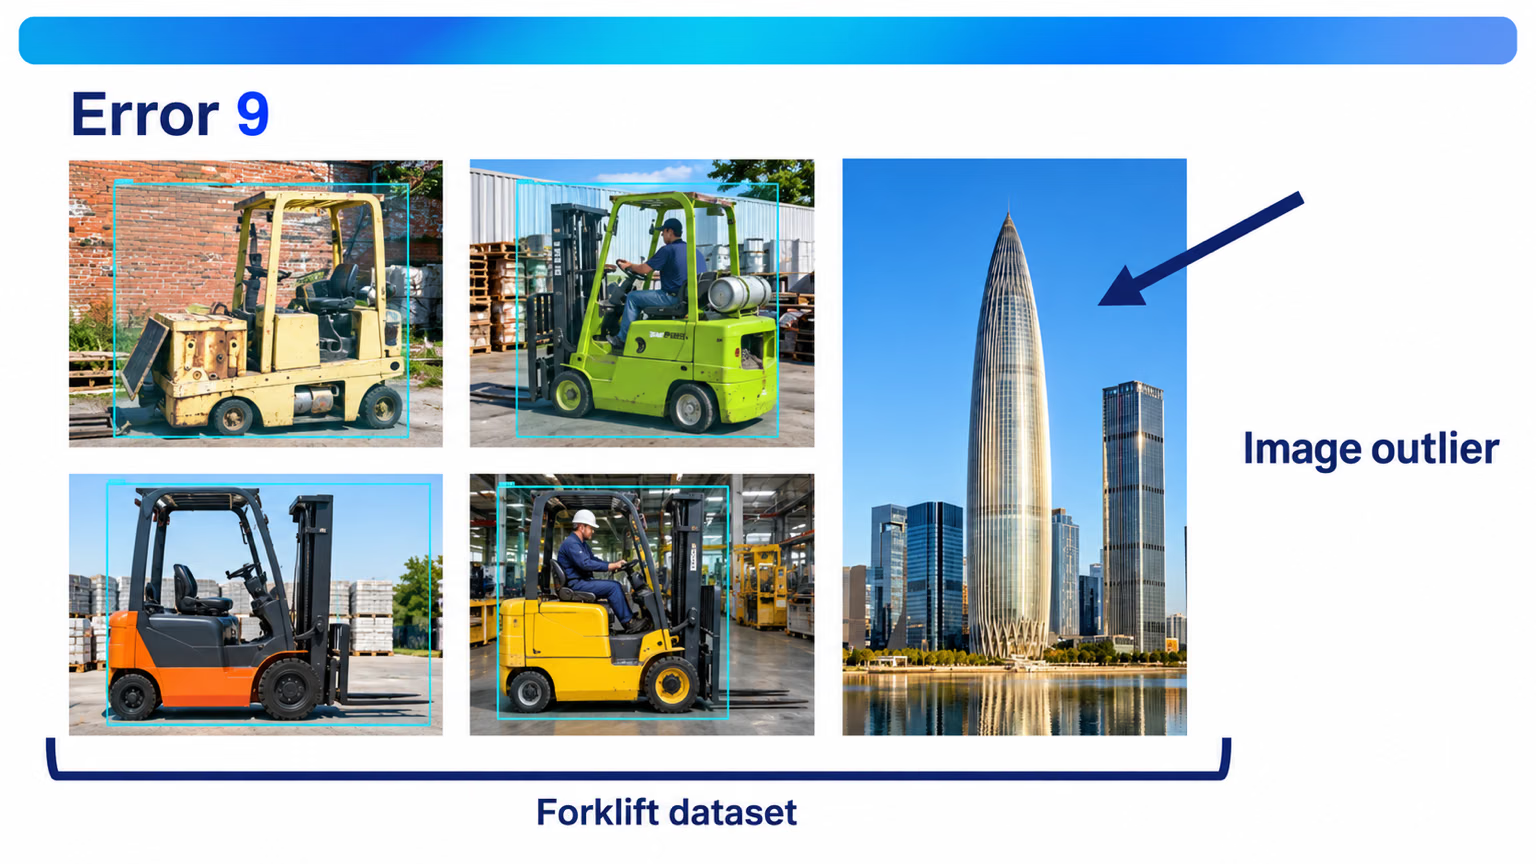
9. 离群图像。 删除与部署场景不符的图像。叉车数据集中混入一张城市天际线照片毫无用处,还会稀释其他数据的价值。
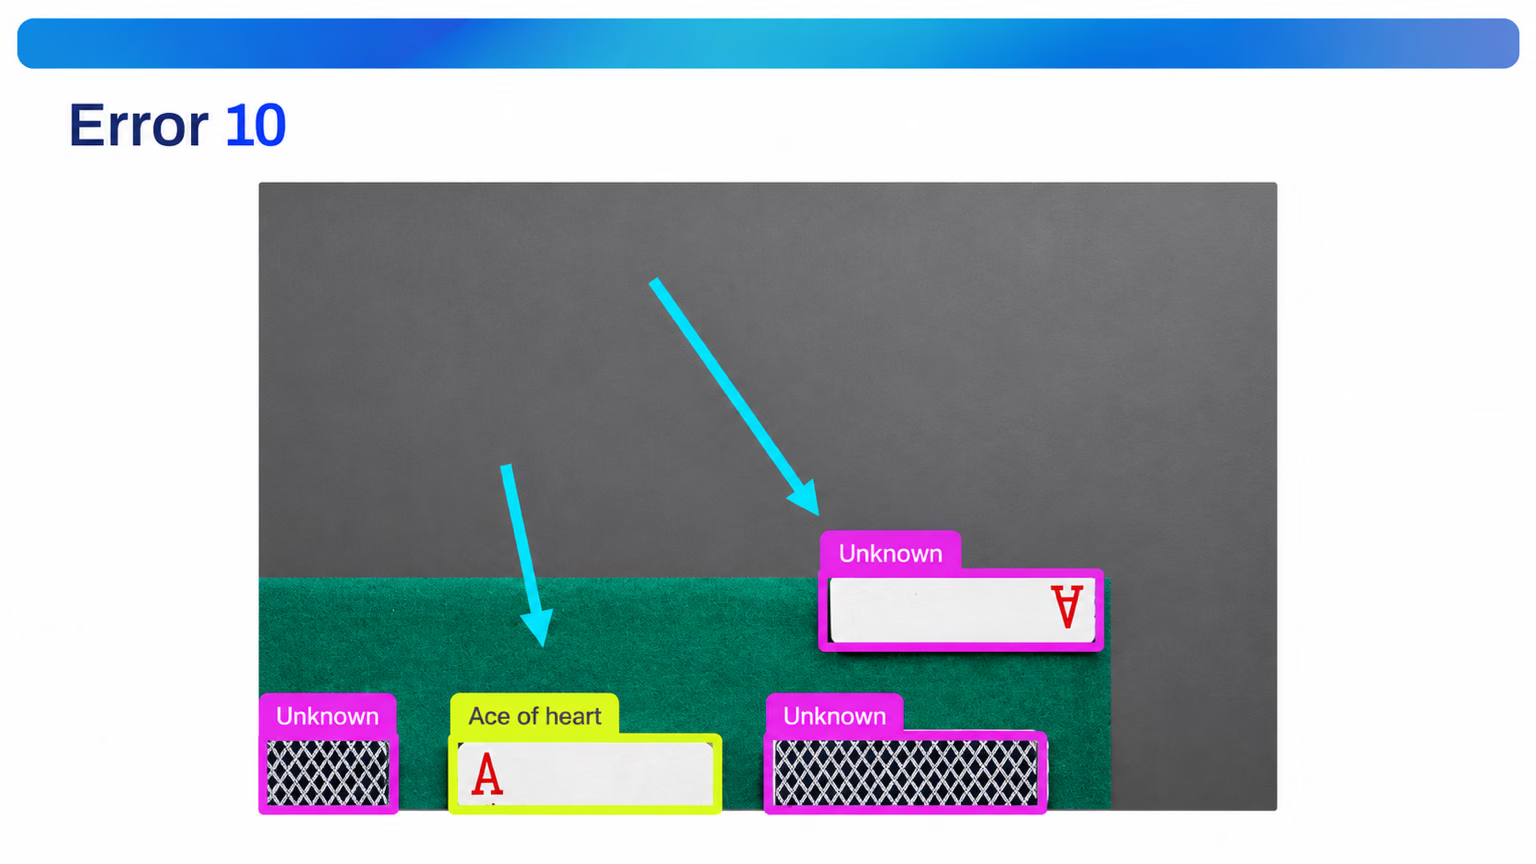
10. 增强导致的歧义。 裁剪可能会去掉定义类别的特征,导致两个类别变得无法区分。把红桃 A 的角标裁掉后,它看起来就像标记为 unknown 的牌。谨慎使用数据增强介绍了修正方法。
衡量一致性,不要靠猜#
校准轮次会让两位标注人员处理相同的图像,并逐个比较他们的标注。两个标注类别相同且重叠率至少达到 0.5 的 IoU 时,才算一致。此脚本会在 COCO8 的 val 图像上计算分数。为了无需第二个人也能运行脚本,我们让一个预训练模型担任标注人员 B;如果你有真实团队,则从 B 的标签文件中读取边界框:
from pathlib import Path

import torch

from ultralytics import YOLO
from ultralytics.data.utils import check_det_dataset, img2label_paths
from ultralytics.utils.metrics import box_iou
from ultralytics.utils.ops import xywh2xyxy

data = check_det_dataset("coco8.yaml")
model = YOLO("yolo26n.pt")  # stands in for a second annotator; compare two label folders the same way
names = data["names"]

matched = total = 0
for image in sorted(Path(data["val"]).glob("*.jpg")):
    rows = [r.split() for r in Path(img2label_paths([str(image)])[0]).read_text().splitlines() if r.strip()]
    a_cls = torch.tensor([int(r[0]) for r in rows])  # annotator A: the dataset labels
    a_box = xywh2xyxy(torch.tensor([[float(v) for v in r[1:]] for r in rows]))
    b = model(image, conf=0.5, verbose=False)[0].boxes  # annotator B: confident model proposals
    iou = box_iou(a_box, b.xyxyn)
    used = set()
    for i in range(len(rows)):  # pair each A object with the best unused same-class B box at IoU >= 0.5
        ok = [j for j in range(len(b)) if j not in used and b.cls[j] == a_cls[i] and iou[i, j] >= 0.5]
        if ok:
            used.add(max(ok, key=lambda j: iou[i, j]))
        else:
            print(f"{image.name}: {names[int(a_cls[i])]} labeled by A only")
    for j in set(range(len(b))) - used:
        print(f"{image.name}: {names[int(b.cls[j])]} labeled by B only")
    matched += len(used)
    total += len(rows) + len(b) - len(used)

print(f"agreement: {matched}/{total} objects = {matched / total:.0%}")
000000000049.jpg: person labeled by A only
000000000049.jpg: person labeled by A only
000000000049.jpg: potted plant labeled by A only
000000000049.jpg: person labeled by A only
000000000049.jpg: person labeled by A only
000000000049.jpg: person labeled by A only
000000000061.jpg: person labeled by A only
000000000061.jpg: elephant labeled by A only
000000000061.jpg: person labeled by A only
agreement: 8/17 objects = 47%如何解读:
- 分数是匹配的物体数除以任一标注人员绘制的物体总数:17 个中匹配了 8 个。
- 分歧集中在少数地方。 9 个分歧都出现在两张图像中,而且大多数是占画面不到 1% 的人物。这不是 9 个随机错误,而是缺少一条规则:远处的人物要不要标注?
- 解决办法是添加一条指南规则,例如“在 640 像素图像中,标注所有高度至少为 10 像素的人物”。两位标注人员重新标注这两张图像,然后再次测量分数。
决策规则:只有一致性达到 90% 才扩大标注规模。 低于这个比例时,每增加一位标注人员都会加剧不一致。
用智能标注加快进度#
智能标注可以让 YOLO 模型或 SAM 提出标签,再由人工接受或修正,从而将吞吐量提高数倍。分轮次启动:先用审核过的一批数据训练,再用该模型为下一批数据提出标签,审核后重新训练。这就是主动学习循环;智能标注和批量标注会在 Ultralytics Platform 上演示整个流程。
漏掉小目标人物的模型不会为这些人物生成边界框建议,而点击“全部接受”的审核人员也不会补上这些人物。下一个基于这些标签训练的模型会更加确信地漏检他们。请审核每张图像,既要补上模型漏掉的目标,也要修正模型画错的内容。
亲自检查#
每次 Ultralytics 训练都会在运行文件夹中生成 labels.jpg 和 train_batch*.jpg。第一个文件会绘制类别数量以及边界框的位置和尺寸;其他文件会显示绘有标签的真实训练图像。首个 epoch 结束前就打开这些文件。人的眼睛能发现指标永远发现不了的问题:画在阴影上的边界框、互换的类别 ID,以及没有闭合的多边形。
显示解答
COCO8 中的分歧可以转化为这样的指南条目:
| 分歧 | 添加到指南中的规则 |
|---|---|
A 在 000000000049.jpg 中标注了远处的人物,B 没有标注 | 在 640 像素图像中,标注所有高度至少为 10 像素的人物;每张图像中都跳过更小的人物。 |
| A 标注了画面边缘的盆栽,B 没有标注 | 如果物体至少有一半可见,就标注被画面边缘裁切的物体。 |
000000000061.jpg 中有一头大象被另一头大象部分遮挡 | 如果动物的头部或半个身体可见,就标注被遮挡的动物;只框出可见部分。 |
要比较两个人而不是一个人和一个模型,请从第二个标签文件夹读取标注人员 B 的行,方法与脚本读取 A 的行完全相同(Path("labels_b", image.stem + ".txt"));用同样的两行代码从这些行构建 b_cls 和 b_box,并在脚本读取 b.cls 和 b.xyxyn 的位置使用它们。重新标注后再次运行;分数超过 90% 就完成这一轮。