从业务目标开始
在采集任何图像之前,将业务目标转化为视觉任务、明确的类别,以及可通过代码运行的验收测试。
仓库团队拍了整整一个月的照片,之后才发现安全主管只关心移动叉车附近的人,结果一半标签都得重做。在拍第一张照片之前,先共同确认一页纸的目标,就能避免这种情况。这只需一个下午,却能决定本课程后续的每一项选择:采集什么、标注什么,以及模型达到什么水平才足以投入使用。
实践操作
一页纸的目标#

五行内容回答了后续每一步都依赖的问题。定义项目目标指南会更深入地讲解同样的内容。下面是一个已填写的仓库示例,本课程将以此为基础:
| 项目 | 回答的问题 | 仓库示例 |
|---|---|---|
| 业务目标 | 业务会发生什么变化?何时实现? | 在六个月内将装卸门附近的险些碰撞事故减少 30%。 |
| 视觉任务 | 模型会输出什么? | 目标检测:为叉车和人员绘制边界框。 |
| 类别 | 具体要给什么标注? | forklift、person、pallet;其他所有内容都属于背景。 |
| 验收测试 | 达到什么数值才算“可以发布”? | 在未用于训练的摄像头拍摄的 500 帧上,person 的召回率 ≥ 0.95,且精确率 ≥ 0.85。 |
| 范围之外 | v1 不承诺处理什么情况? | 漆黑的装卸区、被货架完全遮挡的人,以及手动托盘搬运车。 |
把这页内容放在整个团队都能看到的地方。如果之后有利益相关者对某一行内容提出异议,先修改这页,再调整数据集。
选择能回答问题的最简单任务#
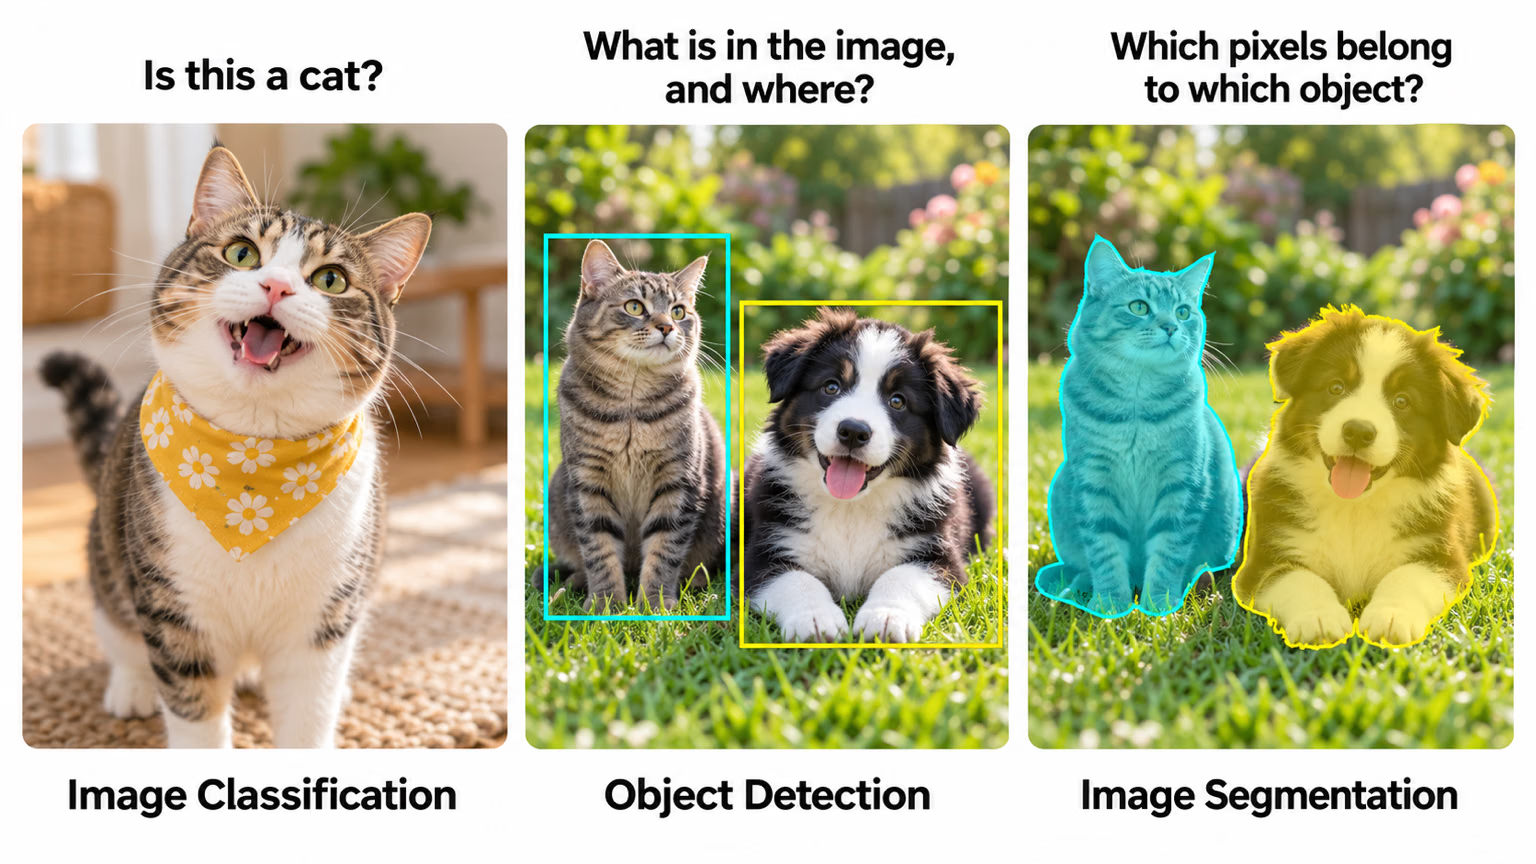
任务决定标注员要画什么,而这会决定大部分标注预算。沿着这棵决策树往下判断,在第一个能回答业务问题的任务处停下:
Ultralytics YOLO 支持七种任务。在规划数据集时,关键在于每种任务的标注成本;计算机视觉基础在其视觉任务课程中对此进行了深入比较。
| 任务 | 标注员需要产出什么 | 标注工作量 | 适用情况 |
|---|---|---|---|
| 分类 | 每张图像一个标签 | 最低 | 每张图像只需一个答案 |
| 检测 | 每个物体一个类别和一个轴对齐边界框 | 低 | 需要对物体计数或定位 |
| OBB | 每个物体一个类别和一个旋转框 | 中 | 物体细长,或从上方观察 |
| 姿态 | 每个物体一个类别和一组命名关键点 | 高 | 关节或部件的位置很重要 |
| 实例分割 | 每个对象对应一个类别和一个多边形 | 高 | 每个对象的轮廓都很重要 |
| 语义分割 | 为每个像素分配一个类别 | 最高 | 你需要的是区域,而不是可计数的对象 |
| 深度估计 | 不绘制任何内容:每张图像对应一张深度图,通常由深度传感器生成 | 取决于采集硬件 | 你需要每个像素的距离 |
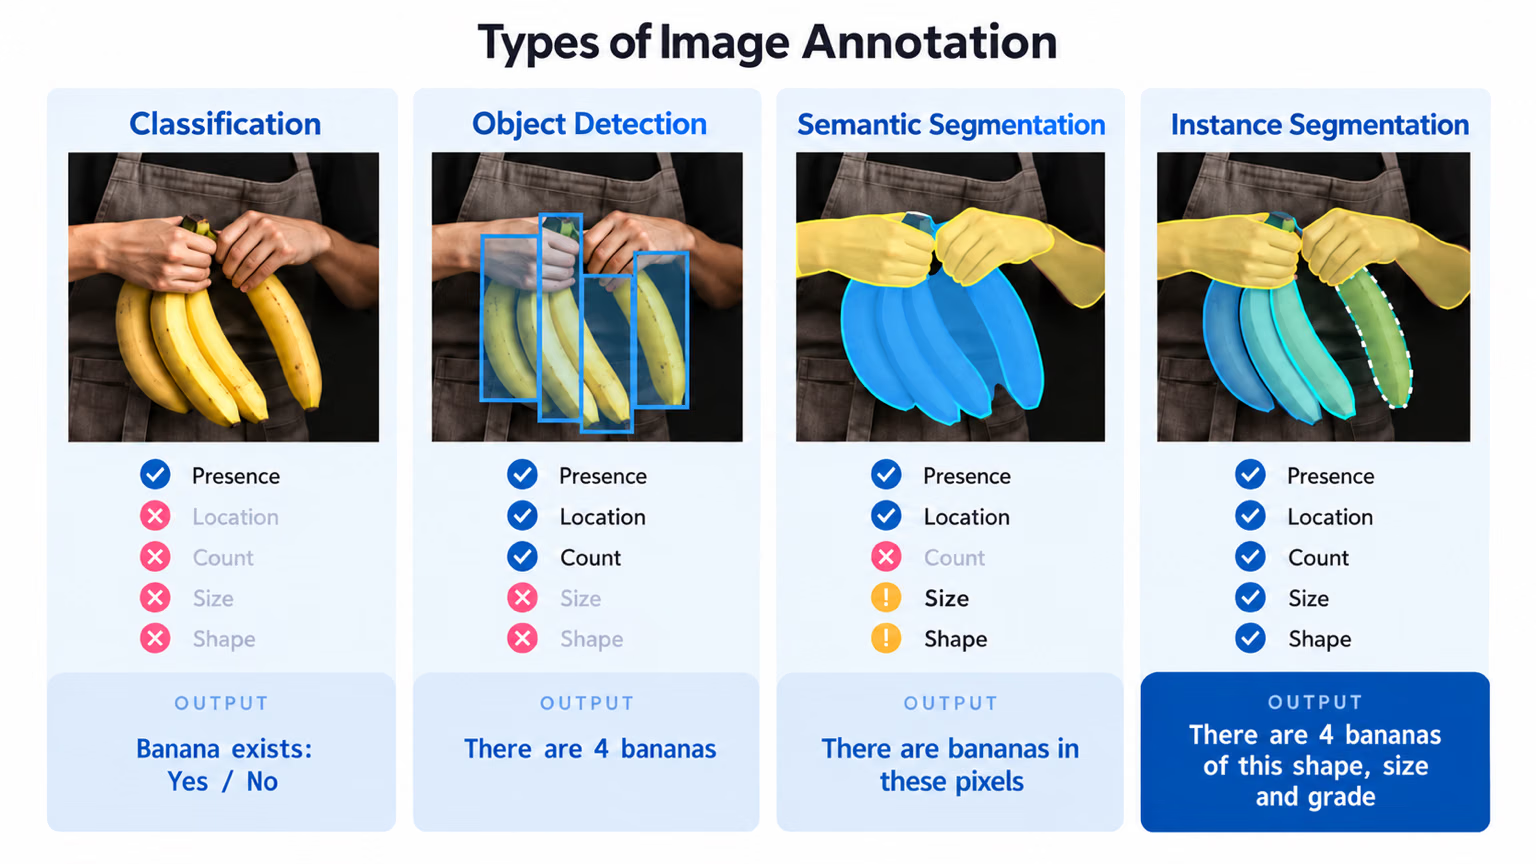
把香蕉示意图当作价目表来看:检测已经能回答是否存在、位于何处以及有多少个,只有两个分割面板能提供大小和形状信息,但标注成本要高得多。如果业务只需要知道“有多少根香蕉”,检测就是合适的选择,使用多边形只会浪费预算。
团队常常因为分割看起来更精确而选择它,结果在数据集覆盖夜班、雨天或第二个站点之前,就用完了标注预算。每个物体的多边形标注成本是边界框的好几倍。只有当目标中的某一项确实需要轮廓本身时才选择分割,例如测量面积或裁剪掩码。
编写标注人员能一致应用的类别定义#
只有当两名标注人员会把同一个对象标为同一类别时,这个类别才有用。为每个类别写一句定义,并指出一个容易混淆但不属于该类别的对象:
forklift:动力叉车,包括货叉和门架。不包括手动托盘车。person:任何人类,包括部分可见、坐着或位于车辆驾驶室内的人。不包括倒影和海报上的人物。pallet:木质或塑料运输托盘,无论是否装载货物。不包括没有托盘底座的堆叠货箱。
然后有意识地选择类别粒度。粗粒度类别(“车辆”)成本更低,收敛也更快;细粒度类别(“轿车”“皮卡”)对下游任务更有用,但更难保持标注一致。先从业务需求出发。之后只需一行代码,就能把细粒度标签合并为粗粒度标签;但粗粒度标签无法拆分,除非重新标注。
“任何看起来危险的东西”或“堵住通道的东西”都不是类别定义。这会要求每位标注人员自行判断,而基于不一致判断训练的模型也会学到这种不一致。修改模糊类别的定义,直到新标注人员仅凭定义就能应用;或者把它改成检测后的规则(例如“通道多边形内的任何 pallet”)。
把指标转化为可执行的验收测试#
选择与错误代价相匹配的指标:
- 漏检代价高(安全、缺陷):针对该类别以召回率作为门槛。
- 误报代价高(自动拒收零件、向员工发送警报):以精确率作为门槛。
- 每个类别同等重要(计数、库存):以各类别的 AP 作为门槛,避免某个类别被平均值掩盖。
YOLO 性能指标指南介绍了各项指标。然后把测试写成代码,让“够不够好?”不再成为争论。这个脚本现在可以用预训练模型在 COCO8 演示数据集上运行,之后也可以使用你自己的检查点和留出集:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")  # later: your fine-tuned runs/detect/train/weights/best.pt
metrics = model.val(data="coco8.yaml", classes=[0], verbose=False)  # 0 = person; later: your holdout YAML

precision, recall = metrics.box.mp, metrics.box.mr
print(f"person: precision={precision:.2f} recall={recall:.2f}")
print("PASS" if recall >= 0.95 and precision >= 0.85 else "FAIL: below the acceptance test")
all 4 10 0.939 0.8 0.848 0.387
person: precision=0.94 recall=0.80
FAIL: below the acceptance test每一行的含义:
classes=[0]只对person进行评分,因此其他类别无法抬高结果。请使用你自己的安全类别 ID。- 验证器输出行显示了 4 张图像和 10 个已标注的人。
mp和mr分别是精确率和召回率,计算时采用了能最好地平衡二者的置信度阈值(F1 最大值)。 - 预训练的 COCO 模型找到了 10 个人中的 8 个,因此召回率为 0.80:虽然精确,但还不够安全。这个 FAIL 正说明测试发挥了作用。在本课程中,FAIL 应促使你回头检查数据,而不是调整超参数。
如果测试集来自与训练集相同的摄像头和日期,它衡量的是记忆能力,而不是就绪程度。在目标中明确留出集的范围(“训练中未使用的摄像头”“最后两周的录像”),并参照正确划分数据集来构建它。
写明 v1 不会处理什么#
没有完美的模型,所以要事先列出可接受的漏检情况:你不会承诺能处理的条件(浓雾、完全黑暗)、你能接受被混淆的相似对象,以及推迟到 v2 的长尾类别。这一行可以避免模型达到目标后仍被拿一条未写明的 100% 标准来评判,同时也能告诉数据采集团队目前哪些方面不必投入精力。
显示解答
以下是另一个项目的目标示例:一家杂货连锁店要检测空货架位置。
| 项目 | 答案 |
|---|---|
| 业务目标 | 在一个季度内,将销量最高的 200 种商品的缺货时长减少 25%。 |
| 视觉任务 | 检测。商店需要知道每个空位的位置,而不是它的轮廓,因此边界框比多边形合适。 |
| 类别 | gap:至少有一个商品宽度的空货架位;不包括被顾客或购物车挡住的货架位。price_tag:货架边缘标签;不包括促销贴纸。 |
| 验收测试 | 在未用于训练、来自 5 家门店的 400 张图像上,gap 的召回率 ≥ 0.90,且精确率 ≥ 0.80。 |
| 范围之外 | 有眩光的冷冻柜门、端架陈列区、农产品区。 |
召回率优先,因为漏掉一个空位会损失一笔销售,而误报只会让员工多走一小段路。acceptance_test.py 只需改动三个地方:data="holdout_stores.yaml"(五家未见过的门店)、classes=[0](0 现在是 gap),以及阈值 recall >= 0.90 and precision >= 0.80。