监控运行状况与准确率
查看 Platform 的端点指标和预测统计信息,通过定时运行状况检查触发告警,并用留出集作业发现准确率漂移。
即使端点每次请求都返回 200 OK,夜班调暗灯光也可能导致准确率下降 5 个百分点。Platform 会显示每个端点的运行情况,但不会通知任何人;没有标签时,也无法查看准确率。本课将构建两项定时检查来弥补这一缺口,并通过模拟夜班演练准确率告警。
实践操作
Platform 会显示什么#

| 信号 | 位置 | 保留时长 |
|---|---|---|
| HTTP 请求数、错误率(4xx 和 5xx)、P95 延迟 | 部署页面和 Deployments 选项卡中的卡片,每分钟刷新一次 | 卡片显示 24 小时的数据;API 可提供 1 小时至 30 天的数据 |
| 运行状况 | Overview 选项卡中的 Endpoint 卡片 | 实时显示;运行状况不佳时会自动重试 |
| 日志 | Logs 选项卡:最近 20 条,可使用 Errors 筛选 | API 每次请求最多返回 200 条记录,并支持分页 |
| 预测统计信息和临时示例(最多 100 张图像) | Monitoring 选项卡 | 仅存储在服务实例内存中 |
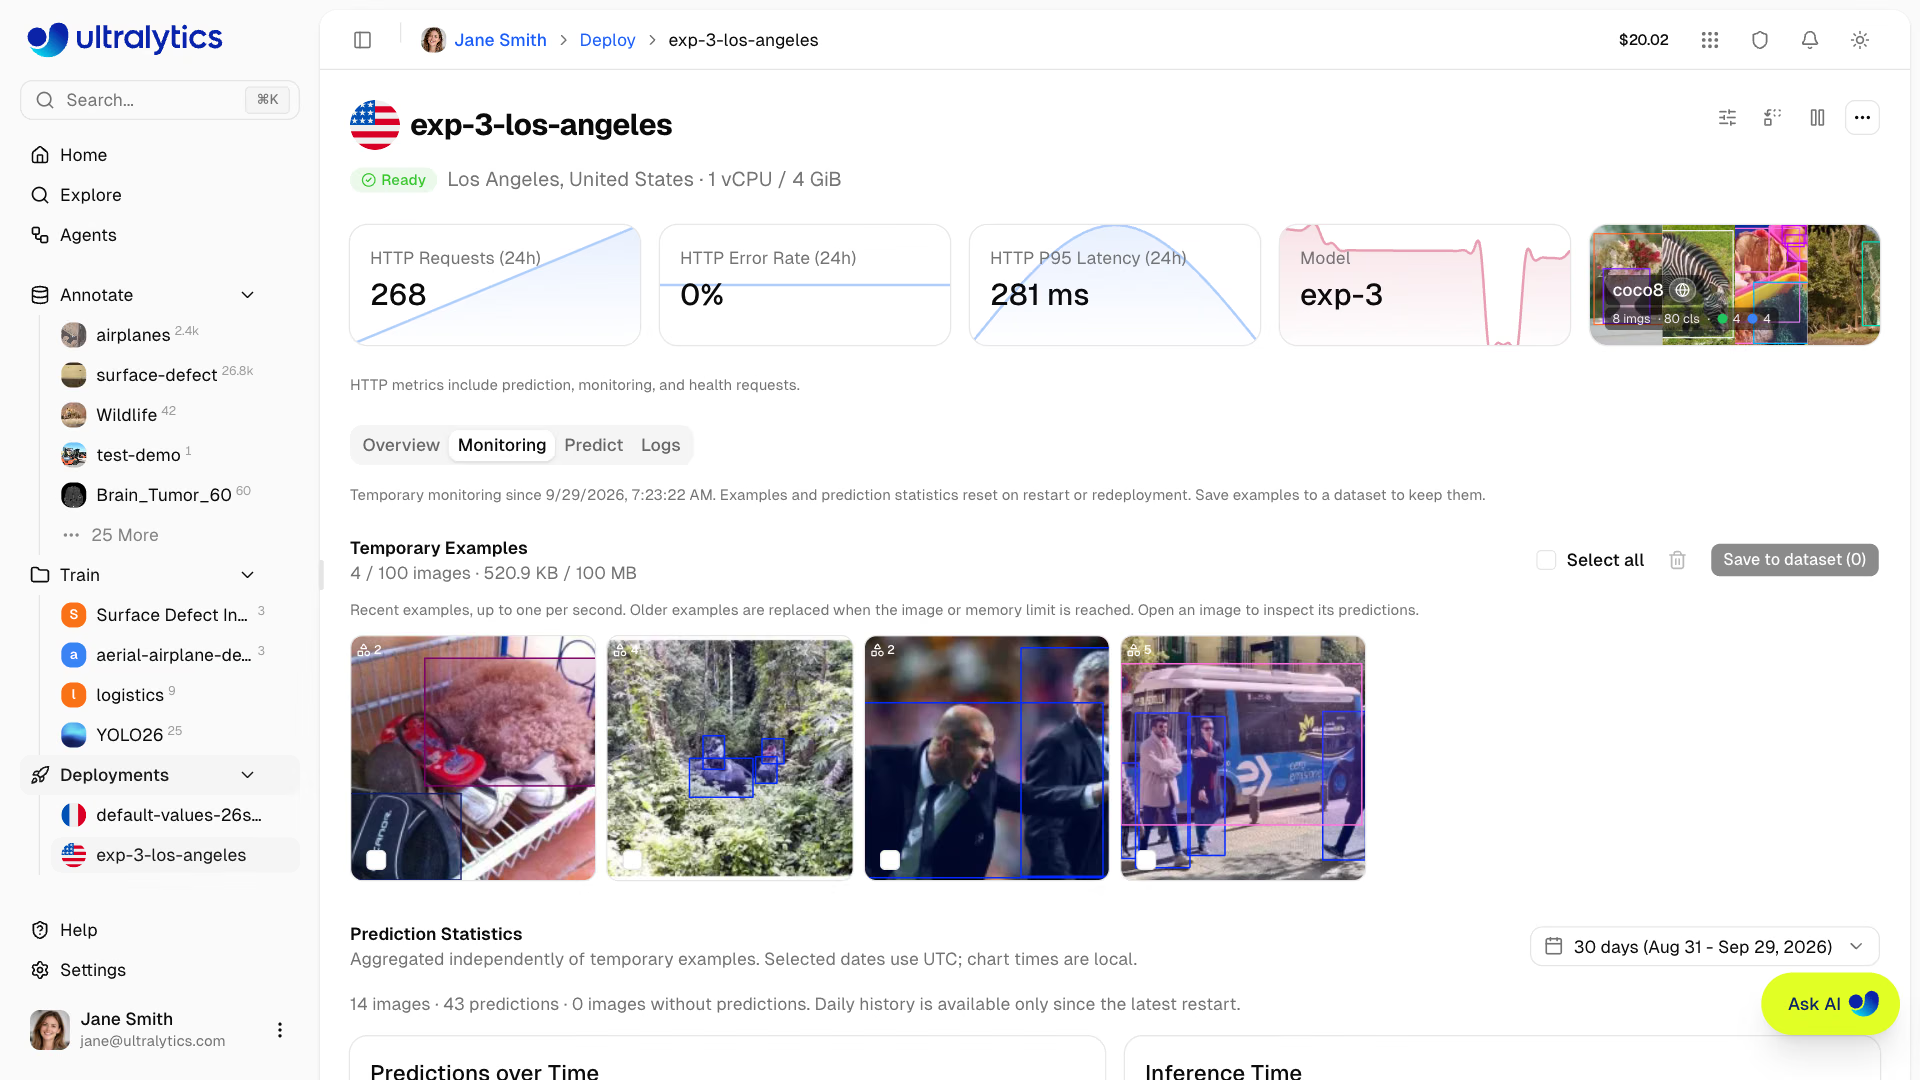
有两点需要注意,它们会影响其他所有内容。只有端点处于 Ready 状态时才会收集指标;删除部署后,历史记录也将无法访问。每当端点停止、重启、调整规格或替换模型时,Monitoring 选项卡中的统计信息和示例都会丢失:它们只是实时视图,并非存档。
实战示例:定时检查端点#
Platform 会在错误率超过 5% 时将错误率卡片标红;部署就绪或启动失败时,Slack 可以发布通知,但 Platform 不提供阈值告警。通过 cron、CI 或监控代理每 5 分钟运行一次此检查,并在退出码非零时通知值班人员:
from ultralytics_platform import Platform

OWNER, DEPLOYMENT = "your-username", "yolo26n-iowa"  # from the deployment page URL
P95_BUDGET_MS, MAX_ERROR_RATE = 300, 1.0  # errorRate is a percentage

with Platform() as client:  # reads ULTRALYTICS_API_KEY
    health = client.deployments.health(OWNER, DEPLOYMENT)
    summary = client.deployments.metrics(OWNER, DEPLOYMENT, range="1h", view="overview")["summary"]
    print(
        f"healthy={health['healthy']} requests={summary['totalRequests']} "
        f"p95={summary['p95LatencyMs']:.0f} ms errors={summary['errorRate']:.2f}%"
    )
    if not health["healthy"] or summary["p95LatencyMs"] > P95_BUDGET_MS or summary["errorRate"] > MAX_ERROR_RATE:
        for entry in client.deployments.logs(OWNER, DEPLOYMENT, severity="ERROR,WARNING", limit=5)["entries"]:
            print(entry["timestamp"], entry["severity"], entry["message"][:120])
        raise SystemExit(1)  # non-zero exit lets cron, CI, or your pager treat it as an alert
使用返回正常端点的模拟 API 运行时,它会打印一行内容并以 0 退出;使用 P95_BUDGET_MS = 100 时,同样的数据会使其以 1 退出:
healthy=True requests=1200 p95=180 ms errors=0.40%health会对端点发送探测请求,并返回healthy、status和latencyMs。它也会唤醒已缩容至零的端点,因此每 5 分钟运行一次也相当于发送预热探测请求。metrics(..., view="overview")会返回totalRequests、errorRate(百分比)以及该时间范围对应的p95LatencyMs。logs会拉取最新的错误和警告,让告警附带第一条线索。
使用 pip install -U ultralytics-platform 安装 SDK(SDK 需要 Python 3.11+)。只对持续超出阈值的情况发出告警,例如连续三次检查失败,并为每条告警提供一行运行手册说明。
实战示例:使用留出集跟踪准确率#
请求指标无法反映准确率,但留出集可以:使用 200–500 张符合真实生产情况的图像,仔细标注,放入独立的私有数据集版本,且绝不用于训练。每周评估已部署的检查点,并将结果追加到历史记录文件:
import json
import sys
from datetime import date
from pathlib import Path

from ultralytics import YOLO

DEPLOYED = "pills-v1.pt"  # the exact best.pt behind the endpoint
HOLDOUT = sys.argv[1] if len(sys.argv) > 1 else "medical-pills.yaml"  # labeled, never trained on

metrics = YOLO(DEPLOYED).val(data=HOLDOUT, split="val", plots=False, verbose=False)
history = Path("holdout_history.jsonl")
rows = [json.loads(line) for line in history.read_text().splitlines()] if history.exists() else []
row = {"date": date.today().isoformat(), "data": HOLDOUT, "map50_95": round(float(metrics.box.map), 4)}
history.write_text("".join(json.dumps(r) + "\n" for r in [*rows, row]))

baseline = rows[0]["map50_95"] if rows else row["map50_95"]
drop = baseline - row["map50_95"]
print(f"holdout mAP50-95 {row['map50_95']:.3f} (baseline {baseline:.3f}, drop {drop:+.3f})")
if drop > 0.01:  # more than 1 mAP point below the deployment-day baseline
    raise SystemExit("ALERT: holdout accuracy regressed - open the retraining runbook")
首次运行会记录部署当天的基线。然后在真正需要告警前先演练一次:此脚本会生成一份“夜班”留出集副本,图像和标签保持不变,亮度则降低 15%:
import shutil
from pathlib import Path

import cv2

from ultralytics.data.utils import check_det_dataset

src = Path(check_det_dataset("medical-pills.yaml")["path"])
dst = Path("pills-night")
(dst / "images/val").mkdir(parents=True, exist_ok=True)
for img in (src / "images/val").glob("*.jpg"):  # darken every holdout image to mimic a dim night shift
    cv2.imwrite(str(dst / "images/val" / img.name), (cv2.imread(str(img)) * 0.15).astype("uint8"))
shutil.copytree(src / "labels/val", dst / "labels/val", dirs_exist_ok=True)  # same labels, darker pixels
Path("pills-night.yaml").write_text(f"path: {dst.resolve()}\ntrain: images/val\nval: images/val\nnames:\n  0: pill\n")
print("wrote pills-night.yaml")
$ python holdout_check.py
holdout mAP50-95 0.659 (baseline 0.659, drop +0.000)
$ python simulate_night_shift.py
wrote pills-night.yaml
$ python holdout_check.py pills-night.yaml
holdout mAP50-95 0.609 (baseline 0.659, drop +0.050)
ALERT: holdout accuracy regressed - open the retraining runbook夜班期间的每个请求仍会在几毫秒内返回 200,但模型的 mAP 却下降了 5 个百分点。只有留出集能发现这一变化。每季度使用新标注的生产图像更新留出集;每次部署新模型时都重设基线。模型监控指南和可观测性与漂移课程介绍了统计漂移检测方法。
通过 Monitoring 选项卡发现漂移#
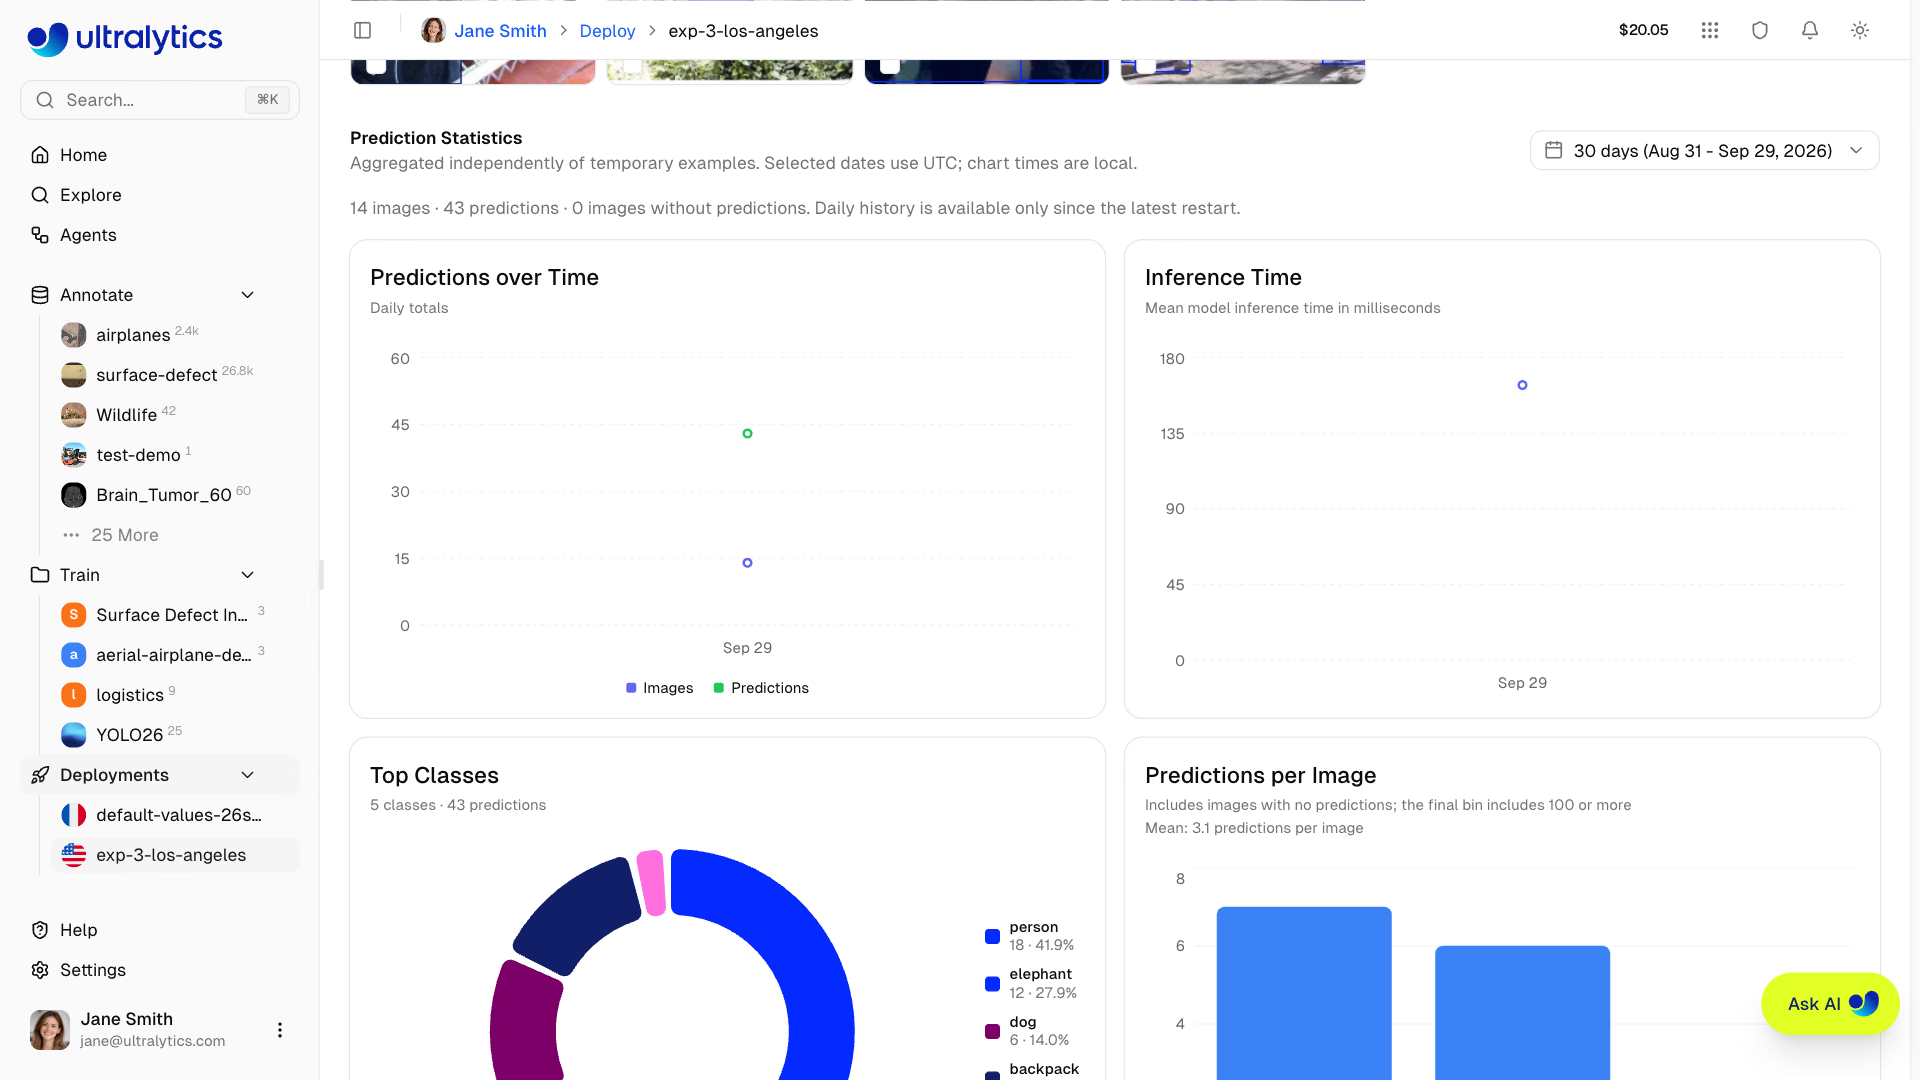
记录部署当周图表的走势,然后进行比较。置信度衡量的是确定程度,而非正确性,因此要结合留出集一起查看:
| 模式 | 可能原因 | 操作 |
|---|---|---|
| 置信度下降,留出集表现稳定 | 无害的域偏移 | 持续观察;将示例保存到下一个数据集版本 |
| 置信度和留出集表现均下降 | 实际准确率回退 | 重新训练(第 10 课) |
| 边界框尺寸或位置突然变化 | 摄像头移动、镜头或现场发生变化 | 先检查摄像头,再调整模型 |
| 每张图像的预测数减少,置信度保持稳定 | 摄像头离线、场景变得不那么复杂,或客户端出现错误 | 排查上游问题 |
| P95 延迟上升,推理时间持平 | 请求处理、负载大小或容量问题 | 基础设施问题,而非模型问题 |
将生产图像反馈回数据集#
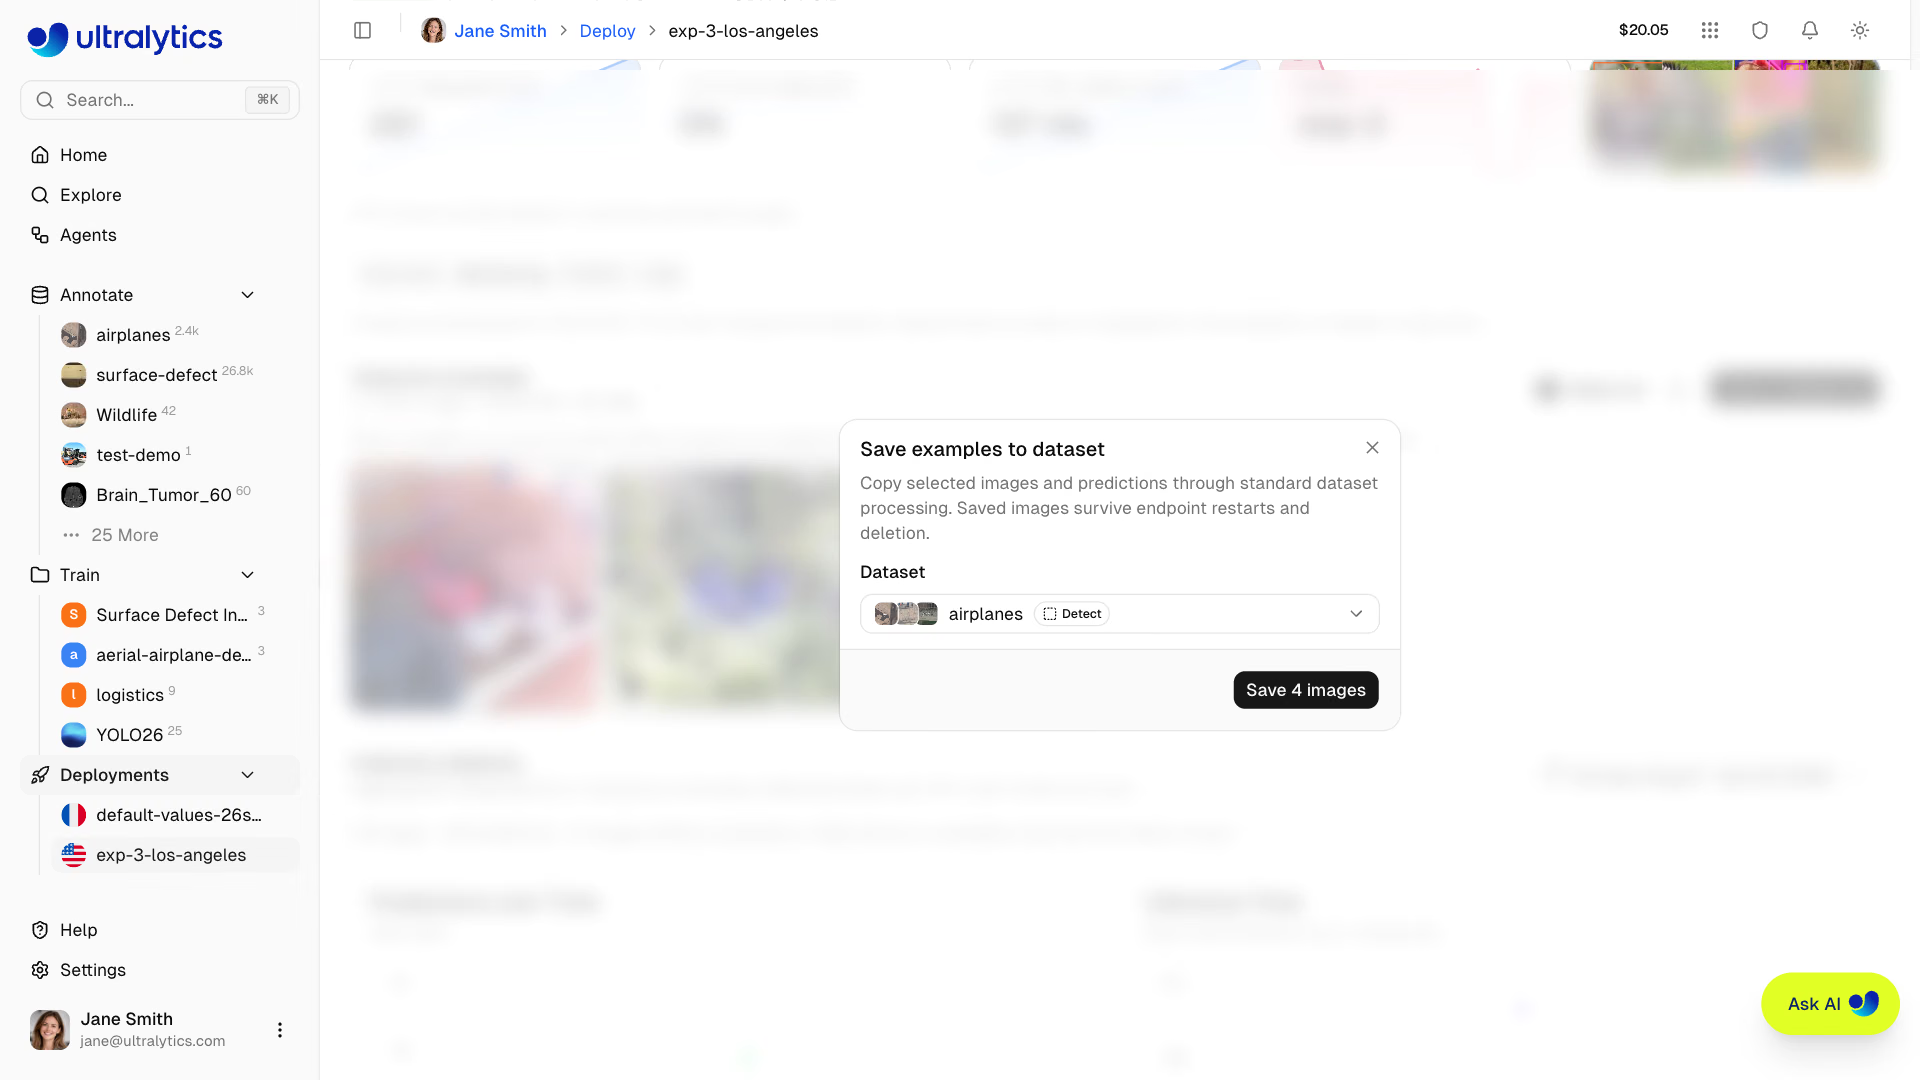
在 Monitoring 选项卡中选择示例并点击 Save to dataset;这些示例会经过常规导入流程,并连同预测结果一起保存,其元数据中还会保留 deploymentId 和区域信息。Agents 中的 Collect Uncertain Detections 模板也能对整个数据集执行相同操作:通过你的部署进行预测,并将置信度处于指定范围内的检测结果对应图像复制到审核数据集中。
常见问题#
症状:调整尺寸或更换模型后,你打算标注的示例消失了。解决方法:这些示例存放在服务实例的内存中。请将它们保存到数据集,并等到数据导入完成后,再停止、调整尺寸或替换模型。
症状:部署更好的模型后,留出集警报立即触发,或者此后再也没有触发。解决方法:基线是历史记录中的第一行。每次替换模型时,都要启动一个新的 holdout_history.jsonl(或记录一个新的基线行)。
症状:流量激增期间错误率飙升,但运行状况仍显示正常。解决方法:429 响应会计为错误,但实际含义是“已达容量上限”。请检查日志;如果出现 429 错误,请将流量分散到更多端点,或使用更大的自定义尺寸。
显示解答
药片端点的参考答案:使用 P95_BUDGET_MS = 300 和 MAX_ERROR_RATE = 1.0 配置 cron 条目 */5 * * * * python endpoint_check.py || ./page-oncall.sh;将预算设为 100 ms,而实际 P95 为 180 ms 时,程序会以状态码 1 退出并触发通知,说明配置有效。每周 CI 作业会在 300 张图像的私有留出集版本上运行 holdout_check.py 和 DEPLOYED = "pills-v2.pt":基线为 0.69。夜班演练使其下降 0.05,并打印带有状态码 1 的 ALERT 行,导致 CI 作业失败并通知频道。晚班的 12 个 Monitoring 示例通过“保存到数据集”存入 pill-review,每个示例都带有 deploymentId 和 europe-west1 标签。