规划 Platform 项目并编制预算
将项目的每个生命周期阶段映射到 Platform 或你自己的技术栈,并在花费任何额度之前估算月度成本。
视觉项目很少败在模型上,更多是败在交接环节:修正过的标签没有同步到训练副本、检查点无法追溯到对应数据,或者始终在线的端点悄悄每月烧掉 150 美元。Ultralytics Platform 在一个工作区中串联起这些交接环节;本课程将引导你在上传任何内容之前,决定项目中哪些阶段由它负责,以及这些阶段的成本。
实践操作
Platform 如何串联工作流#
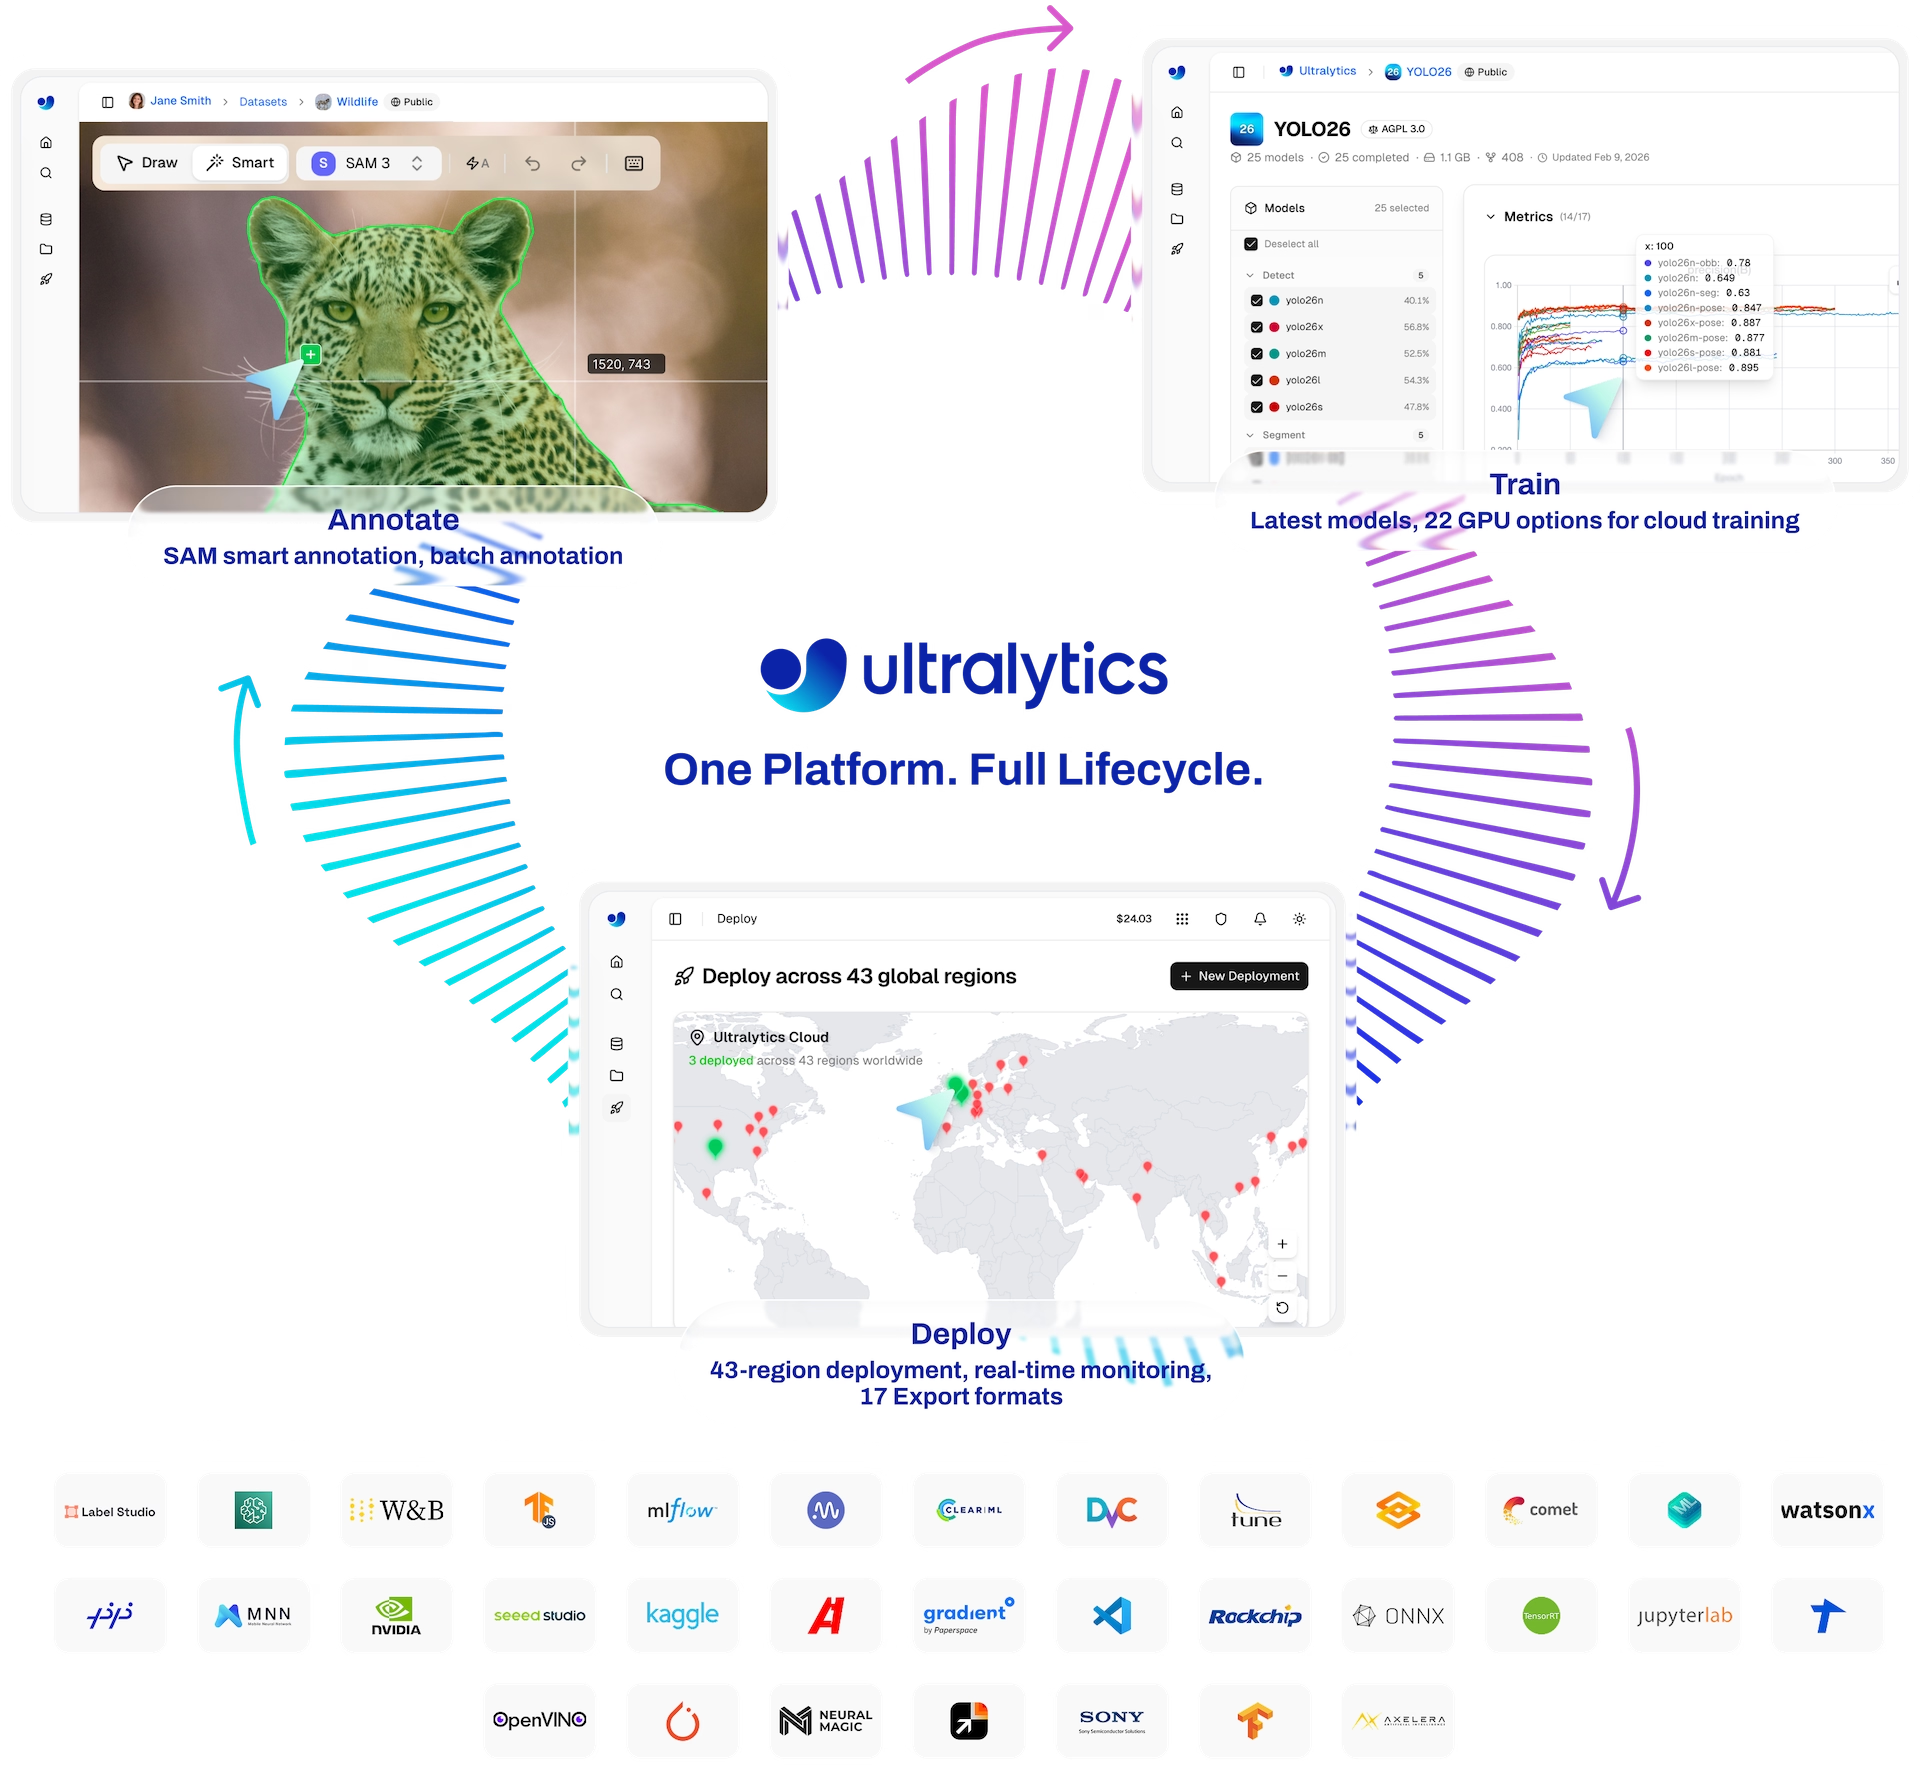
每个生产级视觉系统都遵循相同的工作循环,而成本高昂的部分是两个方框之间的箭头,而不是方框本身:
Platform 的价值在于,每个阶段都会记录下一阶段所需的信息。使用此表作为路线图;最后一列列出了讲解相应阶段的课程:
| 阶段 | 在 Ultralytics Platform 上 | 交给下一阶段的内容 | 课程 |
|---|---|---|---|
| 数据 | 上传图像、视频和归档文件(YOLO、COCO、NDJSON);导入 URL;就地读取 Google Cloud Storage、Amazon S3 或 Azure Blob Storage(Pro);本地部署(Enterprise) | 包含任务类型和数据划分的数据集 | 2 |
| 标注 | 适用于除深度(以成对映射图导入)和 SAM 之外的所有 YOLO 任务的手动工具、YOLO 和类别提示智能标注、批量标注 | 标签,以及每次批量运行前保存的版本 | 3 |
| 整理 | 聚类、查找相似图像、合并类别、拆分工具、编号版本 | 不可变的数据集版本 | 4 |
| 训练集 | 26 种云端 GPU 类型,并提供费用估算;也可以在本地运行并将结果流式传输到项目 | 与其数据集版本、费用和命令关联的模型 | 5 |
| 比较 | 项目图表、带差异对比的表格视图、验证洞察 | 值得发布的运行结果 | 6 |
| 部署 | 覆盖 42 个地区的专用端点;在同一 URL 上替换模型 | 与模型关联的端点 URL | 7 |
| 监控 | 请求、错误和 P95 延迟指标、日志、预测统计信息、保存到数据集 | 生产环境图像回到数据集中 | 8 |
两种工具覆盖整个流程。Agents 可构建可视化工作流,例如将不确定的检测结果收集到审核数据集中;Ask AI 则可通过对话完成训练、比较、标注、导出和部署,使用的正是你可以自行运行的 ul cloud 命令。
明确你仍需负责的事项#
平台在几个有意设定的边界处止步。请在计划中为每项指定一位明确的负责人:
- 从专有系统中提取帧(DICOM 档案、OEM 摄像头、工厂历史数据库):由你的代码将它们传到存储桶或上传到平台。
- 告警。平台会显示端点指标并将作业事件发送到 Slack,但不会针对延迟或错误阈值发出告警。你将在第 8 课中构建这项检查。
- 长期准确率。带标签的留出集及其历史记录由你负责(第 8 课)。
- 应用逻辑。计数、跟踪和区域规则由你的服务处理;Ultralytics Solutions 和 Ultralytics YOLO in Production 课程会介绍这些内容。
- 流量路由。端点使用自动生成的 URL,且不支持自定义域名,因此金丝雀发布、多区域路由和品牌主机名都需要你自行搭建网关。
平台不是一个独立的框架。平台模型下载后就是常规的 best.pt,由 YOLO("best.pt") 加载、验证和导出;本地 model.train(..., project="username/my-project") 则可通过设置 API 密钥流式传输到平台。在两者之间迁移无需转换任何内容。
实例:在开始前为项目做预算#
有三项会消耗点数:云端训练(GPU 费率 × 使用时长)、批量标注和整个数据集的人脸模糊处理(每 1,000 张图像 $1.00),以及自定义尺寸端点(按运行时长计费)。本课程的其他内容均免费。这个计算器采用平台的实际费率,计算一个小型检测项目的费用:
# Monthly Platform budget for a small detection project (rates from the billing and deployment docs)
TRAIN_RUNS = 8  # experiments per month
COST_PER_RUN = 0.23  # dialog estimate: ~1,000 images, YOLO26n, 100 epochs, RTX PRO 6000 ($2.09/h)
BATCH_ANNOTATION_IMAGES = 3_000  # $1.00 per 1,000 images
HOURS_PER_MONTH = 730

# Custom endpoint sizes keep one warm instance; us-central1 rates are $0.000024/vCPU-s and $0.0000025/GiB-s
warm_endpoint_hourly = (2 * 0.000024 + 4 * 0.0000025) * 3600  # 2 vCPU, 4 GiB

lines = {
    "cloud training": TRAIN_RUNS * COST_PER_RUN,
    "batch annotation": BATCH_ANNOTATION_IMAGES / 1000 * 1.00,
    "default endpoint (1 vCPU, 2 GiB, scales to zero)": 0.0,
    "warm endpoint (2 vCPU, 4 GiB, always on)": warm_endpoint_hourly * HOURS_PER_MONTH,
}
for item, usd in lines.items():
    print(f"{item:<50} ${usd:>7.2f}")
print(f"{'total with a warm endpoint':<50} ${sum(lines.values()):>7.2f}")
cloud training $ 1.84
batch annotation $ 3.00
default endpoint (1 vCPU, 2 GiB, scales to zero) $ 0.00
warm endpoint (2 vCPU, 4 GiB, always on) $ 152.42
total with a warm endpoint $ 157.26如何解读:
COST_PER_RUN取自训练对话框中的估算值,该估算会考虑数据集大小、模型、轮数、图像尺寸和 GPU。请将其替换为你自己数据集的估算值(第 5 课);在 H100 SXM 上使用 5,000 张图像、YOLO26s 和 100 轮训练,费用约为 $1.56。- 端点费用占大头。训练和标注一个小型项目只需几美元;但让实例每月保持运行 730 小时,在爱荷华州约需 $150(费率因地区而异,部署对话框会显示准确的小时费率)。
- 决策规则:所有端点一开始都使用免费的默认尺寸。只有当用户无法接受最长一分钟的冷启动,且流量足够稳定、值得支付运行时长费用时,才改用自定义尺寸。
套餐#
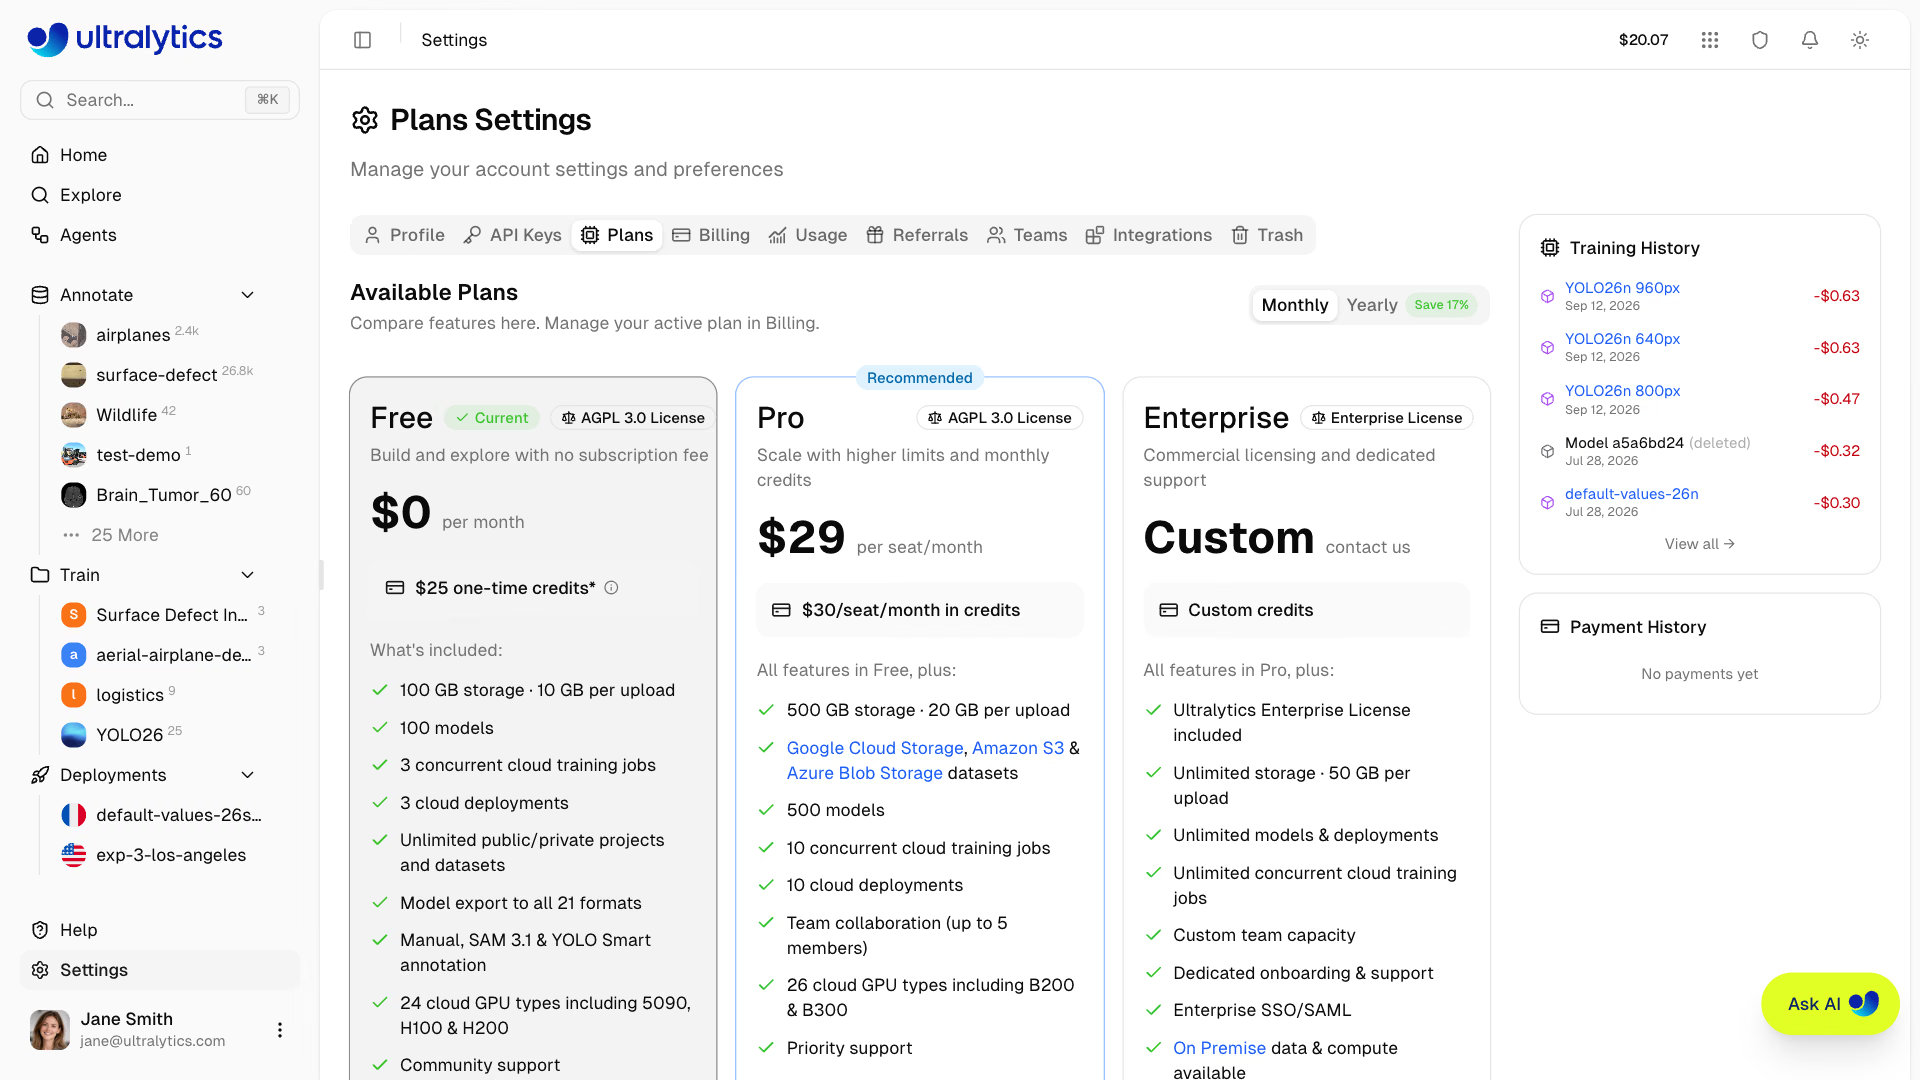
| Free | Pro($29/席位/月) | Enterprise | |
|---|---|---|---|
| 点数 | 注册赠送 $5;使用经过验证的公司邮箱可获 $25 | $30/席位/月,不可结转 | 自定义 |
| 存储空间 / 单次上传 | 100 GB / 10 GB | 500 GB / 20 GB | 无限 / 50 GB |
| 模型 / 并发训练数 | 100 / 3 | 500 / 10 | 无限 |
| 专用部署 | 3 | 10 | 无限 |
| 云端 GPU 类型 | 24 | 26 种(新增 B200、B300) | 26 |
| 云存储数据集、团队 | — | 支持,最多 5 位成员 | 支持,自定义尺寸 |
| 本地部署、SSO、企业许可证 | — | — | 是 |
决策规则:学习期间使用 Free;需要连接云存储、团队协作、超过三个端点或超过三项并发训练时,再升级到 Pro。Pro 每月 $30 的点数可覆盖上述预算中的训练和标注费用。计费文档 列出了所有费率。
常见问题#
症状:包含客户图像的数据集出现在 Explore 中,陌生人可以克隆它。解决方法:Free 和 Pro 账户中新建的数据集和项目默认设为 Public。每次都要在 New Dataset 和 New Project 对话框中切换可见性;之后再将数据集设为私有,也无法删除已存在的克隆。
症状:欧盟客户要求数据存储在欧盟,而你的工作区却将数据存储在美国。解决方法:数据区域(US、EU 或 AP)在注册时选定,之后只有支持团队可以更改。注册前应根据合同要求做好决定(课程 9)。
症状:没有流量时,每天仍消耗约 5 美元的额度。解决方法:自定义尺寸会按运行时间计费,无论端点是否空闲。停止不使用的端点,或将其恢复为默认尺寸,该尺寸可免费缩放到零。
显示解答
药片检测产线摄像头的示例计划。数据:将每晚导出的帧上传到平台(负责人:Ana)。标注:使用最新微调模型进行批量标注,然后审核(Ana)。整理、训练、比较:使用平台(Ravi)。部署:在 europe-west1 中使用一个默认尺寸端点,因为产线 PLC 每 30 秒调用一次,因此端点很少会闲置到足以缩容至零(Ravi)。监控:使用平台仪表板,并在团队的 CI 中运行定时健康检查和每周留出集作业(值班人员)。预算:10 次运行 × $0.23 + 2,000 张图像 × $0.001 = 每月约 $4.30,使用免费端点,费用由 Pro 的 $30 点数抵扣。数据区域:欧盟,因为工厂位于德国;所有数据集均设为私有。