比较运行并选出最佳模型
在 Platform 项目中比较运行,记录每次运行的目的,并通过脚本化的晋级门槛决定是否发布候选模型。
更大的模型通常能在主要指标上胜出,但可能会在没人检查的某个类别上落败。如果不提前制定规则,最终发布的就会是某个人最喜欢的那个模型。本课会记录每次运行,以便之后查明决策依据,并将“它更好吗?”转化为输出 PASS 或 FAIL 的门槛脚本。
实践操作
在项目中比较运行#
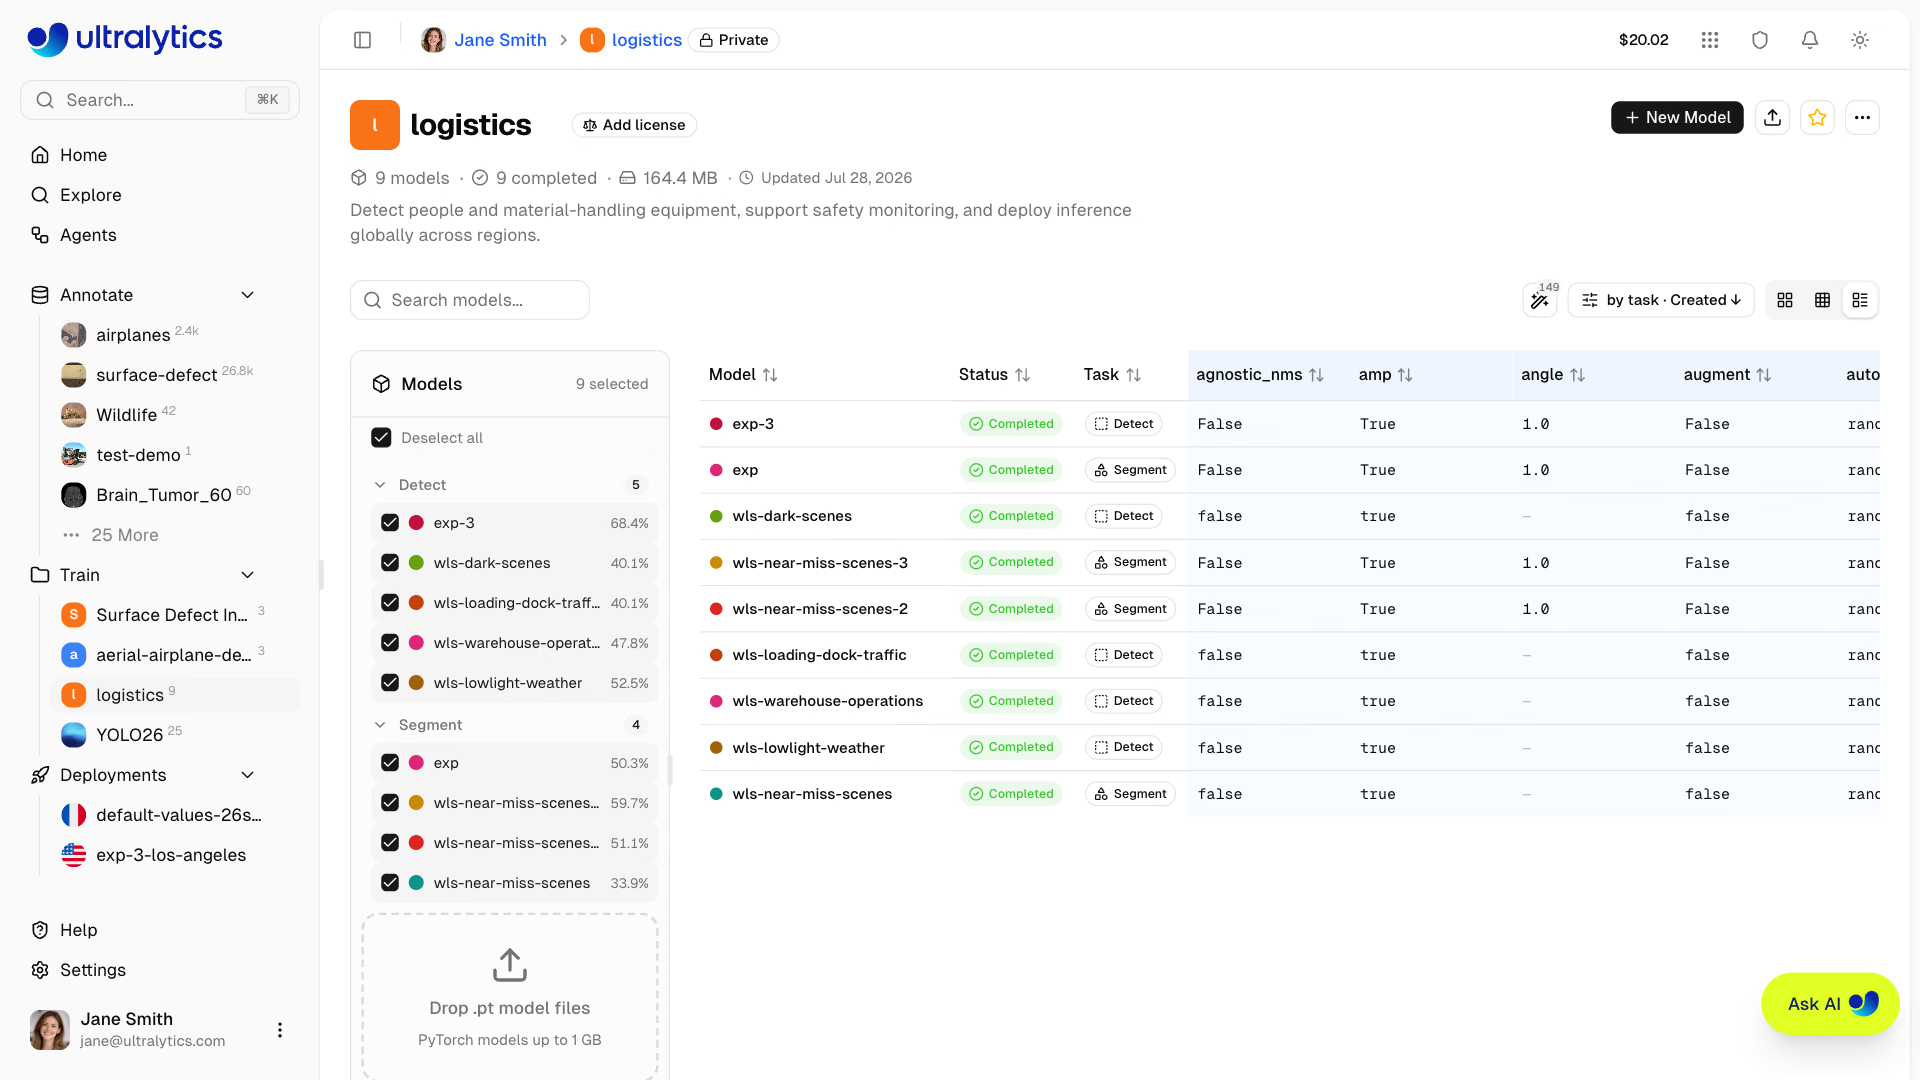
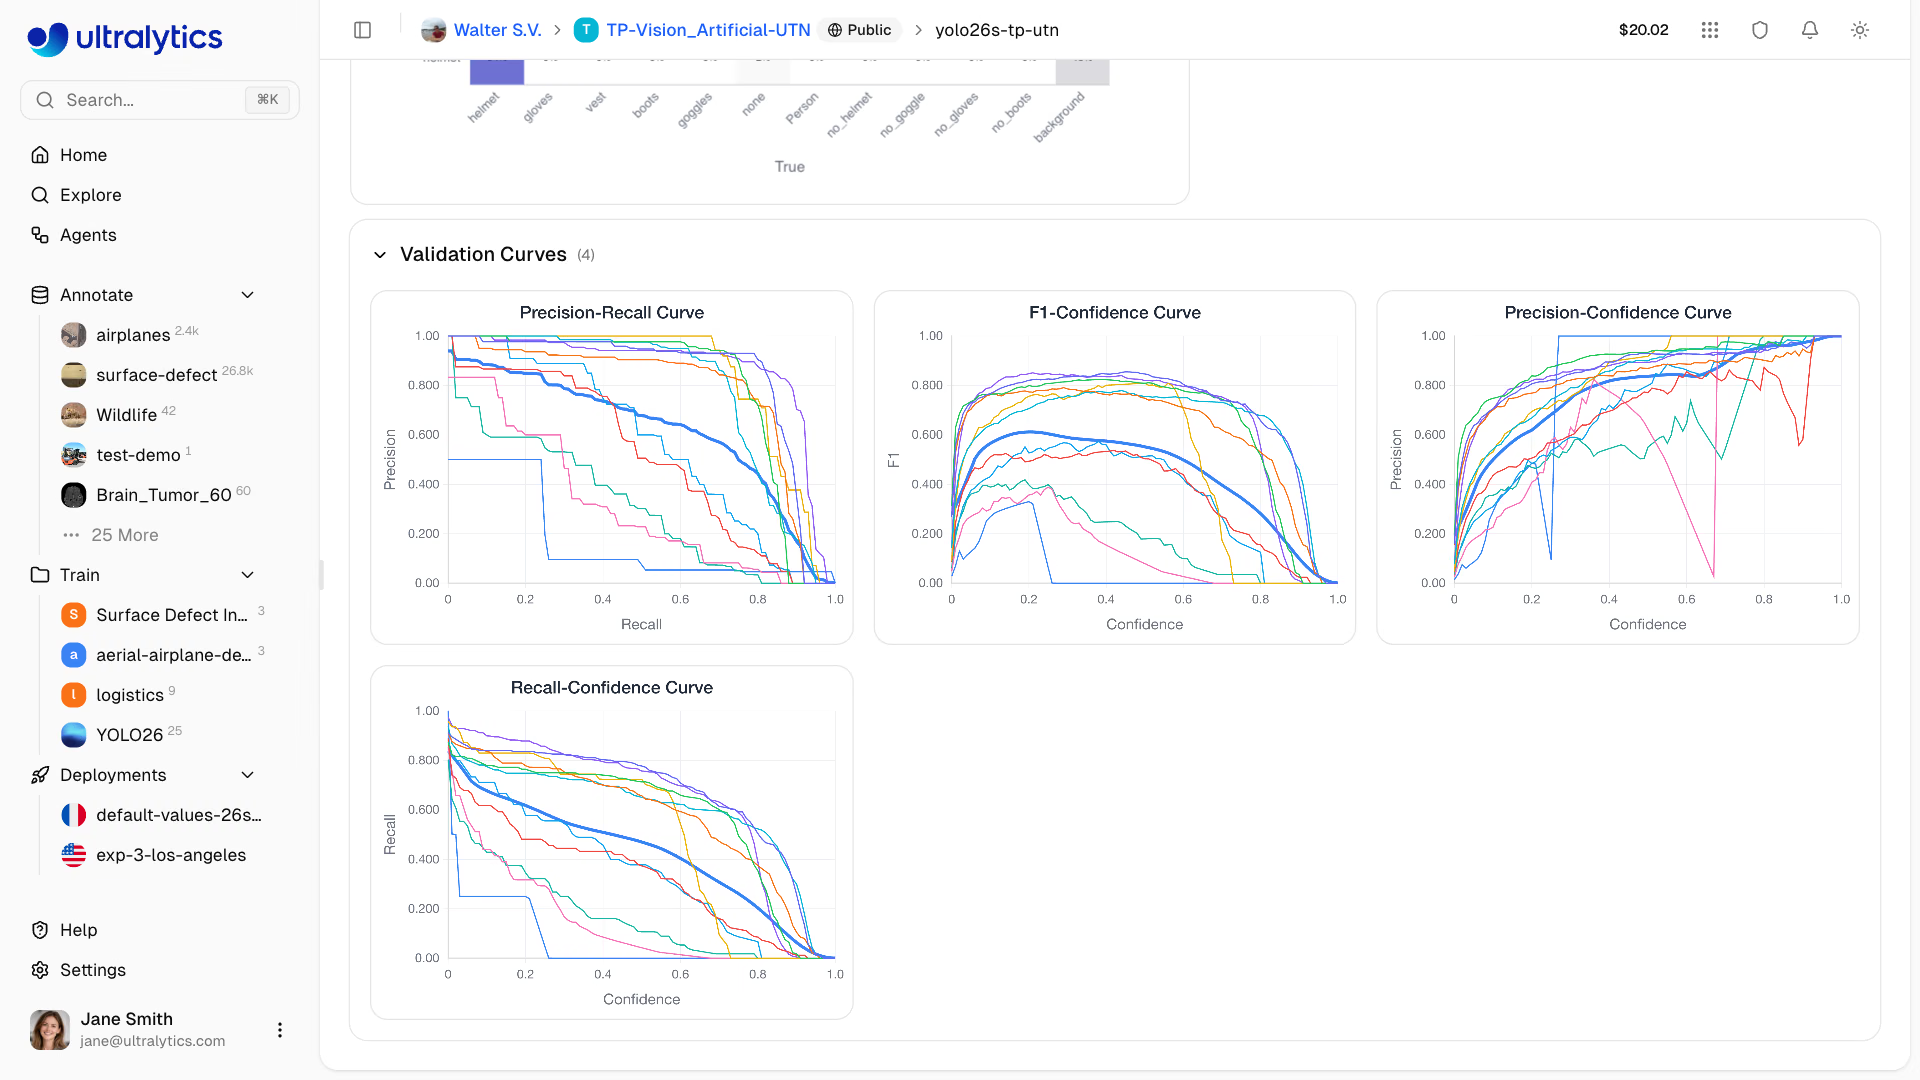
一个 项目会列出模型,并提供复选框。选中模型后,其数据会叠加显示在 Charts 仪表板中;Table 视图会并排列出训练参数和最终指标;Diff 会隐藏相同的列,让你一眼看出两次运行只有 imgsz 不同。比较只能在同一个项目内进行,因此请将相关实验放在一起(模型可以在项目之间剪切和粘贴)。查看曲线时,要比较最终值、每次运行达到该值的速度,以及曲线的平滑程度。

有两个或更多已完成的模型时,Compare with AI 会要求 Ask AI 总结差异并提出下一项实验。请将它的建议视为下一次运行的假设,而不是结论。
让每次运行都有据可查#
名称承载着含义:run_5 没有说明任何信息,而 v3_pallets_added 和 v4_imgsz1024 则说明了数据集版本和变更内容。要记录决策依据,请在模型页面打开 More actions > Information,并将 JSON 说明保存为 Custom Metadata:
{
  "hypothesis": "Pallet AP is low because val holds only 7 pallets",
  "change": "Dataset v3: +80 pallet images from cam03 and cam07; fine-tuned from v2",
  "result": "Pallet AP 0.31 -> 0.58, overall mAP50-95 0.51 -> 0.59",
  "next": "Forklift recall drops at night; collect dawn and dusk footage"
}
Platform 会记录其他信息:Run Information 卡片会显示 GPU、每小时费率、总费用、ultralytics 版本、主机、父模型、固定的数据集版本、Git 提交记录(如果有),以及可复制的 yolo train 命令。只有使用相同数据集版本的运行才能公平比较,因此每次运行都应该固定一个数据集版本。
查看结果前先选定指标和门槛#
| 指标 | 适用场景 |
|---|---|
| mAP50-95 | 检测、分割、姿态和 OBB 任务的默认指标:既能奖励紧致的边界框,也足够稳定,适合用于比较 |
| mAP50 | 目标较大且彼此间隔明显,对边界框紧致度要求不高 |
| 单个类别的 AP | 某个类别决定了业务价值 |
| 固定精确率下的召回率 | 安全和报警系统 |
| 目标设备上的推理延迟 | 始终设置为硬性上限 |
YOLO 性能指标指南解释了各项指标。候选模型只有通过所有门槛才能发布:
操作示例:编写晋级门槛脚本#
下载入围模型的 best.pt 文件,并使用相同代码在相同数据上评分。下面的示例使用两个官方检查点,因此可以在任何地方运行:
from ultralytics import YOLO

DATA = "coco8.yaml"  # identical held-out data for both runs; use your test split for the final call
BASELINE, CANDIDATE = "yolo26n.pt", "yolo26s.pt"  # e.g. best.pt from two Platform runs
NOISE, CLASS_FLOOR, LATENCY_BUDGET_MS = 0.005, 0.90, 100.0

def evaluate(weights):
    m = YOLO(weights).val(data=DATA, plots=False, verbose=False)
    per_class = {m.names[int(c)]: ap for c, ap in zip(m.box.ap_class_index, m.box.ap)}
    return m.box.map, per_class, m.speed["inference"]

(base_map, base_ap, _), (cand_map, cand_ap, cand_ms) = evaluate(BASELINE), evaluate(CANDIDATE)
weak = [n for n, ap in base_ap.items() if cand_ap.get(n, 0) < CLASS_FLOOR * ap]
gates = {
    f"mAP50-95 {base_map:.3f} -> {cand_map:.3f} beats noise": cand_map - base_map > NOISE,
    f"every class keeps {CLASS_FLOOR:.0%} of its AP (weak: {', '.join(weak) or 'none'})": not weak,
    f"inference {cand_ms:.1f} ms within {LATENCY_BUDGET_MS:.0f} ms": cand_ms <= LATENCY_BUDGET_MS,
}
for name, ok in gates.items():
    print("PASS" if ok else "FAIL", name)
print("verdict:", "ship the candidate" if all(gates.values()) else "keep the baseline, run more experiments")
raise SystemExit(0 if all(gates.values()) else 1)  # non-zero exit blocks a CI release step
PASS mAP50-95 0.669 -> 0.693 beats noise
FAIL every class keeps 90% of its AP (weak: elephant, potted plant)
PASS inference 44.1 ms within 100 ms
verdict: keep the baseline, run more experiments结果:较大的模型在整体指标上领先 2.4 个百分点,但有两个类别的 AP 下降超过 10%,因此未通过。这就是只比较主要指标时会遗漏的性能退化。每类别字典来自 ap_class_index 和 ap,只包含数据中存在的类别;延迟是在运行脚本的机器上测得的,因此请在与你的部署目标类似的硬件上运行门槛检查。COCO8 只有 8 张验证图像,远不足以支持真正的决策。请使用至少数百张图像的留出集,并且只在最终评估时传入一次 split="test"。
深入检查表现较差的图像#
对于使用已保存数据集版本训练的检测任务,Validation 视图会提供 Validation insights:按每张图像的 F1 排序、叠加真实标注的表现最差和最好的图像;展示 F1 与图像尺寸、宽高比和实例数量之间相关性的特征探索器;以及最常与失败相关联的类别。在表现最差的图像上使用 Find similar,可以将相似图像作为未标注图像添加到训练集中,把门槛检查失败转化为明确的数据改进任务。
常见问题#
症状:报告的测试 mAP 很高,生产环境中的表现却更差。解决方法:使用验证集调参。如果你在测试集上比较了十次运行,那么测试集已经被用于调参,测得的数值也就偏乐观。只在最后阶段对最终候选模型进行一次测试集评分。
症状:某次运行“领先”了 4 分,却没人能复现原因。解决方法:检查每次运行的 Run Information 卡片中固定的数据集版本。如果版本不同,请在新版本上重新运行基线,然后再进行比较。
症状:每次换一个随机种子重新训练,胜出的模型就会改变。解决方法:在大多数数据集上,差异低于约 0.5 个 mAP 点都属于不同运行之间的噪声。请在门控中保留噪声阈值;当结果如此接近时,应使用更大的留出集。
显示解答
药片模型的示例答案:基线模型 v1-baseline(10 个 epoch)对比候选模型 v2-finetune(再训练 5 个 epoch,SGD,lr0 0.001)。设置 DATA = "medical-pills.yaml" 和 gate.py 中的两个权重。输出:PASS mAP50-95 0.659 -> 0.687 beats noise、PASS every class keeps 90% of its AP (weak: none)、PASS inference 4.0 ms within 100 ms,结论为“发布候选模型”。在 v2 的 Custom Metadata 中记录:假设“v1 在第 10 个 epoch 时仍在提升”,变更“使用 SGD、lr0 0.001 微调 5 个 epoch”,结果“mAP50-95 0.659 -> 0.687”。请在元数据中注明注意事项:medical-pills 的验证集也用于指导训练,因此在投入生产前,请使用单独的留出集进行确认。