训练、解读与微调训练结果
启动一项有预算控制的云端训练任务,根据逐轮曲线评估训练结果,并进行微调,避免默认优化器忽略你的学习率设置。
云端 GPU 每运行一分钟都会产生费用,而微调中最常见的错误不会产生额外费用,却会悄悄浪费整个训练过程:默认优化器会忽略你设置的学习率。本课会在 medical pills 数据集上训练一个真实模型,依据决策规则解读其曲线,并正确进行微调,让你的设置真正生效。
实践操作
启动训练任务#
在项目或数据集页面点击 New Model。Cloud Training 选项卡会引导你配置以下设置:
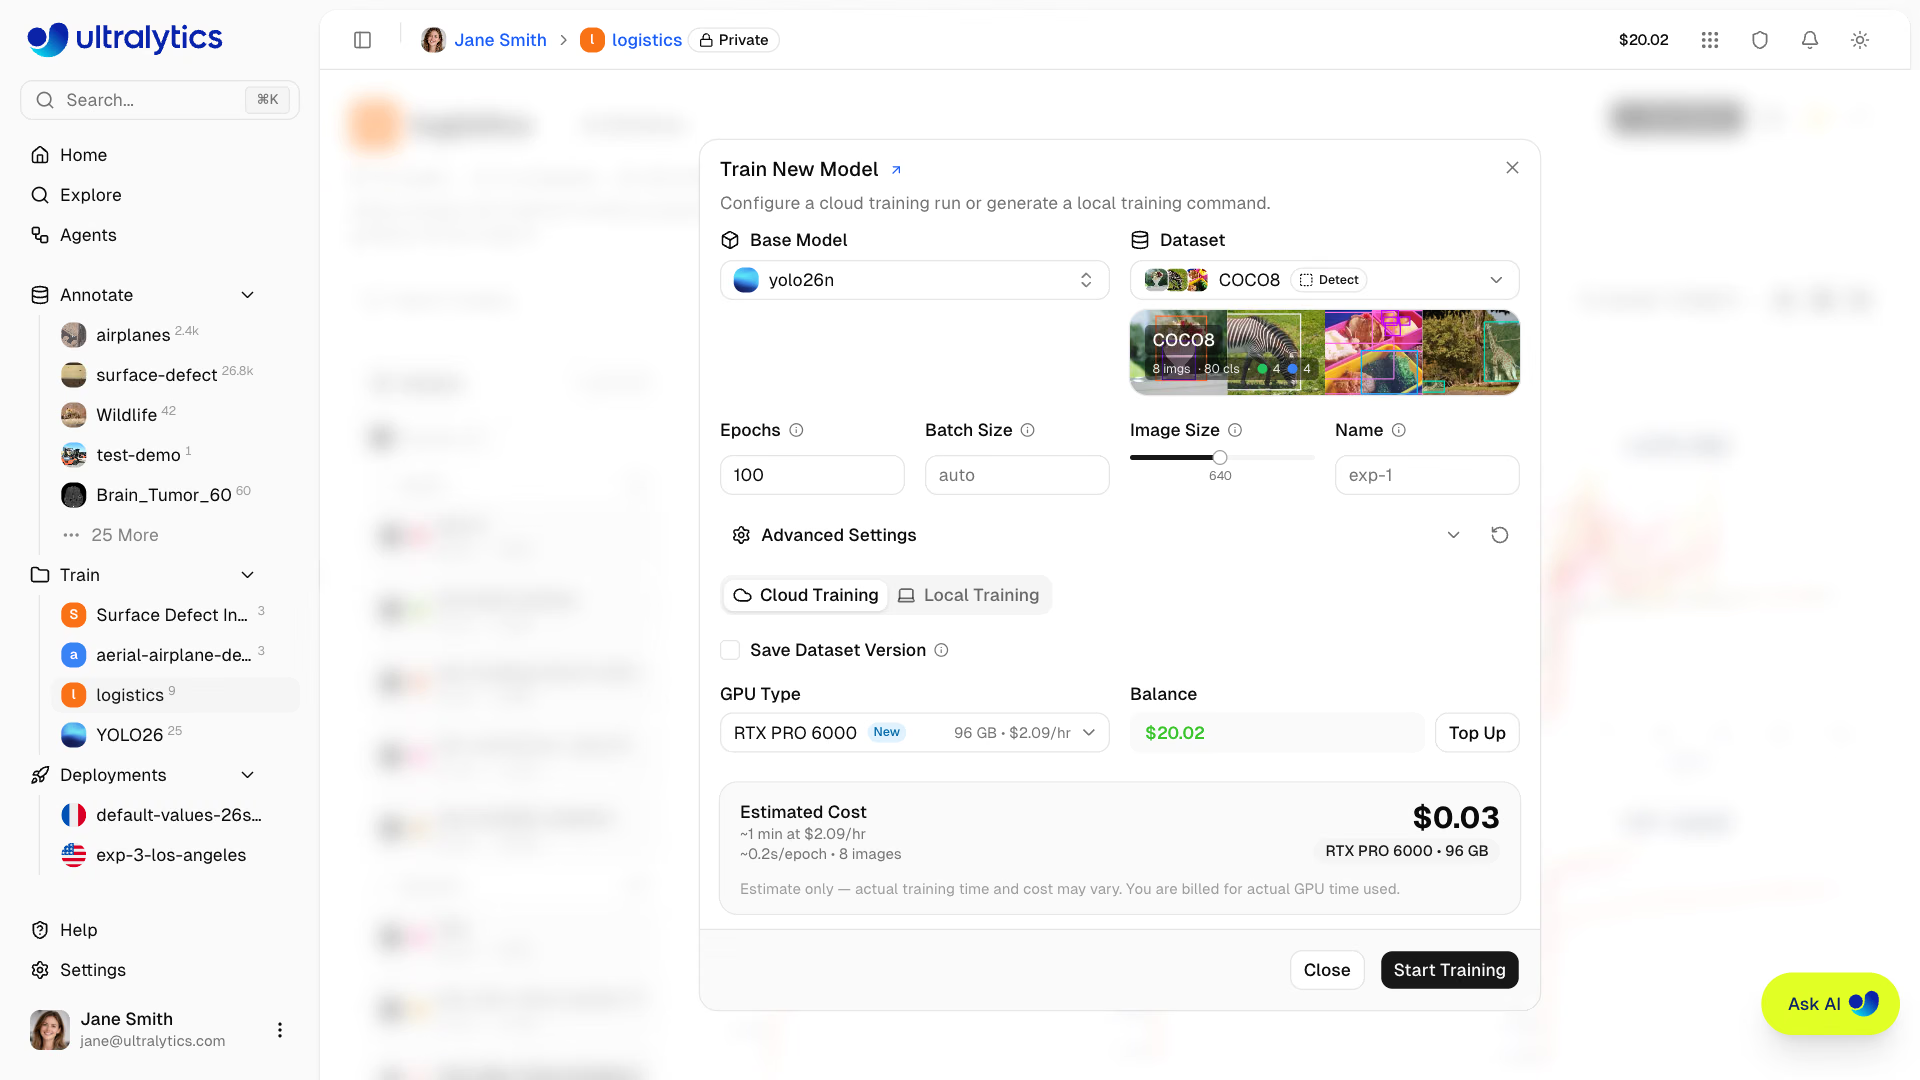
| 设置项 | 默认 | 何时更改 |
|---|---|---|
| 基础模型 | 在 Official 下选择(推荐 YOLO26) | 要进行微调:在 My Models 下选择你之前的训练结果 |
| 数据集 | — | 始终启用 Save Dataset Version,以便将训练任务固定到对应的数据版本 |
| Epoch 数 | 100 | 烟雾测试(10–20)或超大型数据集 |
| 批次大小 | -1(自动适应 GPU 显存) | 要让两次训练的结果完全可比 |
| 图像尺寸 | 640 | 目标较小:请调大图像尺寸(滑块最高可设为 1280;YAML 编辑器最高可接受 4096) |
| 高级设置 | 默认值 | YAML 中提供 50 多个 model.train() 参数,包括优化器、学习率和数据增强 |
这些参数与本地 model.train(...) 使用的参数相同,模型页面之后会显示一条可复制的 yolo train 命令,其中包含所有非默认值。
选择 GPU 并规划训练预算#
| 档位 | 示例(显存、每小时价格) | 适用场景 |
|---|---|---|
| 入门 | RTX 2000 Ada(16 GB,$0.24)、RTX A5000(24 GB,$0.27)、RTX 4090(24 GB,$0.69) | 烟雾测试、nano 和小型模型 |
| 中端 | L40S(48 GB,$0.86)、RTX 5090(32 GB,$0.99)、A100 SXM(80 GB,$1.49) | 中型模型、更大的批次 |
| 默认 | RTX PRO 6000(96 GB,$2.09) | 大多数任务 |
| 高端 | H100 SXM(80 GB,$3.29),H200 SXM(141 GB,$4.39) | 时间紧迫时使用大型数据集 |
| Pro 和 Enterprise | B200(180 GB,$5.89),B300(288 GB,$7.39) | 规模最大的任务 |
费用卡片会在开始前估算时长和价格:在默认 RTX PRO 6000 上,用 YOLO26n 训练 1,000 张图像、跑 100 个 epoch,费用约为 $0.23;在 H100 SXM 上,用 YOLO26s 训练 5,000 张图像、跑 100 个 epoch,费用约为 $1.56,速度约为 RTX 4090 的 3.4 倍。费用按实际 GPU 使用时间计算:GPU 启动后,已完成、已取消和失败的运行都会收费;运行开始时,账户余额必须足以覆盖预估费用(至少 15 分钟的 GPU 使用时间);如果余额变成负数,正在运行的任务会停止。因此,长任务请在 Settings > Billing 中开启自动充值。选择比 RTX PRO 6000 便宜的 GPU 时,如果 Ultralytics 管理的容量空闲,你可能会免费升级到 RTX PRO 6000,但仍按你选择的费率计费。
决策规则:先用默认 GPU 跑 10–20 个 epoch,对新数据集进行冒烟测试。如果某次运行需要数小时,而且有人在等结果,就换用 H100 或 H200。如果 GPU 利用率一直很低,就选更便宜的 GPU,而不是更快的 GPU。
监控运行#
模型页面的 Train 选项卡会实时显示三个子选项卡。Charts 按 epoch 绘制指标、训练和验证损失以及学习率;Console 保留最近 2,000 行日志,并会在出现 traceback 或 CUDA 显存不足错误时立即停止运行;System 显示 GPU 利用率、内存和温度:

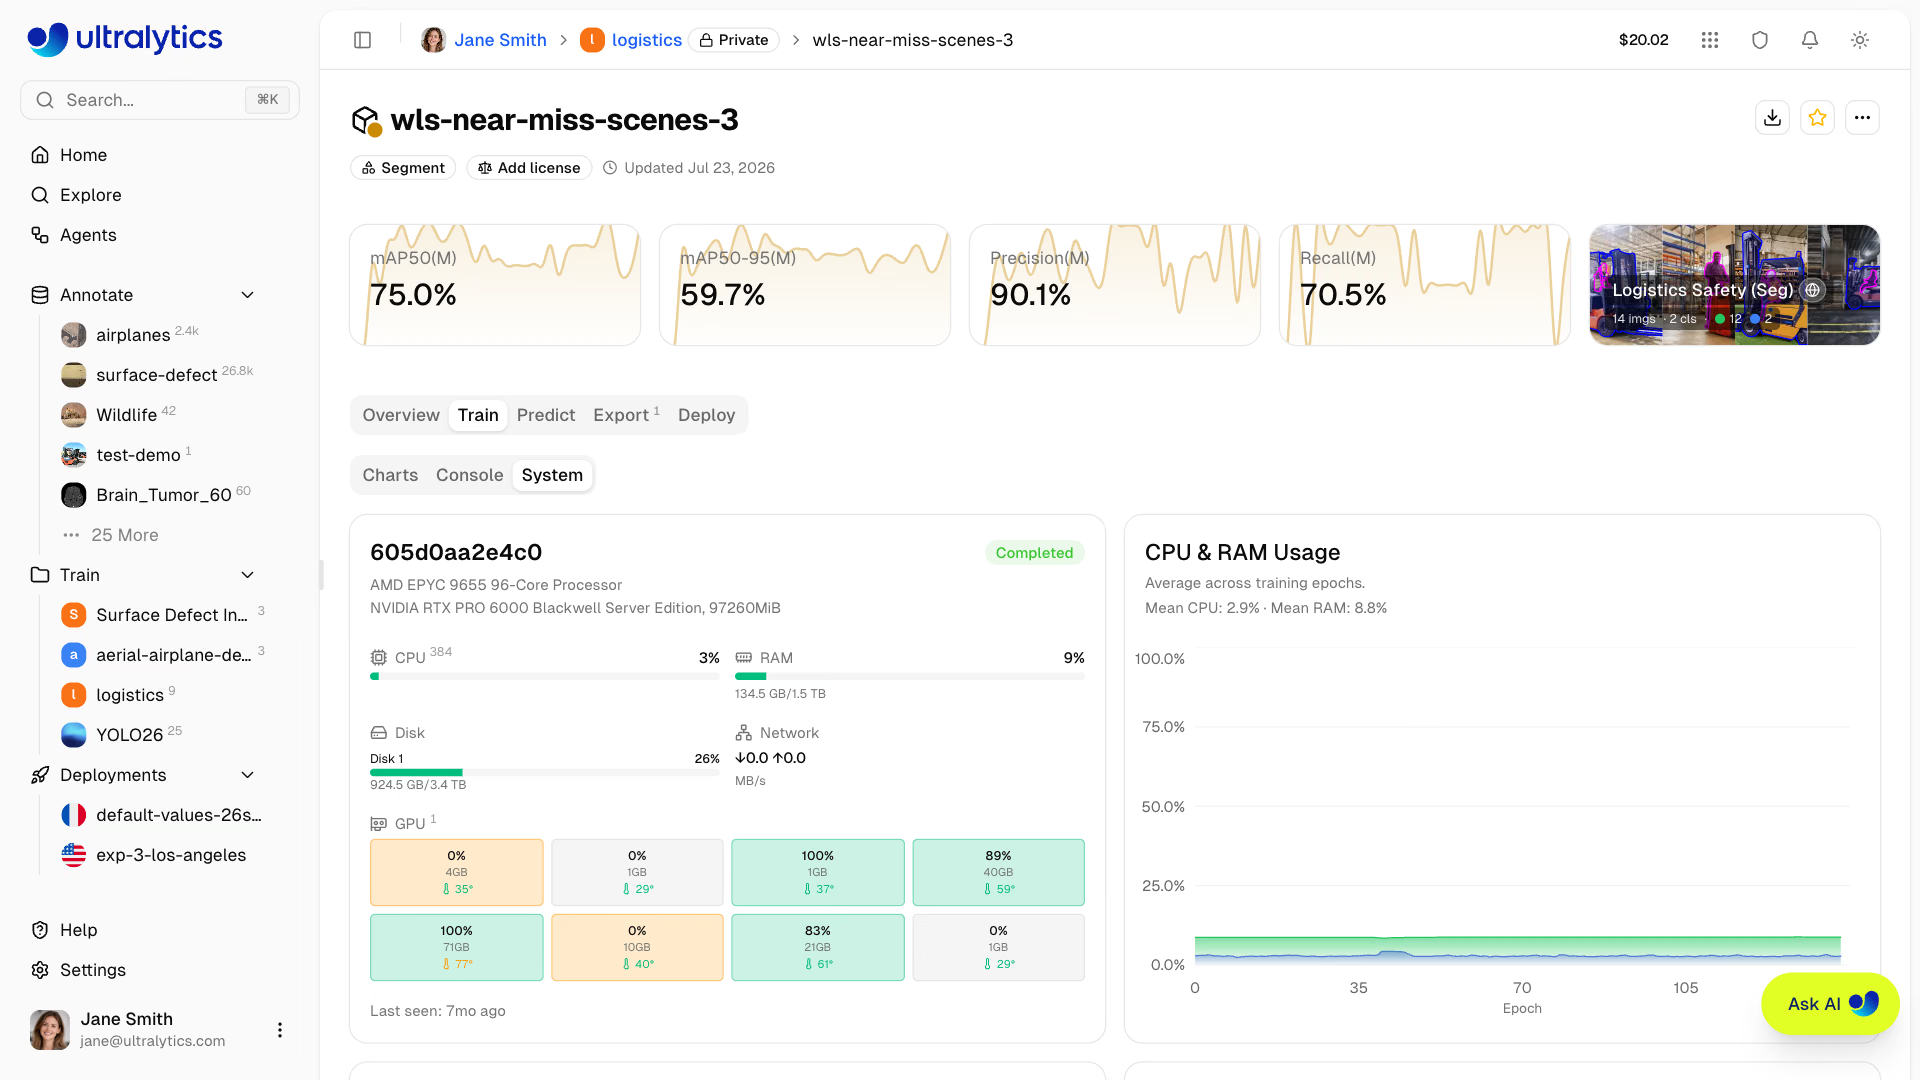
如果某次运行连续 4 小时没有任何输出,就会被标记为失败。最佳检查点会定期上传,因此取消运行后仍会保留截至当时的最佳 epoch;你还可以通过 Slack 提醒获知运行何时完成或失败。
操作示例:训练、流式传输并查看运行#
你可以在任何地方训练,同时在 Platform 中跟踪运行。将 Settings > API Keys 中的 API 密钥导出为 ULTRALYTICS_API_KEY 后,使用格式为 username/project 的 project,即可将图表、控制台和最佳检查点流式传输到该项目:
from ultralytics import YOLO

# export ULTRALYTICS_API_KEY="..." first to stream this run into your Platform project
model = YOLO("yolo26n.pt")
results = model.train(data="medical-pills.yaml", epochs=10, imgsz=320, project="username/pill-inspection", name="v1-baseline")
print(f"mAP50-95 {results.box.map:.3f}, best checkpoint: {model.trainer.best}")
Class Images Instances Box(P R mAP50 mAP50-95)
all 23 399 0.97 0.957 0.977 0.659
mAP50-95 0.659, best checkpoint: .../runs/detect/username/pill-inspection/v1-baseline/weights/best.pt点击 New Model 后,同一条命令也会在 Platform 的 GPU 上运行;在本地笔记本电脑的 CPU 上运行时,用时不到两分钟,配置为 imgsz=320。运行的 results.csv 保存了 Charts 子选项卡绘制的逐 epoch 序列,因此只需几行代码,就能把“监控曲线”转化为一条规则:
import pandas as pd

df = pd.read_csv("results.csv")  # the per-epoch metrics behind the Charts subtab
df.columns = df.columns.str.strip()
m = df["metrics/mAP50-95(B)"]
best_epoch = int(df.loc[m.idxmax(), "epoch"])
recent_gain = m.iloc[-1] - m.iloc[-4]  # change over the last 3 epochs
val_loss = df["val/box_loss"]
print(f"epochs={len(df)} best mAP50-95={m.max():.3f} at epoch {best_epoch}")
print(f"gain over last 3 epochs: {recent_gain:+.3f}")
print(f"val box loss: {val_loss.iloc[0]:.3f} -> {val_loss.iloc[-1]:.3f}")
if recent_gain < 0.005 and val_loss.iloc[-1] >= val_loss.iloc[-4]:
    print("verdict: plateaued - stop, and fix the data before training longer")
elif best_epoch == len(df):
    print("verdict: still improving at the last epoch - more epochs should help")
else:
    print("verdict: converged - keep best.pt")
epochs=10 best mAP50-95=0.659 at epoch 10
gain over last 3 epochs: +0.028
val box loss: 1.367 -> 1.045
verdict: still improving at the last epoch - more epochs should help最佳 epoch 是最后一个 epoch,mAP50-95 在最后三个 epoch 中上升了 2.8 个百分点,而且验证损失仍在下降:这次 10 个 epoch 的运行提前停止了,延长训练或进行微调会有帮助。查看任何 Platform 运行的 Charts 子选项卡时,都可以参考同样的三个信号:最佳 epoch 所在位置、近期增幅,以及验证损失的变化趋势。
从之前的模型微调#
在 My Models 中选择之前的模型作为基础模型;Platform 会创建一个从该检查点开始训练的新模型,旧模型保持不变。通常建议降低学习率,但使用默认的 optimizer: auto 时,训练会自行选择优化器和学习率,并忽略 lr0。控制台会在最初几行中说明这一点:
optimizer: 'optimizer=auto' found, ignoring 'lr0=0.01' and determining best 'optimizer' and 'lr0' automatically...
optimizer: AdamW(lr=0.002, momentum=0.9) with parameter groups 114 weight(decay=0.0), 126 weight(decay=0.0005), 126 bias(decay=0.0)
在 Advanced Settings 中明确设置 optimizer,该值就会生效。使用 optimizer: SGD 和 lr0: 0.001 对药片模型再微调 5 个 epoch,日志如下:
optimizer: SGD(lr=0.001, momentum=0.937) with parameter groups 114 weight(decay=0.0), 126 weight(decay=0.0005), 126 bias(decay=0.0)
                   all         23        399      0.969      0.962      0.983      0.687
mAP50-95 从 0.659 升至 0.687。下一课会通过晋级门槛评估这个候选模型。
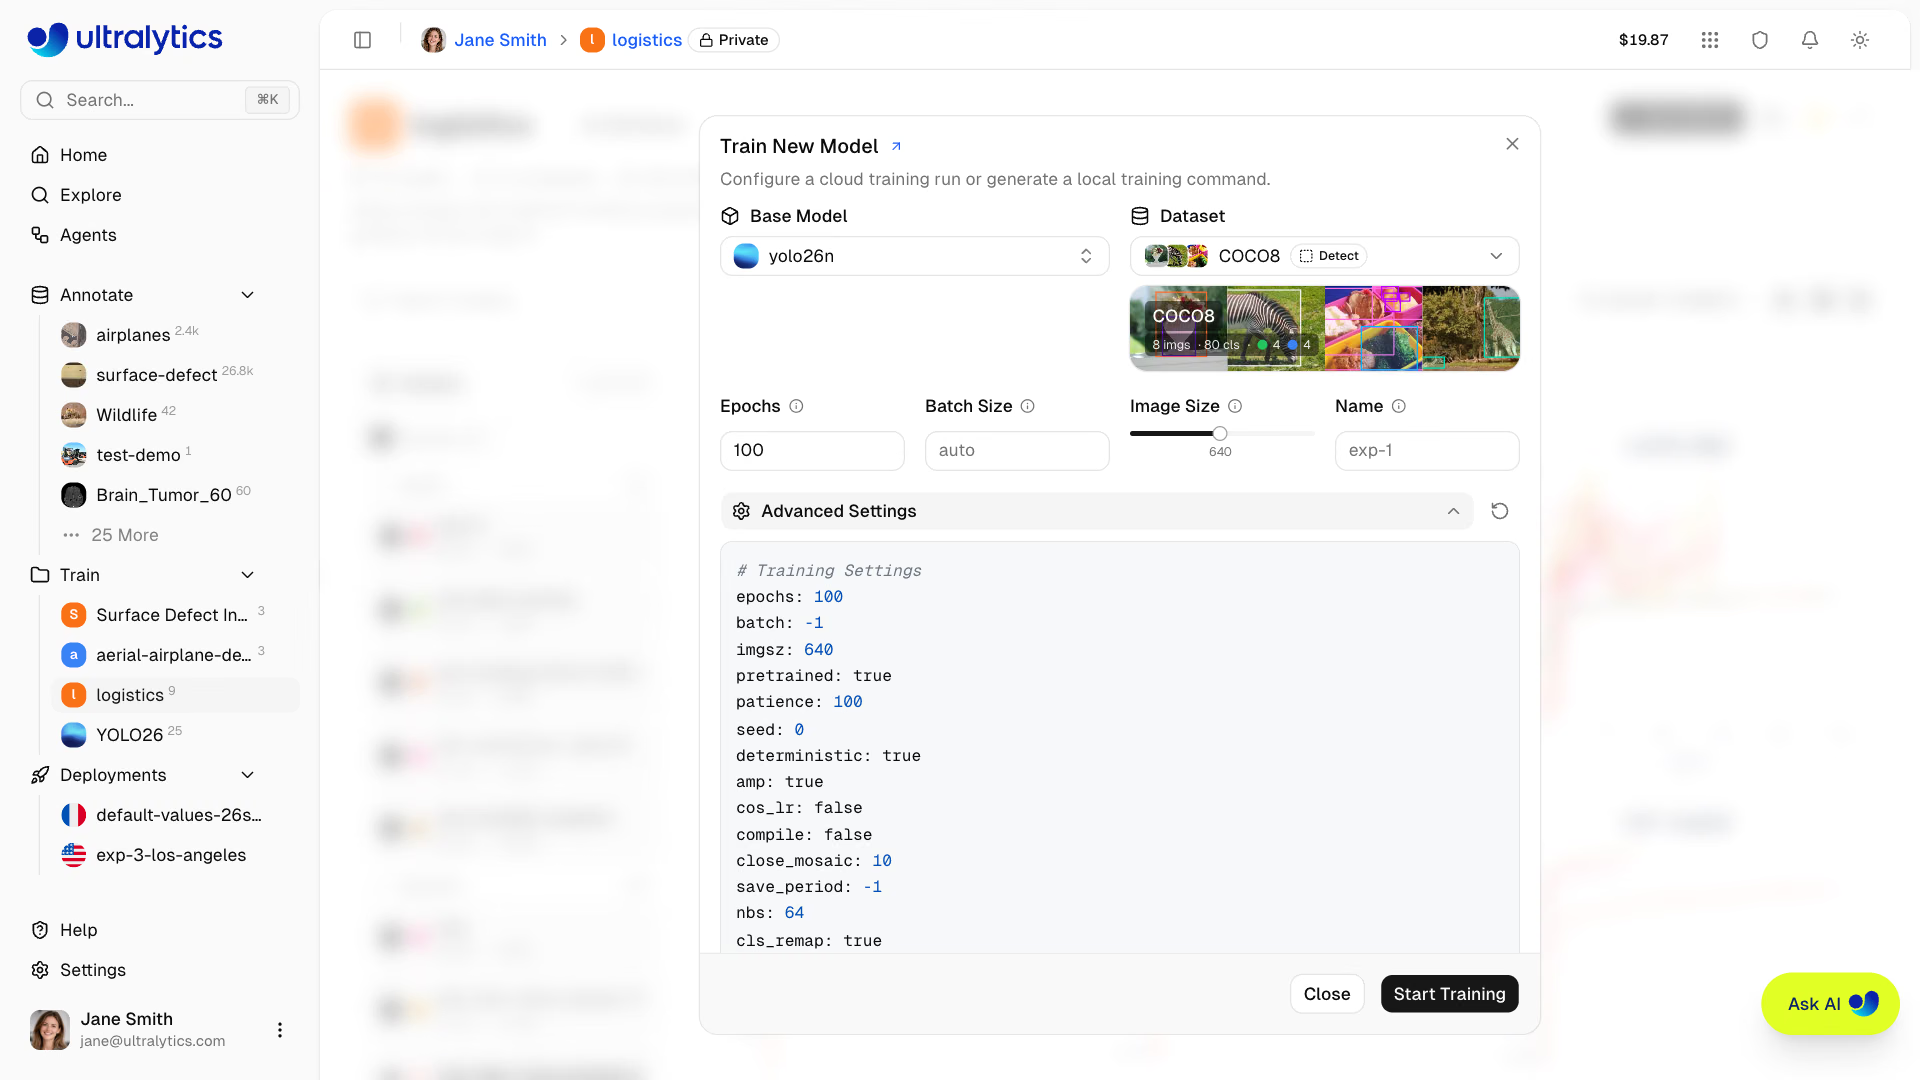
要复现之前的运行,请在模型页面打开 Training Configuration 表格,选择 Copy JSON,然后将其粘贴到 Advanced Settings 中。微调指南介绍了如何冻结层,超参数调优指南介绍了如何进行系统性搜索。
常见问题#
症状:你设置了 lr0: 0.001,但控制台显示的是 ignoring 'lr0=...'。解决方法:使用 optimizer: auto 时,训练会自行选择优化器和学习率。将 optimizer 设为 SGD 或 AdamW,并同时设置 lr0,然后确认控制台中的 optimizer: 行。
症状:整个运行期间,System 子选项卡显示 GPU 利用率远低于 80%。解决方法:瓶颈在于数据加载,而不是 GPU,因此换更快的 GPU 只会增加成本。选择更便宜的 GPU,或者在显存允许时增大批次大小。
症状:验证 mAP50-95 已连续 10 个轮次没有提升,而验证损失却逐渐上升。解决方法:取消训练。当前最佳检查点会保留;下一次提升应来自数据(第 3 和第 4 课),而不是增加轮次。
显示解答
药片数据集的示例答案:10 个 epoch 的基线模型在第 10 个 epoch 达到峰值,mAP50-95 为 0.659,最后三个 epoch 提高了 0.028,验证框损失从 1.367 降至 1.045,因此结论是“继续”。与其从头重新训练,不如进行微调:在 My Models 中选择基础模型 v1-baseline,训练 5 个 epoch,并在 Advanced Settings 中设置 optimizer: SGD 和 lr0: 0.001。控制台确认了 SGD(lr=0.001, momentum=0.937),mAP50-95 达到 0.687。使用默认 GPU 的费用只有几美分;点击 Start Training 前,费用卡片会显示预估金额,训练后则可在 Settings > Billing 中查看实际费用。