隐私、区域与合规性
根据合同选择数据和部署区域,确保数据保持私有,在上传前对图像进行匿名化,并完成发布前合规检查清单。
视觉数据通常涉及个人信息:人脸、车牌、工厂车间里员工的工牌。注册时随意选择数据区域,或让某个数据集保持公开,都可能违反客户合同,而且这两种情况都很难补救。本课程将讲解区域、可见性和匿名化方面的决策,提供一个可运行的上传前模糊处理步骤,并以一份可交给合规审核人员的检查清单收尾。
实践操作
数据区域与部署区域#
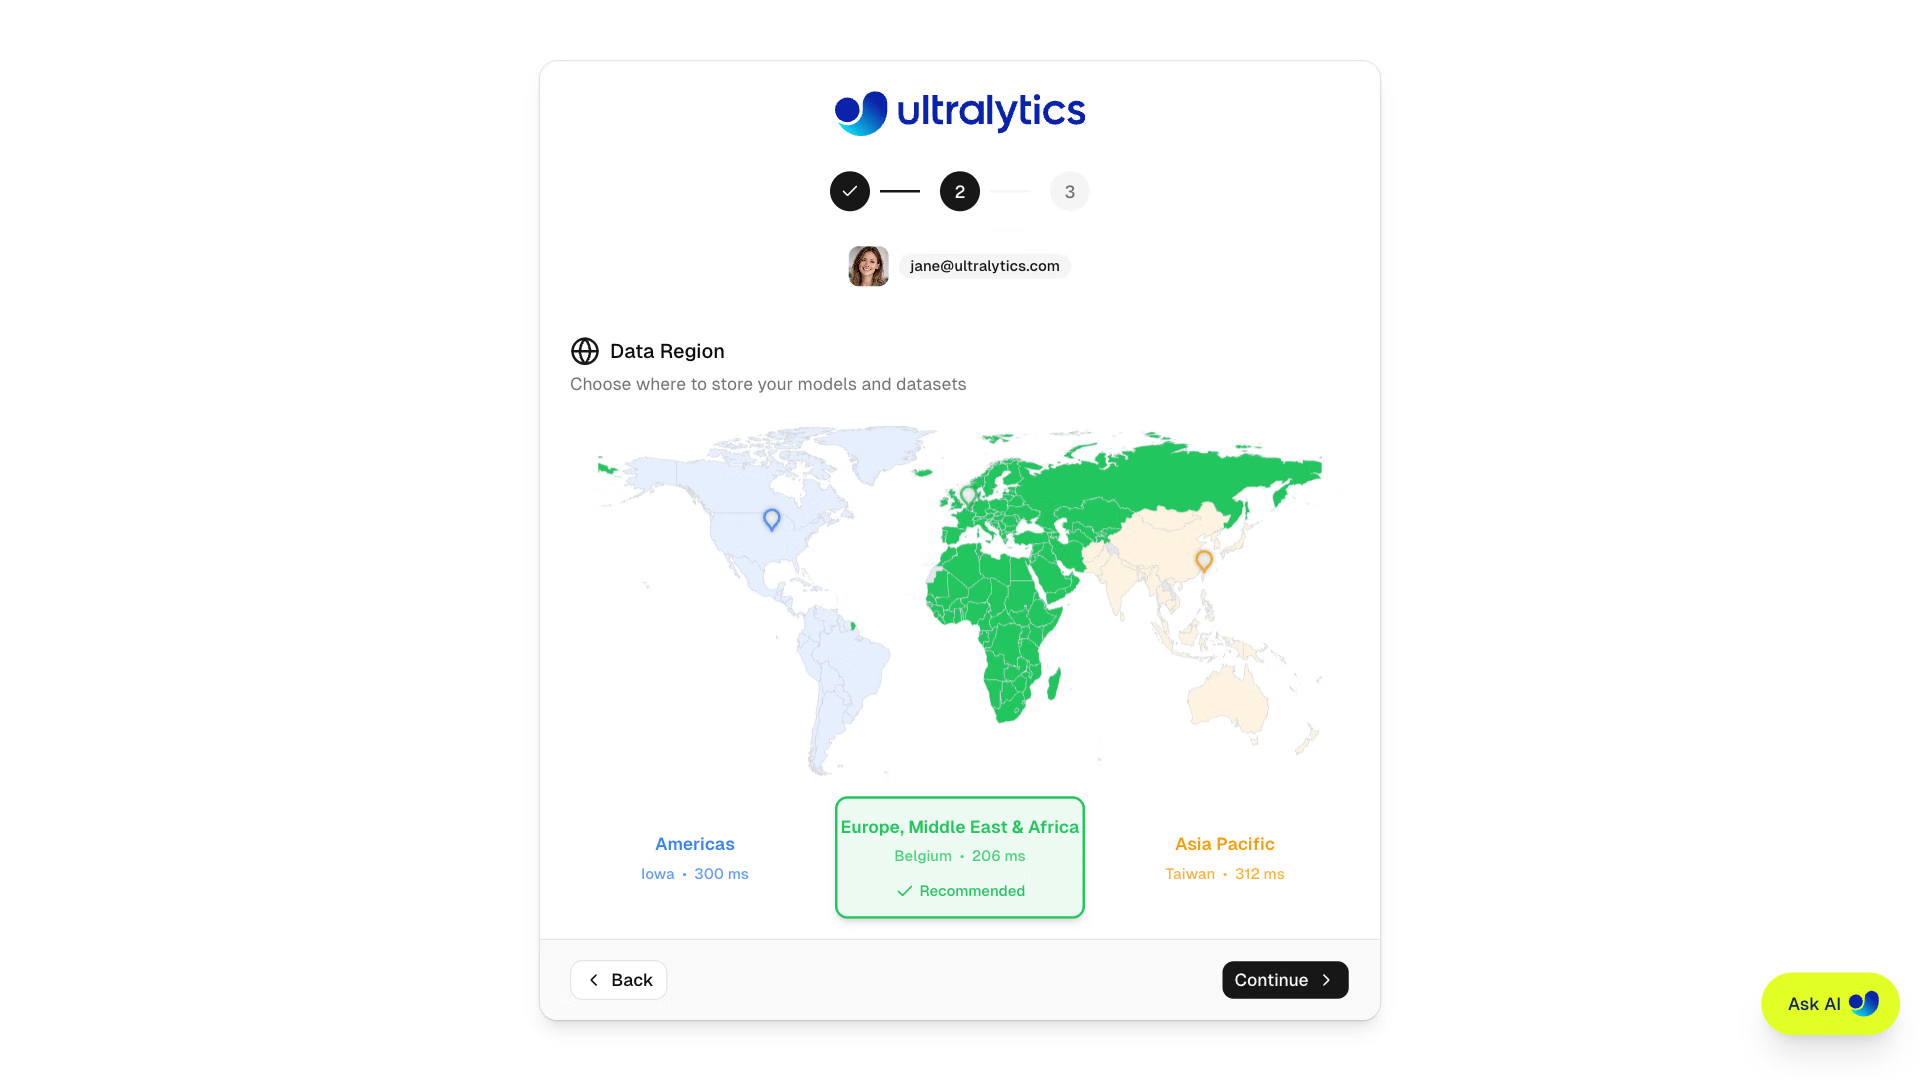
在注册过程中,Platform 会测量到三个数据区域的延迟,并推荐距离最近的区域。你的选择将成为账户的 dataRegion:
| 数据区域 | 位置 | 典型适用对象 |
|---|---|---|
US(us) | 美国艾奥瓦州(us-central1) | 美洲 |
EU(eu) | 比利时圣吉斯兰(europe-west1) | 欧洲、中东和非洲;因 GDPR 要求数据驻留 |
AP(ap) | 中国台湾彰化(asia-east1) | 亚太地区 |
数据区域决定 Platform 存储数据集、模型和托管训练数据的位置,以及共享推理的运行位置。以下三项不受数据区域限制:
- 专用端点可在你选择的42 个部署区域中的任意区域运行,因此 EU 工作区可以从东京提供服务,而每个请求中的图像也会发送到东京。
- 账户级数据(例如个人资料、账单和活动记录)会在全球范围内处理,具体说明见隐私政策。
- 计算位置。数据区域是存储方面的保证。如果合同限制了数据处理地点,请在训练前向 Ultralytics 确认 GPU 和端点的位置,或使用 On Premise。
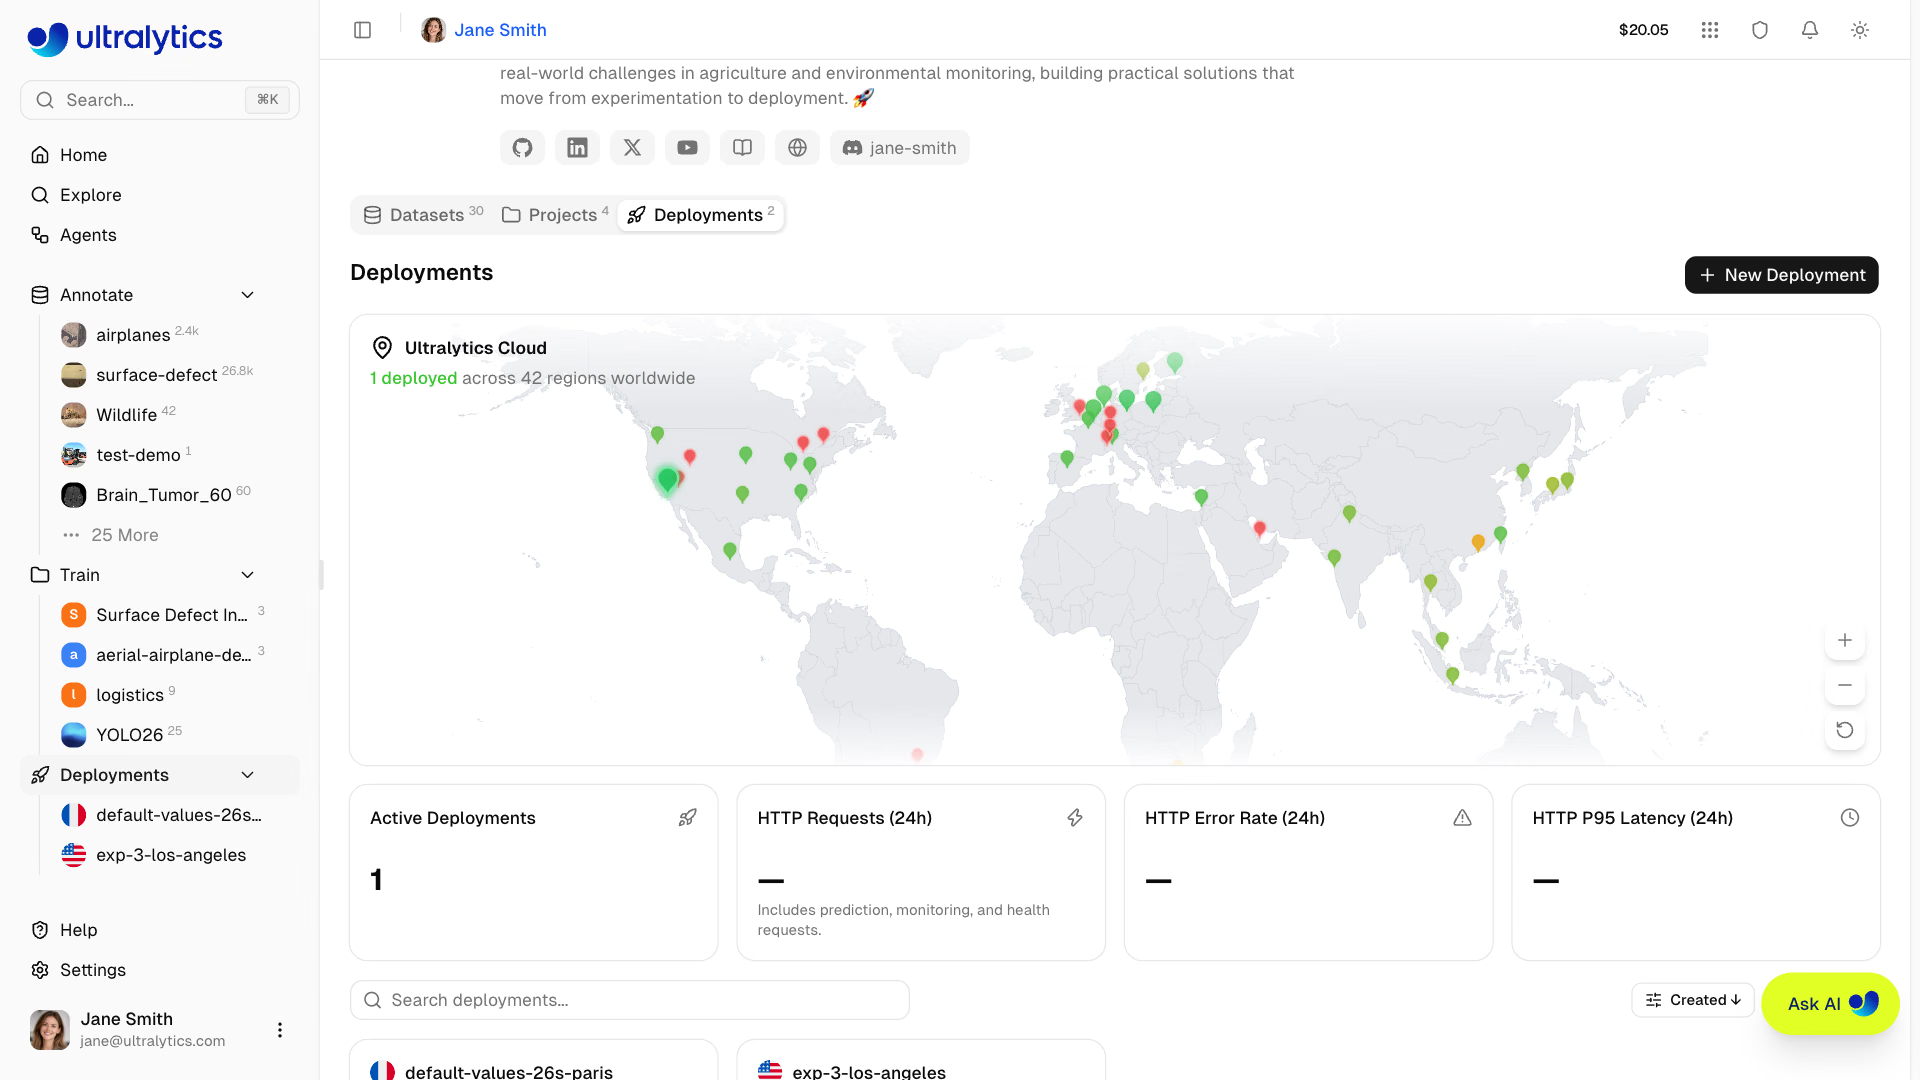
你无法自行更改数据区域;需要提交支持请求。团队工作区会沿用创建者的数据区域。应根据合同来决定,而不是根据延迟:
当跨国用户的延迟需求与数据驻留要求相冲突时,请审慎选择:在数据区域部署一个端点(合规最简单,但远距离用户的访问速度较慢);在多个区域部署端点(速度更快,但每个区域都会接收请求图像,因此要逐一核对是否符合合同);或按司法管辖区划分独立工作区(隔离效果最佳,但运营工作更多)。
可见性与访问权限#
新建数据集和项目在 Free 和 Pro 方案中默认设为 Public,在 Enterprise 方案中默认设为 Private。任何人(包括未登录的访客)都可以查看公开资源,也可以从 Explore 克隆;之后再将其设为私有,并不能删除其他人已经克隆的副本。团队工作区(Pro 和 Enterprise)提供四种角色:
| 角色 | 权限 |
|---|---|
| 所有者 | 所有操作,包括成员管理、账单、删除团队和转移所有权 |
| 管理员 | 编辑所有内容;管理账单、设置和低于管理员级别的成员 |
| 编辑者 | 创建、编辑和删除资源;上传、训练、导出和部署 |
| 查看者 | 读取团队资源和成员信息 |
每个专用端点都绑定一个 API 密钥,只有工作区所有者可以查看密钥值。删除该密钥不会锁定端点;停止或删除部署才会。
示例:上传前进行匿名化#
Platform 可以模糊人脸:右键单击图像并选择 模糊人脸(免费);从 更多操作 对整个数据集执行此操作(每 1,000 张图像 $1.00);或者在“新建数据集”对话框中启用模糊处理,让图像在处理期间自动模糊且不收费。此功能不会模糊车牌、屏幕或旁观者的全身,也不适用于连接的数据集。
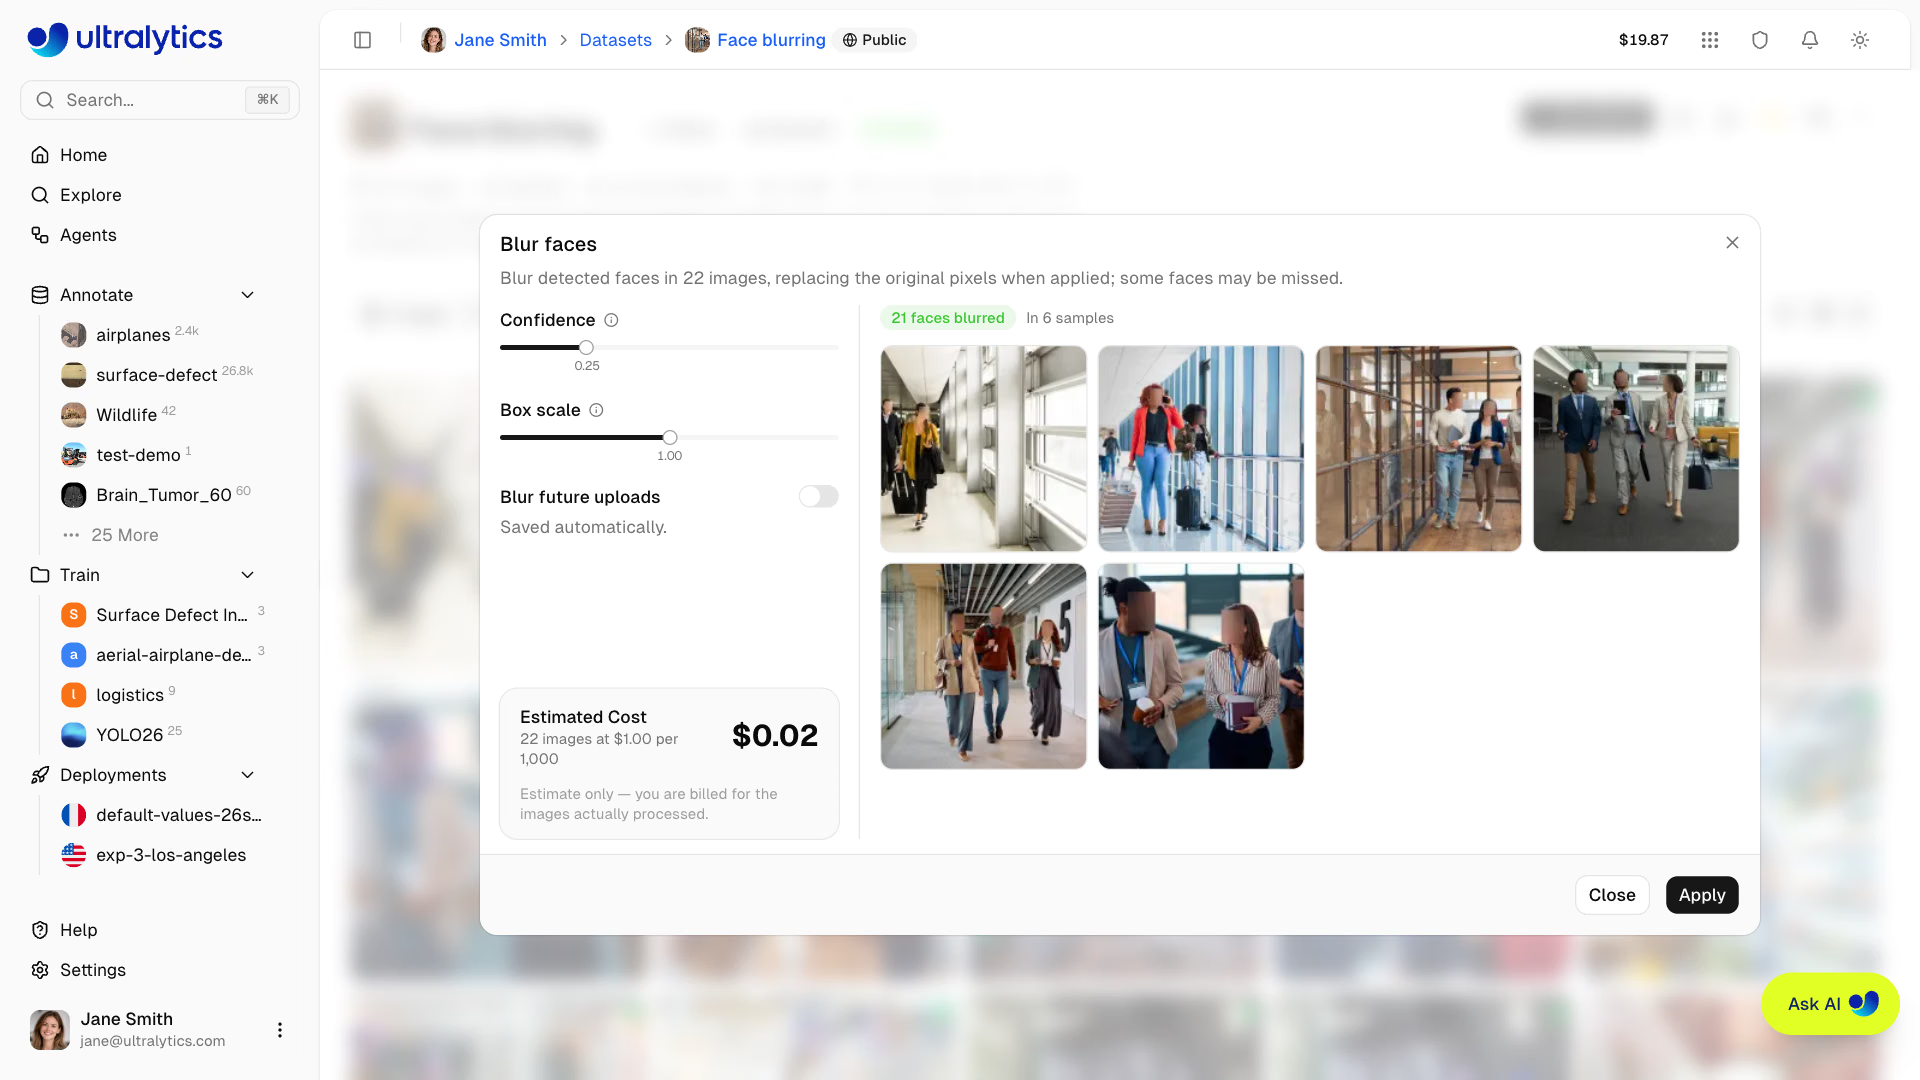
对于其他内容,请在像素离开你的设备之前进行匿名化处理。例如,在叉车项目中,人是旁观者,而不是要检测的类别,因此要将每个人都完全模糊:
from pathlib import Path

import cv2

from ultralytics import YOLO

model = YOLO("yolo26n.pt")  # swap in a plate or face detector for those objects
out = Path("anonymized")
out.mkdir(exist_ok=True)

for result in model.predict("https://ultralytics.com/images/bus.jpg", classes=[0], conf=0.25, verbose=False):
    img = result.orig_img
    for x1, y1, x2, y2 in result.boxes.xyxy.int().tolist():
        img[y1:y2, x1:x2] = cv2.GaussianBlur(img[y1:y2, x1:x2], (51, 51), 0)  # irreversible once saved
    cv2.imwrite(str(out / Path(result.path).name), img)
    print(f"{Path(result.path).name}: blurred {len(result.boxes)} people")
bus.jpg: blurred 4 peopleclasses=[0]将检测范围限制为人物;将predict指向你的帧文件夹,即可批量处理全部帧。conf=0.25的阈值刻意设得较低:出于隐私考虑,多模糊一块区域也比漏掉一个人好。仍要抽查输出,因为检测器可能漏掉较小或被遮挡的人。- 只上传
anonymized/文件夹,并按照你的数据保留政策保存原始文件。
决策规则:如果人物是你要检测的类别,只模糊人脸(使用 Platform 工具),因为模糊整个人体会破坏模型学习所需的信号。如果人物不是要检测的类别,则将旁观者全身模糊。如果你的规则将车牌视为个人数据(EU 和加利福尼亚州通常如此),则遮挡车牌。如果只能将计数或告警发送到站点外,请在边缘设备上运行推理,并发送元数据而非帧。
保留与删除#
| 项目 | 删除后的处理方式 |
|---|---|
| 数据集、项目、模型 | 移至回收站并保留 30 天(仍计入存储空间),随后永久删除 |
| 部署 | 立即永久删除,包括指标和日志历史记录 |
| Monitoring 示例和统计数据 | 保存在端点内存中;停止或重启时即会消失,除非已保存到数据集 |
| 你的账户 | 设置 > 个人资料 > 删除我的账户;团队所有者须先删除或转移团队 |
对于访问请求,设置 > 个人资料中的 导出所有数据 会生成一个包含元数据(个人资料、数据集、项目、模型、活动记录)的 JSON 文件,不包含图像或权重。
发布前合规检查清单#
- 哪些内容会离开客户环境?帧、预测结果,还是仅汇总数据?
- 使用哪个数据区域和哪些部署区域?它们是否都符合合同要求?
- 所有敏感数据集和项目都设为 Private 了吗?检查之前是否有人克隆过公开内容。
- 是否按要求模糊人脸并遮挡车牌?由谁抽查模糊处理遗漏的内容?
- 你是否有权使用这位客户的数据进行训练?如果没有,请将数据保存在独立工作区中。
- 如何应客户要求删除其图像?注明数据集和回收站操作步骤。
- 每个人分别拥有什么角色?谁持有部署 API 密钥?
Ultralytics 在安全页面发布其安全态势信息,包括符合 ISO/IEC 27001:2022 和 SOC 2 Type I 标准的情况。对于任何受监管的部署,请让合规审核人员进行签核。
常见问题#
症状:数据驻留审计发现请求图像在爱荷华州处理。解决方法:数据区域不会限制端点部署位置。请在符合合同要求的区域部署,并在检查清单中列出每个端点所在的区域。
症状:匿名化处理后,人物检测器的召回率骤降。解决方法:模糊整个人体会移除模型学习所需的特征。当人物是目标类别时,只模糊面部;只有当人物是旁观者时,才模糊整个身体。
症状:你将数据集设为私有后,副本仍出现在 Explore 中。解决方法:数据集在公开期间创建的克隆归其所有者所有。对于敏感数据,请将公开视为不可撤销,并在创建时设置可见性。
显示解答
德国药片生产线的参考答案:(1) 帧仅在标注时离开工厂;预测结果会发送到 MES。(2) 数据区域为 EU;端点为 europe-west1。(3) 两个数据集和项目都设为 Private;不存在克隆副本。(4) 操作人员的手和脸有时会出现在画面中:上传时已启用“模糊人脸”,QA 负责人每周抽查 20 张图像。(5) 合同允许使用工厂数据进行训练。(6) 每位客户的图像都保存在各自的数据集中,因此收到删除请求时,需要删除该数据集,然后使用 清空回收站,而不是等待自动删除的 30 天期限。(7) Ravi 是所有者并持有端点密钥;Ana 是编辑者;QA 是查看者。对 20 帧运行 anonymize.py 后模糊了 23 个人;有一名部分被遮挡的操作人员未被检测到,后来经过手动遮挡,因此将阈值降到了 0.15。