可观测性与漂移
记录能发现准确率悄然下降的指标,测试置信度分布是否发生漂移,并且只针对可采取行动的信号发出警报。
视觉服务可能运行正常、速度很快,但结果却是错的。摄像头被碰歪、光线发生变化、新产品系列上线,模型仍在返回框,而所有基础设施仪表盘却一直显示正常。在本课中,将片段调暗以模拟黄昏后,平均置信度仅变化了 0.01,在图表上难以察觉,但双样本 KS 检验却检测到了这一变化,p = 0.007。你将构建这项检查,以及为它提供数据的日志记录功能。
实践操作
信号的三个层次#
| 层次 | 问题 | 信号 |
|---|---|---|
| 基础设施 | 服务是否正常运行并跟得上? | 延迟、吞吐量、丢帧数、CPU 和 GPU 使用率 |
| 模型行为 | 模型的表现是否与上周相同? | 每帧检测数量、平均置信度、类别分布、框的大小 |
| 模型准确率 | 模型的结果是否仍然准确? | 留出集 mAP(性能指标)、抽样人工审核、误报率 |
大多数团队会用标准工具覆盖第一层,然后就此止步。视觉系统往往会在第二层和第三层悄然失效;模型监控指南介绍了完整的维护流程。
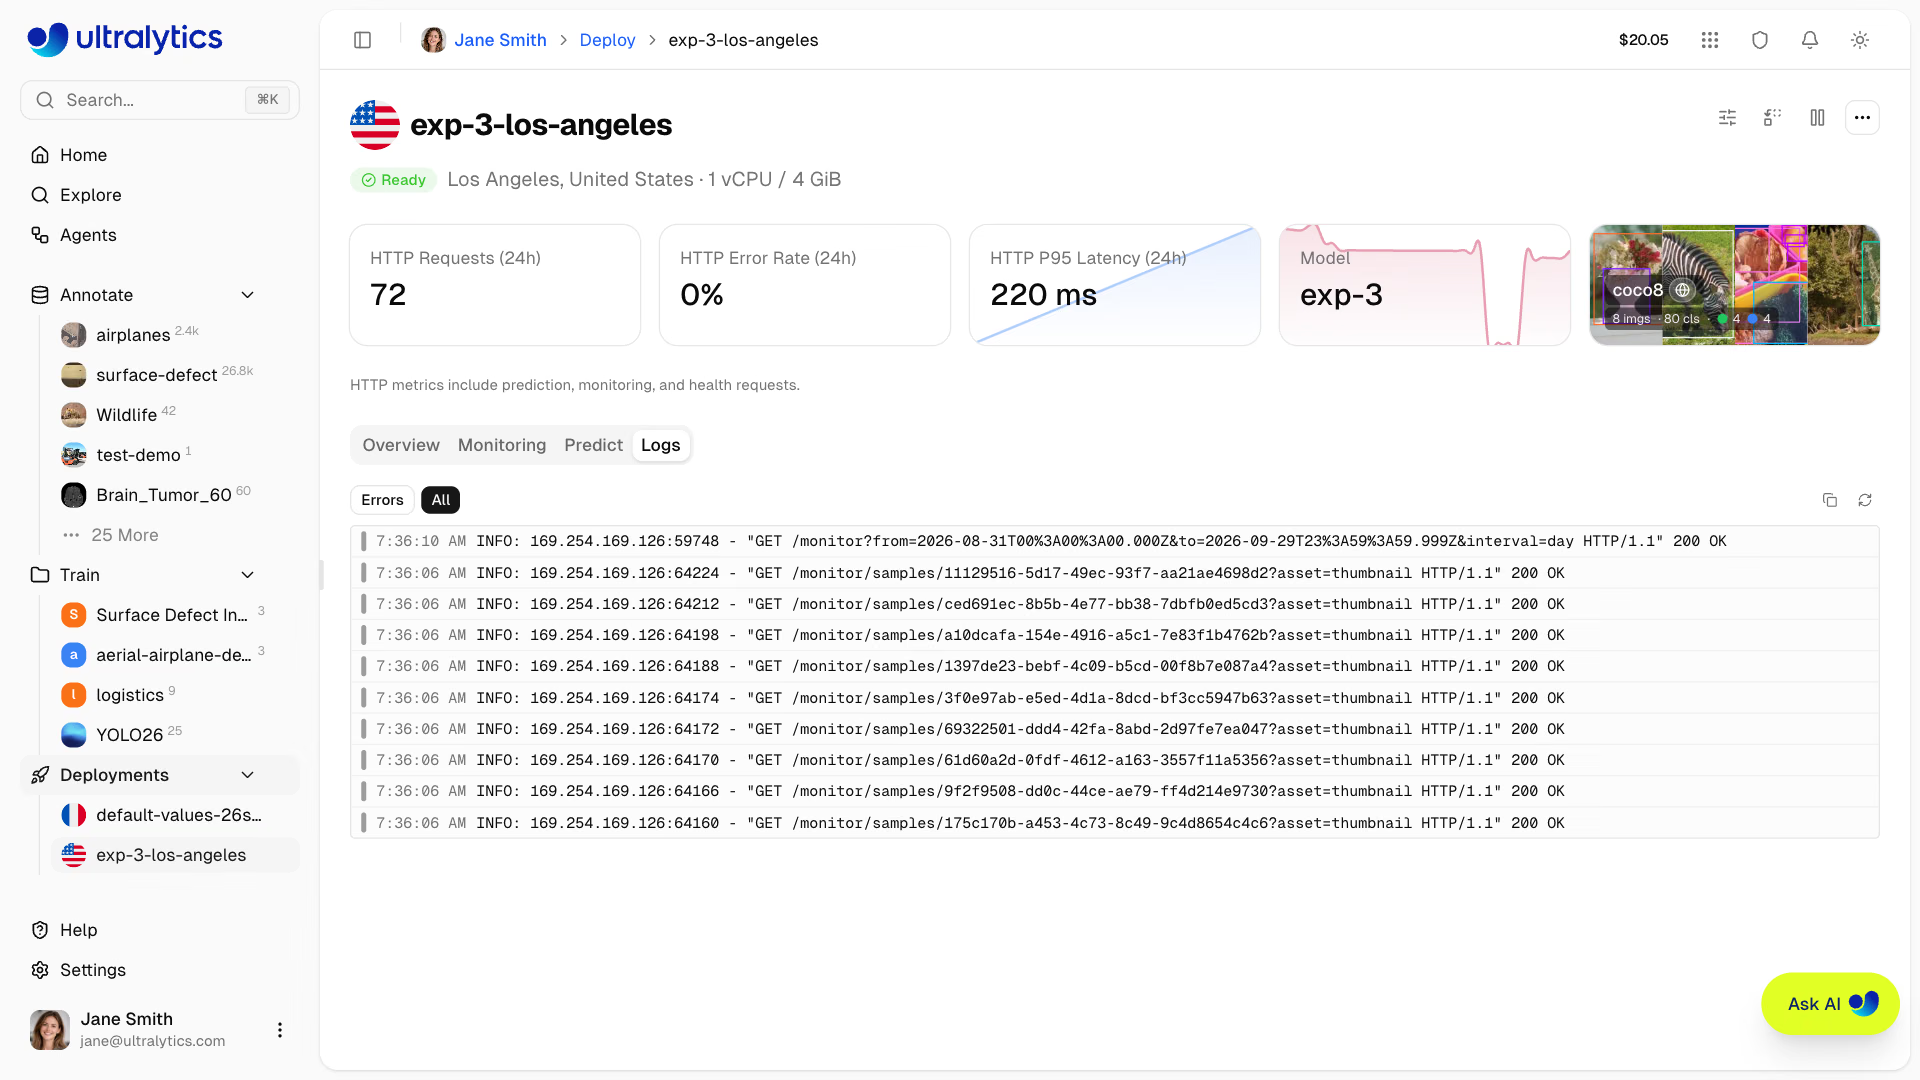
如果你通过 Ultralytics Platform 部署,部署页面会提供基础设施层指标(请求数、错误率、P95 延迟)以及请求日志;你可以像上图那样筛选出错误。其监控运行状况和准确率课程会讲解这些内容。行为层和准确率层需要你自行构建,本课接下来的内容将介绍如何构建。
输出逐帧指标#
每个 Results 对象都包含耗时和框。每帧写入一行 JSON,并将其发送到你使用的指标系统:
import json
import time

from ultralytics import YOLO

model = YOLO("yolo26n.pt")
video = "https://github.com/ultralytics/assets/releases/download/v0.0.0/solutions_ci_demo.mp4"
with open("metrics.jsonl", "w") as log:
    for r in model.predict(video, stream=True, verbose=False):
        conf = r.boxes.conf
        record = {
            "ts": time.time(),
            "camera": "lobby-1",
            "inference_ms": round(r.speed["inference"], 1),
            "detections": len(r.boxes),
            "mean_conf": round(conf.mean().item(), 3) if len(conf) else None,
            "confs": [round(c, 3) for c in conf.tolist()],  # 漂移检验所需的原始值
        }
        log.write(json.dumps(record) + "\n")
print({k: v for k, v in record.items() if k != "confs"})
{'ts': 1792003254.33, 'camera': 'lobby-1', 'inference_ms': 34.7, 'detections': 22, 'mean_conf': 0.543}各字段的用途:
- inference_ms:当 p95 超出预算时发出警报。
- detections:数值突然降至接近零,通常意味着摄像头被遮挡或发生故障;数值激增则意味着场景发生变化或出现误报。
- mean_conf:可快速查看趋势,但单靠它不足以检测漂移。
- confs:完整的置信度分布,下面的漂移测试需要用到它。
检测置信度分布是否发生漂移#
数据漂移会很早就反映在置信度中,远在人们为新数据添加标签之前。上线时收集置信度作为基线,再收集一个近期时间窗口的数据,并用双样本 Kolmogorov-Smirnov 检验(pip install scipy)比较这两个分布。下面的脚本通过调暗同一段视频来模拟黄昏:
import cv2
import numpy as np
from scipy.stats import ks_2samp

from ultralytics import YOLO
from ultralytics.utils.downloads import safe_download

model = YOLO("yolo26n.pt")
video = str(safe_download("https://github.com/ultralytics/assets/releases/download/v0.0.0/solutions_ci_demo.mp4"))

def confidences(darken=1.0):
    """Collect every detection confidence from the clip, optionally darkened to simulate dusk."""
    cap, out = cv2.VideoCapture(video), []
    while True:
        ok, frame = cap.read()
        if not ok:
            break
        out += model((frame * darken).astype(np.uint8), verbose=False)[0].boxes.conf.tolist()
    return np.array(out)

baseline = confidences()  # what "normal" looked like at launch
for name, recent in (("same scene", confidences()), ("dusk (35% brightness)", confidences(darken=0.35))):
    stat, p = ks_2samp(baseline, recent)
    print(f"{name:22s} n={len(recent):4d} mean_conf={recent.mean():.3f} KS={stat:.3f} p={p:.2g}")
same scene n=1376 mean_conf=0.519 KS=0.000 p=1
dusk (35% brightness) n=1337 mean_conf=0.508 KS=0.064 p=0.0068逐行来看:
- 相同场景:分布完全相同,KS 统计量为 0,p = 1,作为对照。
- 黄昏:检测数减少了 39 个,平均值仅降低 0.011,在图表上几乎看不出来。KS 统计量(两个累积分布之间的最大差距)为 0.064,且 p = 0.0068 < 0.01,说明这种偏移确实存在。
漂移警报意味着你应该查看抽样帧,并不代表系统一定出了问题。如果确实发生了漂移,就从受影响的摄像头收集并标注帧:数据收集和标注指南介绍要收集哪些内容,微调指南介绍如何重新训练。边界框尺寸(宽 × 高)也能提供一种简单的漂移信号:摄像头的新安装位置和光学元件会最先体现在尺寸上。
每周验证一次留出集#
行为信号能说明发生了变化;只有标签才能说明准确率是否下降。保留一个包含 200–500 张已标注生产图像的留出集,并在每个模型版本发布时以及每周进行验证:
yolo val model=yolo26n.pt data=coco8.yaml > weekly_metrics.txt # use your production model and holdout YAML持续记录 mAP50-95 和各类别 AP,并在 mAP 每周环比下降超过 1 个点时发出警报。最常见的原因是本应没有变化的模型被替换了;其次是数据漂移。对同一个留出集生成混淆矩阵,就能清楚看出各类别的性能回退。
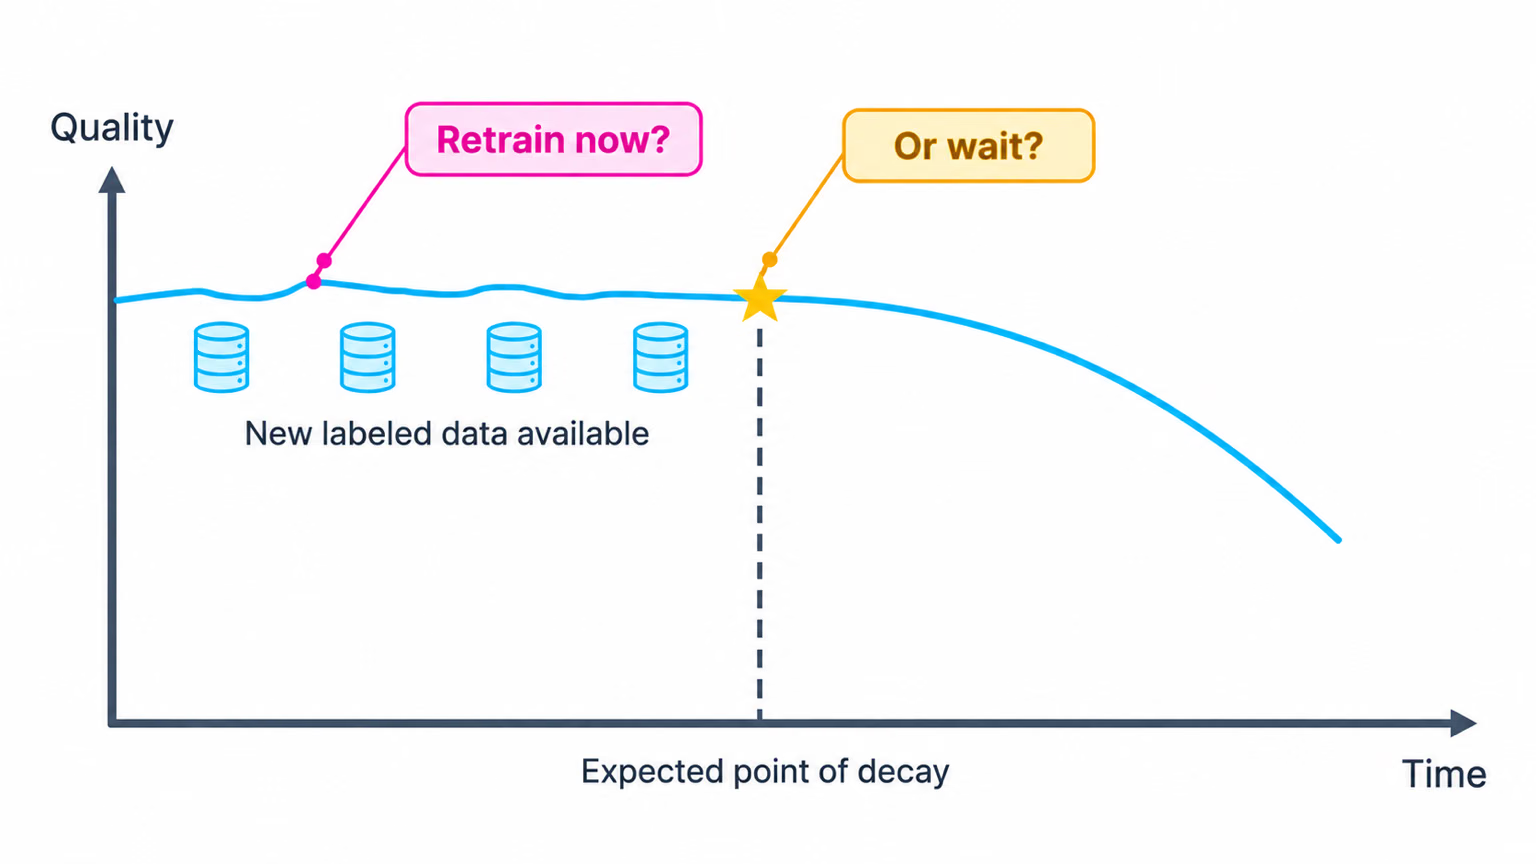
这张图中的问题要由留出集来回答。当留出集显示质量开始下降,或者你从发生漂移的条件下收集到足够的新标注数据时,就重新训练,不要按固定日程安排训练。
根据操作触发警报,而不是只看数字#
| 信号 | 触发条件 | 操作 |
|---|---|---|
p95 inference_ms | 超过预算持续 3 分钟以上 | 扩容,或切换到优化后的导出模型 |
| 每帧检测数 | 下降 50% 以上并持续 5 分钟 | 检查摄像头画面,然后检查模型版本 |
| 丢帧 | 超过 5% 并持续 10 分钟 | 增加容量或降低每路流的 FPS |
| 置信度 KS 检验 | 每日窗口中的 p < 0.01 | 检查帧,然后运行留出集验证 |
| 留出集 mAP50-95 | 每周环比下降 1 个点以上 | 收集数据、添加标签并进行微调 |
常见问题#
症状:KS 检验每晚和每周一都会触发。解决方法:每日和每周周期会带来真实的数据分布变化。应比较同类数据(相同摄像头、相同时段、相同星期几),并使用包含数千次检测的时间窗口。
症状:留出集上的 mAP 看起来不错,用户却报告漏检。解决方法:留出集必须反映当前的生产环境。每个季度都从重要摄像头采集新帧并完成标注,以此更新留出集。
每个告警都需要有明确的后续行动说明。只想观察的信号应放在仪表板上,而不是用于触发寻呼告警。
显示解答
将 monitor.py 输出中第一个健康窗口保留为 baseline.jsonl,然后将每个新窗口与它进行比较:
import json

import numpy as np
from scipy.stats import ks_2samp

def load(path):
    """Flatten the per-frame 'confs' lists written by monitor.py."""
    with open(path) as f:
        return np.array([c for line in f for c in json.loads(line)["confs"]])

baseline, recent = load("baseline.jsonl"), load("metrics.jsonl")
stat, p = ks_2samp(baseline, recent)
print(f"KS={stat:.3f} p={p:.2g} -> {'review frames' if p < 0.01 else 'ok'}")
KS=0.000 p=1 -> ok如果两个文件来自同一段视频,这就是预期结果。通过调度程序每天运行一次,将统计量和 p 值发送到与逐帧日志相同的指标系统,并将 review frames 发送给相关人员,而不是寻呼系统。