CPU 上的 OpenVINO
导出 FP32、FP16 和 INT8 OpenVINO 模型,逐一验证,并且只在自有 CPU 上确实有收益时才保留 INT8。
你现有的 Intel CPU 通常可以替代 GPU 实例:在 Ultralytics 基准测试中,YOLO26m 使用 PyTorch 时为 192 毫秒,使用 OpenVINO INT8 时在笔记本电脑的 Core Ultra CPU 上降至 36 毫秒。不过,收益取决于芯片;在本课程使用的 ARM 测试笔记本上,使用四张图像校准的 INT8 导出版本损失了 3 个 mAP 点。你将学会在发布之前判断自己属于哪种情况。
实践操作
OpenVINO 的优势#
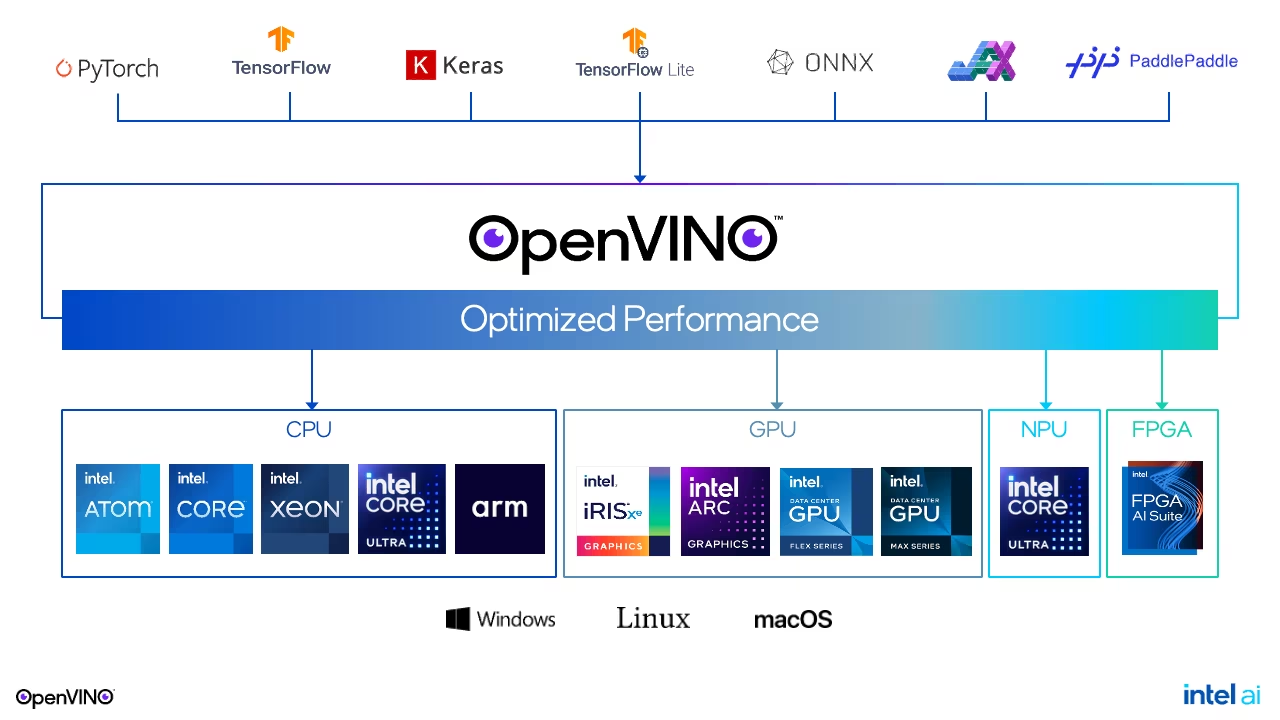
OpenVINO 可以处理来自 PyTorch 和 ONNX 的模型,并通过一个 API 在 Intel CPU、集成和独立 GPU 以及 NPU 上运行。其 CPU 内核针对 Intel 指令集(AVX2、AVX-512、AMX)进行了优化,INT8 路径也已成熟。注意 CPU 栏中的 ARM 方块:OpenVINO 也能在 ARM 上运行,但其内核针对 Intel 进行了调优,因此在 ARM 上依赖它之前应先进行测量。
已公布的 Intel Core Ultra 7 155H CPU 基准测试结果(COCO128):
| 模型 | PyTorch FP32 | OpenVINO FP32 | OpenVINO INT8 | mAP50-95 FP32 → INT8 |
|---|---|---|---|---|
| YOLO26n | 33.19 ms | 13.43 ms | 11.40 ms | 0.4734 → 0.4611 |
| YOLO26s | 70.92 ms | 36.16 ms | 15.54 ms | 0.5632 → 0.5471 |
| YOLO26m | 192.45 ms | 102.52 ms | 35.72 ms | 0.6191 → 0.6025 |
从该表可以得出三条规律:
- 仅使用 OpenVINO FP32,就能让 Intel CPU 上的 PyTorch 延迟大致减半。先尝试这一方案。
- 模型越大,INT8 的收益越明显:
n提速 1.2 倍,m提速 2.9 倍,代价是损失 1.2–1.7 个 mAP 点。对于n,INT8 的精度损失通常不值得。 - 购买硬件之前,先试试集成 GPU:同一芯片上的 Arc iGPU(
device="intel:gpu")运行 YOLO26n FP32 用时 9.13 毫秒,运行 YOLO26m 用时 34.47 毫秒。
在自己的 CPU 上比较不同精度#
导出每种精度后立即验证,通过后再导出下一种:
from ultralytics import YOLO

if __name__ == "__main__":  # validation starts worker processes on macOS and Windows
    model = YOLO("yolo26n.pt")  # or runs/detect/pills_v1/weights/best.pt
    for name, quantize in (("FP32", None), ("FP16", 16), ("INT8", 8)):
        path = model.export(format="openvino", quantize=quantize, data="coco8.yaml")  # or my_dataset/data.yaml
        m = YOLO(path).val(data="coco8.yaml", batch=1, plots=False, verbose=False)  # before the next export overwrites it
        print(f"{name}: mAP50-95 {m.box.map:.4f}  -> {path}")
OpenVINO: export success ✅ 2.3s, saved as 'yolo26n_openvino_model/' (9.6 MB)
FP32: mAP50-95 0.6783 -> yolo26n_openvino_model/
OpenVINO: export success ✅ 1.6s, saved as 'yolo26n_openvino_model/' (5.1 MB)
FP16: mAP50-95 0.6783 -> yolo26n_openvino_model/
WARNING ⚠️ OpenVINO: >300 images recommended for INT8 calibration, found 4 images.
OpenVINO: export success ✅ 11.3s, saved as 'yolo26n_int8_openvino_model/' (3.2 MB)
INT8: mAP50-95 0.6460 -> yolo26n_int8_openvino_model/每一行的含义:
- FP32 和 FP16 的得分相同,而 FP16 的体积只有一半(5.1 MB 对 9.6 MB),但两者都写入了同一个文件夹。如果先导出两者再验证,你就会把 FP16 测量两次。
- INT8 文件为 3.2 MB,但损失了 3.2 个百分点,因为它使用 COCO8 的四张图像进行了校准。警告信息已说明这一点:实际校准需要数百张来自你自己的 YAML、接近生产环境的图像(
fraction会限制实际使用的图像数量)。 - 以上都没有测量速度。速度请使用下方的基准测试。
要在指定的 Intel 设备上运行导出的模型:
from ultralytics import YOLO

ov_model = YOLO("yolo26n_openvino_model/")
results = ov_model("https://ultralytics.com/images/bus.jpg", device="intel:cpu") # or intel:gpu, intel:npu发布整个文件夹:yolo26n.xml(计算图)、yolo26n.bin(权重)和 metadata.yaml。intel:gpu 和 intel:npu 需要 Intel 硬件。
与 ONNX Runtime 对比运行时间#
精度已确定;速度要在目标设备上、并在实际负载下评估。使用第一课中的 pick_runtime.py 和 CANDIDATES = ("onnx", "openvino") 运行。在 Apple 芯片测试笔记本上,当 CPU 由其他任务共享时:
onnx      p50  30.0 ms  p95  46.4 ms  misses the 30 ms budget
openvino  p50  22.8 ms  p95 113.5 ms  misses the 30 ms budget
OpenVINO 的中位数表现更好,但尾部延迟差得多。Ultralytics 封装器使用 LATENCY 提示编译 OpenVINO(日志中会显示 Using OpenVINO LATENCY mode for batch=1 inference on CPU),这会让每个请求分摊到 CPU 的各个核心上;当其他任务争用这些核心时,最慢的请求受影响最大。在专用 Intel 设备上,表现通常接近上方公布的数据,但只有你自己的 p95 数据才能说明实际情况。
决策规则:
常见问题#
症状:FP16 导出文件体积减半,速度却完全没变。解决方法:大多数 CPU 上,插件会自行选择执行精度;使用 FP16 可以减小下载体积,想要提速则使用 INT8 或 iGPU。
症状:FP32 和 FP16 报告的数值完全相同,因为它们其实是同一个文件。解决方法:FP32 和 FP16 导出文件共用 *_openvino_model/ 文件夹;每次导出后立即验证(或重命名文件夹)。
症状:平均值看起来不错,但繁忙时仍会掉帧。解决方法:在生产负载运行时测量推理耗时,并根据 p95 而非平均值做判断。如果一台服务器上有多个视频流,按照延迟与吞吐量模式指南,直接使用 OpenVINO 运行时加载 .xml,并以 THROUGHPUT 提示进行编译。
在 macOS 和 Windows 上,验证会启动工作进程并重新导入你的脚本。如果没有 if __name__ == "__main__":,本课程的测试运行会在这些工作进程中重复执行导出,浪费数分钟,还会与正在测量的任务争用 CPU。
显示解答
python ov_compare.py    # accuracy and size of FP32, FP16, INT8
python pick_runtime.py  # p50 and p95 for ONNX Runtime and OpenVINO
下面是基于上述 Core Ultra 7 155H 数据的具体决策示例:
| 选项 | mAP50-95 | 规模 | 毫秒/张图像 |
|---|---|---|---|
| OpenVINO FP32 | 0.4734 | 9.6 MB | 13.43 |
| OpenVINO INT8 | 0.4611 | 3.2 MB | 11.40 |
集成 GPU FP32 (intel:gpu) | 0.4758 | 9.6 MB | 9.13 |
部署 集成 GPU 上的 OpenVINO FP32:这是最快的选项,而且没有精度损失;而 CPU 上的 INT8 虽然能节省 2 毫秒,却会损失 1.2 个百分点。在 YOLO26m 部署中,结论则会反过来:选择 CPU INT8(快 2.9 倍,损失 1.7 个百分点),前提是这种损失在你的预算范围内。