多路流推理
通过批量推理、有界队列和帧丢弃测量,让一个模型处理多个摄像头。
一个能跟上单个摄像头的系统,在接入四个摄像头后可能会落后数分钟,而且不会发生崩溃:结果只是越来越晚才到达,直到内存耗尽。在这里使用的笔记本电脑 CPU 上,一个 30 FPS 视频流可以跟上,四个视频流会丢掉一半帧,八个则会丢掉三分之二以上。本课程将构建用于测量这一指标的流水线,因为这个指标决定了如何配置硬件。
实践操作
时间都花在哪里#
每一帧都要经过四个阶段:
| 阶段 | 典型耗时 | 运行设备 |
|---|---|---|
| 解码(RTSP 或文件 → 数组) | 每个 1080p 帧耗时 5–20 ms | CPU |
| 预处理(letterbox、归一化) | 约 1 ms | CPU |
| 推理 | GPU 上几毫秒,CPU 上几十毫秒 | 加速器 |
| 后处理、跟踪、数据输出 | 几毫秒;数据库较慢时耗时更长 | CPU |
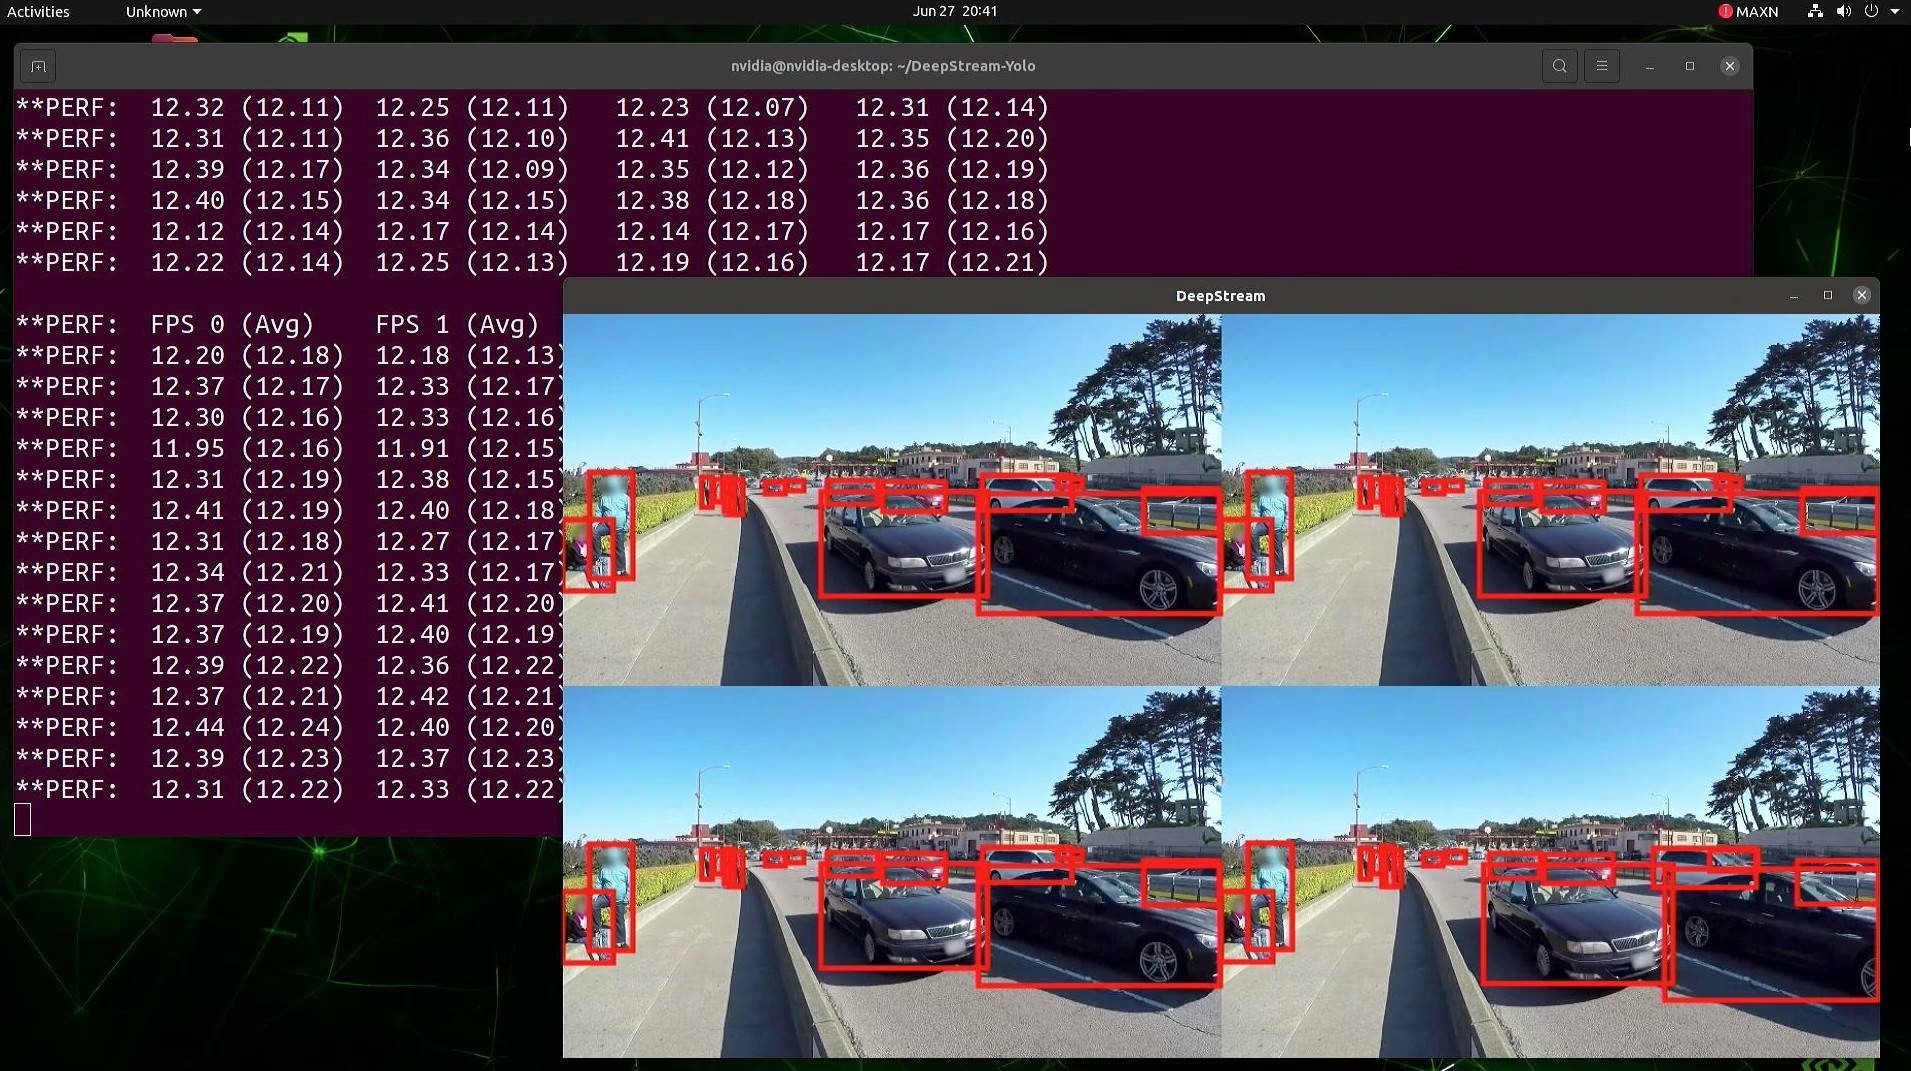
如果在一个线程中逐个摄像头依次运行这些阶段,那么解码帧时加速器就会空闲。解决方法是将各个阶段分开,这正是上方 DeepStream 流水线的做法:四路视频流共用一个设备,每路分别报告自己的 FPS(这里约为 12)。Python 中也可以采用相同结构:
内置方式:.streams 文件#
Ultralytics 会为你批处理多个数据源。在 .streams 文件中每行写一个数据源,然后传给 Predict 或 Track 模式。每个视频流都有自己的读取器线程和跟踪器,每次迭代都会对所有视频流执行一次批量前向传播:
from collections import Counter
from pathlib import Path

from ultralytics import YOLO
from ultralytics.utils.downloads import safe_download

base = "https://github.com/ultralytics/assets/releases/download/v0.0.0/"
clips = [safe_download(base + name) for name in ("solutions_ci_demo.mp4", "ground-vehicles-airport.mp4")]
Path("cams.streams").write_text("\n".join(str(c) for c in clips))  # 生产环境:每行一个 rtsp:// URL

model = YOLO("yolo26n.pt")  # 在生产环境中使用优化后的导出模型
frames = Counter()
for r in model.track("cams.streams", stream=True, stream_buffer=True, tracker="bytetrack.yaml", verbose=False):
    frames[Path(r.path).name] += 1  # r.path 会告诉你此结果来自哪个视频流
print(frames)
Counter({'solutions_ci_demo.mp4': 62, 'ground-vehicles-airport.mp4': 62})两个视频流都产生了 62 个结果,因为迭代会在最短的视频流结束时停止(机场片段有 150 帧)。stream_buffer=True 处理了每一帧,这适合录制文件;对于实时摄像头,应保留默认的 False,这样模型较慢时会跳过过时帧,而不是不断落后。结合 TensorRT 或 OpenVINO 导出模型,可获得最佳的单路视频流吞吐量。
自定义方式:使用丢帧计数器的生产者-消费者模式#
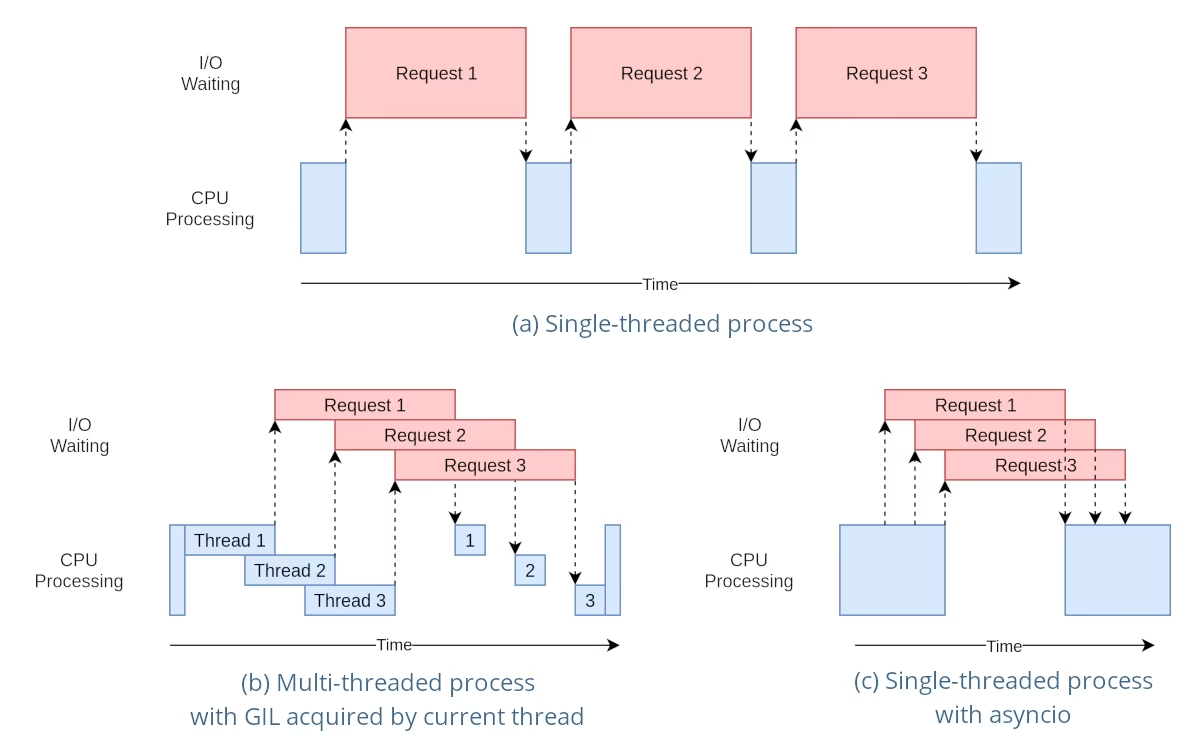
这张图说明了为什么线程适用于这条流水线。解码过程大多是在等待(粉色的 I/O 条),而 OpenCV 和 PyTorch 在工作时会释放 Python 的 GIL,因此解码器线程可以很好地并行执行(图 b)。繁重的 Python 后处理无法并行;应将其移到独立进程中。
如果你需要自定义数据输出端、逐摄像头逻辑或明确的丢帧指标,可以自行构建流水线。解码器线程不会接触模型;模型由一个消费者循环独占,这也能确保你遵守线程安全推理规范:
import queue
import threading
import time

import cv2

from ultralytics import YOLO
from ultralytics.utils.downloads import safe_download

base = "https://github.com/ultralytics/assets/releases/download/v0.0.0/"
SOURCES = [str(safe_download(base + n)) for n in ("solutions_ci_demo.mp4", "ground-vehicles-airport.mp4")]
frames = queue.Queue(maxsize=16)  # bounded: memory and latency stay flat under overload
dropped = [0] * len(SOURCES)

def decode(stream_id, source):
    """Producer: read frames at the camera's pace and never block on a full queue."""
    cap = cv2.VideoCapture(source)
    interval = 1 / (cap.get(cv2.CAP_PROP_FPS) or 30)
    while True:
        ok, frame = cap.read()
        if not ok:
            break
        try:
            frames.put_nowait((stream_id, frame))
        except queue.Full:
            dropped[stream_id] += 1  # consumer is behind: drop rather than serve stale frames
        time.sleep(interval)  # pace files like a live camera; remove for RTSP sources
    cap.release()

model = YOLO("yolo26n.pt")  # one model, used only by the consumer loop below
model.predict("https://ultralytics.com/images/bus.jpg", verbose=False)  # warm up before cameras start

decoders = [threading.Thread(target=decode, args=(i, s), daemon=True) for i, s in enumerate(SOURCES)]
for t in decoders:
    t.start()

processed = [0] * len(SOURCES)
while any(t.is_alive() for t in decoders) or not frames.empty():
    batch = []
    while len(batch) < 8:  # gather up to 8 frames from any camera
        try:
            batch.append(frames.get(timeout=0.05))
        except queue.Empty:
            break
    if not batch:
        continue
    results = model([frame for _, frame in batch], verbose=False)  # one batched forward pass
    for (stream_id, _), r in zip(batch, results):
        processed[stream_id] += 1  # per-stream postprocessing and sinks go here

print(f"processed={processed} dropped={dropped}")
processed=[56, 131] dropped=[6, 19]两个片段分别有 62 帧和 150 帧,每一帧都已处理或丢弃(56 + 6 = 62,131 + 19 = 150),因此计数器涵盖了所有帧。212 帧中有 25 帧被丢弃:这台笔记本电脑的 CPU 无法在两个 30 FPS 视频流上使用 PyTorch 运行 yolo26n。通过重复播放片段来模拟更多摄像头,并进行一次遍历:
| 视频流数量(每路 30 FPS) | 丢弃帧数 |
|---|---|
| 1 | 0% |
| 2 | 12% |
| 4 | 51% |
| 8 | 69% |
根据测量结果规划容量#
每台设备可处理的视频流数量 ≈ 持续吞吐量(模型按你的批大小每秒处理的帧数)÷ 每路视频流所需的 FPS。使用前几课中介绍的优化导出模型,在实际硬件上测量吞吐量,并预留 20–30% 的余量应对峰值;丢帧数一旦大于零就发出警报。分辨率越高,计算开销大致按像素数增长:1280×1280 的计算量约为 640×640 的 4 倍。对于大规模设备集群,Triton Inference Server 和 Jetson 上的 DeepStream 是理想的生产环境方案。
常见问题#
症状:model.track(["cam1.mp4", "cam2.mp4"]) 会将列表视为图像批次,而不是视频流。解决方法:将各个数据源写入 .streams 文件,每行一个。
症状:每个文件只输出一两帧。解决方法:stream_buffer=False 会丢弃过期帧,而文件读取器会抢在模型前面处理;对文件设置 stream_buffer=True,对实时摄像头则保留默认值。
症状:负载较高时偶尔出现错误或混杂的结果。解决方法:不要让多个线程同时调用同一个 YOLO 实例。可以像上文那样让一个消费者独占该实例,或在每个推理线程中创建一个模型。
症状:延迟逐分钟增加,内存持续攀升,直到进程崩溃。解决方法:使用有界队列,并在队列满时丢弃帧,同时统计丢帧数。实时系统过载时应该丢帧,而不是让延迟不断累积。
显示解答
在 producer_consumer.py 中的 SOURCES 行后立即添加以下代码行,将视频流数量设为命令行参数:
import sys

N = int(sys.argv[1]) if len(sys.argv) > 1 else 2  # 模拟摄像头数量
SOURCES = [SOURCES[i % len(SOURCES)] for i in range(N)]
然后逐步增加数量:
for n in 1 2 4 8; do python producer_consumer.py $n; doneprocessed=[62] dropped=[0]
processed=[56, 131] dropped=[6, 19]
processed=[23, 82, 23, 81] dropped=[39, 68, 39, 69]
processed=[14, 53, 13, 53, 13, 52, 13, 53] dropped=[48, 97, 49, 97, 49, 98, 49, 97]这台机器的答案是一路视频流:从两路开始出现丢帧。要处理四个摄像头,可以导出到速度更快的运行时(第 3 和第 4 课),降低 imgsz,或改用加速器,然后重新测试。