使用 TensorRT 优化
构建 FP16 TensorRT 引擎,判断 INT8 带来的精度损失是否值得,并在发布前对引擎进行准入检查。
在 NVIDIA GPU 上,TensorRT FP16 引擎通常是最划算的提速方式:在 Ultralytics A100 基准测试中,速度约提升 1.5 倍,mAP 没有变化。INT8 提速更多,但经训练后量化的 YOLO26s 到 YOLO26m 在 COCO 上损失了 4 到 6 个 mAP 点。本课将讲解如何判断当前要采取哪一步,并在用户发现问题之前完成测量。
实践操作
本课程中的代码需要安装了 TensorRT 的 NVIDIA GPU。文中展示的每个参数都列在导出模式文档中 format=engine 对应的部分。
FP16 是稳妥的第一步#
Volta 及更新架构的 NVIDIA GPU 配备 FP16 张量核心,而且检测模型推理时很少需要 FP32。可以从这里开始:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")  # or runs/detect/pills_v1/weights/best.pt
model.export(format="engine", quantize=16, workspace=4)  # FP16 引擎,构建器工作区最大 4 GiB
workspace 限制 TensorRT 构建时可使用的 GPU 内存;不设置该参数则由 TensorRT 自行决定。TensorRT 集成页面公布了以下 A100 测试结果(YOLOv8n,640 像素):
| 精确率 | 预测,批次大小 8(毫秒) | COCO val mAP50-95 |
|---|---|---|
| FP32 | 0.52 | 0.37 |
| FP16 | 0.34 | 0.37 |
| INT8 | 0.28 | 0.33 |
这个模型比 YOLO26 老,但精度与速度之间的权衡趋势依然成立:FP16 免费提速约 1.5 倍;INT8 又提速 1.2 倍,但损失了 4 个百分点。如果 FP16 已满足你的预算,就发布它。
没有本地 NVIDIA GPU?Ultralytics Platform 的 Export 选项卡可以在你选择的云 GPU 上构建引擎,并提供相同的图像尺寸、精度、批次、动态、NMS 和工作区选项:

选择你要部署到的 GPU 系列:截图中的引擎是在 RTX 5090 上构建的,只能在该系列 GPU 上运行。
INT8 需要校准数据#
INT8 量化会将每一层的激活值映射到 256 个级别。为了确定映射范围,导出器会将校准图像输入模型并记录观测到的激活值,因此图像必须与生产环境中的数据相似:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
model.export(
    format="engine",
    quantize=8,
    data="coco128.yaml",  # 校准图像来自此数据集的 val 划分;使用 my_dataset/data.yaml
    fraction=1.0,  # 要使用的图像占比(或数量)
    batch=8,  # 较大的校准批次能让范围更稳定
    dynamic=True,  # 使用 batch=8 时,引擎可接受 1 到 8 的批次大小
    workspace=4,
)
INT8 带来的损失取决于模型。导出模式文档测量了 YOLO26 TensorRT 引擎在 COCO val 上的表现(mAP50-95):
| 模型 | FP32 引擎 | INT8,已校准(PTQ) | 量化感知训练(QAT)后的 INT8 |
|---|---|---|---|
| YOLO26n | 0.4032 | 0.3934 | 0.3935 |
| YOLO26s | 0.4794 | 0.4412 | 0.4711 |
| YOLO26m | 0.5269 | 0.4696 | 0.5137 |
仅校准就让 YOLO26n 损失 1 个百分点,让较大的模型损失 4–6 个百分点。QAT 会在 train 中使用 quantize=8 对模型进行微调,使其权重能够适应 INT8;检查点会携带自身的范围,导出 INT8 时不需要校准数据,精度与 FP32 相差 1–2 个百分点。具体决策如下:
发布前对引擎进行准入检查#
每个引擎都必须在部署 GPU 上通过相同的检查:
| 检查项 | 准入检查项 |
|---|---|
| 验证集上的 mAP50-95 | FP16 与 FP32 的差距在 0.5 个百分点以内;INT8 符合你书面规定的预算 |
| 各类别 AP | 没有类别的 AP 下降超过约 1 个百分点(小类别的波动最大) |
| p95 延迟 | 在生产批次大小下低于预算 |
| 运行阈值 | 根据引擎自身的 F1 曲线重新选择 conf |
| 确定性 | 对同一张图像运行两次,得到完全相同的框 |
yolo val model=yolo26n.engine data=coco8.yaml  # or my_dataset/data.yaml
yolo benchmark model=yolo26n.pt data=coco8.yaml imgsz=640 format=engine quantize=16提速从何而来#
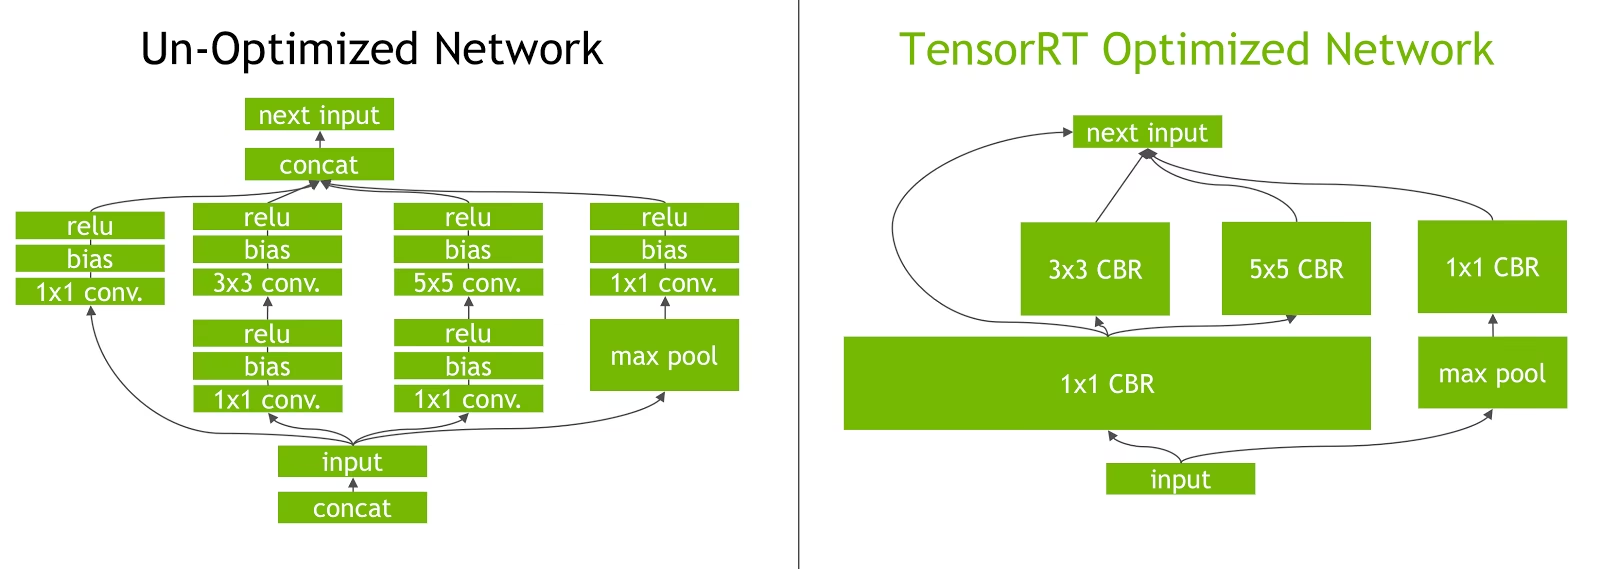
TensorRT 将每个卷积、偏置和 ReLU 融合到一个内核中(右侧的“CBR”块),并省去拼接步骤,因此 GPU 启动的内核大幅减少,数据传输量也更少。在 YOLO26 中,这种优化在整个网络的 conv-BN-activation 链、主干网络中的注意力(PSA)模块,以及检测头的大量小型算子上都能发挥作用。如果引擎仍然很慢,可以使用 trtexec 或 NVIDIA Nsight 对其进行性能分析:通常某一层会占用 30% 或更多的时间。
常见问题#
症状:INT8 在 COCO 上损失 1 个点,在你的摄像头数据上损失 6 个点。解决方法:使用你自己的验证集中的留出数据进行校准;NVIDIA 建议至少使用 500 张有代表性的图像。校准结果也因设备而异,因此要在实际部署所用的 GPU 上校准。
症状:在相同的 conf 下切换到 INT8 后,召回率下降。解决方法:INT8 可能会改变置信度值;根据 INT8 引擎自己的 F1 曲线重新选择 conf。
症状:引擎在部署设备上反序列化失败,或运行速度低于预期。解决方法:在部署所用的 GPU 系列上构建,并使用匹配的 TensorRT 和 CUDA 运行时;同时交付 .onnx,以便设备能够重新构建。如果校准在构建期间崩溃,则增大 workspace,或减小 imgsz 或 batch。
在 Jetson 上,DeepStream 会在硬件加速的视频管线中运行生成的引擎;在数据中心,Triton Inference Server 可为其提供服务。
显示解答
from ultralytics import YOLO

if __name__ == "__main__":  # validation starts worker processes on Windows
    data = "coco8.yaml"  # or my_dataset/data.yaml
    model = YOLO("yolo26n.pt")
    engine = model.export(format="engine", quantize=16, workspace=4)

    base = model.val(data=data, plots=False).box.map
    fp16 = YOLO(engine).val(data=data, plots=False).box.map
    print(f"PyTorch {base:.4f}  FP16 engine {fp16:.4f}  gap {abs(base - fp16) * 100:.2f} points")

    # Only if FP16 misses the latency budget:
    # model.export(format="engine", quantize=8, data=data, batch=8, dynamic=True, workspace=4)
一份通过检查的报告应显示:差距小于 0.5 个百分点,p95 低于预算,决策为发布 FP16。如果 p95 未达标,就使用自己的校准 YAML 导出 INT8,重新运行相同的两条命令;只有差距仍在开始前写明的预算范围内时才发布 INT8,否则尝试 QAT 或使用更小的模型。