成本与延迟调优
分析整个流水线的性能,按顺序调整真正影响延迟和成本的杠杆,并在达到预算时停止。
团队花上几周时间从模型中挤出几毫秒,却没发现真正的瓶颈是数据库写入或 RTSP 解码器。影响最大的杠杆不多,而且都有充分的测量依据:在 CPU 上,YOLO26s 的运行时间是 YOLO26n 的 2.2 倍,但 mAP 高出 7.7 个点;每隔一帧运行一次检测,工作量就能减半。本课将教你先分析性能,再调整最有效且符合要求的杠杆,并在预先设定的预算范围内停止。
实践操作
先测量整个流水线#
每个 Results 对象都会将自身耗时拆分为多个阶段:
from ultralytics import YOLO

model = YOLO("yolo26n.pt")
video = "https://github.com/ultralytics/assets/releases/download/v0.0.0/solutions_ci_demo.mp4"
totals = {"preprocess": 0.0, "inference": 0.0, "postprocess": 0.0}
for n, r in enumerate(model.predict(video, stream=True, verbose=False), 1):
    for stage in totals:
        totals[stage] += r.speed[stage]
print({stage: round(ms / n, 1) for stage, ms in totals.items()}, "ms per frame")
{'preprocess': 0.7, 'inference': 36.1, 'postprocess': 0.7} ms per frame这里的推理耗时占模型总耗时的 95%,因此调整模型相关杠杆会有帮助。以同样方式测量解码和你自己的输出耗时(在每个部分周围添加 time.perf_counter()),然后根据测量结果采取相应措施:
| 测量结果 | 优先处理 |
|---|---|
| RTSP 解码耗时 60 ms,推理耗时 5 ms | 使用硬件解码、降低流分辨率,或增加解码器线程 |
| 推理耗时 30 ms,Python 后处理耗时 100 ms | 使用 NumPy 向量化处理,或将处理移至工作进程 |
| 推理耗时 5 ms,数据库写入耗时 200 ms | 批量写入,或改为异步写入 |
| 推理占主要耗时 | 参见下方的杠杆排行榜 |
杠杆排行榜#
从最上方开始尝试,达到预算要求后就停止:
| 优化手段 | 典型加速幅度 | 典型准确率代价 |
|---|---|---|
| 更小的模型(m → s、s → n) | 1.5–2.5× | 在 COCO 上 mAP 降低 4.5–7.7 个点;在窄领域任务上降幅较小 |
更小的 imgsz(640 → 480) | 约 1.8× | 小型和远距离物体会最先受影响 |
| 更快的运行时、FP16 | 在 GPU 上约 1.5× | 通常没有影响;请验证结果是否一致 |
| 使用校准的 INT8 | 在 GPU 上进一步提升 1.2×;在 CPU 上最高可达 2.9× | YOLO26n 降低 1 个点,较大模型降低 4–6 个点;QAT 可恢复大部分损失 |
减少帧数(vid_stride=N) | 最高可达 N× | 可能漏掉快速移动的物体和持续时间短的事件 |
| 增大批次(服务器) | 提高吞吐量,而不是降低延迟 | 无 |
这些数字来自 YOLO26、TensorRT 和 OpenVINO 基准测试表以及下方的测量结果;你的结果会有所不同,因此请自行测量。
更小的模型#
COCO 上的 YOLO26 基准测试表:
| 模型 | mAP50-95 | CPU ONNX(毫秒) | T4 TensorRT10(毫秒) |
|---|---|---|---|
| YOLO26n | 40.9 | 38.9 | 1.7 |
| YOLO26s | 48.6 | 87.2 | 2.5 |
| YOLO26m | 53.1 | 220.0 | 4.7 |
在 CPU 上,每降低一个型号,速度就会提升 2.2–2.5 倍。COCO 上的准确率差距属于最坏情况:与面向 80 类目标的通用检测器相比,只检测 3 类大型物体的仓库检测器从 m 换到 n 通常损失小得多,因此始终值得在你自己的 val 集上测试较小的模型。
更小的输入尺寸#
计算量大致随像素数变化,因此 imgsz=480 所需的计算量约为 640 输入尺寸的 56%。测试环境为测试笔记本的 CPU,使用 ONNX Runtime,批次大小为 1(在 bus.jpg 上运行 25 次取中位数):
| 模型 | 640 | 480 | 320 |
|---|---|---|---|
| YOLO26n | 21.3 ms | 12.1 ms | 7.1 ms |
| YOLO26s | 55.0 ms | 24.2 ms | 12.9 ms |
判断标准:如果新的尺寸下,最小且重要的物体仍约有 10 像素或更大,就可以尝试;如果物体较小或距离较远(例如无人机、远离摄像头的货架),就保留当前分辨率,改用更小的模型。
减少帧数#
如果推理限制了帧率,而且场景中的运动较慢,可以使用 vid_stride=N 每隔 N 帧运行一次检测,并让跟踪器补上间隔:
import time

from ultralytics import YOLO

model = YOLO("yolo26n.pt")
video = "https://github.com/ultralytics/assets/releases/download/v0.0.0/solutions_ci_demo.mp4"
model.predict(video, vid_stride=30, verbose=False)  # warm up so the first timing is fair

for stride in (1, 2, 3):
    start, ids, frames = time.perf_counter(), set(), 0
    for r in model.track(video, stream=True, vid_stride=stride, tracker="bytetrack.yaml", classes=[0], verbose=False):
        frames += 1
        if r.boxes.is_track:
            ids.update(r.boxes.id.int().tolist())
    print(f"vid_stride={stride}: {frames} frames in {time.perf_counter() - start:.2f} s, {len(ids)} person IDs")
vid_stride=1: 62 frames in 2.66 s, 32 person IDs
vid_stride=2: 31 frames in 1.19 s, 30 person IDs
vid_stride=3: 20 frames in 0.95 s, 28 person IDs处理一半的帧,耗时大约减半,而跟踪器保留了 32 个身份中的 30 个。使用 vid_stride=3 时,它丢失了 4 个身份;对于这个步行速度的场景,这就是该停止优化的信号。
降低云端成本#
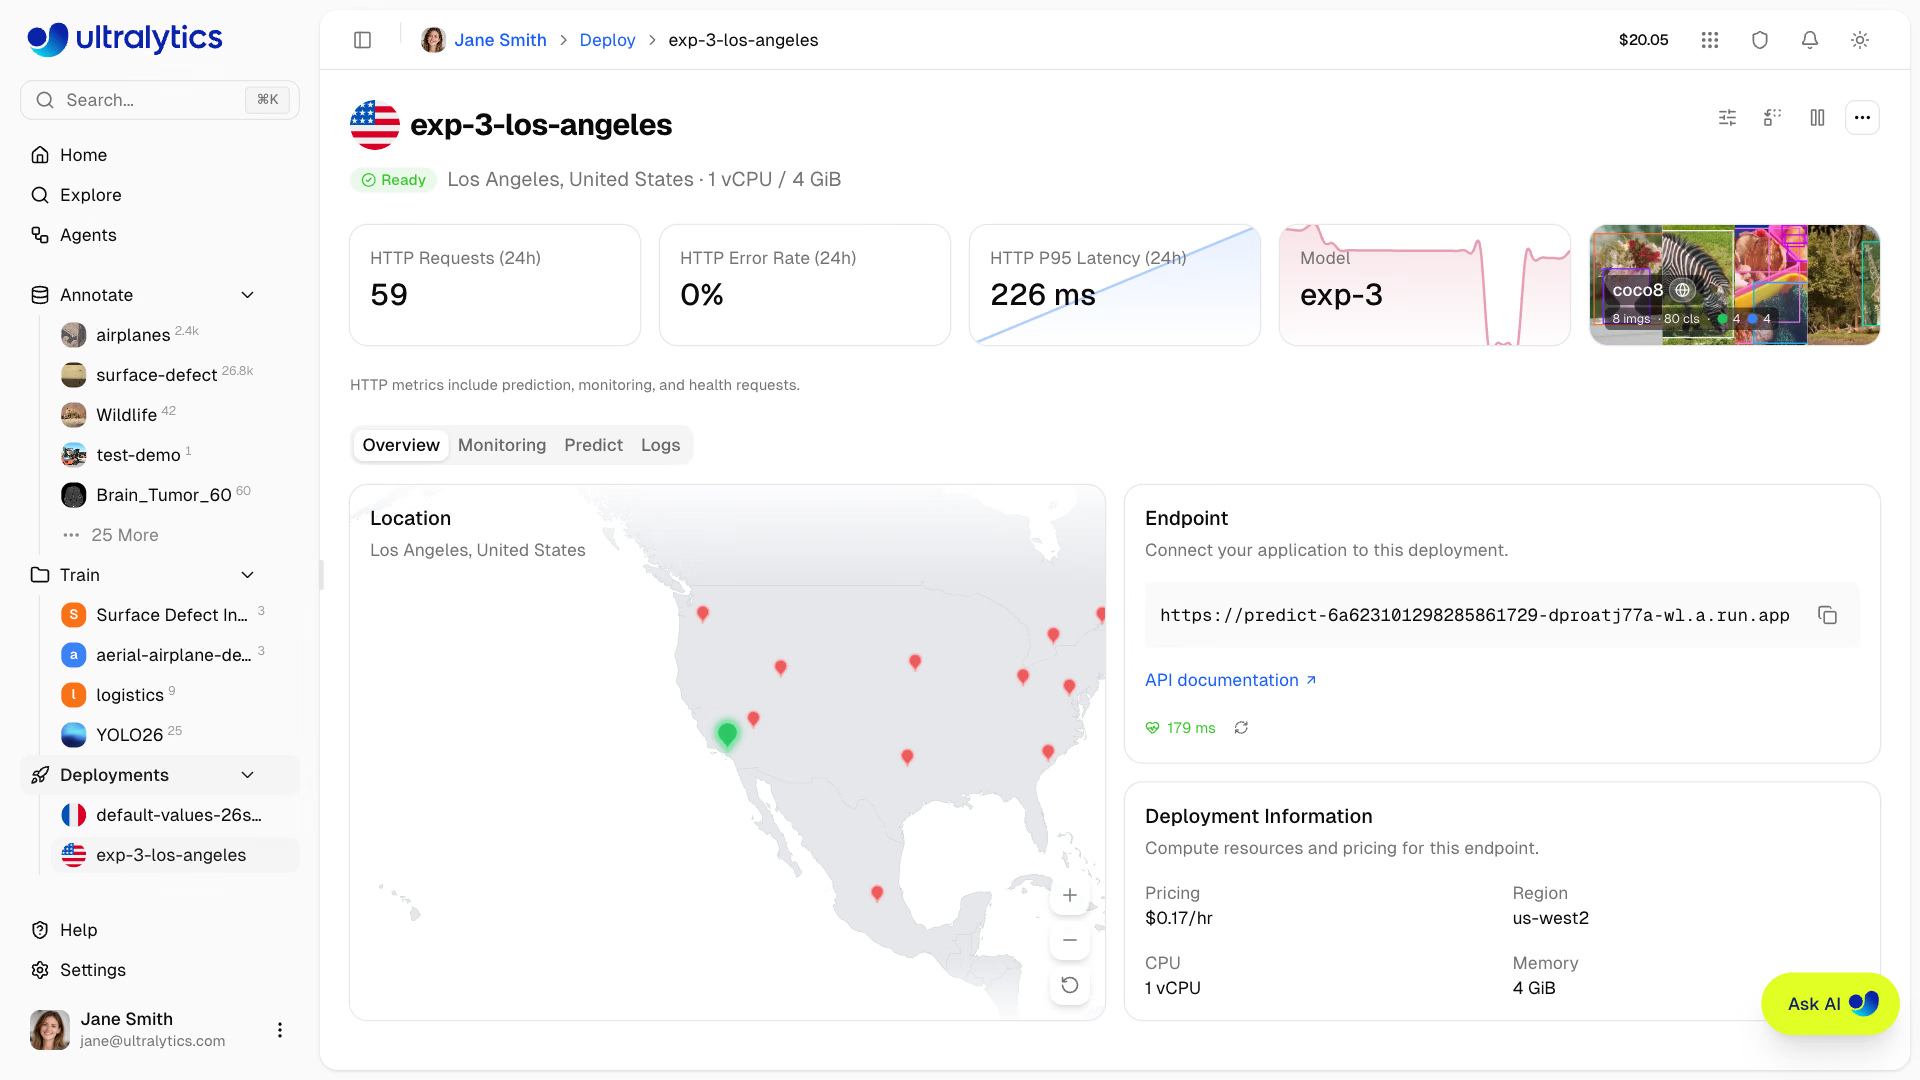
成本等于实例运行时长除以有效工作量。像这样的卡片会显示你需要的两个数字:每小时成本(这里是 1 vCPU、4 GiB 配置,每小时 $0.17)和处理的工作量(24 小时内处理 59 个请求,P95 延迟为 226 ms,说明端点大部分时间处于空闲状态)。接下来:
- 提高利用率。利用率为 30% 的 GPU 有 70% 的账单被浪费。可以批量处理流(见前几课),或通过 Triton Inference Server提供服务。
- 选择合适的规格。在认定需要大型 GPU 之前,先在较小的 GPU 上进行基准测试,或在配备 OpenVINO 的 CPU 上进行测试。
- 批处理作业使用竞价实例或可抢占容量。重新处理存档视频可以容忍中断;实时流则不行。
常见问题#
症状:花两周调优只节省了 10 ms,系统仍然很慢。解决方法:先分析整个管线的性能,再修复耗时最长的阶段,无论它是什么。
症状:在结果循环中使用 if i % 2: continue 毫无节省。解决方法:模型已经处理了该帧;使用 vid_stride 在数据源处跳过帧。
症状:吞吐量提高了,但每帧到达得更晚。解决方法:更大的批次能提高单位成本的吞吐量,而不会降低单帧延迟;批处理适用于多个视频流或离线任务,不适用于单个实时摄像头。
模型层面的优化手段用尽后,下一步就是改进数据。与生产环境相符的数据集能让较小的模型达到原本只有更大模型才能实现的准确率:降低成本而不损失准确率。
显示解答
from ultralytics import YOLO

if __name__ == "__main__":  # validation starts worker processes on macOS and Windows
    data, img = "coco8.yaml", "https://ultralytics.com/images/bus.jpg"  # use your val YAML and a production frame
    for weights, imgsz in (("yolo26s.pt", 640), ("yolo26n.pt", 640), ("yolo26n.pt", 480)):
        model = YOLO(weights)
        runs = [model(img, imgsz=imgsz, verbose=False)[0].speed["inference"] for _ in range(20)][5:]
        m = model.val(data=data, imgsz=imgsz, batch=1, plots=False, verbose=False).box.map
        print(f"{weights} imgsz={imgsz}: {sorted(runs)[len(runs) // 2]:.1f} ms, mAP50-95 {m:.3f}")
每行都会丢弃前五次运行作为预热,并报告其余运行的中位数。选择第一个满足延迟预算且 mAP 损失在预算范围内的行。预算示例:“两天、最多损失 1 个 mAP 点、门店设备上达到 20 FPS。”如果 yolo26s 在 640 尺寸下无法达到每帧 50 ms,而 yolo26n 在 640 尺寸下能在你的验证集上以不超过 1 个点的损失达到要求,就到此为止;不要把第二天花在 480 尺寸上。