标注质量
了解 YOLO 标签的内容,检查标签文件中的错误行,并通过指南和量化校准轮次确保标注人员保持一致。
用不一致标签训练的模型也会学到这种不一致。按照一条明确规则绘制的五万个框,胜过按照二十种各自为政的理解绘制的五十万个框;重新标注几乎总比换更大的模型便宜。本课将为你提供标签检查工具、一页指南,以及一个衡量标注人员一致性的数值。
实践操作
标签究竟是什么#
在 YOLO 格式中,每张图像都有一个对应的 .txt 文件,每个目标占一行。坐标按图像的宽度和高度归一化到 0–1,因此标签在调整尺寸后仍然有效。行布局取决于任务:
| 任务 | 一种标签 | 说明 |
|---|---|---|
| 检测 | class x_center y_center width height | 边界框中心点和尺寸 |
| 实例分割 | class x1 y1 x2 y2 ... xn yn | 多边形轮廓 |
| 姿态估计 | class x y w h px1 py1 v1 ... pxn pyn vn | 边界框,后接关键点(可选可见性) |
| OBB | class x1 y1 x2 y2 x3 y3 x4 y4 | 旋转框的四个角点 |
| 分类 | 没有标签文件 | 将图像按类别分别放入文件夹 |
| 语义分割 | 每张图像对应一张 PNG 掩码 | 每个像素值表示一个类别索引 |
| 深度估计 | 每张图像对应一个深度 PNG 或 NPY 文件 | 每个像素值表示一个距离 |
类别索引从 0 开始,并映射到数据集 YAML 中的名称。没有目标的图像不需要标签文件——背景图像就是这样处理的。目标检测格式、语义分割和深度估计数据集页面提供了可运行的示例。
检查你的标签文件#
错误行可能悄无声息地通过:坐标大于 1、YAML 未定义的类别 ID,或同一目标被重复框选,都会变成模型试图学习的噪声。简短的检查脚本可以在训练前发现这些问题:
from itertools import combinations
from pathlib import Path

from ultralytics.data.utils import check_det_dataset

def iou(a, b):
    """IoU of two normalized (x_center, y_center, width, height) boxes."""
    ax1, ay1, ax2, ay2 = a[0] - a[2] / 2, a[1] - a[3] / 2, a[0] + a[2] / 2, a[1] + a[3] / 2
    bx1, by1, bx2, by2 = b[0] - b[2] / 2, b[1] - b[3] / 2, b[0] + b[2] / 2, b[1] + b[3] / 2
    inter = max(0, min(ax2, bx2) - max(ax1, bx1)) * max(0, min(ay2, by2) - max(ay1, by1))
    return inter / (a[2] * a[3] + b[2] * b[3] - inter)

def check_labels(text, names):
    """Return a list of problems in one YOLO detection label file."""
    problems, boxes = [], []
    for i, row in enumerate(text.split("\n"), 1):
        values = row.split()
        if not values:
            continue
        if len(values) != 5:
            problems.append(f"row {i}: {len(values)} values, expected 5")
        elif int(values[0]) not in names:
            problems.append(f"row {i}: unknown class {values[0]}")
        elif not all(0 <= float(v) <= 1 for v in values[1:]):
            problems.append(f"row {i}: coordinates outside 0-1")
        else:
            boxes.append((i, int(values[0]), [float(v) for v in values[1:]]))
    for (i, ca, a), (j, cb, b) in combinations(boxes, 2):
        if ca == cb and iou(a, b) > 0.8:
            problems.append(f"row {j}: duplicate of row {i} (IoU {iou(a, b):.2f})")
    return problems

broken = "0 0.50 0.50 0.20 0.30\n0 0.51 0.50 0.20 0.30\n3 0.40 0.40 0.10 0.10\n0 1.20 0.50 0.10 0.10\n0 0.50 0.50 0.10"
print("\n".join(check_labels(broken, {0: "pill"})))

data = check_det_dataset("medical-pills.yaml")
files = sorted(Path(data["path"], "labels").rglob("*.txt"))
found = sum(len(check_labels(f.read_text(), data["names"])) for f in files)
print(f"medical-pills: {found} problems in {len(files)} label files")
row 3: unknown class 3
row 4: coordinates outside 0-1
row 5: 4 values, expected 5
row 2: duplicate of row 1 (IoU 0.90)
medical-pills: 0 problems in 115 label files手工制作的示例展示了检查脚本能捕获的每种错误;真实数据集则能顺利通过。每批标注完成后以及每次训练前都运行一次——只需几秒钟。
标签为何会出现偏差#
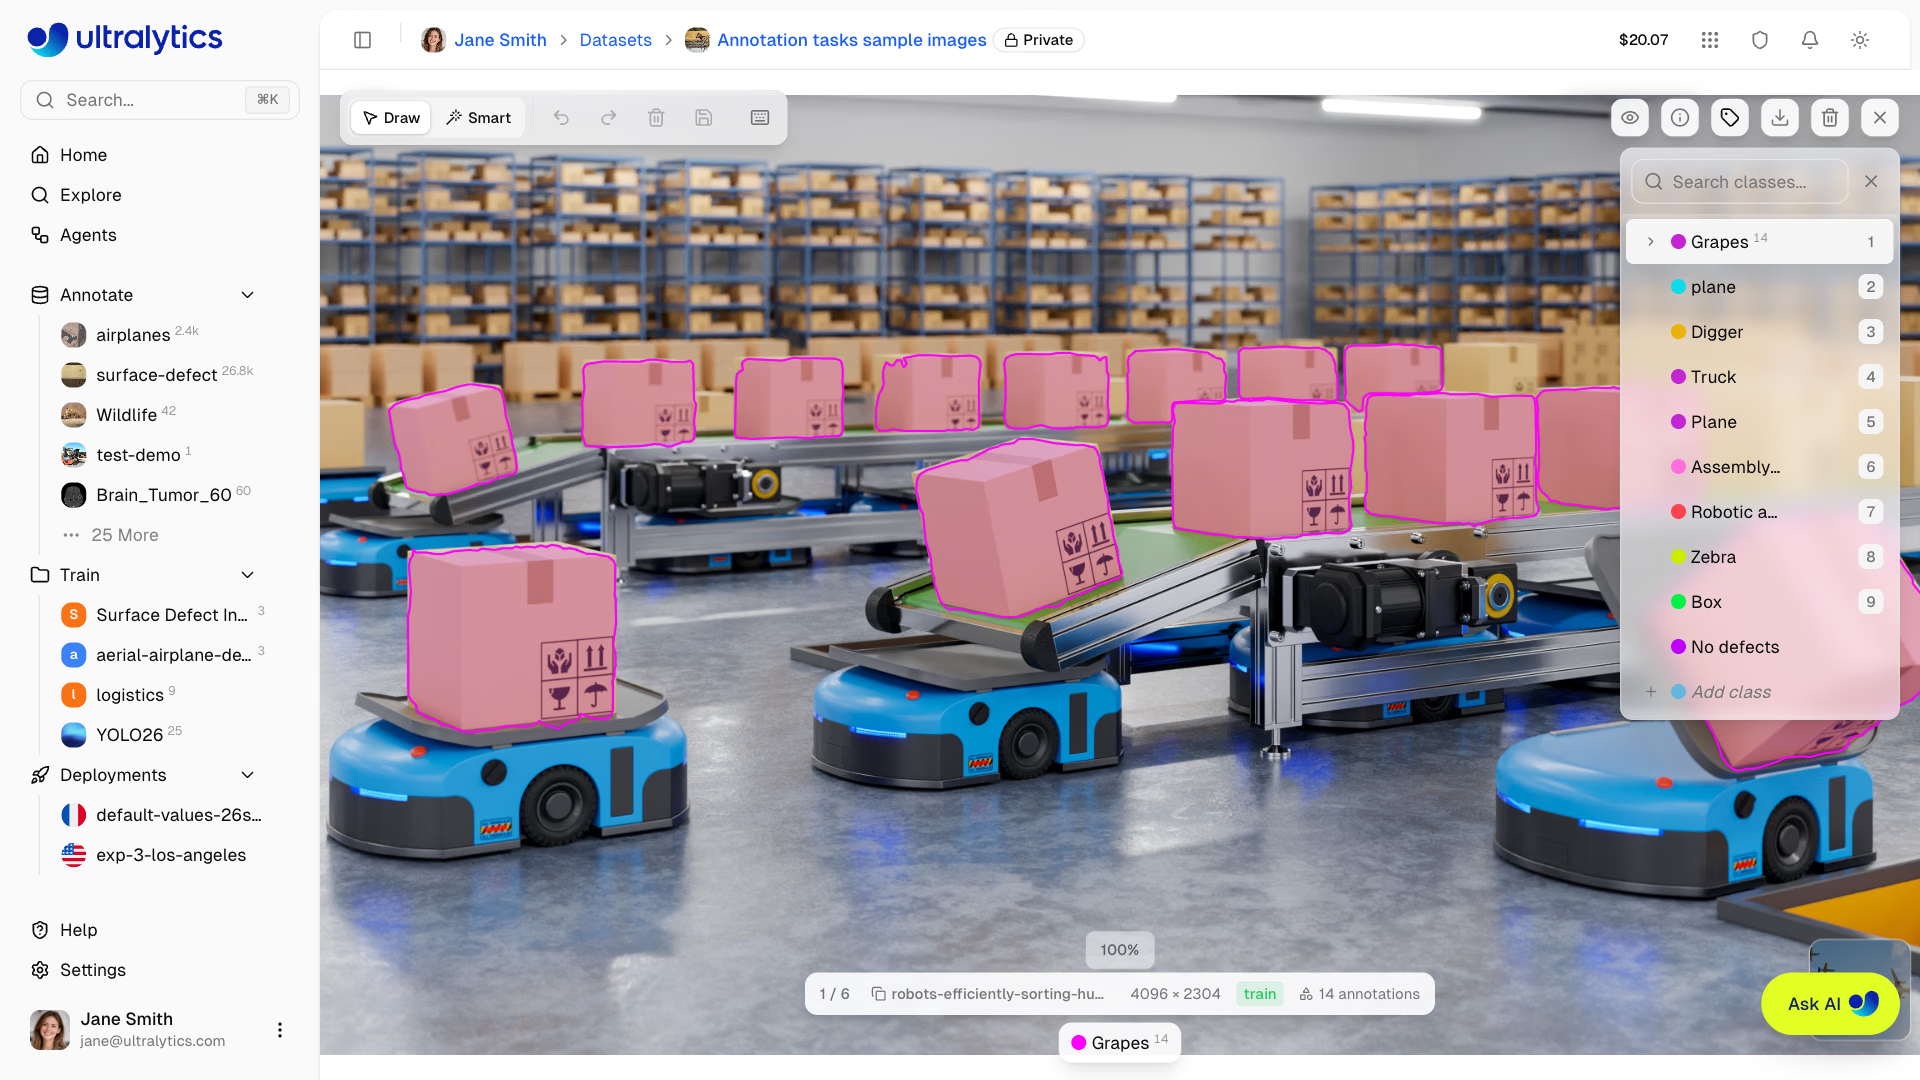
看看这个编辑器中的类别面板:14 个纸箱多边形被保存到了 Grapes 下,而列表下方还有一个 Box 类别;此外,plane 和 Plane 也作为两个独立类别存在。检查脚本无法发现这两类问题,因为每一行都有效;但审核人员只要对照指南检查标签,几秒钟内就能发现两者。大多数标签错误都是这样:文件有效,判断却错了。
标注人员很少是因为粗心才标注不好。规则含糊不清,每个人都会做出合理但不同的猜测,因此标注结果往往不一致:
- 边界框在哪里结束? 阴影、随身携带的包,还是叉车货叉上的货物?
- 截断。 人物有一半在画面外,还算
person吗?可见部分达到多少才算? - 遮挡。 只露出一个车轮的汽车应该标注还是跳过?
- 类别边界。 皮卡属于
car还是truck?滑板车属于bicycle还是other? - 禁止标注的情况。 显示目标的倒影、海报和屏幕。
只要每个人都做出相同选择,任何一种做法都可以。
一页指南#
指南应控制在一页内,为每条规则配一张示例图像,并优先列出边界情况:
## Class: forklift

Include:
- Forklifts with at least 30% of the body visible, moving or parked, any size or color.

Do not label:
- Pallet jacks (no overhead mast) → class `pallet_jack`.
- Reflections in glass or polished floors, and forklifts on posters or screens.

Box rules:
- Include the mast and the full visible body.
- Exclude the load (pallets, boxes) — those have their own classes.
- For partly occluded forklifts, box the visible part only.在校准轮次中衡量一致性#
从一位标注人员扩大到二十位之前,让所有人标注相同的 50 张图像,然后进行比较:
一致性指两位标注人员都绘制了相同类别且 IoU 至少为 0.5 的目标所占比例——这是评估者间信度的实用衡量方式:
def iou(a, b):
    """IoU of two (x1, y1, x2, y2) pixel boxes."""
    w = max(0, min(a[2], b[2]) - max(a[0], b[0]))
    h = max(0, min(a[3], b[3]) - max(a[1], b[1]))
    inter = w * h
    return inter / ((a[2] - a[0]) * (a[3] - a[1]) + (b[2] - b[0]) * (b[3] - b[1]) - inter)

def agreement(boxes_a, boxes_b, threshold=0.5):
    """Share of objects both annotators drew with the same class and IoU >= threshold."""
    unmatched, matched = list(boxes_b), 0
    for cls_a, box_a in boxes_a:
        best = max(unmatched, key=lambda b: iou(box_a, b[1]) if b[0] == cls_a else -1, default=None)
        if best and best[0] == cls_a and iou(box_a, best[1]) >= threshold:
            unmatched.remove(best)
            matched += 1
    return matched / max(len(boxes_a), len(boxes_b))

# Two annotators label the same calibration image
alice = [("forklift", (100, 200, 400, 600)), ("person", (450, 220, 520, 480)), ("person", (600, 230, 660, 470))]
bob = [("forklift", (100, 120, 400, 600)), ("person", (452, 218, 522, 478)), ("pallet_jack", (600, 230, 660, 470))]
print(f"agreement: {agreement(alice, bob):.0%}")
agreement: 67%这 67% 的结果掩盖了两种分歧。Bob 的叉车框向上偏了 80 像素——他把桅杆尖端也包含进去了——但 IoU 仍达到 0.83,因此算作一致;如果你的产品要测量高度,就应收紧边界框规则。第三个目标则是真正的冲突:Alice 标为 person,Bob 标为 pallet_jack。这需要更清晰的规则和示例图像,然后再进行一轮校准。保留这 50 张校准图像:它们将成为每位新标注人员的入职测试。
审核人员悄悄修正标签会切断反馈循环,标注人员也永远学不会自己错在哪里。请说明原因并驳回,让标注人员修正。前一百张图像会慢一些,之后就会快得多。
需要跟踪的指标#
| 指标 | 指标说明 |
|---|---|
| 吞吐量(每小时处理的目标数) | 产能和成本 |
| 驳回率 | 质量是否在下降 |
| 在共同重叠集上的一致性 | 标注人员是否仍在使用相同规则 |
一致性下降意味着有些事情变了:来了新标注人员、换了新相机、批次有歧义,或大家疲劳了。当模型后来在特定条件下失效时,把那些确切的图像重新交给标注人员处理——这就是主动学习自动化的闭环,也是现实场景中大多数准确率提升的来源。在 Ultralytics Platform 上的数据集中浏览并筛选失败案例,并查看数据集质量控制和标注最佳实践,了解如何大规模执行这一流程。
显示解答
在对 10 张图像进行校准轮次后,为 medical-pills 的 pill 类别编写的指南:
## Class: pill

Include:
- Every tablet inside a blister cavity, including half-visible ones at the image edge.
- Tablets seen through clear plastic, even when glare covers part of them.

Do not label:
- Empty cavities, torn foil, or tablets outside the pack.
- Reflections of tablets in the foil.

Box rules:
- Box the tablet itself, not the plastic bubble around it.
- If two tablets touch, draw two boxes.
如何解读一致性得分:假设第一轮得分为 82%。按原因对未匹配的目标进行分类。对于药板,最常见的两类原因是:边界框圈住了塑料泡罩而不是药片(通过第一条边界框规则及示例图像解决),以及一位标注人员跳过了被眩光遮住的药片(通过第二条纳入规则解决)。在 10 张新图像上重新运行;只有得分超过 90% 门槛后才扩大规模。