Aufgaben in einer Pipeline kombinieren
Erstelle eine Kaskade aus Erkennung und anschließender Klassifizierung, klassifiziere jedes verfolgte Objekt nur einmal statt in jedem Einzelbild und erstelle aus Pose-Schlüsselpunkten Zeitreihen pro Person.
Die nützlichsten Systeme jenseits der Erkennung bestehen meist aus zwei Modellen, nicht aus einem. Ein Detektor findet alle Beschäftigten, und ein Klassifikator entscheidet, ob der Helmtyp bei jeder Person der richtige ist; ein Pose-Modell findet Gelenke, und ein Tracker macht daraus einen zeitlichen Verlauf, anhand dessen sich Wiederholungen zählen lassen. Der Code ist kurz. Diese Systeme scheitern an Datensätzen für die zweite Stufe, die nicht zu den Bildausschnitten der ersten Stufe passen, sowie an den Kosten, die sich mit jedem Objekt in jedem Einzelbild multiplizieren — bei einer naiven Verarbeitung kostet ein Stream mit 30 FPS und zehn Personen 300 Klassifizierungen pro Sekunde.
Praxisnah
Zwei Muster für die meisten Produkte#
Beide beginnen mit demselben Einzelbild und derselben Ultralytics-API; sie unterscheiden sich darin, was die zweite Stufe verarbeitet. Auswahl und Abstimmung des Trackers sowie die Verarbeitung von Streams für die Objektverfolgung werden unter Objekte mit ByteTrack, BoT-SORT und TrackTrack verfolgen behandelt. Hier konzentrieren wir uns darauf, die Aufgaben zu verbinden.
Erst erkennen, dann die Bildausschnitte klassifizieren#
from ultralytics import YOLO

detector = YOLO("yolo26n.pt")
classifier = YOLO("yolo26n-cls.pt")  # swap in your own fine-tuned classifier

result = detector("https://ultralytics.com/images/bus.jpg", conf=0.5)[0]
crops, labels = [], []
for box in result.boxes:
    x1, y1, x2, y2 = box.xyxy[0].int().tolist()
    crops.append(result.orig_img[y1:y2, x1:x2])  # BGR numpy crop, same as the detector saw
    labels.append(result.names[int(box.cls)])

for label, crop_result in zip(labels, classifier(crops, verbose=False)):  # one batched call for all crops
    probs = crop_result.probs
    print(f"{label:6s} -> {crop_result.names[probs.top1]} ({float(probs.top1conf):.2f})")
bus -> bullet_train (0.31)
person -> sweatshirt (0.24)
person -> abaya (0.50)
person -> loudspeaker (0.49)
person -> frilled_lizard (0.24)Die Verarbeitung ist korrekt: Die Bildausschnitte stammen mit voller Auflösung aus orig_img und verwenden die Pixelkoordinaten des Detektors. Der Klassifikator verarbeitet sie alle mit einem einzigen gebündelten Aufruf. Die Labels sind absichtlich unsinnig.
Der ImageNet-Klassifikator wurde nie mit eng zugeschnittenen, teilweise abgeschnittenen Personen im Straßenverkehr trainiert und rät daher – beachte, dass keine Konfidenz über 0,50 liegt. Dasselbe passiert bei einem Klassifikator, der mit sauberen Produktfotos trainiert und mit unscharfen Ausschnitten des Detektors gefüttert wird.
Den Datensatz für die zweite Stufe aus eigenen Bildausschnitten erstellen#
Passende Daten erhältst du am zuverlässigsten, wenn du sie vom Detektor erzeugen lässt:
- Führe den Detektor mit
save_crop=Trueüber repräsentatives Filmmaterial aus, zum Beispiel mityolo predict model=best.pt source=footage/ save_crop=True. Die Bildausschnitte werden unterruns/detect/predict/crops/<class>/gespeichert. - Sortiere die Bildausschnitte jeder Klasse in deine Ordner für die Feinklassifizierung (
helmet_ok/,helmet_missing/) — das ist bereits die Klassifizierungsstruktur aus der vorherigen Lektion. - Trainiere den Klassifikator mit diesen Ordnern und validiere ihn anhand von Bildausschnitten aus einem anderen Tag oder einer anderen Kamera.
Da der Detektor die Bildausschnitte erstellt hat, enthalten sie den tatsächlichen Bildausschnitt, Bewegungsunschärfe und Verdeckungen — genau das, was der Klassifikator in der Produktion sehen wird. Das Feinabstimmen darauf ist gewöhnliches Transferlernen.
Einmal pro Track-ID klassifizieren#
Ein Helm verändert sich nicht von einem Einzelbild zum nächsten; daher ist es unnötige Arbeit, jeden Begrenzungsrahmen in jedem Einzelbild zu klassifizieren. Verfolge die erkannten Objekte und klassifiziere jede neue Track-ID einmal:
from ultralytics import YOLO

detector = YOLO("yolo26n.pt")
classifier = YOLO("yolo26n-cls.pt")  # swap in your own fine-tuned classifier
source = "https://github.com/ultralytics/assets/releases/download/v0.0.0/decelera_portrait_min.mov"

labels = {}  # track id -> (label, confidence), filled once per person
frames = boxes_seen = 0
for result in detector.track(source, classes=[0], stream=True, persist=True, verbose=False):  # people only
    frames += 1
    if result.boxes.id is None:
        continue
    for track_id, (x1, y1, x2, y2) in zip(result.boxes.id.int().tolist(), result.boxes.xyxy.int().tolist()):
        boxes_seen += 1
        if track_id not in labels:  # first sighting: classify once, then reuse
            probs = classifier(result.orig_img[y1:y2, x1:x2], verbose=False)[0].probs
            labels[track_id] = (classifier.names[probs.top1], round(float(probs.top1conf), 2))

print(f"{frames} frames, {boxes_seen} person boxes, {len(labels)} classifier calls")
print(labels)
11 frames, 33 person boxes, 3 classifier calls
{1: ('basketball', 0.51), 2: ('maillot_(tights)', 0.14), 3: ('bulletproof_vest', 0.23)}Drei Aufrufe des Klassifikators statt 33 bei einem Clip mit 11 Einzelbildern; bei einem langen Stream steigt die Einsparung mit jedem Einzelbild, in dem eine Person zu sehen ist. Die Labels sind weiterhin Vermutungen von ImageNet — ersetze den Klassifikator durch deinen feinabgestimmten Klassifikator, und sie werden zur Klassifizierung der jeweiligen Person.
Klassifiziere einmal pro Track, wenn sich das Merkmal nicht ändern kann, solange das Objekt im Bild ist (Helmtyp, Fahrzeugmarke, Produkt-SKU). Klassifiziere alle N Frames erneut, wenn es sich ändern kann (Tür offen, Hand erhoben). Wenn erste Sichtungen meist klein und unscharf sind, klassifiziere stattdessen den Frame, in dem die Box des Tracks am größten ist.
Pose und Verfolgung#
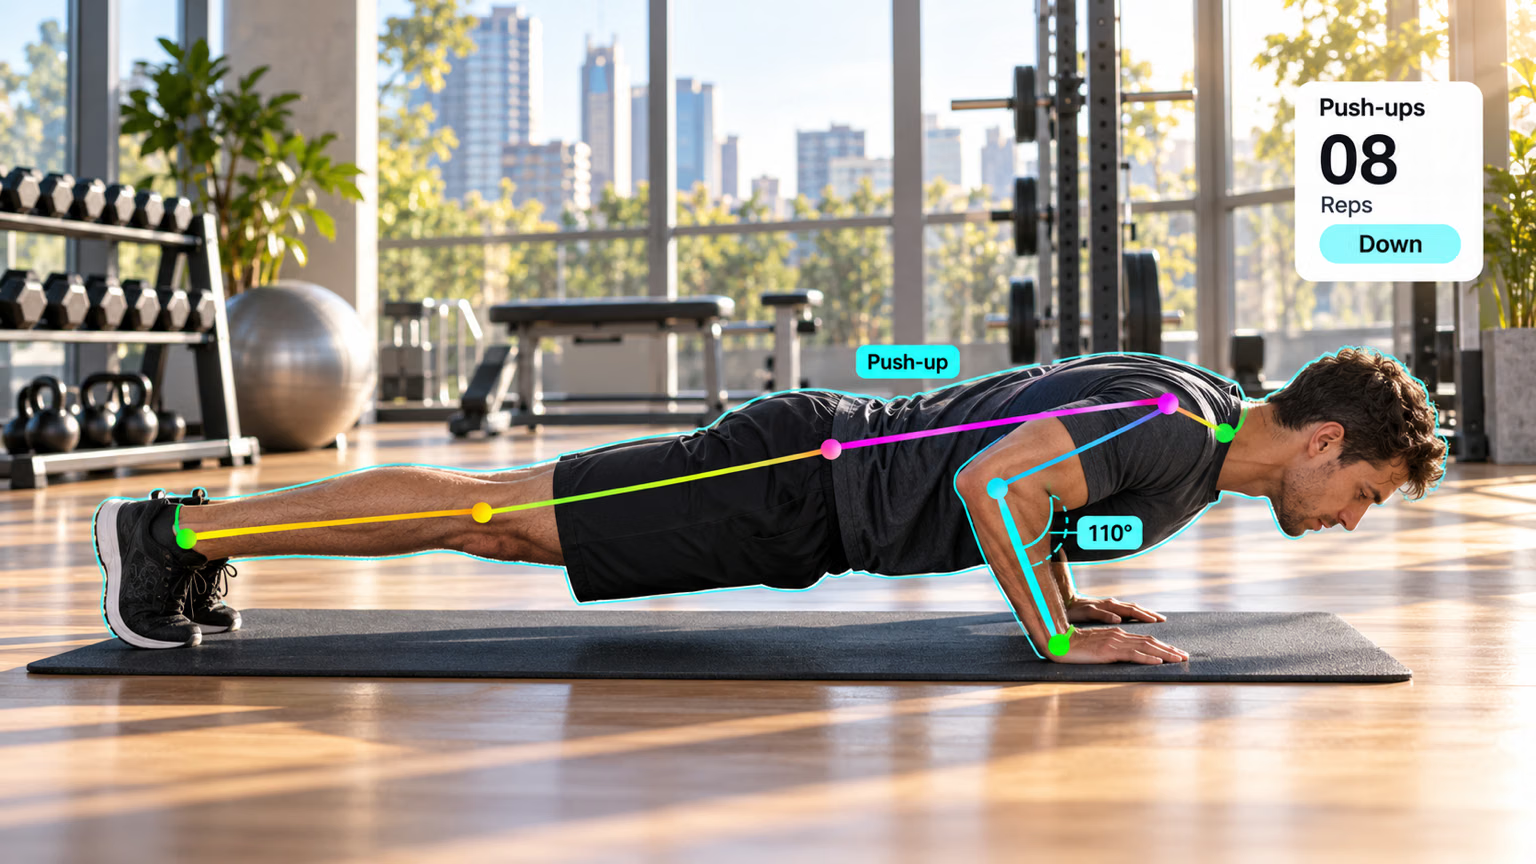
Der Track-Modus fügt pro Person eine persistente result.boxes.id hinzu, sodass Schlüsselpunkte zu einer Zeitreihe werden. Dieses Skript zeichnet den Winkel des linken Knies jeder Person im selben kurzen Video auf:
from collections import defaultdict

import numpy as np

from ultralytics import YOLO

def angle(a, b, c):
    """Angle at b, in degrees, formed by points a-b-c."""
    ba, bc = a - b, c - b
    return np.degrees(np.arccos(np.dot(ba, bc) / (np.linalg.norm(ba) * np.linalg.norm(bc))))

model = YOLO("yolo26n-pose.pt")
source = "https://github.com/ultralytics/assets/releases/download/v0.0.0/decelera_portrait_min.mov"
HIP, KNEE, ANKLE = 11, 13, 15  # left leg, COCO keypoint order
knee_angles = defaultdict(list)  # track id -> knee angle per frame

for result in model.track(source, stream=True, persist=True, verbose=False):
    if result.boxes.id is None:  # no confirmed tracks in this frame
        continue
    kpts = result.keypoints.cpu().numpy()
    for track_id, xy, conf in zip(result.boxes.id.int().tolist(), kpts.xy, kpts.conf):
        if conf[[HIP, KNEE, ANKLE]].min() > 0.5:  # skip occluded legs
            knee_angles[track_id].append(angle(xy[HIP], xy[KNEE], xy[ANKLE]))

for track_id, angles in sorted(knee_angles.items()):
    print(f"id {track_id}: {len(angles)} frames, left knee {min(angles):.0f}-{max(angles):.0f} deg")
id 1: 11 frames, left knee 170-176 deg
id 2: 11 frames, left knee 96-118 deg
id 3: 11 frames, left knee 177-180 degDas gebeugte Knie von ID 2 passt zur sitzenden Person im Clip; die beiden anderen Personen stehen mit gestreckten Beinen bei etwa 180°. Darauf aufbauend zählt ein Wiederholungszähler das Überschreiten von Schwellenwerten in der Messreihe jeder ID — erst unter einen Winkel und dann wieder über einen anderen —, wie es die Lösung zur Trainingsüberwachung für dich umsetzt.
Die Verarbeitungskette kalkulieren#
| Kostenfaktor | Erkennen, dann klassifizieren | Pose und Verfolgung |
|---|---|---|
| Skaliert mit | Objekten pro Einzelbild | Einzelbildern |
| Wichtigster Stellhebel | Crops stapelweise erstellen; einmal pro Track-ID klassifizieren und im Cache speichern | imgsz oder vid_stride verringern, wenn die Bewegung langsam ist |
| Fehlermodus | Der Klassifikator sieht Crops, die sich von seinen Trainingsdaten unterscheiden | ID-Wechsel teilen den Verlauf einer Person in zwei Teile |
Symptom: Ein Wiederholungszähler wird mitten im Satz zurückgesetzt oder eine Person erscheint unter zwei IDs. Ursache: Der Tracker hat die Person verloren (Verdeckung, schnelle Drehung) und eine neue ID vergeben. Lösung: Stimme den Tracker wie im Produktionskurs beschrieben ab und sorge dafür, dass die Logik pro ID kurze Lücken toleriert – eine zwischengespeicherte Klassifikatorbezeichnung wird für die neue ID einfach neu berechnet.
Lösung anzeigen
Ergänze save_crop=True im Detektoraufruf:
result = detector("https://ultralytics.com/images/bus.jpg", conf=0.5, save_crop=True)[0]Crops erscheinen unter runs/detect/predict*/crops/person/ und crops/bus/ (der Name des Ausgabeordners erhöht sich bei jedem Vorhersagelauf). Durch das Caching pro Track waren für 33 Personenboxen 3 Klassifikatoraufrufe nötig; bei einem Clip mit 11 Frames wurden also 30 Aufrufe eingespart.
Ersetze für die Kniewinkelzählung die letzte Schleife von pose_track.py:
for track_id, angles in sorted(knee_angles.items()):
    bent = sum(a < 120 for a in angles)
    print(f"id {track_id}: {len(angles)} frames, {bent} with knee below 120 deg")
id 1: 11 frames, 0 with knee below 120 deg
id 2: 11 frames, 11 with knee below 120 deg
id 3: 11 frames, 0 with knee below 120 degID 2, die sitzende Person, liegt in allen 11 Frames unter 120°; bei ID 1 und 3 ist das nie der Fall.