Benutzerdefinierte Keypoints und OKS-Metriken
Entwirf ein Keypoint-Schema für nicht menschliche Objekte, erstelle und überprüfe das Dataset-YAML und lege OKS-Sigmas anhand der Platzierungsgenauigkeit der einzelnen Punkte fest.
Pose ist nicht nur für Personen geeignet. Gabelspitzen an einem Gabelstapler, Ecken eines Paketetiketts, Nase und Schwanz eines Tiers – jedes Objekt mit stabilen, eindeutig benennbaren Punkten eignet sich für einen Pose-Datensatz. Das Schema, das du am ersten Tag festlegst, bleibt dauerhaft bestehen: Jedes Label, jedes Spiegelungspaar und jede Metrik hängt davon ab. Eine spätere Änderung bedeutet, alles neu zu labeln. In dieser Lektion legst du das Schema fest, bevor jemand tausend Bilder labelt, und erfährst genau, wie die Metrik es bewertet.
Praxisnah
Das Keypoint-Schema entwerfen#
Gute Keypoints haben drei Eigenschaften gemeinsam: eindeutig (zwei Annotatoren platzieren den Punkt an derselben Stelle), stabil (der Punkt kommt in jeder Pose des Objekts vor) und nützlich (eine nachgelagerte Berechnung verwendet ihn). Betrachte einen Gabelstapler aus der Perspektive einer Decken-Kamera. Die Produktfrage lautet: „Sind die Gabeln angehoben, während der Stapler fährt?“:
| Index | Keypoint | Grund für die Aufnahme | Spiegelungspartner |
|---|---|---|---|
| 0 | left_fork_tip | Reichweite und Richtung der Gabeln | 1 |
| 1 | right_fork_tip | Reichweite und Richtung der Gabeln | 0 |
| 2 | mast_top | Höhe der Gabeln relativ zum Hubmast | 2 (sich selbst) |
| 3 | mast_base | Bezugspunkt am Fahrgestell | 3 (sich selbst) |
Jeder Punkt ist enthalten, weil er in die Berechnung einfließt: Die Gabelspitzen geben die Richtung an, das Mastpaar die Höhe. Prüfe jeden möglichen Punkt anhand derselben Kriterien:
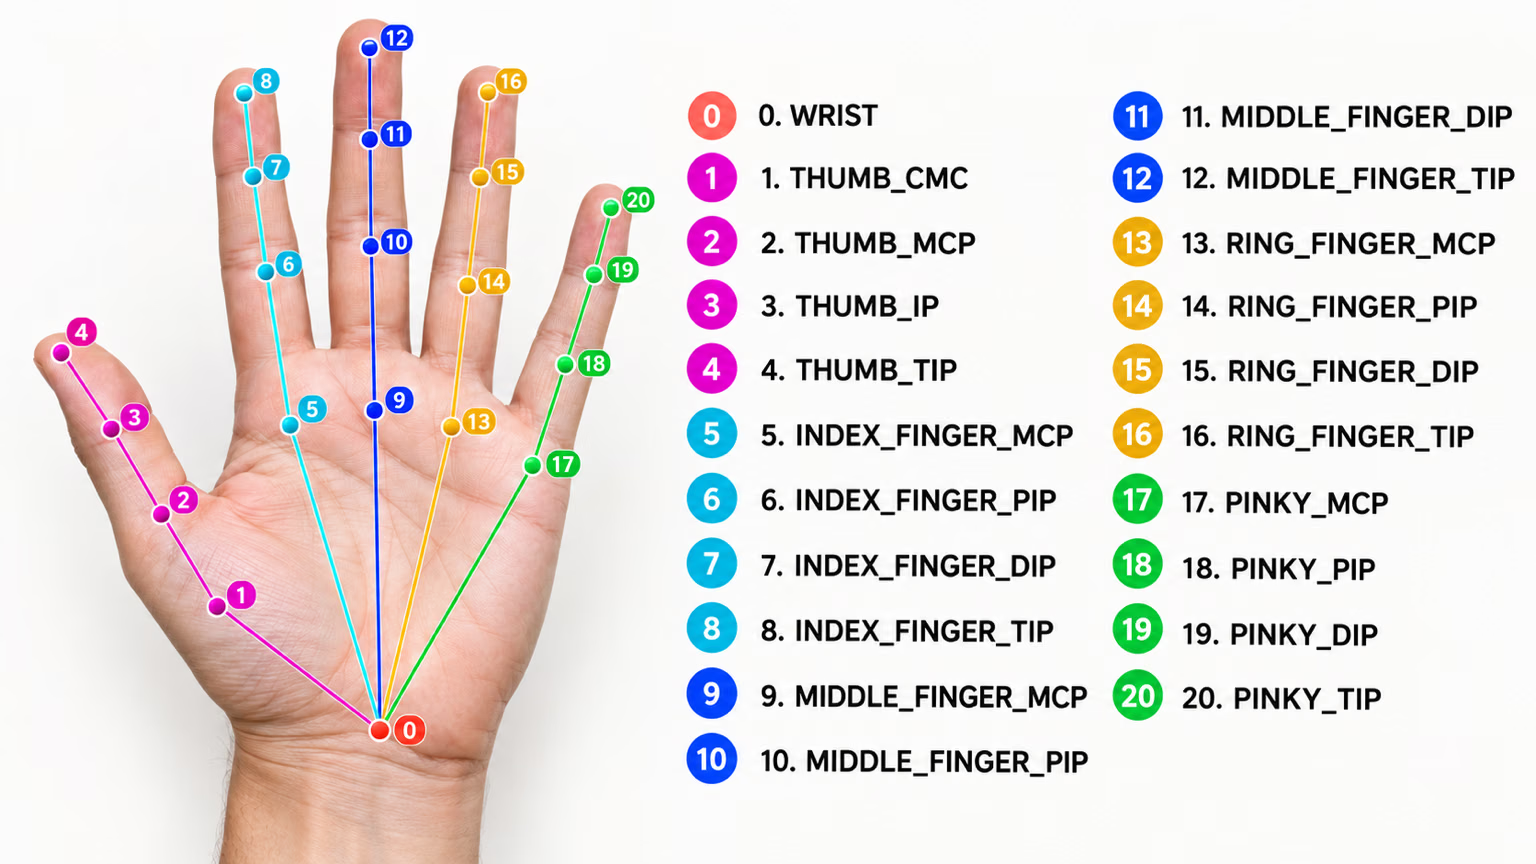
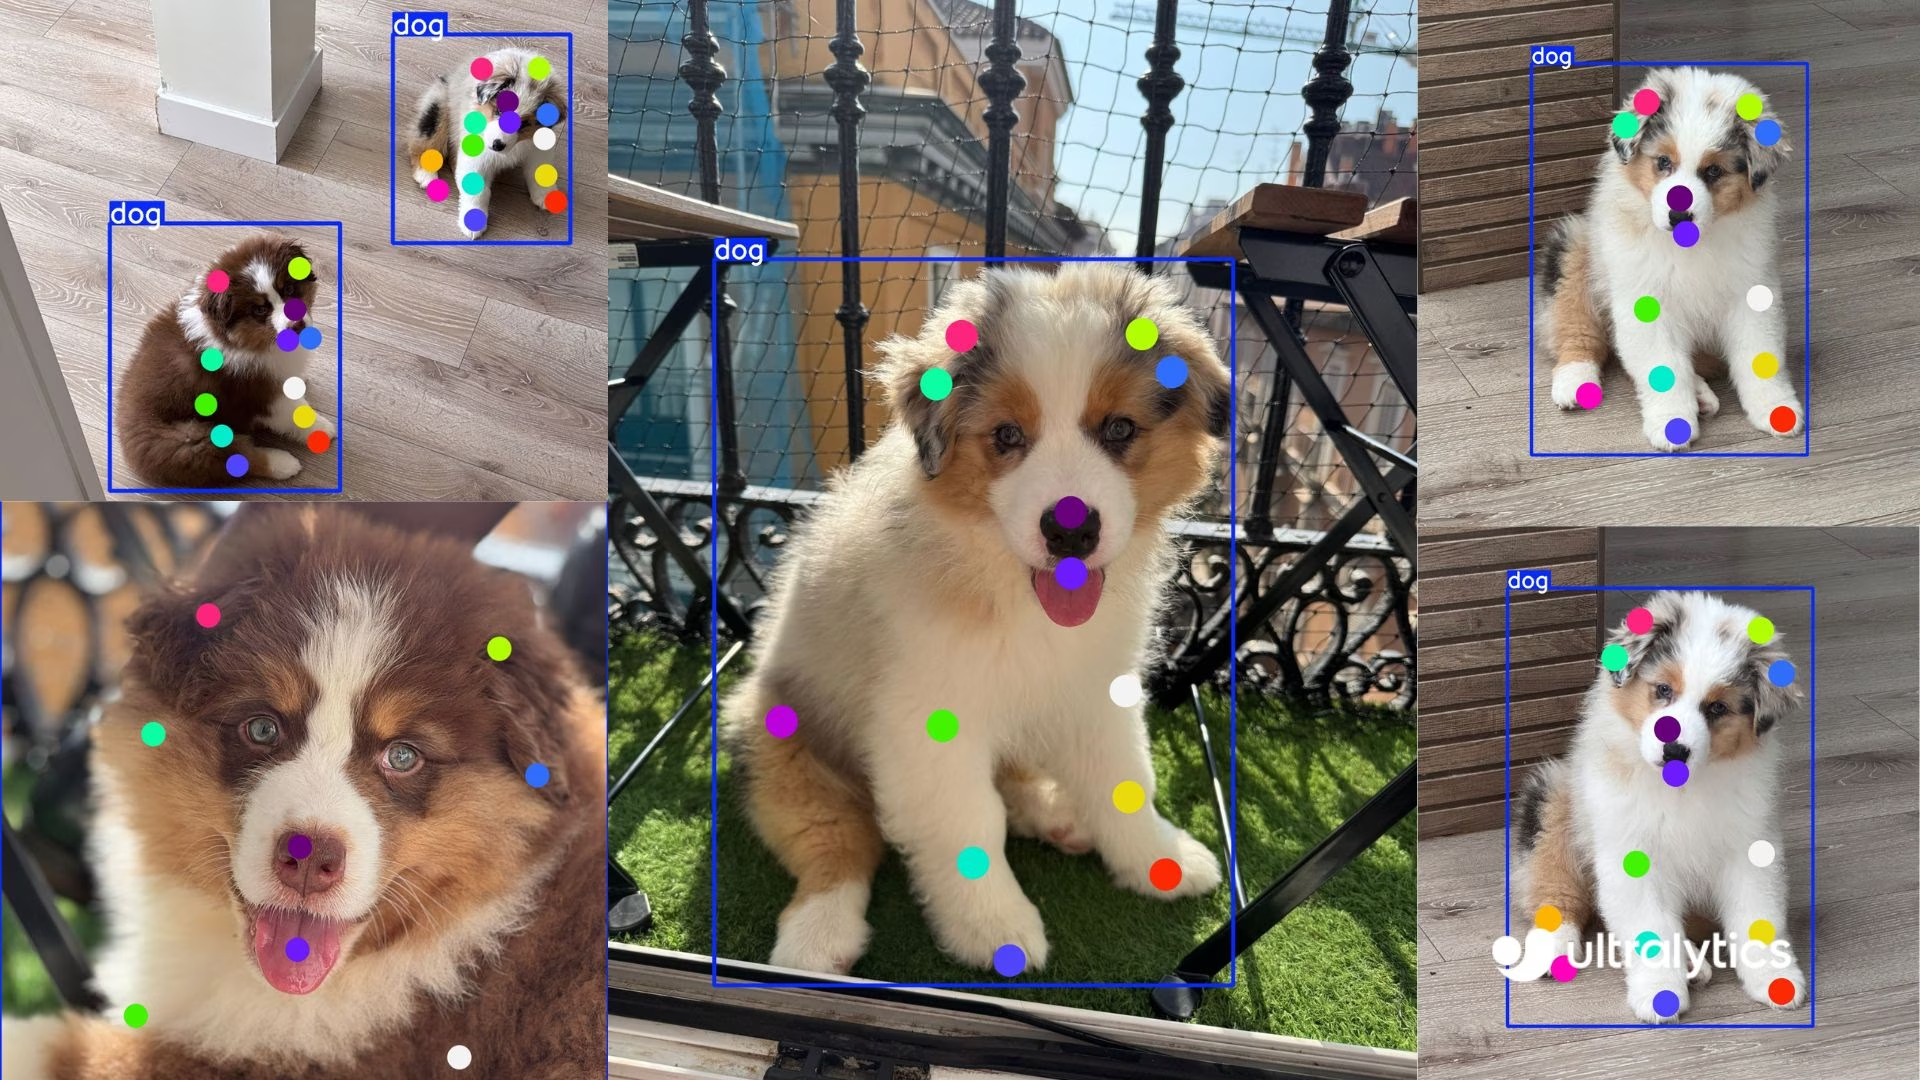
Widerstehe der Versuchung, Punkte „für alle Fälle“ hinzuzufügen: Jeder einzelne kostet bei jedem Beispiel Labeling-Zeit, und Punkte, die niemand verwendet, fügen der Metrik nur Rauschen hinzu. Öffentliche Datensätze zeigen die Bandbreite: Tiger-Pose verwendet 12 Punkte ohne Sichtbarkeit, Dog-Pose 24 und Hand Keypoints 21:
Das Dataset-YAML erstellen#
path: forklift-pose
train: images/train
val: images/val

kpt_shape: [4, 3] # 4 keypoints, each x, y, visibility
flip_idx: [1, 0, 2, 3] # fork tips swap, mast points stay
kpt_oks_sigmas: [0.05, 0.05, 0.08, 0.08] # tips are sharp, mast ends are fuzzier

names:
  0: forklift

kpt_names:
  0:
    - left_fork_tip
    - right_fork_tip
    - mast_top
- mast_basekpt_namesdokumentiert die Reihenfolge der Punkte für Personen und Werkzeuge, jeweils pro Klasse.flip_idxmuss seine eigene Zuordnung aufheben: Bei zweimaliger Anwendung wird jeder Index wieder sich selbst zugeordnet.kpt_oks_sigmasist optional und gewichtet sowohl den Keypoint-Verlust beim Training als auch OKS bei der Validierung. Falls vorhanden, muss es einen positiven Wert pro Keypoint enthalten, andernfalls wird der Lauf mit einemValueErrorabgebrochen.
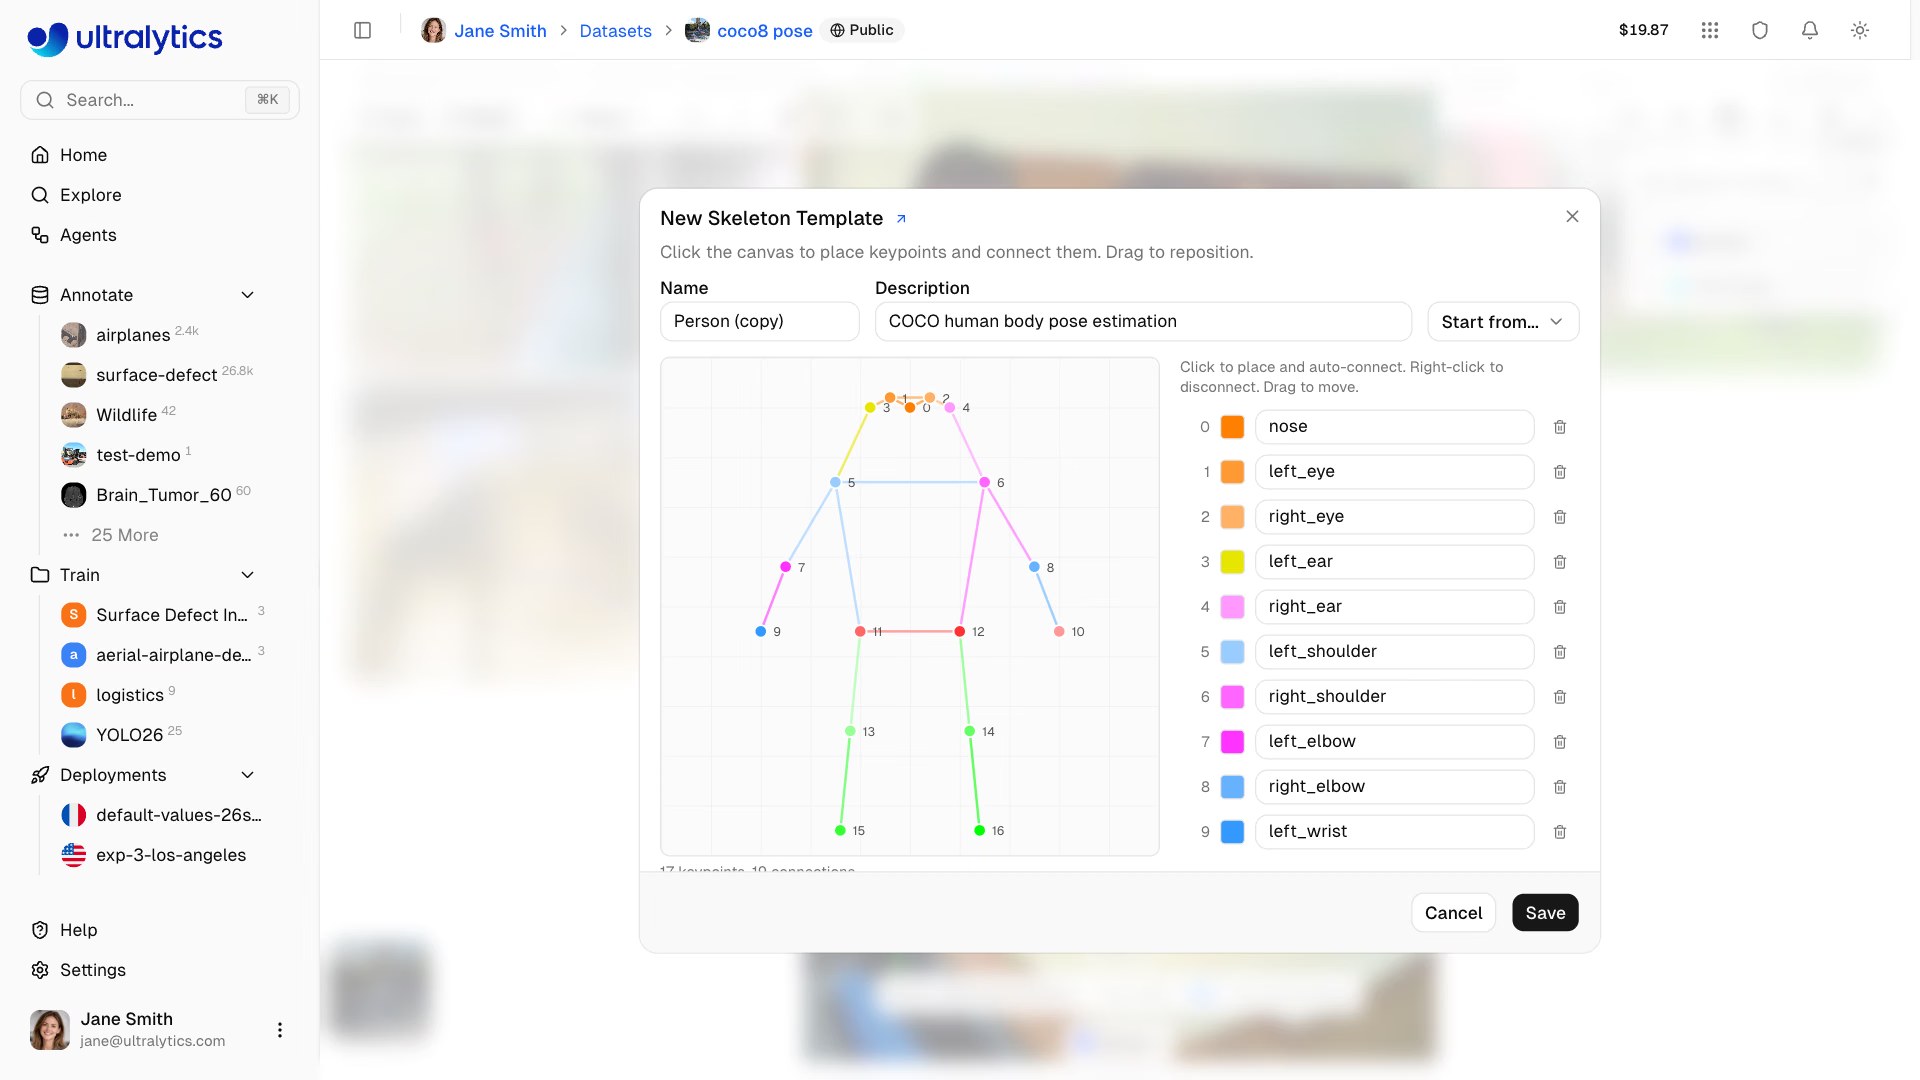
Auf der Ultralytics-Plattform entspricht dasselbe Schema einer Skelettvorlage. Eine neue Vorlage kann von einer vorhandenen ausgehen (Vorlage verwenden…). So kannst du Punkte umbenennen und entfernen, statt jeden Keypoint von Hand zu platzieren – behalte die Indexreihenfolge aus deiner Schema-Tabelle bei:
Labels vor dem Training prüfen#
Fehler in Pose-Datensätzen bleiben oft unbemerkt: Fehlt in einer Zeile ein Keypoint, verschieben sich alle nachfolgenden Werte; ein Sichtbarkeitswert von 3 aus einem fehlerhaften Export wird wie jede andere Zahl eingelesen. Dieser Prüfer lädt das YAML mit dem eigenen Loader von Ultralytics und validiert jede Zeile. Er funktioniert unverändert mit COCO8-pose; ersetze den YAML-Pfad durch deinen eigenen:
from pathlib import Path

from ultralytics.data.utils import check_det_dataset

data = check_det_dataset("coco8-pose.yaml")  # resolves paths, downloads if needed
k, dims = data["kpt_shape"]
flip = data.get("flip_idx", [])
assert not flip or sorted(flip) == list(range(k)), "flip_idx must list every keypoint index once"
assert all(flip[flip[i]] == i for i in range(len(flip))), "flip_idx must undo itself: pairs swap, center points stay"

expected = 5 + k * dims  # class + 4 box values + k keypoints of `dims` values
bad = 0
for label in Path(data["path"], "labels").rglob("*.txt"):
    for n, row in enumerate(label.read_text().splitlines(), 1):
        values = row.split()
        if len(values) != expected:
            bad += 1
            print(f"{label.name}:{n} has {len(values)} values, expected {expected}")
        elif dims == 3 and not {float(v) for v in values[7::3]} <= {0, 1, 2}:
            bad += 1
            print(f"{label.name}:{n} has a visibility flag outside 0/1/2")
print(f"kpt_shape={data['kpt_shape']}, flip_idx ok, {bad} bad rows")
kpt_shape=[17, 3], flip_idx ok, 0 bad rowsvalues[7::3] beginnt beim ersten Sichtbarkeitswert (Klasse, vier Box-Werte, dann x y v) und nimmt anschließend jeden dritten Wert.
So bewertet OKS einen Keypoint#
Pose mAP ersetzt die Box-IoU durch Object-Keypoint-Ähnlichkeit (OKS). Für jeden gelabelten Keypoint wandelt OKS den Pixelabstand zwischen Vorhersage und Label in einen Wert zwischen 0 und 1 um, skaliert nach der Objektgröße und dem Sigma des jeweiligen Keypoints, und bildet anschließend den Durchschnitt über die gelabelten Keypoints. Pose mAP50-95 ist der Durchschnitt der Präzision bei OKS-Schwellenwerten von 0,50 bis 0,95 – genau wie Box-mAP über IoU-Schwellenwerte. Der Leitfaden zu Leistungsmetriken behandelt die gemeinsame Berechnungsgrundlage.
Sigmas lassen sich am einfachsten verstehen, indem man sie misst. Dieses Skript bewertet dieselbe Gabelstapler-Vorhersage mit zwei Sigmas und verwendet dabei die Funktion kpt_iou, die der Pose-Validator aufruft:
import torch

from ultralytics.utils.metrics import kpt_iou

# One labeled forklift, 4 keypoints (x, y, visibility) in pixels, inside a 200 x 120 px box
label = torch.tensor([[[40.0, 30, 2], [40, 90, 2], [170, 20, 2], [170, 100, 2]]])
area = torch.tensor([200 * 120 * 0.53])  # Ultralytics scales box area by 0.53 to approximate object area

for offset in (2, 5, 10, 20):
    pred = label.clone()
    pred[..., 0] += offset  # every predicted keypoint lands `offset` pixels to the right
    sharp = kpt_iou(label, pred, area, sigma=[0.025] * 4).item()
    loose = kpt_iou(label, pred, area, sigma=[0.10] * 4).item()
    print(f"{offset:2d} px off: OKS {sharp:.2f} with sigma 0.025, {loose:.2f} with sigma 0.10")
2 px off: OKS 0.94 with sigma 0.025, 1.00 with sigma 0.10
5 px off: OKS 0.67 with sigma 0.025, 0.98 with sigma 0.10
10 px off: OKS 0.21 with sigma 0.025, 0.91 with sigma 0.10
20 px off: OKS 0.00 with sigma 0.025, 0.67 with sigma 0.10Bei einem 200 × 120 Pixel großen Gabelstapler verfehlt eine Vorhersage mit 10 Pixel Abweichung den OKS-Schwellenwert 0,50 bei einem Sigma von 0,025 und besteht alle Schwellenwerte bis 0,90 bei einem Sigma von 0,10. Dasselbe Modell, derselbe Fehler, aber eine ganz andere Pose-mAP.
| Sigma | Auswirkung | Verwendung für |
|---|---|---|
| Klein (≈ 0,025–0,05) | Schon wenige Pixel Abweichung kosten Punkte | scharf abgegrenzte Punkte: Augen, Gabelspitzen, Ecken |
| Groß (≈ 0,08–0,10) | großzügige Toleranz | unscharf abgegrenzte Punkte: Hüften, Mitte eines Masts |
| Standard | COCO-Sigmas für kpt_shape: [17, 3]; andernfalls 1/K für jeden Punkt | Hier beginnen und dann messen |
Sigmas sollten widerspiegeln, wie einheitlich Annotatoren jeden Punkt platzieren. Miss die Abweichung: Lass zwei Personen dieselben 50 Bilder labeln und vergleiche die Abstände für jeden Keypoint. Für Punkte, bei denen sie voneinander abweichen, sind größere Sigmas angebracht. Andernfalls bestraft die Metrik das Modell für menschliche Ungenauigkeit.
Eine Änderung von kpt_oks_sigmas verändert die Pose-mAP, ohne das Modell zu verändern, wie die Tabelle oben zeigt. Lege die Sigmas vor deiner ersten Baseline fest, dokumentiere sie bei jedem Ergebnis und vergleiche niemals Läufe, die mit unterschiedlichen Werten validiert wurden.
Lösung anzeigen
Beispiel für ein Paket auf einem Förderband, von oben betrachtet. Die Frage lautet: „Zeigt das Etikett nach oben, und in welche Richtung ist es gedreht?“:
| Index | Keypoint | Zweck | Spiegelungspartner | Sigma |
|---|---|---|---|---|
| 0 | label_top_left | Ausrichtung des Etiketts | 1 | 0.04 |
| 1 | label_top_right | Ausrichtung des Etiketts | 0 | 0.04 |
| 2 | label_bottom_right | Ausrichtung des Etiketts | 3 | 0.04 |
| 3 | label_bottom_left | Ausrichtung des Etiketts | 2 | 0.04 |
kpt_shape: [4, 3]
flip_idx: [1, 0, 3, 2]
kpt_oks_sigmas: [0.04, 0.04, 0.04, 0.04]
flip_idx besteht die Prüfung auf Selbstinversität: 0 → 1 → 0 und 2 → 3 → 2. Ein gespiegeltes Etikett vertauscht links und rechts, behält aber oben und unten bei. Daher wird oben links mit oben rechts gepaart, nicht mit unten rechts.
Um die Toleranz zu bestimmen, setze sigma=[0.04] * 4 in oks.py und erweitere die Abweichungswerte. Die Box des Etiketts bestimmt den Maßstab. Verwende daher eine Box, die der Größe eines typischen Paketetiketts in deinen Bildern entspricht. Die Abweichung, bei der OKS erstmals unter 0,5 fällt, ist der größte Fehler, den die Genauigkeit deiner Annotatoren dem Modell erlaubt.