Semantische Segmentierung: Jeden Pixel kennzeichnen
Erstelle mit yolo26n-sem.pt eine pixelweise Klassenkarte, wandle sie in Abdeckungswerte um, erstelle Datensätze mit Klassenkarten im PNG-Format und lies mIoU aus, ohne dich von der Pixelgenauigkeit täuschen zu lassen.
Manche Fragen lassen sich nicht durch das Zählen von Objekten beantworten: Wie viel des Gehwegs ist versperrt, wie viel eines Feldes ist von Unkraut bedeckt, wo endet die befahrbare Straße? Die semantische Segmentierung beantwortet diese Fragen, indem sie jedem Pixel eine Klassen-ID zuweist. Die wichtigste Kennzahl lässt sich allerdings leicht falsch verstehen: Das Modell, das du in dieser Lektion trainierst, erreicht eine Pixelgenauigkeit von 91 %, erkennt aber keine einzige Person.
Praxisnah
Instanz- oder semantische Segmentierung?#
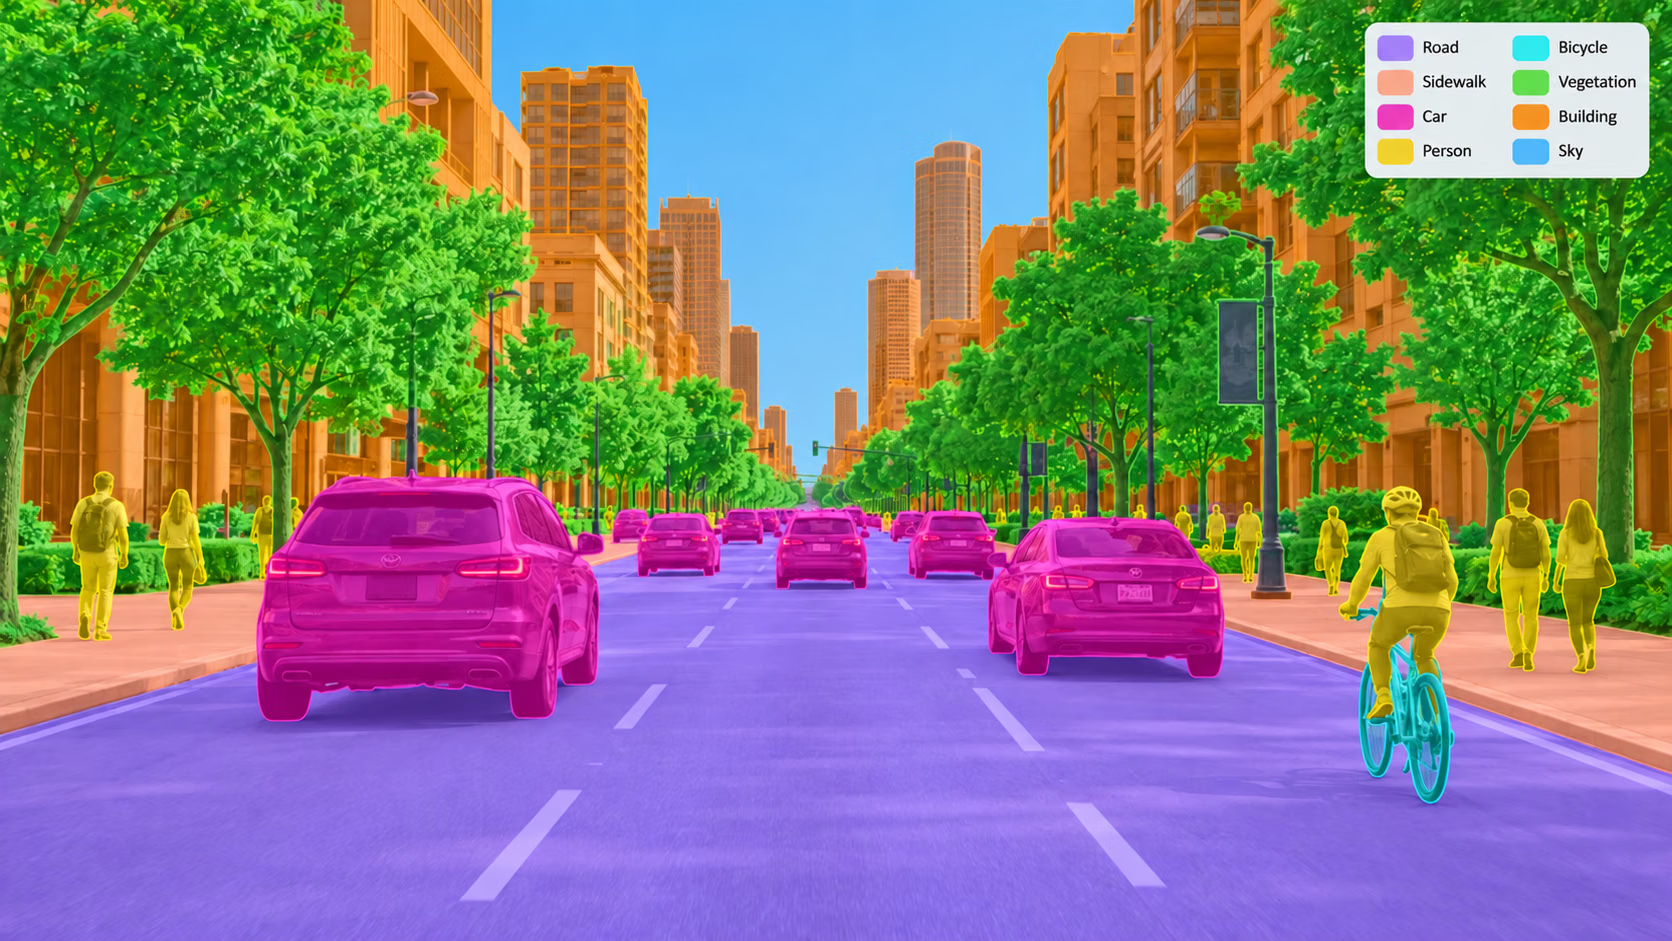
Instanzsegmentierung (segment) | Semantische Segmentierung (semantic) | |
|---|---|---|
| Ausgabe | eine Maske pro Objekt sowie eine Box | eine Klassen-ID pro Pixel |
| Zählt Objekte | ja | nein – zwei sich berührende Autos bilden eine gemeinsame „Auto“-Region |
| Erfasst „Stoff“ (Straße, Himmel, Gras) | schlecht – es gibt keine natürlich abgegrenzten Instanzen | ja |
| Labels | Polygone | PNG-Klassenkarten oder Polygone |
| Maßgebliche Metrik | Masken-mAP50-95 | mIoU |
| Vortrainierte Gewichte | yolo26n-seg.pt (COCO, 80 Klassen) | yolo26n-sem.pt (Cityscapes, 19 Klassen) |
Wenn die nachgelagerte Frage „wie viele“ lautet, verwende Instanzsegmentierung. Geht es um „wie viel“ oder „wo“, ist semantische Segmentierung einfacher zu beschriften und auszuwerten. Die Aufgabenseite zur semantischen Segmentierung enthält eine Modellübersicht.
Eine Klassenkarte vorhersagen#
result.semantic_mask.data ist ein H × W-Tensor in der Originalbildgröße; jeder Wert ist eine Klassen-ID, und 255 bedeutet „ignorieren“. result.summary() wandelt ihn in Pixelanteile pro Klasse um:
from ultralytics import YOLO

model = YOLO("yolo26n-sem.pt")  # Cityscapes, 19 classes
result = model("https://ultralytics.com/images/bus.jpg")[0]

class_map = result.semantic_mask.data  # H x W tensor of class ids, 255 = ignore
print("class map:", tuple(class_map.shape), class_map.dtype)
for row in result.summary():
    if row["pixel_ratio"] >= 0.02:
        print(f"{row['name']:12s} {row['pixel_ratio']:.1%}")
class map: (1080, 810) torch.uint8
road 27.5%
sidewalk 2.0%
building 19.3%
vegetation 4.5%
person 14.6%
train 30.9%Sieh dir die letzte Zeile an. Cityscapes hat eine Klasse bus, doch das Modell ordnet den Bus als train ein. Das Modell wurde mit Aufnahmen trainiert, die überwiegend von Kameras an Autos auf deutschen Straßen stammen. Ein Bus, der aus kurzer Entfernung vom Gehweg aus fotografiert wurde, liegt außerhalb dieser Verteilung. Semantische Modelle übernehmen den Blickwinkel und die Klassendefinitionen ihrer Trainingsdaten – den Datensatzverzerrungen – stärker als Detektoren. Stimme das Modell daher mit deinen eigenen Kamerabildern fein ab, bevor du der Klassenkarte vertraust.
Die Klassenkarte in eine Antwort umwandeln#
Mit einfachen Tensorvergleichen wird aus einer Klassenkarte eine Kennzahl für dein Produkt. Hier geht es um die Frage: „Wie viel der Fläche, auf die eine Person treten würde, ist Straße oder Gehweg, und wie viel davon sind Menschen?“
from ultralytics import YOLO

result = YOLO("yolo26n-sem.pt")("https://ultralytics.com/images/bus.jpg", verbose=False)[0]
class_map = result.semantic_mask.data  # H x W class ids at the original size, 255 = ignore
ids = {name: i for i, name in result.names.items()}

h = class_map.shape[0]
lower = class_map[h // 2 :]  # the half of the frame a pedestrian would walk into
walkable = (lower == ids["road"]) | (lower == ids["sidewalk"])
people = lower == ids["person"]
print(f"lower half: {walkable.float().mean():.0%} road or sidewalk, {people.float().mean():.0%} person")
result.save("semantic_overlay.jpg")  # colored class map over the photo, for a visual check
lower half: 59% road or sidewalk, 23% personDrei Gewohnheiten machen diese Werte verlässlich:
- Rufe IDs anhand des Namens ab aus
result.names, niemals anhand einer fest codierten Zahl; ein Modell, das mit deinen eigenen Klassen trainiert wurde, nummeriert sie anders. - Beschränke die Auswertung auf den relevanten Bereich. Verhältnisse für das ganze Bild beziehen Himmel und Gebäude mit ein. Schneide zuerst die Klassenkarte zu oder multipliziere sie mit einer Bereichsmaske.
- Öffne die Überlagerung.
semantic_overlay.jpgzeigt auf einen Blick, ob der als „Straße“ gezählte Bereich tatsächlich Straße ist.
Das Datensatzformat#
Semantische Datensätze ordnen jedem Bild eine einkanalige Maskengrafik zu, deren Pixelwerte Klassen-IDs sind. Die Anleitung zu semantischen Datensätzen ist die Referenz; die Verzeichnisstruktur entspricht Datei für Datei images/:
cityscapes8/
├── images/
│   ├── train/aachen_000000_000019.png
│   └── val/aachen_000004_000019.png
└── masks/
    ├── train/aachen_000000_000019.png
    └── val/aachen_000004_000019.png
Die YAML-Datei ergänzt masks_dir und – wenn sich die in deinen Masken gespeicherten IDs von den Trainings-IDs unterscheiden – einen label_mapping-Block:
path: cityscapes8
train: images/train
val: images/val
masks_dir: masks # semantic mask directory

names:
  0: road
  1: sidewalk
  # ... 19 classes in total

label_mapping: # raw mask value -> training id
  0: ignore_label
  7: 0 # road
  8: 1 # sidewalk
  # ...
Cityscapes-Masken speichern die ursprünglichen Label-IDs von -1 bis 33. Die Zuordnung behält 19 davon bei und weist alle anderen ignore_label zu, gespeichert als 255. Pixel mit dem Wert 255 werden sowohl von der Verlustfunktion als auch von den Kennzahlen ausgeschlossen. Verwende denselben Wert für Bereiche, bei denen sich deine Annotatoren nicht sicher waren.
Wenn du bereits Polygon-Labels hast, aber kein masks_dir, wandelt der Loader die Polygone für dich in Raster um und fügt eine Klasse background für nicht abgedeckte Pixel hinzu.
Verlustbehaftete Komprimierung vermischt benachbarte Pixelwerte und verwandelt so eine Grenze zwischen Klasse 7 und Klasse 8 in einen verschwommenen Bereich aus 7ern, 8ern und nicht vorhandenen IDs. Speichere jede Maske als PNG oder TIFF.
Trainieren und mIoU auswerten#
Cityscapes8 umfasst 8 Bilder mit urbanen Szenen – 4 zum Trainieren und 4 zur Validierung – und reicht für einen CPU-Schnelltest aus:
from ultralytics import YOLO

model = YOLO("yolo26n-sem.pt")
model.train(data="cityscapes8.yaml", epochs=1, imgsz=320, device="cpu")
metrics = model.val()
print(f"mIoU: {metrics.miou:.3f}  pixel accuracy: {metrics.pixel_accuracy:.3f}")
Class Images Pixels mIoU PixAcc
all 4 192315 0.415 0.906
road 4 78529 0.974 0.996
vegetation 4 37602 0.844 0.936
person 3 722 0 0
rider 1 21 0 0
mIoU: 0.415 pixel accuracy: 0.906(Zeilen pro Klasse gekürzt.) Die Pixel-genauigkeit beträgt 91 %, die mIoU 42 %, und die Zeilen pro Klasse zeigen, dass das Modell keine einzige Person erkannt hat. Alle drei Werte stimmen. Straße, Gebäude und Vegetation machen den größten Teil der Pixel aus – allein auf die Straße entfallen 78,529 von 192,315 Pixeln. Daher erzielt ein Modell, das diese Klassen gut einfärbt, eine hohe Pixelgenauigkeit, während es alle kleinen Klassen verfehlt. Die mIoU mittelt die IoU pro Klasse mit gleichem Gewicht, sodass jede verfehlte Klasse den Wert senkt.

Lege Grenzwerte sowohl für mIoU als auch für die IoU der Klassen fest, auf die dein Produkt reagiert. Bei einer Sicherheitsfunktion für Fußgänger führt eine Person-IoU von 0 zum Durchfallen, unabhängig davon, was die Pixelgenauigkeit aussagt.
Lösung anzeigen
In unserem Lauf: mIoU 0.415, Pixelgenauigkeit 0.906 und IoU 0 für Wand, Person, Fahrer, Motorrad und Fahrrad sowie für jede Klasse, die in den vier Validierungsbildern nicht vorkommt.
Die Pixelgenauigkeit ist höher, weil sie Pixel zählt und Straße, Gebäude, Vegetation und Himmel den Großteil jedes Cityscapes-Bildes ausmachen. Bei der mIoU zählt jede Klasse gleich viel. Daher senken fünf verfehlte kleine Klassen den Durchschnitt, obwohl sie nur einige Hundert Pixel bedecken. Bei einem Produkt, das auf Menschen reagiert, fällt dieses Modell allein wegen seiner IoU für Personen durch die Freigabeprüfung.