Aufgabe auswählen und Pipeline planen
Ordne jede Produktfrage einer der sieben Ultralytics-YOLO-Aufgaben zu und lege Gewichte, Ergebnisfeld, Label-Format und maßgebliche Metrik fest. Belege den Plan, indem du jede Aufgabe mit einem Bild ausführst.
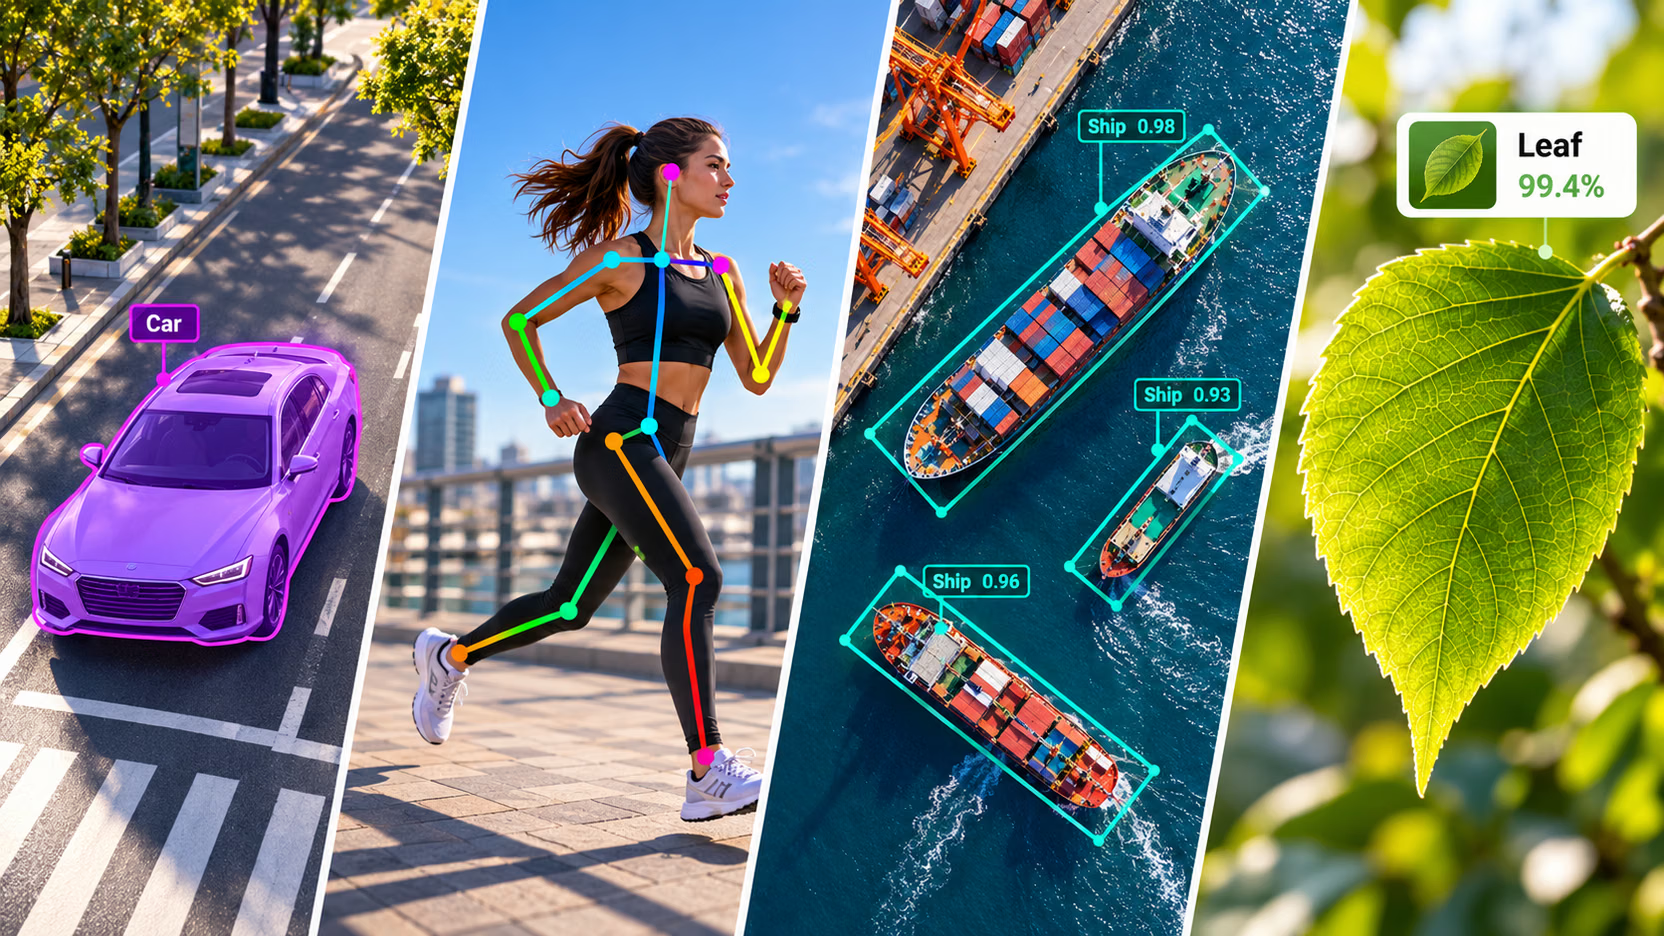
Sobald ein Detektor im Einsatz ist, lauten die nächsten Anfragen selten „mehr Boxen“. Stattdessen geht es um Fragen wie „Wie groß ist die verschüttete Flüssigkeit?“, „Ist der Rücken der Arbeitskraft gekrümmt?“, „In welche Richtung zeigt das Schiff?“ und „Ist dieses Teil Ausschuss?“. Auf dem Straßenfoto, das in diesem Kurs durchgehend verwendet wird, nimmt die Bounding-Box des Busses 48 % des Bildes ein, während der Bus selbst nur 29 % abdeckt. Eine flächenbasierte Antwort, die sich auf die Box stützt, läge also um mehr als die Hälfte daneben. Die gewählte Aufgabe bestimmt das Label-Format. Deshalb ist die Auswahl vor der ersten Beschriftung die kostengünstigste Entscheidung im Projekt; eine spätere Änderung bedeutet, dass die Labels neu erstellt werden müssen.
Praxisnah
Ein Foto, vier verschiedene Antworten#

Stelle eine Frage zu einem Foto — wie viel des Bildes nimmt der Bus ein und wie weit ist er entfernt? — und lass vier Ultralytics-YOLO-Aufgaben darauf antworten:
from ultralytics import YOLO

image = "https://ultralytics.com/images/bus.jpg"
det = YOLO("yolo26n.pt")(image, verbose=False)[0]
seg = YOLO("yolo26n-seg.pt")(image, retina_masks=True, verbose=False)[0]
sem = YOLO("yolo26n-sem.pt")(image, verbose=False)[0]
depth = YOLO("yolo26n-depth.pt")(image, verbose=False)[0]
frame = det.orig_shape[0] * det.orig_shape[1]  # pixels in the photo

i = [det.names[int(c)] for c in det.boxes.cls].index("bus")
x1, y1, x2, y2 = det.boxes.xyxy[i].tolist()
print(f"detect    bus box covers   {(x2 - x1) * (y2 - y1) / frame:.1%} of the frame")

i = [seg.names[int(c)] for c in seg.boxes.cls].index("bus")
bus_mask = seg.masks.data[i].bool()  # H x W, True on bus pixels
print(f"segment   bus mask covers  {bus_mask.sum().item() / frame:.1%} of the frame")

ratios = {row["name"]: row["pixel_ratio"] for row in sem.summary()}
print(f"semantic  'train' pixels   {ratios['train']:.1%} of the frame")

meters = depth.depth.data[bus_mask].median().item()  # depth map and mask share the original size
print(f"depth     bus is about     {meters:.1f} m from the camera")
detect bus box covers 47.7% of the frame
segment bus mask covers 29.2% of the frame
semantic 'train' pixels 30.9% of the frame
depth bus is about 4.5 m from the cameraGehe die Ergebnisse Zeile für Zeile durch:
- detect beantwortet wo. Die Box umfasst auch die Straße unter dem Bus und die vier Personen davor. Als Flächenangabe ist sie daher 63 % zu groß.
- segment beantwortet welche Form. 29,2 % ist die tatsächliche Fläche des Busses im Bild — die Zahl, die du für Regeln zu Fläche, Abdeckung oder Überlappung verwenden solltest.
- semantic beantwortet welche Pixel zu welcher Klasse gehören. Die Fläche ähnelt der der Maske, aber das Modell bezeichnet den Bus als
train: Es weist Oberflächen die Klassen seines Trainingsdatensatzes zu (Cityscapes, Lektion 4) und unterscheidet niemals einzelne Fahrzeuge voneinander. - depth beantwortet wie weit entfernt. Die mediane Tiefe innerhalb der Busmaske beträgt 4,5 m — zwei Aufgaben kombiniert, um eine Frage zu beantworten, die keine von beiden allein beantworten kann.
Wenn dein Produkt als Ergebnis eine Fläche, einen Flächenanteil oder eine Überlappung ausgibt, ist eine Box das falsche Werkzeug. Verwende für Objekte eine Maske (Segmentierung) oder für Oberflächen eine Klassenkarte (semantische Segmentierung).
Die sieben Aufgaben im Überblick#
Computer Vision Foundations behandelt ausführlich, wie du zwischen Aufgaben auswählst — sieh dir Die sieben Vision-Aufgaben noch einmal an, wenn die Auswahl nicht offensichtlich ist. Dies ist die praktische Zusammenfassung für den Rest des Kurses. Jede Zeile steht für eine Aufgabe, die das installierte Paket ultralytics mit derselben API trainiert, validiert, für Vorhersagen verwendet und exportiert; die Übersicht der Aufgaben enthält die vollständige Referenz.
| Frage, die die Ausgabe beantwortet | Aufgabe | YOLO26-Gewichte | Ergebnisfeld | Label-Format | Maßgebliche Metrik |
|---|---|---|---|---|---|
| Wo befindet sich jedes Objekt? | detect | yolo26n.pt | boxes | Klasse + Box | Box-mAP50-95 |
| Welche genaue Form und Fläche hat jedes Objekt? | segment | yolo26n-seg.pt | masks + boxes | Klasse + Polygon | Masken-mAP50-95 |
| Zu welcher Klasse gehört jedes Pixel? | semantic | yolo26n-sem.pt | semantic_mask | PNG-Klassenkarte oder Polygone | mIoU |
| Wo befinden sich die Gelenke oder Landmarken? | pose | yolo26n-pose.pt | keypoints + boxes | Klasse + Box + Keypoints | Pose-mAP50-95 (OKS) |
| Wie ist jedes Objekt gedreht? | obb | yolo26n-obb.pt | obb | Klasse + 4 Ecken | OBB-mAP50-95 |
| Was ist auf diesem gesamten Bild (oder Ausschnitt) zu sehen? | classify | yolo26n-cls.pt | probs | Ein Ordner pro Klasse | Top-1-Genauigkeit |
| Wie weit ist jedes Pixel von der Kamera entfernt? | depth | yolo26n-depth.pt | depth | Tiefenkarte pro Bild (16-Bit-PNG oder NPY) | δ1 (delta1) |
Die erste Zeile setzt du bereits ein. In den Lektionen 2 bis 8 lernst du die fünf mittleren Zeilen kennen, und in den Lektionen 9 und 10 verknüpfst du sie und bringst sie zum Einsatz. Die letzte Zeile, die monokulare Tiefenschätzung, sagt für jedes Pixel eines einzelnen Bildes eine Entfernung in Metern voraus. Die Labels stammen von Tiefensensoren oder 3D-Renderern statt von Annotierenden, weshalb dafür ein eigenes Datensatzformat verwendet wird. Dieser Kurs behandelt die Tiefenschätzung überall dort, wo sich der Arbeitsablauf überschneidet: in diesem Plan, in der Validierungsschleife und bei der Exportprüfung in der letzten Lektion.
Wähle jeweils eine Frage aus#
Gehe die Fragen der Reihe nach durch und halte beim ersten Ja an:
Der Entscheidungsbaum deckt die häufigsten Fälle ab. Vier Entscheidungshilfen helfen bei den meisten übrigen Fällen:
| Wenn die Anfrage … | Wähle | Denn |
|---|---|---|
| eine Anzahl und eine Fläche erfordert („wie viele verschüttete Flüssigkeiten und wie groß sind sie?“) | segment | semantische Segmentierung verbindet sich berührende Objekte zu einer Region |
| lange, schmale Objekte betrifft, die dicht nebeneinander liegen und von oben zu sehen sind | obb | achsenparallele Boxen sich überlappen und NMS echte Objekte verwirft, selbst wenn du den Winkel nie ausliest |
| zwischen Vorder- und Rückseite oder links und rechts unterscheiden muss | pose | eine OBB liefert eine Achse, aber keine Ausrichtung |
| konstruktionsbedingt genau ein Element pro Bild zeigt (eine feste Prüfstation) | classify | die kostengünstigsten Labels und das schnellste Modell ermöglicht |
Die Aufgabe wird beim Erstellen des Datensatzes festgelegt — auf der Ultralytics Platform ist das das Feld Task Type im Dialog „Neuer Datensatz“. Diese Entscheidung fällt also vor dem ersten Label:

Eine API, sieben Ergebnisfelder#
Für jede Aufgabe kommt derselbe Aufruf zum Einsatz; das Modell liest seine Aufgabe aus der Gewichtsdatei. Der Unterschied liegt darin, welches Ergebnisfeld ausgefüllt ist — und genau dieses Feld liest dein Code aus:
from ultralytics import YOLO

WEIGHTS = ["yolo26n.pt", "yolo26n-seg.pt", "yolo26n-sem.pt", "yolo26n-pose.pt", "yolo26n-obb.pt", "yolo26n-cls.pt", "yolo26n-depth.pt"]
FIELDS = ("boxes", "masks", "semantic_mask", "keypoints", "obb", "probs", "depth")

for weights in WEIGHTS:
    model = YOLO(weights)
    result = model("https://ultralytics.com/images/bus.jpg", verbose=False)[0]
    fields = [f for f in FIELDS if getattr(result, f) is not None]
    print(f"{weights:17s} task={model.task:9s} fields={fields}")
yolo26n.pt task=detect fields=['boxes']
yolo26n-seg.pt task=segment fields=['boxes', 'masks']
yolo26n-sem.pt task=semantic fields=['semantic_mask']
yolo26n-pose.pt task=pose fields=['boxes', 'keypoints']
yolo26n-obb.pt task=obb fields=['obb']
yolo26n-cls.pt task=classify fields=['probs']
yolo26n-depth.pt task=depth fields=['depth']Die Ergebnisse von Segmentierung und Pose enthalten weiterhin boxes. Daher funktioniert dein bestehender Detektionscode auch mit ihnen. Ergebnisse der Klassifizierung, semantischen Segmentierung und Tiefenschätzung beschreiben das gesamte Bild und enthalten überhaupt keine Felder für einzelne Objekte.
Detektionscode, der result.boxes durchläuft, bricht mit TypeError: 'NoneType' object is not iterable ab, wenn er auf ein OBB-Modell trifft: result.boxes ist None, und die gedrehten Detektionen befinden sich ausschließlich in result.obb. Passe den Detektionscode für OBB an, indem du result.obb ausliest, statt auf None zu prüfen und dadurch null Detektionen zu erhalten.
Wenn ein Modell nicht ausreicht#
Die meisten Produktionssysteme, die über die Detektion hinausgehen, folgen einer von drei Strukturen:
- Erst detektieren, dann klassifizieren. Der Detektor findet kleine Objekte in einem großen Bild; ein Bildklassifikator klassifiziert jeden Ausschnitt in voller Auflösung detailliert: Helmtyp, Fehlergrad, Produkt-SKU.
- Pose plus Tracking. Keypoints beschreiben ein Einzelbild; ein Tracker erstellt daraus eine Zeitreihe pro Person, anhand derer du Wiederholungen zählen oder Stürze erkennen kannst.
- Erst segmentieren, dann messen. Das Modell liefert Pixel; einfacher Code wandelt sie in Flächen, Breiten, Abdeckungsverhältnisse oder (mit Tiefeninformationen) Entfernungen um.
Für die Labels einer Pipeline, die erst segmentiert und dann misst, wird ein Polygon pro Objekt benötigt, wie bei diesen Paketen auf Lagerrobotern im Editor der Ultralytics Platform:
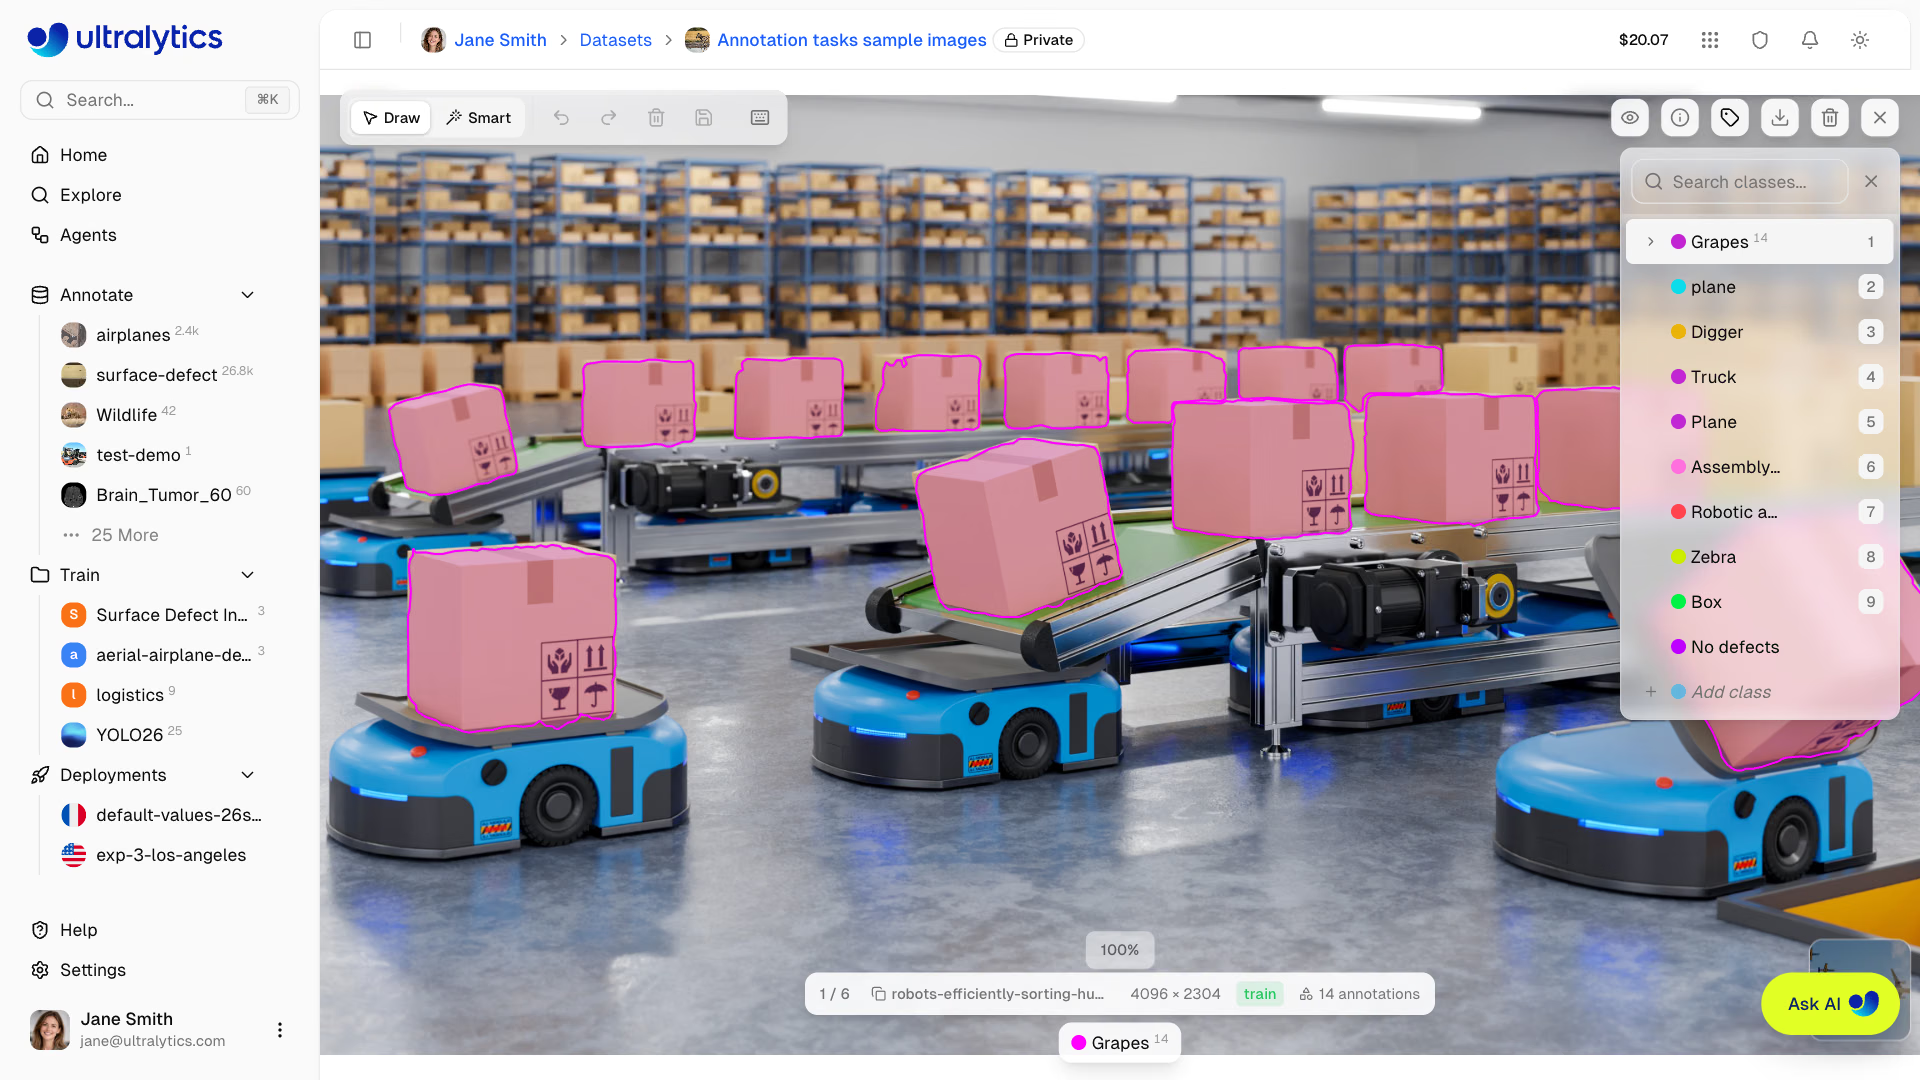
Ein zweites Modell verursacht zusätzliche Inferenzlatenz, einen zweiten Datensatz, der beschriftet und gepflegt werden muss, und ein zweites Modell, das überwacht werden muss. Verknüpfe Modelle nur dann, wenn eine einzelne Aufgabe die Frage nicht beantworten kann – ein bereitstellbarer Plan mit einem Modell ist besser als ein Plan mit drei Modellen, die du nicht beschriften kannst.
Stolperfallen#
Symptom: Das Team beschriftet Polygone, weil Masken in Demos gut aussehen, aber das Produkt später nur eine Anzahl ausliest. Lösung: Benenne vor dem Beschriften die Codezeile, die die Ausgabe verarbeitet. Wenn nichts den Umriss ausliest, stelle einen Detektor bereit: Boxen lassen sich schneller beschriften und verarbeiten.
Symptom: Nach einem Monat Beschriftungsarbeit fällt jemandem auf, dass das Produkt eine Ausrichtung benötigt, der Datensatz aber OBB-Labels enthält, die nur eine Achse angeben. Lösung: Schreibe das genaue Attribut in den Plan (result.masks.xy, result.keypoints.xy, result.obb.xywhr) und führe tasks.py mit den ausgewählten Gewichten aus, bevor du das erste Label erstellst.
Symptom: Ein Klassifikator, der bei sauberen Produktfotos 95 % erreicht, liegt bei den meisten zugeschnittenen Detektionen aus der Produktion falsch. Lösung: Erstelle den Datensatz für die zweite Stufe anhand der Zuschnitte, die die erste Stufe selbst erzeugt, einschließlich der tatsächlichen Unschärfe und des Bildausschnitts. Lektion 9 zeigt wie.
Lösung anzeigen
Für die Palettenanfrage:
| Zeile | Auswahl |
|---|---|
| Frage | Ragt ein Teil einer Palette über die Kante des Regalträgers hinaus? |
| Aufgabe | segment — ob etwas übersteht, hängt vom Umriss der Palette ab; ihre Box umfasst auch den Zwischenraum unter der Palette und die darauf befindliche Ladung |
| Gewichte | yolo26n-seg.pt, feinabgestimmt mit Bildern der Lagerkameras |
| Label-Format | Ein Polygon pro Palette |
| Ergebnisfeld | result.masks.data mit retina_masks=True (Pixel jenseits der Trägerkante) |
| Maßgebliche Metrik | Masken-mAP50-95 auf einer Kamera, deren Bilder nicht im Training verwendet wurden |
| Zweite Stufe | Keine – die Strahllinie ist für jede Kamera festgelegt, sie ist also eine Konfiguration und kein Modell |
Die Überhangregel besteht dann aus drei Codezeilen: Zeichne die Strahllinie einmal pro Kamera ein, zähle die Maskenpixel auf der falschen Seite der Linie und löse einen Alarm aus, wenn ein Pixelgrenzwert überschritten wird, den du anhand einiger bekannter Überhänge kalibrierst. Lektion 3 zeigt genau diese Art von Masken-Region-Test.