Einen Bildklassifikator trainieren
Richte einen Datensatz als Ordnerstruktur ein, trainiere yolo26n-cls.pt mit MNIST160, lies Wahrscheinlichkeiten und Top-1-Genauigkeit aus und leite Vorhersagen mit geringer Konfidenz zur manuellen Prüfung weiter.
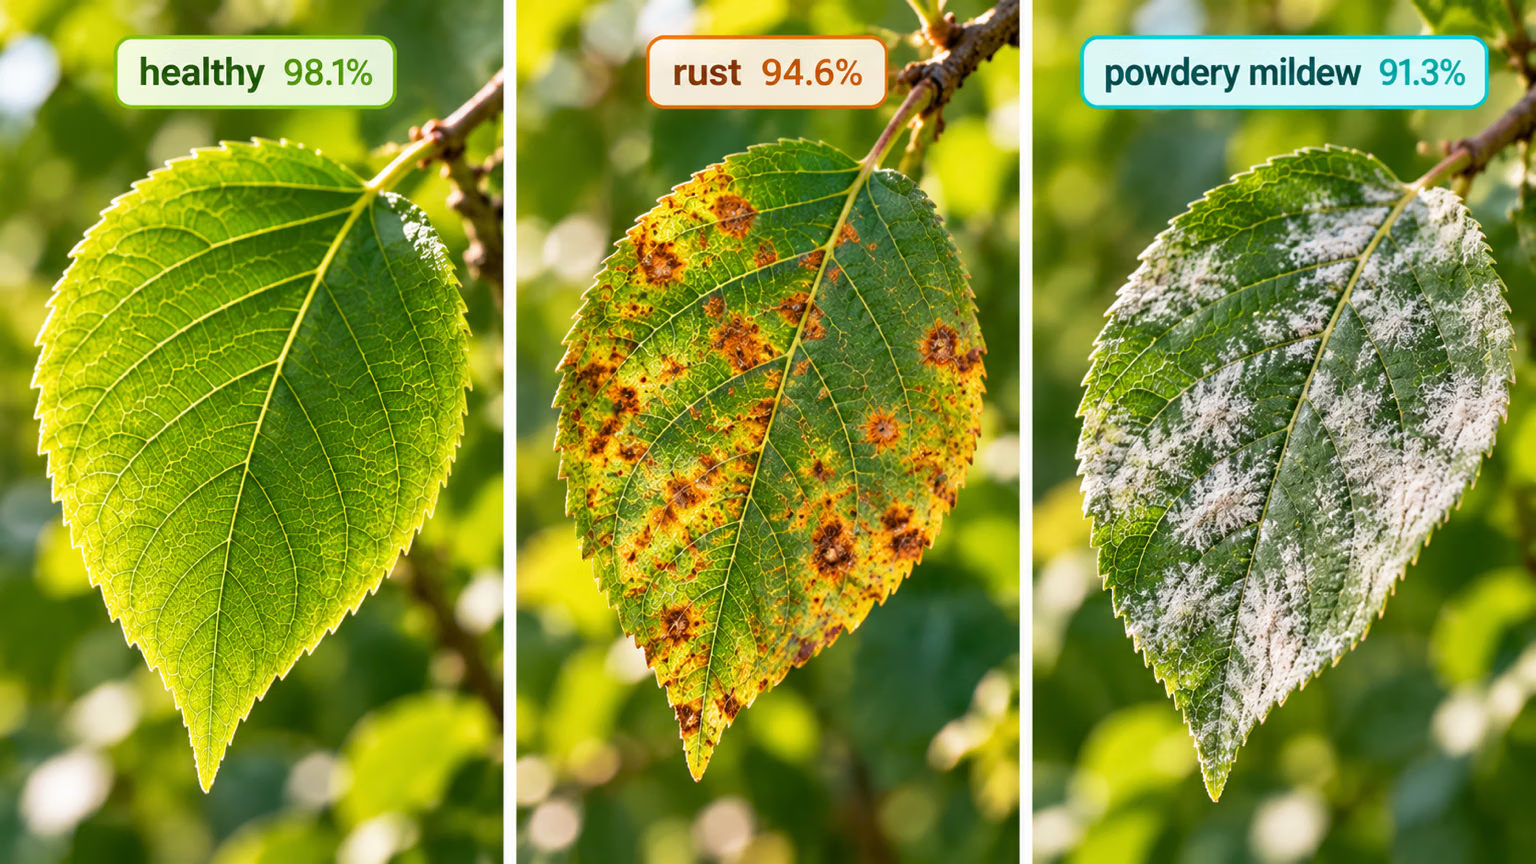
Die Bildklassifizierung beantwortet eine Frage pro Bild: Was ist das? Sie benötigt die einfachsten Labels aller Aufgaben — einen Ordnernamen — und läuft am schnellsten. Deshalb ist sie die Standardwahl als zweite Stufe nach einem Detektor und das richtige erste Modell für eine Prüfstation, die ein Bauteil pro Bild erfasst. Der Datensatz benötigt keine YAML-Datei; die Ordnerstruktur legt daher die Regeln fest. Ein Klassifikator gibt immer eine Antwort, auch bei Bildern, die nichts mit den bisher gesehenen Bildern gemeinsam haben. Zu entscheiden, wann man ihm nicht vertrauen sollte, ist die halbe Arbeit.
Praxisnah
Die Ordnerstruktur des Datensatzes#
Klassifizierungsdatensätze bestehen aus Verzeichnissen, nicht aus YAML-Dateien. Verweise data= auf den Stammordner:
parts/
├── train/
│   ├── good/      img_0001.jpg ...
│   ├── scratch/   img_0412.jpg ...
│   └── dent/      img_0733.jpg ...
└── val/
    ├── good/
    ├── scratch/
    └── dent/
Was der Datenlader damit macht, geht aus dem installierten Quellcode und dem Leitfaden zu Klassifizierungsdatensätzen hervor:
| Situation | Verhalten |
|---|---|
| Klassenindizes | Ordnernamen unter train/, alphabetisch sortiert → dent=0, good=1, scratch=2 |
| Validierungsordner | val/, dann validation/, dann valid/; verwendet bei Bedarf test/ und gibt eine Warnung aus |
Kein Ordner train/, nur Klassenordner | Teilt die Daten automatisch im Verhältnis 80/20 in train/ und val/ auf |
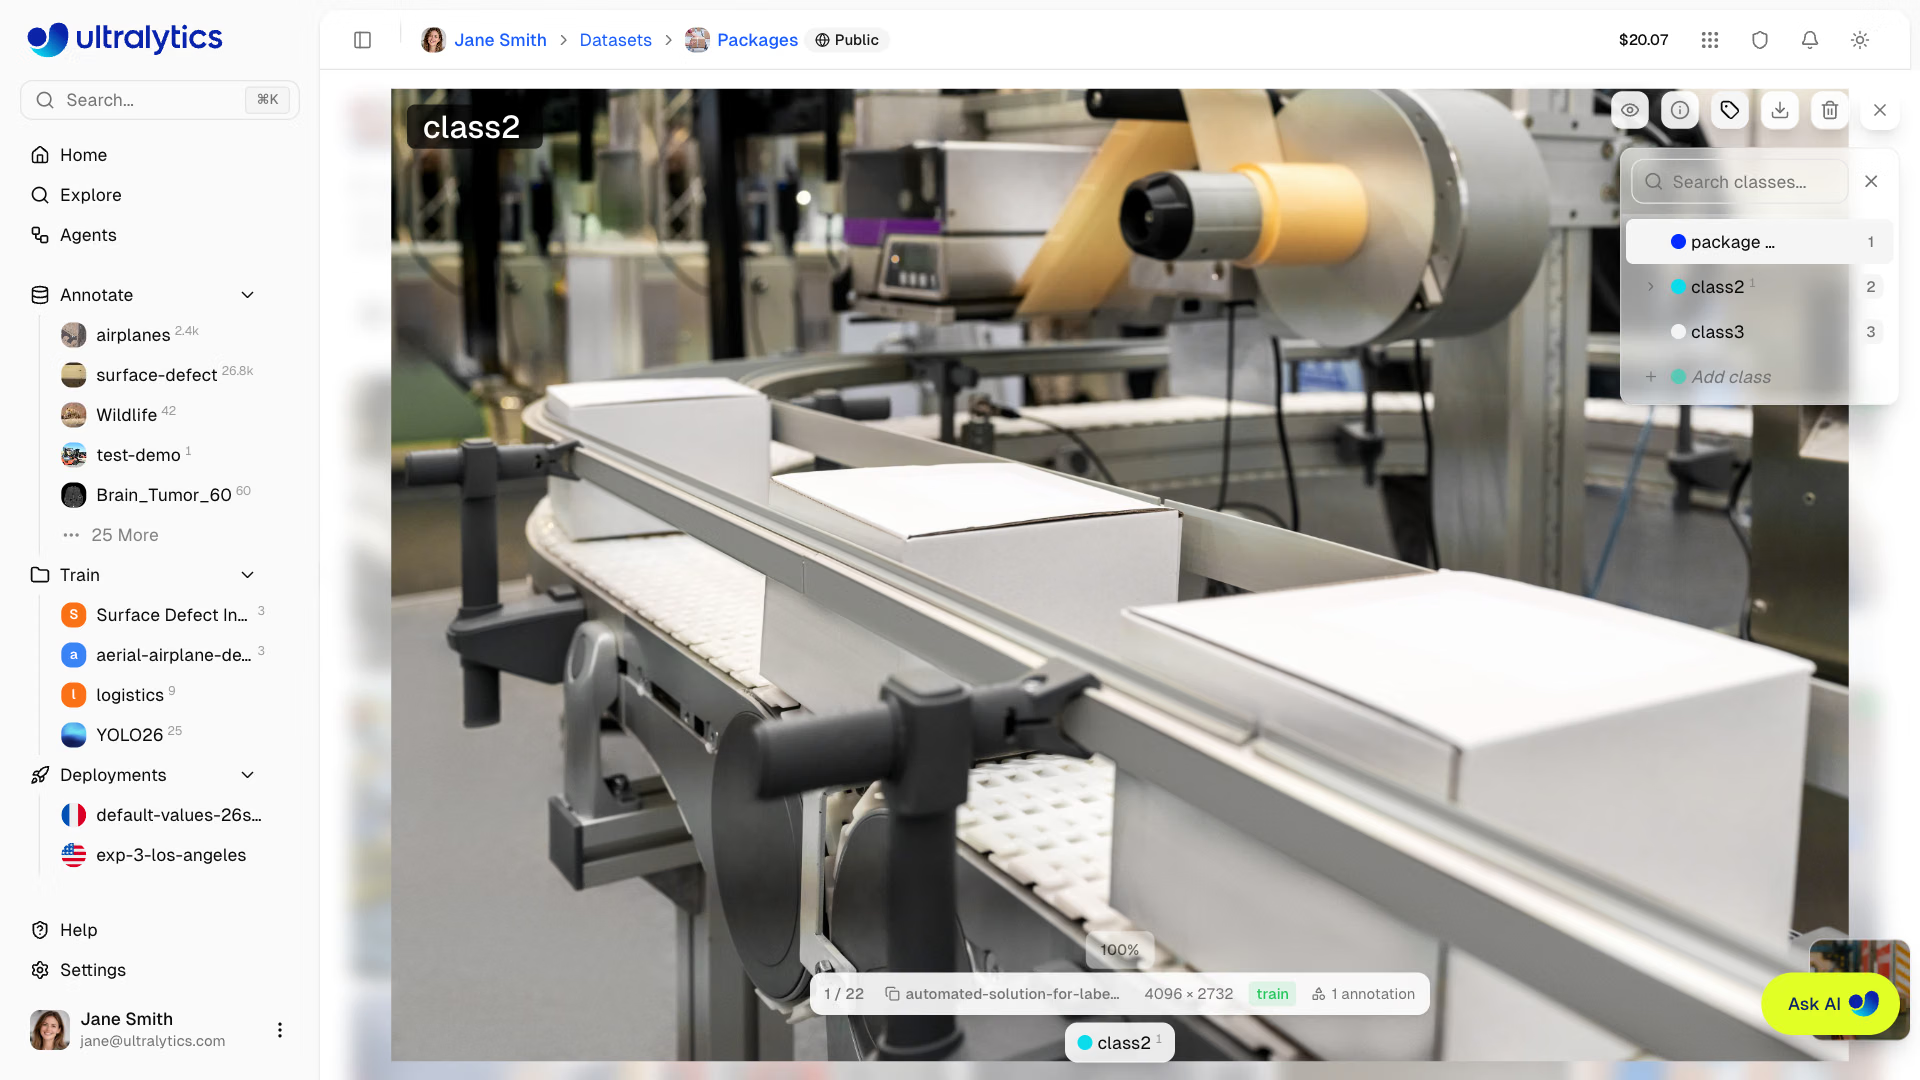
Auf der Ultralytics Platform enthält ein Klassifizierungsdatensatz pro Bild ein Label auf Bildebene statt Formen:
Symptom: Nach dem Hinzufügen einer Klasse meldet eine alte Integration good-Teile als dent. Ursache: Ein Ordner namens bent wird alphabetisch an den Anfang sortiert und verschiebt alle nachfolgenden Indizes. Lösung: Ordne Indizes immer mit model.names (oder result.names) Namen zu; verwende niemals fest codierte Indizes.
Mit MNIST160 trainieren#
MNIST160 umfasst 160 handgeschriebene Ziffern, 80 in train/ und 80 in test/, jeweils auf zehn Ziffernordner verteilt — klein genug für einen CPU-Rauchtest. Der Datensatz enthält keinen Ordner val/; achte daher auf die Warnung des Datenladers und darauf, dass er stattdessen test/ verwendet:
from ultralytics import YOLO

model = YOLO("yolo26n-cls.pt")
model.train(data="mnist160", epochs=1, imgsz=64, device="cpu")
metrics = model.val()
print(f"top-1: {metrics.top1:.3f}  top-5: {metrics.top5:.3f}")
WARNING ⚠️ Dataset 'split=val' not found, using 'split=test' instead.
val: .../datasets/mnist160/test... found 80 images in 10 classes ✅
all 0.162 0.463
top-1: 0.162 top-5: 0.463Eine Epoche verändert den neuen Kopf mit zehn Klassen kaum. In unserem Lauf erreichte epochs=10 auf einer Laptop-CPU in etwa zehn Sekunden eine Top-1-Genauigkeit von 0.55 und Top-5 von 0.95 — die Trainingsschleife funktioniert, braucht aber einfach mehr Epochen. Im Leitfaden zur Klassifizierungsaufgabe sind die Größen der vortrainierten Modelle aufgeführt.
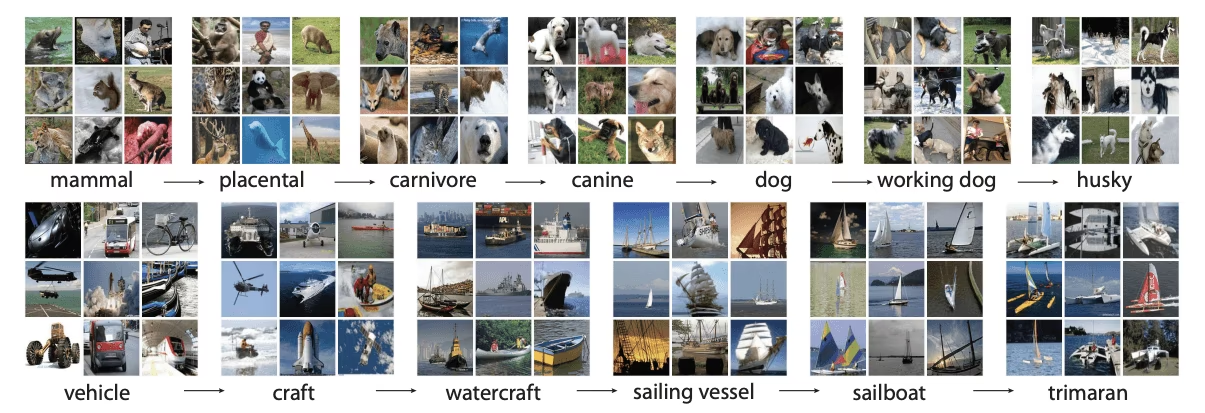
Top-1 ist der Anteil der Bilder, bei denen die Klasse mit der höchsten Wahrscheinlichkeit korrekt ist. Top-5 zählt einen Treffer, wenn die richtige Klasse unter den fünf wahrscheinlichsten ist. Top-5 ist bei den 1.000 Klassen von ImageNet aussagekräftig, deren Klassen von allgemein bis sehr spezifisch reichen; bei fünf oder weniger Klassen beträgt der Wert immer 1.0, und bei zehn Klassen ist er großzügig. Beurteile das Modell anhand der Genauigkeit bei Top-1 sowie einer Konfusionsmatrix pro Klasse.
Wahrscheinlichkeiten im Code auslesen#
from ultralytics import YOLO

model = YOLO("yolo26n-cls.pt")  # ImageNet, 1,000 classes
result = model("https://ultralytics.com/images/bus.jpg")[0]

probs = result.probs
print(f"top-1: {result.names[probs.top1]} ({float(probs.top1conf):.2f})")
for i, conf in zip(probs.top5, probs.top5conf.tolist()):
    print(f"  {result.names[i]:20s} {conf:.3f}")
top-1: minibus (0.52)
minibus 0.516
police_van 0.369
trolleybus 0.096
minivan 0.006
ambulance 0.003probs.top1 ist ein Index, probs.top5 eine Liste von Indizes und probs.data der vollständige Wahrscheinlichkeitsvektor. Beachte die Top-1-Konfidenz: 0.52 ist kaum mehr als ein Münzwurf zwischen minibus und police_van. Anhand dieser Zahl leitest du die Vorhersage weiter.
Unsichere Vorhersagen zur Prüfung an eine Person weiterleiten#
Ein Klassifikator muss in der Produktion selten bei jedem Bild richtig liegen; er muss bei den Bildern richtig liegen, die er eigenständig beurteilt. Dieses Skript trainiert das Modell über 10 Epochen und misst anschließend, wie sich verschiedene Konfidenzschwellenwerte auf die 80 zurückgehaltenen Ziffern auswirken würden:
from pathlib import Path

from ultralytics import YOLO

model = YOLO("yolo26n-cls.pt")
model.train(data="mnist160", epochs=10, imgsz=64, device="cpu", plots=False)  # model now holds best.pt
print(model.names)  # folder names, sorted, became class indices

test = Path(model.trainer.data["test"])  # mnist160/test, the split the loader validated on
images = sorted(test.rglob("*.png"))
results = model(images, imgsz=64, verbose=False)
truth = [p.parent.name for p in images]

for threshold in (0.0, 0.3, 0.6):
    kept = [(r, t) for r, t in zip(results, truth) if r.probs.top1conf >= threshold]
    correct = sum(r.names[r.probs.top1] == t for r, t in kept)
    print(f"threshold {threshold:.1f}: auto-accept {len(kept):2d}/{len(images)}, accuracy on accepted {correct / max(len(kept), 1):.0%}")
{0: '0', 1: '1', 2: '2', 3: '3', 4: '4', 5: '5', 6: '6', 7: '7', 8: '8', 9: '9'}
threshold 0.0: auto-accept 80/80, accuracy on accepted 55%
threshold 0.3: auto-accept 41/80, accuracy on accepted 68%
threshold 0.6: auto-accept 10/80, accuracy on accepted 80%Jede Zeile zeigt einen Zielkonflikt: Ein höherer Schwellenwert erhöht die Genauigkeit der akzeptierten Vorhersagen und leitet mehr Bilder an eine Person weiter. Bei 0.6 entscheidet dieses Modell nur bei 10 von 80 Ziffern selbst — es ist noch nicht bereit, irgendetwas zu automatisieren. Die Lösung sind mehr Trainingsepochen, kein ausgefeilterer Schwellenwert. Führe dieselbe Tabelle nach jeder Trainingsrunde erneut aus: Sie zeigt sowohl die erreichbare Genauigkeit als auch genau, wie viel Prüfaufwand jeder Schwellenwert verursacht.
Wähle den niedrigsten Schwellenwert, bei dem die Genauigkeit auf den akzeptierten Bildern deine Anforderung erfüllt, gemessen mit zurückgehaltenen Daten. Prüfe anschließend, ob dein Team das dadurch entstehende Prüfvolumen bewältigen kann; falls nicht, verbessere das Modell.
Stolperfallen#
Symptom: Eine leere Station, ein falsches Teil oder eine Hand vor der Linse erhält eine selbstsichere Klassenbezeichnung. Ursache: Die Wahrscheinlichkeiten von softmax summieren sich immer zu 1, daher wählt der Klassifikator stets eine seiner Klassen aus. Lösung: Füge einen Ordner other/ hinzu, der genau solche Bilder enthält, und leite Vorhersagen mit niedrigem top1conf zur Prüfung weiter.
Symptom: Ein vortrainiertes Modell erzielt auf deinem Datensatz vor dem Training einen Wert nahe null. Ursache: yolo26n-cls.pt sagt 1.000 ImageNet-Indizes voraus, und deine Ordner verwenden die Indizes 0–9 mit anderen Bedeutungen: Bei MNIST160 hat der Ordner 0 den Index 0, den der vortrainierte Klassifikationskopf als tench bezeichnet. Auf diese Weise haben wir einen Top-1-Wert von 0,000 gemessen. Lösung: Zuerst feinabstimmen, dann validieren.
Symptom: Top-1 liegt bei der Validierung nahe 1,0, in der Produktion jedoch deutlich niedriger. Ursache: Nahezu identische Fotos desselben Teils in train/ und val/. Lösung: Teile nach Teil oder Sitzung auf, wie unter Datensatz richtig aufteilen beschrieben.
Klassifikatoren werden mit imgsz=224 vortrainiert, nicht mit 640. Kleine Objekte in einem großen Bild lassen sich besser mit Erkennung und anschließender Klassifizierung behandeln (nächste Lektion) als mit einem größeren imgsz.
Lösung anzeigen
from ultralytics import YOLO

for epochs in (1, 10):
    model = YOLO("yolo26n-cls.pt")
    model.train(data="mnist160", epochs=epochs, imgsz=64, device="cpu")
    metrics = model.val()
    print(f"{epochs:2d} epochs  top-1: {metrics.top1:.3f}  top-5: {metrics.top5:.3f}")
print(model.names)  # {0: '0', 1: '1', ..., 9: '9'}
Unsere Läufe: 1 Epoche → Top-1 0.162, Top-5 0.463; 10 Epochen → Top-1 0.550, Top-5 0.950. Bei fünf Klassen ist die richtige Antwort immer unter den fünf wahrscheinlichsten; daher beträgt Top-5 zwangsläufig 1.0 und sagt nichts aus.
Für 75 % Genauigkeit bei akzeptierten Bildern ergibt route.py den Wert 0.6 (80 % bei 10 akzeptierten Bildern); dadurch werden 70 von 80 Ziffern zur Prüfung weitergeleitet. Das ist die ehrliche Antwort: Der Schwellenwert erfüllt die Genauigkeitsanforderung, aber das Modell ist noch nicht nützlich. Trainiere länger und führe die Tabelle erneut aus, bevor du einen Schwellenwert für den echten Einsatz festlegst.