1つのパイプラインでタスクを組み合わせる
検出してから分類するカスケードを構築し、トラッキング中の物体を各フレームではなく1回だけ分類し、ポーズキーポイントから人物ごとの時系列データを作成します。
検出を超える最も有用なシステムは、通常1つではなく2つのモデルで構成されます。検出器が作業員をすべて見つけ、分類器が各ヘルメットの種類が適切か判断します。ポーズモデルが関節を検出し、トラッカーが繰り返し回数を数えられるタイムラインに変換します。コードは短く済みます。こうしたシステムで問題になるのは、第1ステージのクロップに合わない第2ステージ用データセットと、フレーム内の物体ごとに処理コストが増えることです。単純に実行すると、10人が映る30 FPSのストリームでは、1秒あたり300回の分類が必要になります。
実践的
ほとんどの製品に対応する2つのパターン#
どちらも同じフレームと同じUltralytics APIから始まりますが、第2ステージで処理するものが異なります。object trackingのトラッカー選定、チューニング、ストリーム処理については、ByteTrack、BoT-SORT、TrackTrackで物体をトラッキングするで扱います。ここではタスクの連携に焦点を当てます。
検出してからクロップを分類する#
from ultralytics import YOLO

detector = YOLO("yolo26n.pt")
classifier = YOLO("yolo26n-cls.pt")  # swap in your own fine-tuned classifier

result = detector("https://ultralytics.com/images/bus.jpg", conf=0.5)[0]
crops, labels = [], []
for box in result.boxes:
    x1, y1, x2, y2 = box.xyxy[0].int().tolist()
    crops.append(result.orig_img[y1:y2, x1:x2])  # BGR numpy crop, same as the detector saw
    labels.append(result.names[int(box.cls)])

for label, crop_result in zip(labels, classifier(crops, verbose=False)):  # one batched call for all crops
    probs = crop_result.probs
    print(f"{label:6s} -> {crop_result.names[probs.top1]} ({float(probs.top1conf):.2f})")
bus -> bullet_train (0.31)
person -> sweatshirt (0.24)
person -> abaya (0.50)
person -> loudspeaker (0.49)
person -> frilled_lizard (0.24)処理の組み立て方は適切です。クロップはorig_imgからフル解像度で、検出器が使うピクセル座標のまま取得され、分類器にはすべてをまとめてバッチ処理で渡します。意図的に、ラベルには意味のないものを使っています。
ImageNet分類器は、道路上の人物をタイトに部分切り出しした画像で学習されたことがないため、推測します。確信度が0.50を超えていない点に注目してください。きれいな製品写真で学習した分類器に、ぼやけた検出器の切り出し画像を入力した場合も同じことが起こります。
第2ステージのデータセットを独自のクロップから作成する#
データを適合させる確実な方法は、検出器にデータを生成させることです。
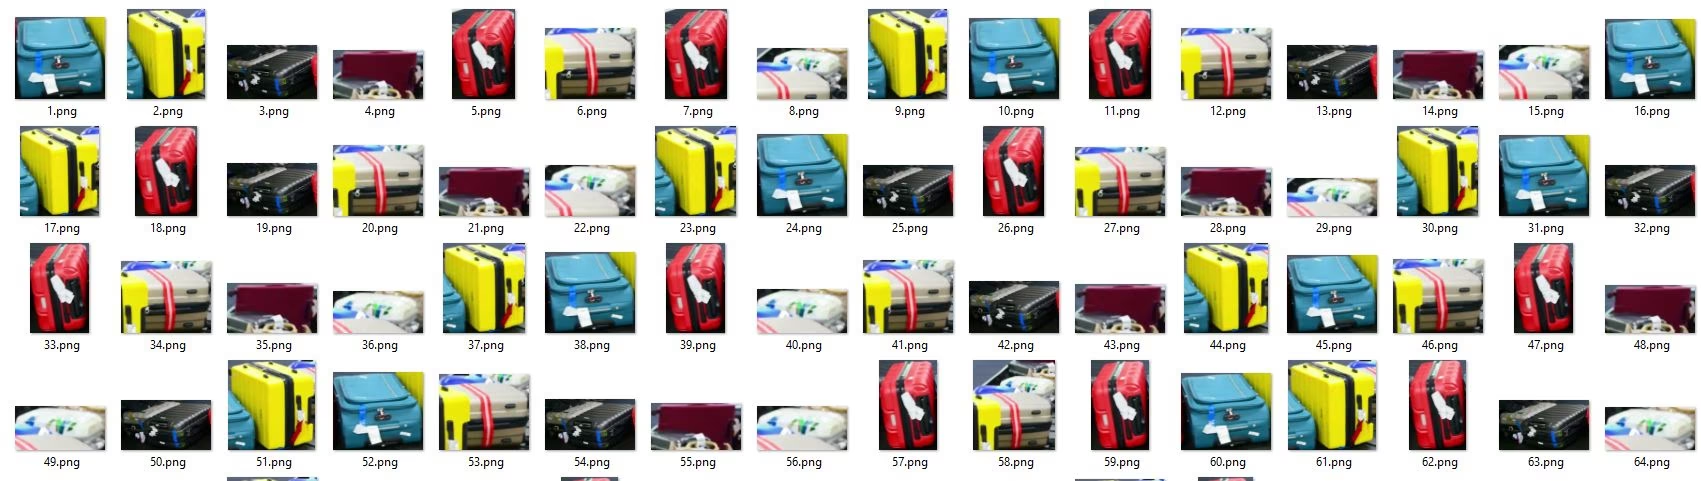
save_crop=Trueを使って代表的な映像で検出器を実行します。たとえばyolo predict model=best.pt source=footage/ save_crop=Trueを指定します。クロップはruns/detect/predict/crops/<class>/に保存されます。- 各クラスのクロップを、細分類用のフォルダ(
helmet_ok/、helmet_missing/)に振り分けます。これは前のレッスンで扱った分類用のフォルダ構成と同じです。 - これらのフォルダで分類器を学習し、別の日または別のカメラで取得したクロップを使って検証します。
検出器がクロップを切り出すため、実際のフレーミング、ブラー、オクルージョンが反映されます。これは本番環境で分類器が見るものとまったく同じです。そのクロップを使ったファインチューニングは、通常の転移学習です。
トラックIDごとに1回だけ分類する#
ヘルメットはフレーム間で変化しないため、すべてのフレームですべてのボックスを分類するのは無駄です。検出結果をトラッキングし、新しいトラックIDごとに1回だけ分類します。
from ultralytics import YOLO

detector = YOLO("yolo26n.pt")
classifier = YOLO("yolo26n-cls.pt")  # swap in your own fine-tuned classifier
source = "https://github.com/ultralytics/assets/releases/download/v0.0.0/decelera_portrait_min.mov"

labels = {}  # track id -> (label, confidence), filled once per person
frames = boxes_seen = 0
for result in detector.track(source, classes=[0], stream=True, persist=True, verbose=False):  # people only
    frames += 1
    if result.boxes.id is None:
        continue
    for track_id, (x1, y1, x2, y2) in zip(result.boxes.id.int().tolist(), result.boxes.xyxy.int().tolist()):
        boxes_seen += 1
        if track_id not in labels:  # first sighting: classify once, then reuse
            probs = classifier(result.orig_img[y1:y2, x1:x2], verbose=False)[0].probs
            labels[track_id] = (classifier.names[probs.top1], round(float(probs.top1conf), 2))

print(f"{frames} frames, {boxes_seen} person boxes, {len(labels)} classifier calls")
print(labels)
11 frames, 33 person boxes, 3 classifier calls
{1: ('basketball', 0.51), 2: ('maillot_(tights)', 0.14), 3: ('bulletproof_vest', 0.23)}11フレームのクリップで、分類器の呼び出しを33回から3回に減らせます。長いストリームでは、人物が映り続けるフレーム数に応じて削減効果が大きくなります。ラベルはまだImageNetによる推測ですが、ファインチューニングした分類器に置き換えれば、人物ごとの判定結果になります。
物体が画面内にある間は属性が変化しない場合(ヘルメットの種類、車両メーカー、製品SKUなど)、トラックごとに1回だけ分類します。変化する場合(ドアの開閉、手を上げる動作など)は、Nフレームごとに再分類します。最初に検出されたときの画像が小さくぼやけていることが多い場合は、トラックのボックスが最も大きいフレームで分類します。
ポーズとトラッキング#
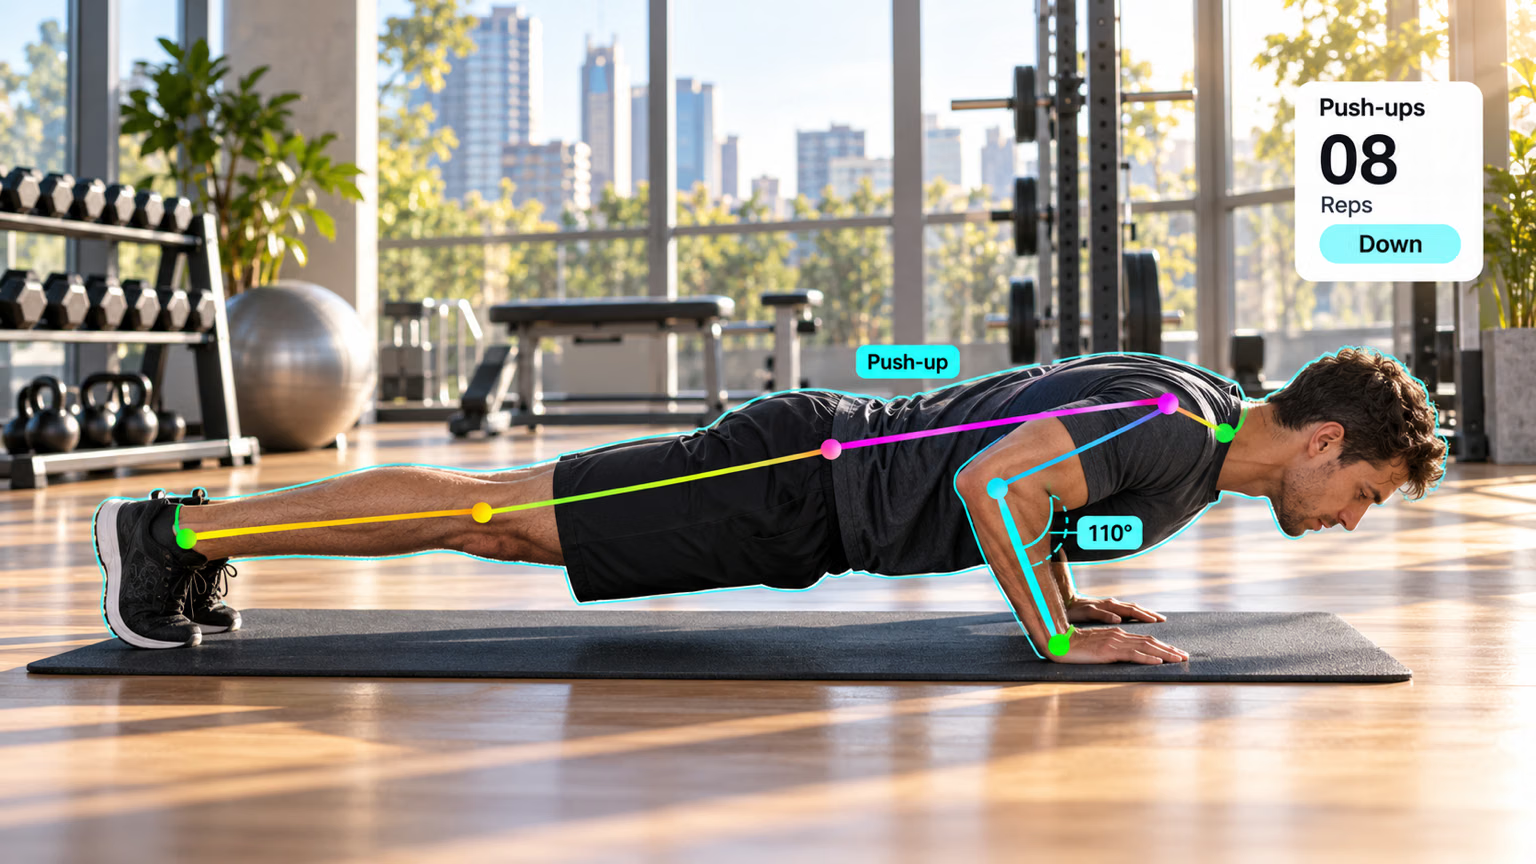
トラックモードでは、人物ごとに永続的なresult.boxes.idが追加されるため、キーポイントを時系列データとして扱えます。このスクリプトは、同じ短い動画で各人物の左膝の角度を記録します。
from collections import defaultdict

import numpy as np

from ultralytics import YOLO

def angle(a, b, c):
    """Angle at b, in degrees, formed by points a-b-c."""
    ba, bc = a - b, c - b
    return np.degrees(np.arccos(np.dot(ba, bc) / (np.linalg.norm(ba) * np.linalg.norm(bc))))

model = YOLO("yolo26n-pose.pt")
source = "https://github.com/ultralytics/assets/releases/download/v0.0.0/decelera_portrait_min.mov"
HIP, KNEE, ANKLE = 11, 13, 15  # left leg, COCO keypoint order
knee_angles = defaultdict(list)  # track id -> knee angle per frame

for result in model.track(source, stream=True, persist=True, verbose=False):
    if result.boxes.id is None:  # no confirmed tracks in this frame
        continue
    kpts = result.keypoints.cpu().numpy()
    for track_id, xy, conf in zip(result.boxes.id.int().tolist(), kpts.xy, kpts.conf):
        if conf[[HIP, KNEE, ANKLE]].min() > 0.5:  # skip occluded legs
            knee_angles[track_id].append(angle(xy[HIP], xy[KNEE], xy[ANKLE]))

for track_id, angles in sorted(knee_angles.items()):
    print(f"id {track_id}: {len(angles)} frames, left knee {min(angles):.0f}-{max(angles):.0f} deg")
id 1: 11 frames, left knee 170-176 deg
id 2: 11 frames, left knee 96-118 deg
id 3: 11 frames, left knee 177-180 degID 2の膝が曲がっている様子は、クリップ内で座っている人物と一致します。残りの2人は脚を伸ばして立っており、角度は約180°です。ここから、各IDの時系列データでしきい値を超えた回数を数えられます。1つの角度を下回ってから別の角度を上回るまでを1回とします。これはワークアウト監視ソリューションが提供する機能です。
パイプラインのコストを見積もる#
| コスト要因 | 検出してから分類 | ポーズとトラッキング |
|---|---|---|
| 増加要因 | フレームあたりの物体数 | フレーム数 |
| 主な調整項目 | バッチ単位でクロップし、トラックIDごとに一度だけ分類してキャッシュします | 動きが遅い場合は、imgsz または vid_stride を低くします |
| 失敗モード | 分類器に、学習データとは異なるクロップが入力されます | IDの切り替わりにより、1人の履歴が2つに分かれます |
症状: 反復回数カウンターがセットの途中でリセットされたり、1人の人物に2つのIDが割り当てられたりします。 原因: トラッカーが人物を見失い(オクルージョンや急な方向転換など)、新しいIDを割り当てました。 対処: 本番向けコースの説明に従ってトラッカーを調整し、IDごとのロジックが短い途切れを許容するようにします。キャッシュされた分類ラベルは新しいIDに対して再計算されるだけです。
解答を表示
検出器の呼び出しに save_crop=True を追加します。
result = detector("https://ultralytics.com/images/bus.jpg", conf=0.5, save_crop=True)[0]クロップは runs/detect/predict*/crops/person/ と crops/bus/ に表示されます(予測を実行するたびに実行フォルダー名が増えます)。トラックごとのキャッシュにより、人物ボックス33件に対する分類器の呼び出しは3回となり、11フレームの動画で30回削減されました。
膝の角度のカウントを得るには、pose_track.py の最後のループを置き換えます。
for track_id, angles in sorted(knee_angles.items()):
    bent = sum(a < 120 for a in angles)
    print(f"id {track_id}: {len(angles)} frames, {bent} with knee below 120 deg")
id 1: 11 frames, 0 with knee below 120 deg
id 2: 11 frames, 11 with knee below 120 deg
id 3: 11 frames, 0 with knee below 120 deg座っている人物のID 2は、11フレームすべてで120°未満です。ID 1と3は一度も120°未満になりません。