タスクを選び、パイプラインを計画する
各プロダクトの課題を、重み、結果フィールド、ラベル形式、ゲート指標とともに、7つのUltralytics YOLOタスクのいずれかに対応付け、各タスクを1枚の画像で実行して計画を検証します。
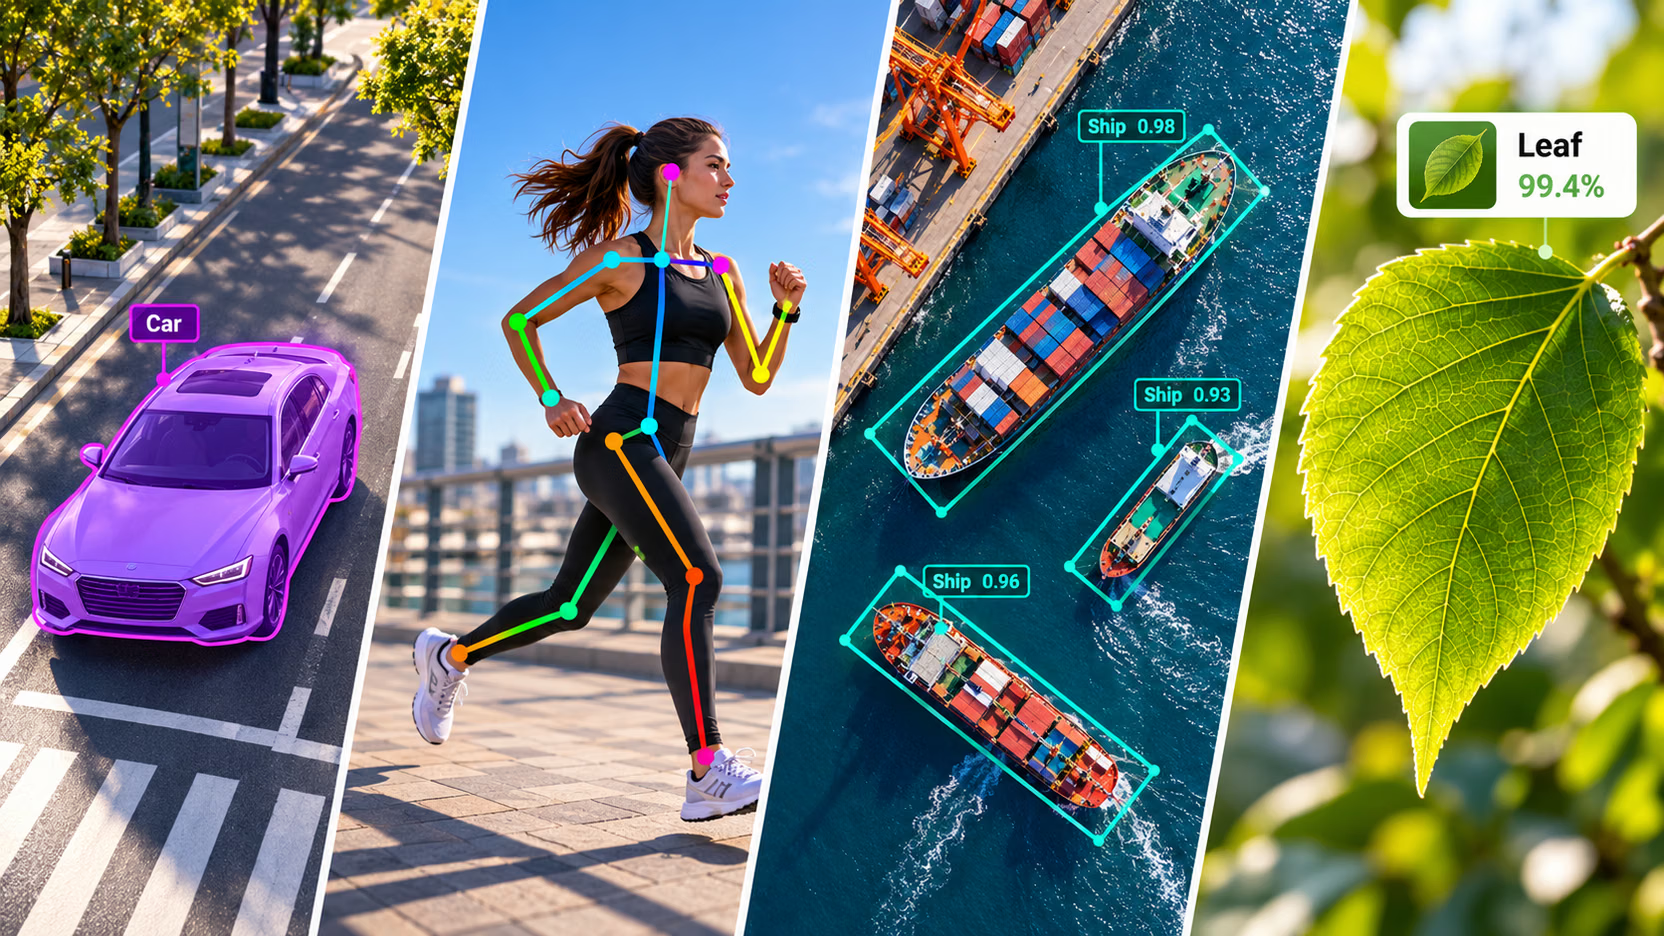
検出モデルをリリースした後に寄せられる要望は、「ボックスをもっと増やして」ではないことがほとんどです。「こぼれた液体の面積はどれくらいか」「作業員の背中は曲がっているか」「船はどちらを向いているか」「この部品は不良品か」といった要望です。このコース全体で使う道路の写真では、バスのバウンディングボックスがフレームの48%を占める一方、バス自体は29%を占めています。そのため、ボックスを使って面積を求めると、半分以上も誤った値になります。選択するタスクによってラベル形式が決まるため、誰かがラベル付けを始める前にタスクを決めることが、プロジェクトで最も低コストな判断です。後から変更すると、再ラベル付けが必要になります。
実践的
1枚の写真から得られる4通りの答え#

1枚の写真について「このフレームのうち、バスが占める割合はどれくらいで、どのくらい離れているか」と質問し、4つのUltralytics YOLOタスクに答えさせます。
from ultralytics import YOLO

image = "https://ultralytics.com/images/bus.jpg"
det = YOLO("yolo26n.pt")(image, verbose=False)[0]
seg = YOLO("yolo26n-seg.pt")(image, retina_masks=True, verbose=False)[0]
sem = YOLO("yolo26n-sem.pt")(image, verbose=False)[0]
depth = YOLO("yolo26n-depth.pt")(image, verbose=False)[0]
frame = det.orig_shape[0] * det.orig_shape[1]  # pixels in the photo

i = [det.names[int(c)] for c in det.boxes.cls].index("bus")
x1, y1, x2, y2 = det.boxes.xyxy[i].tolist()
print(f"detect    bus box covers   {(x2 - x1) * (y2 - y1) / frame:.1%} of the frame")

i = [seg.names[int(c)] for c in seg.boxes.cls].index("bus")
bus_mask = seg.masks.data[i].bool()  # H x W, True on bus pixels
print(f"segment   bus mask covers  {bus_mask.sum().item() / frame:.1%} of the frame")

ratios = {row["name"]: row["pixel_ratio"] for row in sem.summary()}
print(f"semantic  'train' pixels   {ratios['train']:.1%} of the frame")

meters = depth.depth.data[bus_mask].median().item()  # depth map and mask share the original size
print(f"depth     bus is about     {meters:.1f} m from the camera")
detect bus box covers 47.7% of the frame
segment bus mask covers 29.2% of the frame
semantic 'train' pixels 30.9% of the frame
depth bus is about 4.5 m from the camera行ごとに確認します。
- detectはどこにあるかに答えます。ボックスにはバスの下の道路と、バスの前に立つ4人も含まれるため、面積としては63%大きすぎます。
- segmentはどんな形かに答えます。29.2%が画像内におけるバスの実際の占有面積で、面積、カバー率、重なりのルールに使用する値です。
- semanticはどのピクセルがどのクラスに属するかに答えます。面積はマスクの値に近いものの、モデルはバスを
trainと判定します。トレーニングセット(Cityscapes、第4レッスン)のクラスに基づいて領域を分類するため、個々の車両を区別することはありません。 - depthはどのくらい離れているかに答えます。バスのマスク内の深度の中央値は4.5 mです。単独ではどちらも答えられない質問に、2つのタスクを組み合わせて答えています。
製品が報告する数値が面積、占有率、または重なり率なら、ボックスは適切な手段ではありません。オブジェクトにはマスク(インスタンスセグメンテーション)、表面にはクラスマップ(セマンティックセグメンテーション)を使ってください。
7つのタスクの概要#
コンピュータービジョンの基礎では、タスクの選び方を詳しく解説しています。選択に迷った場合は、7つのビジョンタスクを振り返ってください。ここでは、コースの残りの部分で使う実践的な要点をまとめます。各行は、インストール済みのultralyticsパッケージが、同じAPIでトレーニング、検証、予測、エクスポートできるタスクです。詳しいリファレンスはタスクの概要を参照してください。
| 出力が答える質問 | タスク | YOLO26の重み | 結果フィールド | ラベル形式 | ゲート指標 |
|---|---|---|---|---|---|
| 各オブジェクトはどこにありますか? | detect | yolo26n.pt | boxes | クラス + ボックス | ボックスmAP50-95 |
| 各オブジェクトの正確な形状と面積はどれくらいですか? | segment | yolo26n-seg.pt | masks + boxes | クラス + ポリゴン | マスクmAP50-95 |
| 各ピクセルはどのクラスに属しますか? | semantic | yolo26n-sem.pt | semantic_mask | PNGクラスマップまたはポリゴン | mIoU |
| 関節またはランドマークはどこにありますか? | pose | yolo26n-pose.pt | keypoints + boxes | クラス + ボックス + キーポイント | ポーズmAP50-95(OKS) |
| 各オブジェクトはどのように回転していますか? | obb | yolo26n-obb.pt | obb | クラス + 4つの角 | OBB mAP50-95 |
| 画像全体(または切り抜き)は何ですか? | classify | yolo26n-cls.pt | probs | クラスごとに1つのフォルダー | top-1精度 |
| 各ピクセルはカメラからどのくらい離れていますか? | depth | yolo26n-depth.pt | depth | 画像ごとの深度マップ(16ビットPNGまたはNPY) | δ1(delta1) |
最初の行のタスクはすでにリリース済みです。レッスン2~8では中央の5行を学び、レッスン9と10ではそれらを連結してリリースします。最後の行である単眼深度推定は、1枚の画像のすべてのピクセルについて距離をメートル単位で予測します。ラベルはアノテーターではなく深度センサーや3Dレンダラーから得るため、独自のデータセット形式があります。このコースでは、ワークフローを共有する部分、つまりこの計画、検証ループ、最終レッスンのエクスポート確認に含めています。
一度に1つの質問を選ぶ#
質問を順番に確認し、最初に「はい」となるところで止めます。
このチャートは一般的なケースを網羅しています。その他の多くのケースは、次の4つの判断基準で絞り込めます。
| 要望が次のような場合… | 選択するタスク | 理由 |
|---|---|---|
| 個数と面積の両方が必要(「こぼれは何件あり、それぞれどのくらいの大きさか」) | segment | semanticでは、接触しているオブジェクトが1つの領域に統合されます |
| 上から見た、細長いオブジェクトが並んで密集している状況を扱う | obb | 軸に沿ったボックスが重なり、角度を使わない場合でもNMSによって実際のオブジェクトが削除されます |
| 前後または左右の判別が必要 | pose | OBBが示すのは軸であり、方位ではありません |
| 構成上、画像ごとに対象が必ず1つだけ(固定式の検査ステーションなど) | classify | ラベル付けのコストが最も低く、モデルも最速 |
データセットを作成するとタスクが固定されます。Ultralytics Platformでは、新しいデータセットのダイアログにあるTask Typeフィールドで指定するため、最初のラベル付けより前にこの選択を行います。

1つのAPI、7つの結果フィールド#
すべてのタスクで同じ呼び出しを使います。モデルは重みファイルからタスクを読み取ります。変わるのは結果のどのフィールドに値が入るかで、コードが読み取るのはそのフィールドです。
from ultralytics import YOLO

WEIGHTS = ["yolo26n.pt", "yolo26n-seg.pt", "yolo26n-sem.pt", "yolo26n-pose.pt", "yolo26n-obb.pt", "yolo26n-cls.pt", "yolo26n-depth.pt"]
FIELDS = ("boxes", "masks", "semantic_mask", "keypoints", "obb", "probs", "depth")

for weights in WEIGHTS:
    model = YOLO(weights)
    result = model("https://ultralytics.com/images/bus.jpg", verbose=False)[0]
    fields = [f for f in FIELDS if getattr(result, f) is not None]
    print(f"{weights:17s} task={model.task:9s} fields={fields}")
yolo26n.pt task=detect fields=['boxes']
yolo26n-seg.pt task=segment fields=['boxes', 'masks']
yolo26n-sem.pt task=semantic fields=['semantic_mask']
yolo26n-pose.pt task=pose fields=['boxes', 'keypoints']
yolo26n-obb.pt task=obb fields=['obb']
yolo26n-cls.pt task=classify fields=['probs']
yolo26n-depth.pt task=depth fields=['depth']セグメンテーションとポーズの結果にはboxesが含まれるため、既存の検出コードをそのまま使えます。分類、セマンティック、深度の結果は画像全体を表し、オブジェクト単位のフィールドはありません。
result.boxes をループする検出コードは、OBBモデルで TypeError: 'NoneType' object is not iterable が発生して停止します。result.boxes は None であり、回転した検出結果は result.obb にのみ格納されます。None の有無を確認して検出数がゼロになるのではなく、result.obb を読み取るように検出コードをOBB対応にしてください。
1つのモデルでは足りない場合#
検出を超えるほとんどの本番システムは、次の3つの構成のいずれかをとります。
- 検出してから分類する。検出モデルが大きなフレーム内の小さなオブジェクトを見つけ、画像分類モデルが各オブジェクトの高解像度の切り抜きを細かく判定します。例:ヘルメットの種類、欠陥グレード、製品SKU。
- ポーズとトラッキングを組み合わせる。キーポイントは1フレームを表し、トラッカーはキーポイントを人物ごとの時系列に変換します。時系列から反復回数を数えたり、転倒を検出したりできます。
- セグメンテーションしてから測定する。モデルがピクセルを返し、通常のコードで面積、幅、カバー率、または深度を使った距離を算出します。
セグメンテーションしてから測定するパイプラインのラベルは、次のUltralytics Platformエディターにある倉庫ロボット上の荷物のように、オブジェクトごとに1つのポリゴンです。
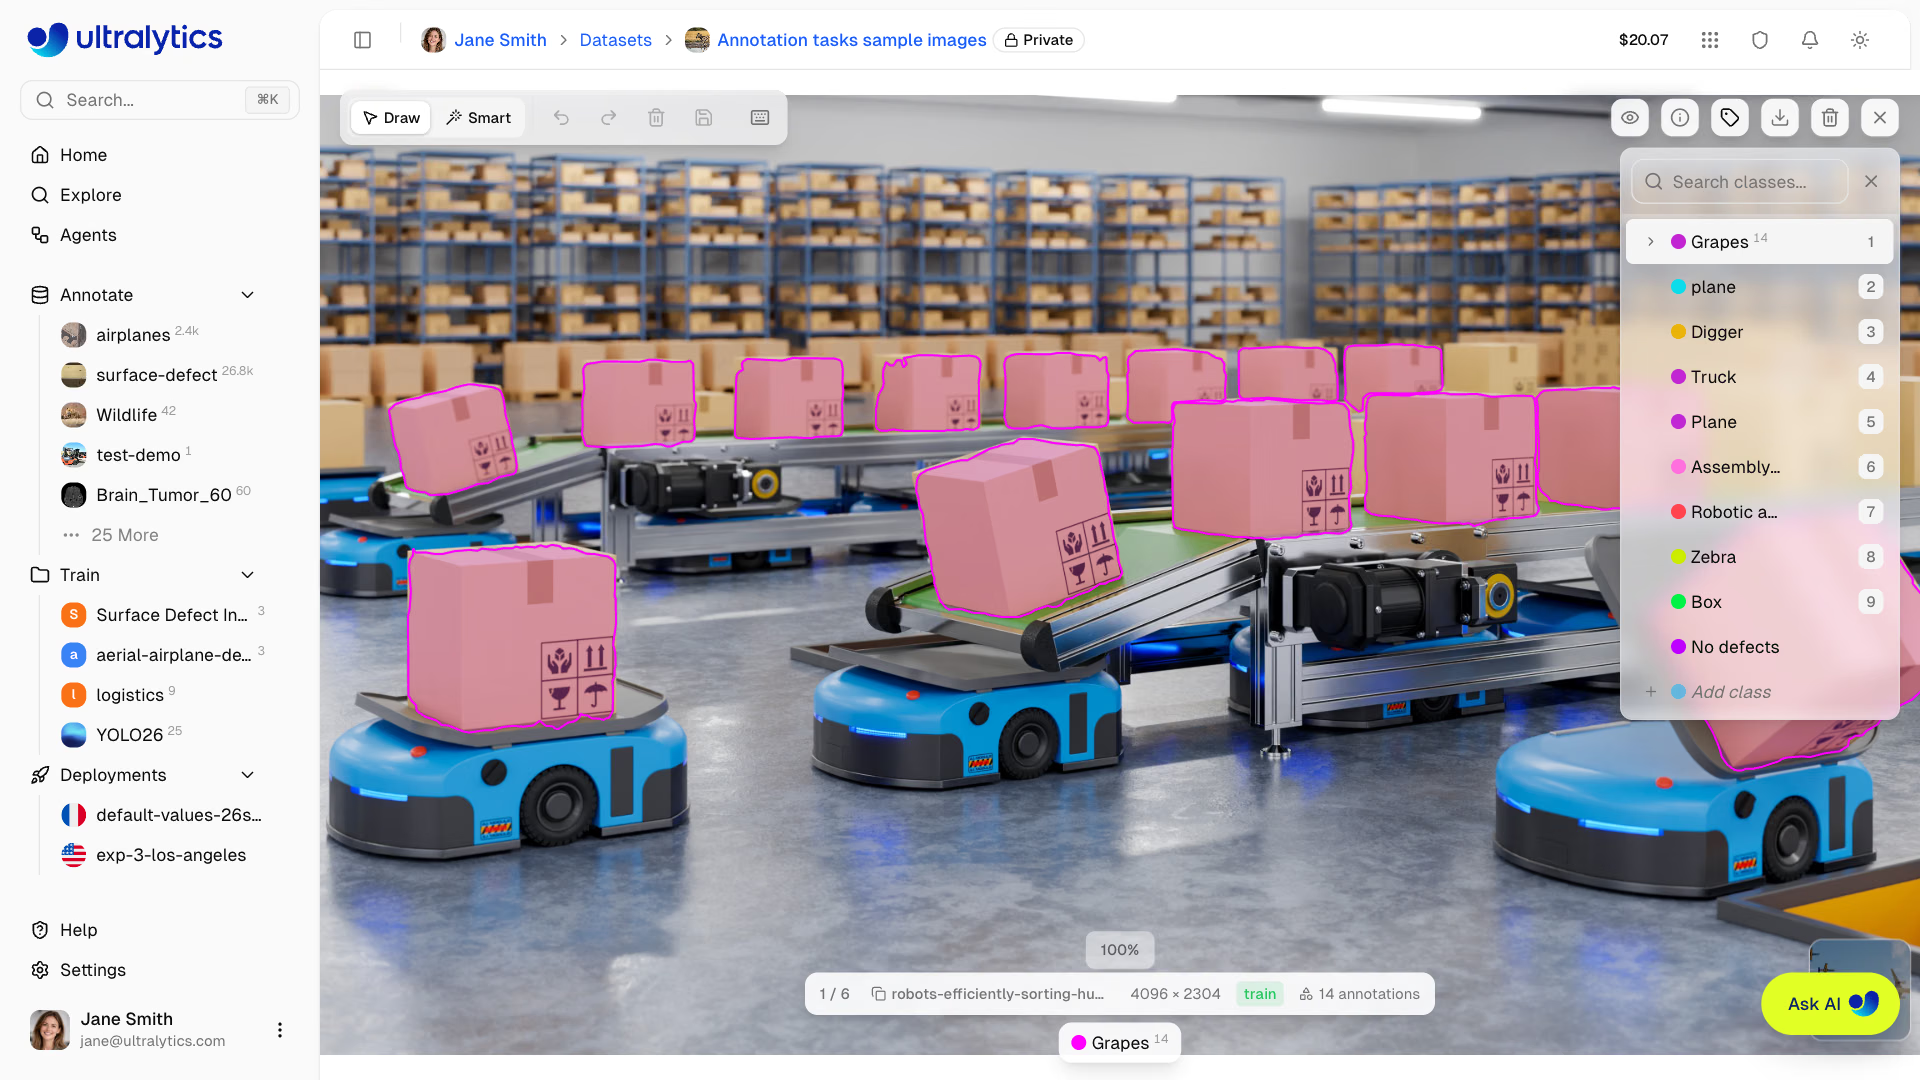
2つ目のモデルを追加すると、推論レイテンシー、ラベル付けと保守が必要な2つ目のデータセット、監視する2つ目のモデルが増えます。1つのタスクでは質問に答えられない場合に限ってモデルを連結してください。ラベル付けできない3モデルの計画より、デプロイできる1モデルの計画が優れています。
よくある落とし穴#
症状: マスクのデモ映えを理由にチームがポリゴンのラベルを付けたものの、製品で使うのはカウントだけです。対処: ラベル付けの前に、出力を処理するコードの行を特定してください。輪郭を読む処理がないなら、検出モデルをデプロイしてください。ボックスはラベル付けも実行も高速です。
症状: 1か月のラベル付け後に、製品には方向が必要だと判明しましたが、データセットのラベルは軸しか示さないOBB形式です。対処: 計画に必要な属性を正確に記載し(result.masks.xy、result.keypoints.xy、result.obb.xywhr)、最初のラベルを付ける前に、選択した重みで tasks.py を実行してください。
症状: きれいな製品写真では95%のスコアを出す分類モデルが、本番環境の検出器による切り抜き画像の大半で誤判定します。対処: 実際のぼけやフレーミングを含め、1段目のモデル自身が切り抜いた画像から2段目のデータセットを作成してください。方法はレッスン9で説明しています。
解答を表示
パレットのリクエストの場合:
| 項目 | 選択 |
|---|---|
| 質問 | パレットの一部でもラックの梁のラインからはみ出していますか? |
| タスク | segment — はみ出しの判定にはパレットの輪郭が必要です。ボックスにはパレットの下の隙間と上に積まれた荷物も含まれます |
| 重み | 倉庫カメラの映像でファインチューニングしたyolo26n-seg.pt |
| ラベル形式 | パレットごとに1つのポリゴン |
| 結果フィールド | result.masks.dataとretina_masks=True(梁のラインを越えたピクセル) |
| ゲート指標 | トレーニングから除外したカメラのマスクmAP50-95 |
| 第2段階 | なし — ビームラインはカメラごとに固定されるため、モデルではなく設定です |
オーバーハングの判定ルールは、3行のコードで実装できます。カメラごとにビームラインを一度描画し、ラインの反対側にあるマスクのピクセル数を数え、既知のオーバーハングをいくつか使って調整したピクセルしきい値を超えたらアラートを出します。レッスン3では、まさにこのようなマスクと領域の比較テストを紹介します。