セマンティックセグメンテーション:すべてのピクセルにラベルを付ける
yolo26n-sem.pt でピクセル単位のクラスマップを予測し、カバー率の数値に変換してPNGクラスマップのデータセットを構築し、ピクセル精度に惑わされずにmIoUを読み取ります。
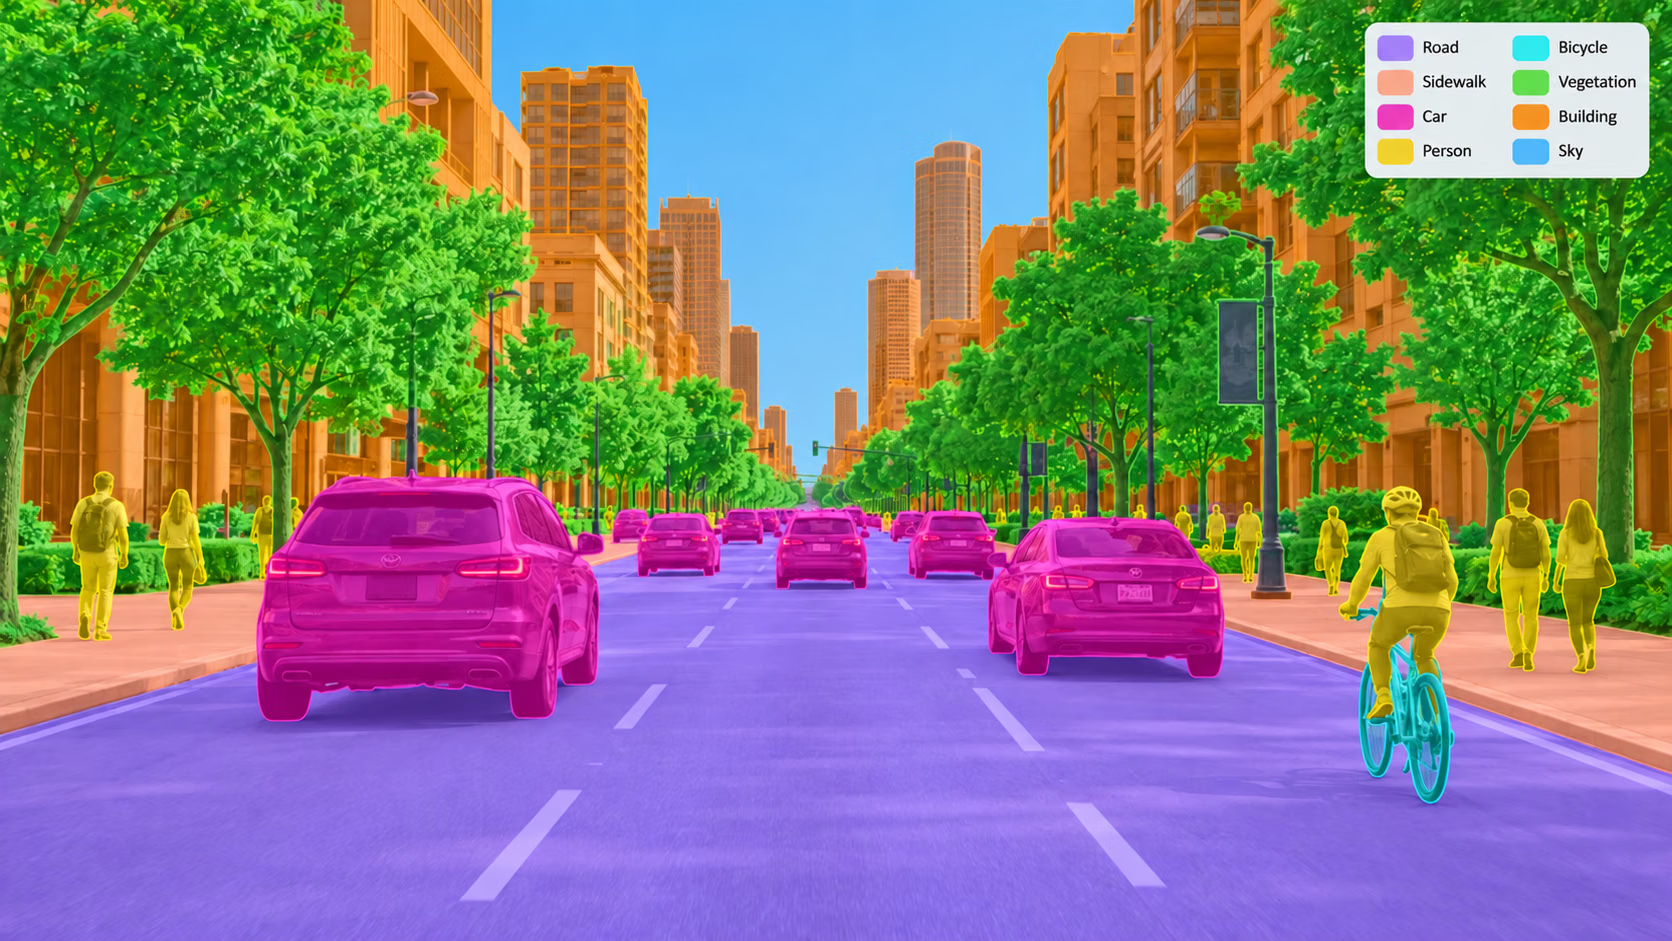
数える対象となるオブジェクトがない質問もあります。歩道のどのくらいが塞がれているか、畑のどのくらいが雑草か、走行可能な道路がどこで終わるか、といった質問です。セマンティックセグメンテーションは、ピクセルごとに1つのクラスIDを割り当ててこれらに答えます。ただし、主要な指標は誤解しやすいものです。このレッスンで学習するモデルは、人物を1人も検出できないにもかかわらず、ピクセル精度が91%になります。
実践的
インスタンスですか、それともセマンティックですか?#
インスタンスセグメンテーション(segment) | セマンティックセグメンテーション(semantic) | |
|---|---|---|
| 出力 | オブジェクトごとに1つのマスクとバウンディングボックス | ピクセルごとに1つのクラスID |
| オブジェクトをカウントする | はい | いいえ — 接触している2台の車は1つの「車」領域です |
| 「もの」(道路、空、草)を扱う | 不得意 — 自然なインスタンスがありません | はい |
| ラベル | ポリゴン | PNGクラスマップ、またはポリゴン |
| ゲート指標 | マスクmAP50-95 | mIoU |
| 事前学習済み重み | yolo26n-seg.pt(COCO、80クラス) | yolo26n-sem.pt(Cityscapes、19クラス) |
下流の質問に「いくつ」が含まれる場合は、インスタンスセグメンテーションを使ってください。「どれくらい」や「どこ」が問われる場合は、セマンティックセグメンテーションのほうがラベル付けも読み取りも簡単です。セマンティックセグメンテーションのタスクページにモデル一覧があります。
クラスマップを予測する#
result.semantic_mask.data は元の画像サイズの H × W テンソルです。各値はクラスIDで、255は無視を意味します。result.summary() を使うと、クラスごとのピクセル比率を算出できます。
from ultralytics import YOLO

model = YOLO("yolo26n-sem.pt")  # Cityscapes, 19 classes
result = model("https://ultralytics.com/images/bus.jpg")[0]

class_map = result.semantic_mask.data  # H x W tensor of class ids, 255 = ignore
print("class map:", tuple(class_map.shape), class_map.dtype)
for row in result.summary():
    if row["pixel_ratio"] >= 0.02:
        print(f"{row['name']:12s} {row['pixel_ratio']:.1%}")
class map: (1080, 810) torch.uint8
road 27.5%
sidewalk 2.0%
building 19.3%
vegetation 4.5%
person 14.6%
train 30.9%最後の行を確認してください。Cityscapesには bus クラスがありますが、モデルはバスを train と判定します。主にドイツの道路を車載カメラで撮影した映像から学習しているため、歩道から近距離で撮影されたバスはその分布の範囲外です。セマンティックモデルは、検出モデルよりも学習データの撮影視点やクラス定義、つまりデータセットバイアスを強く引き継ぎます。そのため、マップを信頼する前に、自分のカメラでファインチューニングしてください。
クラスマップから答えを導き出す#
クラスマップは、単純なテンソル比較で製品上の数値に変換できます。ここでは、「歩行者が進む領域のうち、道路または歩道が占める割合と、人が占める割合はどれくらいか」を求めます。
from ultralytics import YOLO

result = YOLO("yolo26n-sem.pt")("https://ultralytics.com/images/bus.jpg", verbose=False)[0]
class_map = result.semantic_mask.data  # H x W class ids at the original size, 255 = ignore
ids = {name: i for i, name in result.names.items()}

h = class_map.shape[0]
lower = class_map[h // 2 :]  # the half of the frame a pedestrian would walk into
walkable = (lower == ids["road"]) | (lower == ids["sidewalk"])
people = lower == ids["person"]
print(f"lower half: {walkable.float().mean():.0%} road or sidewalk, {people.float().mean():.0%} person")
result.save("semantic_overlay.jpg")  # colored class map over the photo, for a visual check
lower half: 59% road or sidewalk, 23% personこれらの数値を信頼できるものにするには、次の3つの習慣が重要です。
- IDは名前から検索します。
result.namesから検索し、番号をハードコードしないでください。独自のクラスで学習したモデルでは、クラス番号が異なります。 - 重要な領域に限定します。 フレーム全体の比率には空や建物も含まれます。最初にクラスマップをスライスするか、領域マスクを乗算します。
- オーバーレイを開きます。
semantic_overlay.jpgを見れば、数値の算出に使われた「道路」が本当に道路かどうかをすぐに確認できます。
データセット形式#
セマンティックデータセットでは、各画像に、ピクセル値がクラスIDであるシングルチャンネルのマスク画像を組み合わせます。セマンティックデータセットガイドがリファレンスです。ディレクトリ構成は images/ をファイル単位で反映しています。
cityscapes8/
├── images/
│   ├── train/aachen_000000_000019.png
│   └── val/aachen_000004_000019.png
└── masks/
    ├── train/aachen_000000_000019.png
    └── val/aachen_000004_000019.png
YAMLには masks_dir が追加されます。また、マスクに格納されたIDが学習時のIDと異なる場合は、label_mapping ブロックも追加されます。
path: cityscapes8
train: images/train
val: images/val
masks_dir: masks # semantic mask directory

names:
  0: road
  1: sidewalk
  # ... 19 classes in total

label_mapping: # raw mask value -> training id
  0: ignore_label
  7: 0 # road
  8: 1 # sidewalk
  # ...
Cityscapesのマスクには、-1から33までの生のラベルIDが格納されています。マッピングではそのうち19個を維持し、残りは ignore_label に割り当てられ、255として保存されます。255に設定されたピクセルは、損失と指標の両方から除外されます。アノテーターが判断できなかった領域にも、同じ値を使用してください。
すでにポリゴンラベルがあり、masks_dir がない場合、ローダーがポリゴンをラスタライズし、未カバーのピクセルに background クラスを追加します。
非可逆圧縮では隣接するピクセル値が混ざり、クラス7とクラス8の境界が、7、8、および存在しないIDの混ざった状態になります。マスクはすべてPNGまたはTIFFで保存してください。
学習してmIoUを読み取る#
Cityscapes8には都市シーンの画像が8枚あり、学習用が4枚、検証用が4枚です。CPUでのスモークテストには十分です。
from ultralytics import YOLO

model = YOLO("yolo26n-sem.pt")
model.train(data="cityscapes8.yaml", epochs=1, imgsz=320, device="cpu")
metrics = model.val()
print(f"mIoU: {metrics.miou:.3f}  pixel accuracy: {metrics.pixel_accuracy:.3f}")
Class Images Pixels mIoU PixAcc
all 4 192315 0.415 0.906
road 4 78529 0.974 0.996
vegetation 4 37602 0.844 0.936
person 3 722 0 0
rider 1 21 0 0
mIoU: 0.415 pixel accuracy: 0.906(クラスごとの行は省略しています。)ピクセル精度は91%ですが、mIoUは42%です。クラスごとの行を見ると、モデルは人物を1人も検出していません。これらはすべて正しい結果です。道路、建物、植生がピクセルの大部分を占めています。道路だけでも192,315ピクセル中78,529ピクセルです。そのため、これらのクラスをうまく塗り分けるモデルは、小さなクラスをすべて見逃しても高いピクセル精度を得られます。mIoUはクラスごとのIoUを等しい重みで平均するため、クラスを見逃すたびに値が下がります。

mIoU と、製品が処理に使うクラスのIoUを基準にしてください。人物IoUが0の歩行者安全機能は、ピクセル精度がどのような値でも不合格です。
解答を表示
今回の実行では、mIoUは0.415、ピクセル精度は0.906でした。wall、person、rider、motorcycle、bicycleのIoUは0で、4枚の検証画像にピクセルが存在しないクラスもすべてIoUが0でした。
ピクセル精度が高いのは、ピクセル数を基準に数えるためです。Cityscapesの各フレームの大部分は、道路、建物、植生、空で占められています。mIoUは各クラスを等しい重みで評価するため、見逃した5つの小さなクラスは、数百ピクセルしか占めていなくても平均値を下げます。人物を対象に動作する製品では、personのIoUだけでこのモデルは判定基準を満たしません。