すべてのタスクを評価してデプロイする
デプロイ時の画像サイズで、各タスク固有の指標を合否判定に使います。1つのループですべてのタスクを検証し、予測結果を確認したうえで、すべてのタスクをONNXにエクスポートします。
正解の定義はタスクごとに異なります。ピクセルの重なり、キーポイントの類似度、回転ボックスのIoU、top-1の正解、深度比率などです。検出用のチェックリストを使い回すチームは、ボックスのmAPを基準にセグメンテーションモデルを判定したり、製品の対象ではないボックスを基準に姿勢推定モデルを判定したりして、リリースしてしまいます。また、合格基準を満たしたモデルでも、エクスポート後に問題が起きることがあります。このレッスンでは、同じ姿勢推定の重みでも入力サイズによって検出人数が5人から3人に変わり、深度モデルの距離はほぼ2倍になります。
実践的
タスクごとに1つの合否基準#
| タスク | 判定基準 | results_dict のキー | Python属性 | 評価指標 |
|---|---|---|---|---|
| セグメンテーション | マスクmAP50-95 | metrics/mAP50-95(M) | metrics.seg.map | インスタンスごとのピクセルIoU |
| セマンティックセグメンテーション | mIoU(クラスごとのIoUを含む) | metrics/mIoU | metrics.miou | クラスごとのピクセルIoU |
| 姿勢推定 | pose mAP50-95 | metrics/mAP50-95(P) | metrics.pose.map | OKS |
| OBB | OBB mAP50-95 | metrics/mAP50-95(B) | metrics.box.map | 回転ボックスのIoU |
| 分類 | top-1精度 | metrics/accuracy_top1 | metrics.top1 | top-1クラスの正解 |
| 深度推定 | δ1(AbsRelを含む) | metrics/delta1 | metrics.delta1 | 真の深度の1.25倍以内に収まるピクセルの割合 |
パフォーマンス指標ガイドでは、各スコアについて説明しています。セグメンテーションと姿勢推定の実行では、ボックスの指標も出力されます。ボックスとマスクの差から輪郭の品質を診断できるため、診断用として確認しますが、製品の指標ではありません。しきい値のスイープや混同行列など、検出に特化した読み解き方については、検証と診断の内容を応用できます。
1つのループですべてのタスクを検証する#
Valモードでは、タスクに合ったデータセットと組み合わせて、あらゆるタスクの重みを使用できます。そのため、1つのループでリリース表の数値をまとめて取得できます。
from ultralytics import YOLO

runs = {
    "yolo26n-seg.pt": ("coco8-seg.yaml", "metrics/mAP50-95(M)"),
    "yolo26n-sem.pt": ("cityscapes8.yaml", "metrics/mIoU"),
    "yolo26n-pose.pt": ("coco8-pose.yaml", "metrics/mAP50-95(P)"),
    "yolo26n-obb.pt": ("dota8.yaml", "metrics/mAP50-95(B)"),
    "yolo26n-depth.pt": ("depth8.yaml", "metrics/delta1"),
}
for weights, (data, key) in runs.items():
    metrics = YOLO(weights).val(data=data, device="cpu", plots=False, verbose=False)
    print(f"{weights:17s} {key:22s} {metrics.results_dict[key]:.3f}")
yolo26n-seg.pt metrics/mAP50-95(M) 0.538
yolo26n-sem.pt metrics/mIoU 0.610
yolo26n-pose.pt metrics/mAP50-95(P) 0.419
yolo26n-obb.pt metrics/mAP50-95(B) 0.857
yolo26n-depth.pt metrics/delta1 0.377imgsz を明示的に指定しない場合、各モデルは学習時のサイズで検証されます。セグメンテーションと姿勢推定は640、深度推定は768、セマンティックセグメンテーションとOBBは1024です。これらの事前学習済みモデルの数値は、コース前半で学習した320ピクセルのモデルより高くなっています。これは学習による差と解像度による差の両方が影響しています。検証画像は4枚だけなので、ここでの数値はすべてスモークテストです。たとえば、深度推定タスクのページでは、NYUベンチマーク全体に対するδ1が報告されています。分類は意図的に対象外としています。分類器のレッスンと同様に、ファインチューニングした分類器は専用フォルダーを使って検証してください。
同じ重みでも、異なるimgszではスコアが変わります。すべての数値と合わせてimgszを記録し、デプロイ時に使用するサイズで検証してください。異なるサイズで測定した数値を比較しないでください。
すべてのタスクをエクスポートする#
各タスクは、同じエクスポートモードの呼び出しでONNXにエクスポートできます。タスクはモデルのメタデータに保存されるため、YOLO("model.onnx") が適切な後処理を適用します。実行環境の選択、同等性チェック、TensorRTやOpenVINOのチューニングについては、ONNXにエクスポートして同等性を検証するで説明しています。このループでは、すべてのタスクでエクスポートと再読み込みが問題なく完了することを確認します。
from ultralytics import YOLO

for weights in ["yolo26n-seg.pt", "yolo26n-sem.pt", "yolo26n-pose.pt", "yolo26n-obb.pt", "yolo26n-cls.pt", "yolo26n-depth.pt"]:
    onnx_path = YOLO(weights).export(format="onnx", imgsz=320)
    onnx_model = YOLO(onnx_path)  # task comes from the ONNX metadata
    result = onnx_model("https://ultralytics.com/images/bus.jpg", imgsz=320, verbose=False)[0]
    print(f"{onnx_model.task:9s} {result.verbose()}")
segment 4 persons, 1 bus,
semantic
pose 3 persons,
obb (no detections),
classify minibus 0.38, police_van 0.21, trolleybus 0.05, amphibian 0.05, bullet_train 0.03,
depth depth 4.67-26.91m,すべてのエクスポートを適切なタスクとして再読み込みできました。特に次の3つの結果は、詳しく確認する必要があります。
- 320ピクセルでは姿勢推定モデルが3人を検出しました。640ピクセルのPyTorch実行では5人を検出しました。
- 深度推定モデルはシーンの距離を4.7~26.9 mと判定しました。同じ重みをネイティブサイズの768ピクセルで使った場合は2.1~14.9 mと判定しました。
- OBBモデルは街路の写真で何も検出しませんでした。空撮画像向けモデルとして正しい動作であり、エクスポートの不具合ではありません。
imgsz=320 で実行したPyTorchの姿勢推定と深度推定の数値はONNXと一致しているため、どちらもエクスポートの不具合ではありません。入力サイズによって結果が変わりました。検証した imgsz でエクスポートしてください。セマンティックセグメンテーションにはオブジェクトごとの要約行がないため、代わりに result.semantic_mask を確認します。
エクスポートが壊れていると判断したり、出荷したりする前に、学習時と同様の画像を使って各エクスポート済みモデルで1回推論します。COCOモデルには道路シーン、OBBには航空画像タイル、深度推定には適切なスケールの屋内または道路シーンを使用します。
独自の後処理を実装する場合は、エクスポートログにある imgsz=320 でのONNXの生出力は次のとおりです。
| タスク | ONNXの出力形状 | 内容 |
|---|---|---|
| セグメンテーション | (1, 116, 2100) と (1, 32, 80, 80) | ボックス + 80個のクラススコア + 32個のマスク係数、マスクプロトタイプ |
| セマンティックセグメンテーション | (1, 320, 320) | クラスマップ。argmaxはすでに計算グラフに含まれています |
| 姿勢推定 | (1, 56, 2100) | ボックス + 1個のスコア + 17 × 3個のキーポイント値 |
| OBB | (1, 20, 2100) | ボックス + 15個のクラススコア + 1個の角度 |
| 分類 | (1, 1000) | クラス確率 |
| 深度推定 | (1, 1, 320, 320) | ピクセルごとの深度(メートル単位) |
Ultralytics Platformでは、モデルページにタスク固有の指標(セグメンテーションモデルの場合はマスクmAP)が表示され、その下のエクスポートタブから同じ形式でエクスポートできます。

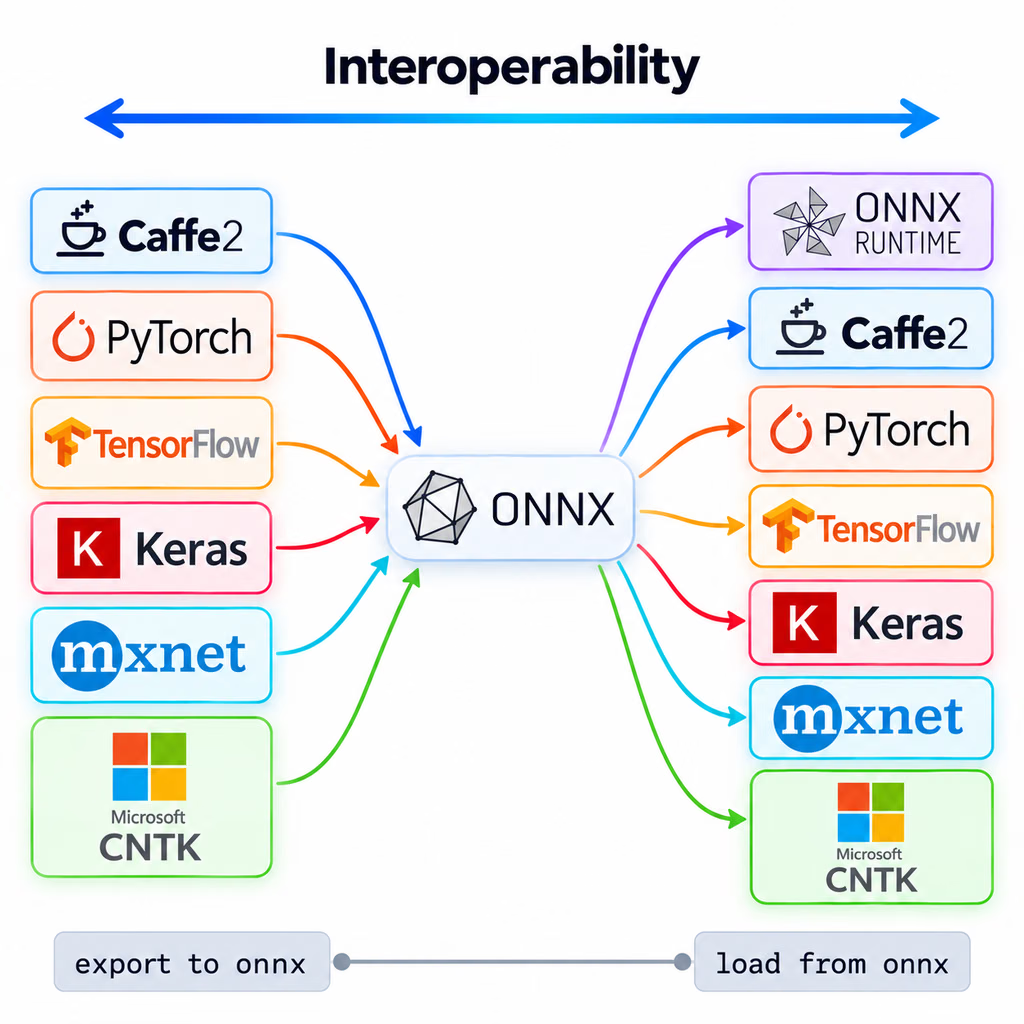
ONNXは中間形式として機能します。エクスポートした1つのファイルをONNX Runtimeで実行したり、ほかのランタイム向けに変換したりできます。
リリースチェックリスト#
- 上の表に記載した合否判定用の指標が、ホールドアウトセットでデプロイ時の
imgszにおいて目標を満たしています。 - エクスポートしたモデルを、想定される
taskとして再読み込みでき、固定した画像セットでPyTorchの予測結果と一致します。 - タスクごとのコードパスが空の結果を処理します。
masks is None、キーポイントが0個、OBBが0個の場合も対象です。 - 可観測性とドリフトで説明しているように、下流の数値(面積、角度、距離、クラス確率)を記録し、変化を監視できるようにします。
合否基準を満たさない場合、「データに戻る」とは通常、次の3つの調整手段のいずれかを指します。
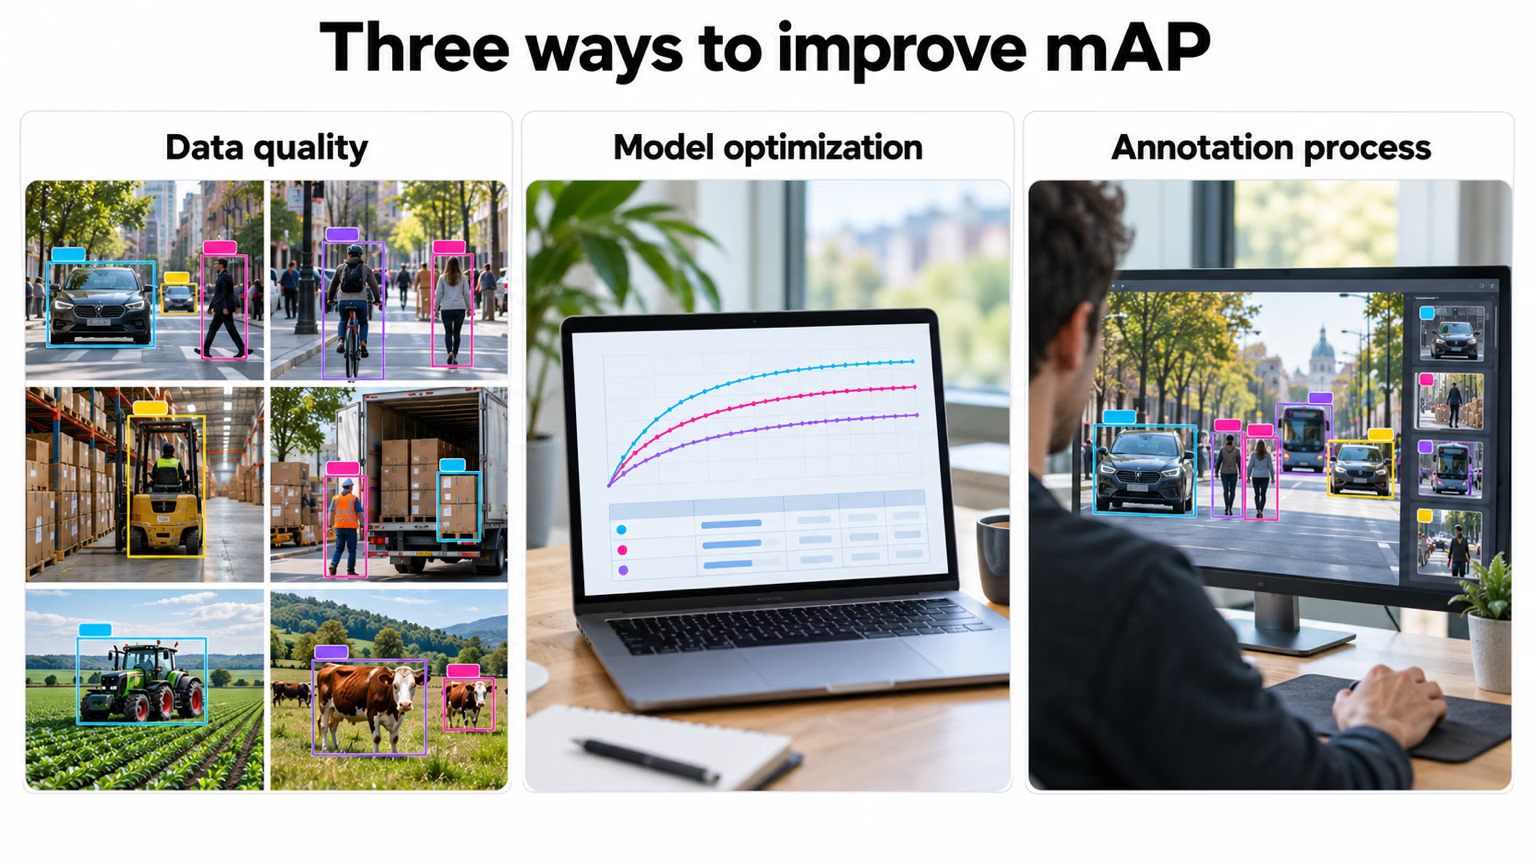
まずデータ品質とアノテーションプロセスを改善します。レッスン2と6のラベルチェックから始めるのが最も手軽です。データがクリーンな場合にのみ、モデルを変更します。
解答を表示
from ultralytics import YOLO

checks = {
    "runs/segment/train/weights/best.pt": ("coco8-seg.yaml", "metrics/mAP50-95(M)", "https://ultralytics.com/images/bus.jpg"),
    "runs/obb/train/weights/best.pt": ("dota8.yaml", "metrics/mAP50-95(B)", "https://ultralytics.com/images/boats.jpg"),
}
for weights, (data, key, image) in checks.items():
    model = YOLO(weights)
    gate = model.val(data=data, imgsz=320, plots=False, verbose=False).results_dict[key]
    onnx_model = YOLO(model.export(format="onnx", imgsz=320))
    result = onnx_model(image, imgsz=320, verbose=False)[0]
    print(f"{onnx_model.task:8s} {key} @320 = {gate:.3f} | ONNX: {result.verbose()}")
runs/... のパスを、学習実行時に表示されたフォルダー(Results saved to ...)に合わせて変更します。レッスン2と7の1エポックの学習では、次のようになります。
segment  metrics/mAP50-95(M) @320 = 0.377 | ONNX: 4 persons, 1 bus,
obb metrics/mAP50-95(B) @320 = 0.832 | ONNX: 185 ships, 3 harbors,| モデル | ゲート指標 | 値 | 画像サイズ | ONNX |
|---|---|---|---|---|
| セグメンテーション | マスクmAP50-95 | 0.377 | 320 | segment として再読み込みされ、バス1台と人物4人を検出します |
| OBB | OBB mAP50-95 | 0.832 | 320 | obb として再読み込みされ、船185隻と港3か所を検出します |
各チェックには、モデルの対象ドメインの画像を使います。OBBモデルには街路の画像ではなく、空撮した港の写真を使います。どちらもエクスポートチェックには合格していますが、どちらのモデルもリリースできる状態ではありません。検証画像4枚での1エポックの学習はスモークテストであり、合否判定ではないためです。